ARTICLE · 1316071
长任务上下文必爆:卸载、压缩、隔离三板斧怎么选(Deep Agents 10/16)
长任务上下文必爆:卸载、压缩、隔离三板斧怎么选(Deep Agents 10/16)
长任务里上下文必然爆,这不是调参能躲开的。Deep Agents 内置了三板斧:卸载到文件、压缩总结、隔离到子 agent。这一课讲清楚每一招的触发条件、代价,以及症状对应该用哪一招——最后给一张诊断表。
一、为什么必然爆
agent 的上下文是单调增长的:每一轮的 AIMessage + ToolMessage 都追加进消息列表,没有任何东西会自动消失。而工具返回值的大小你控制不了——一次网页抓取可能是 200 token,也可能是 40000。
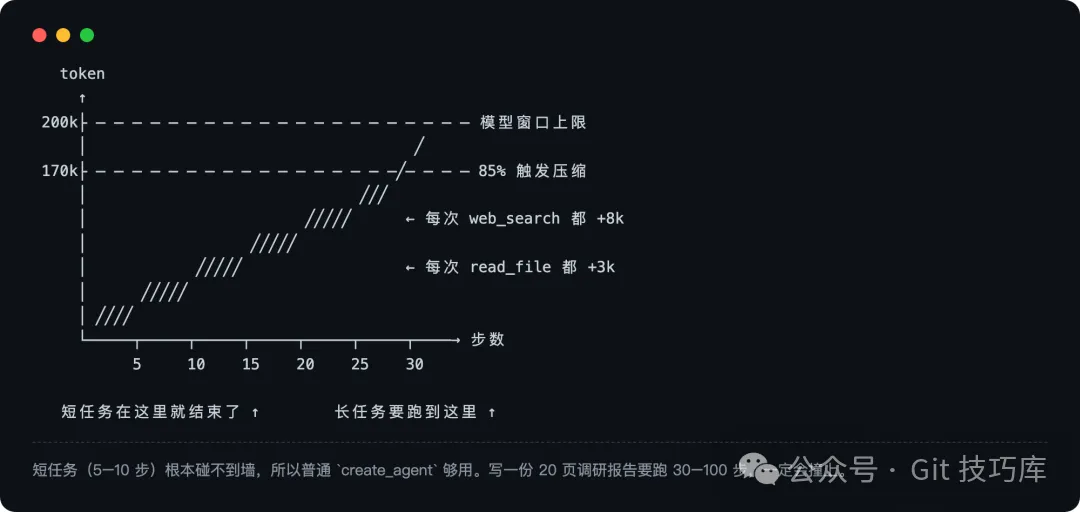
撞上之后的三种死法:
二、三板斧:机制和代价
做什么
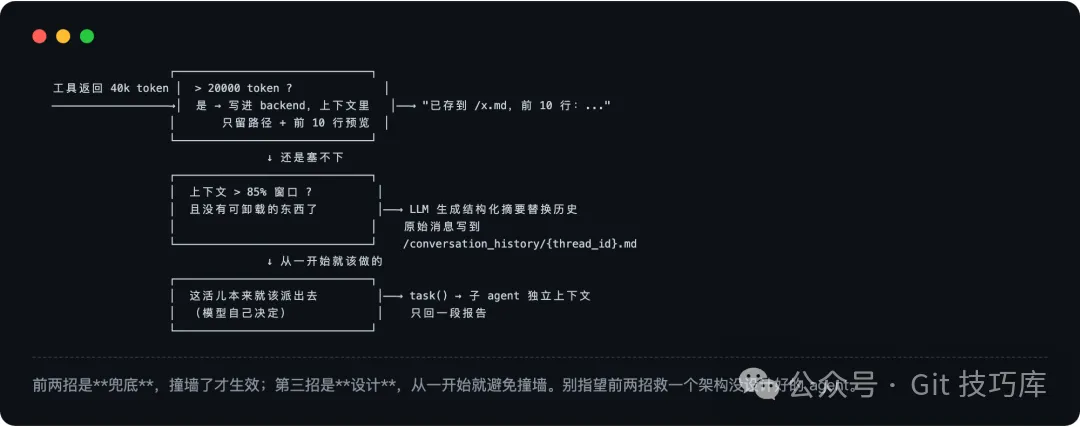
卸载 Offloading:大块内容写进 backend,上下文里换成一个路径 压缩 Summarization:老消息交给 LLM 总结成一段话,替换掉原文 隔离 Subagents:脏活派给子 agent,主 agent 只收最终报告
触发
卸载 Offloading:自动。工具入参或返回值超 20000 token 压缩 Summarization:自动。上下文到窗口的 85% 隔离 Subagents:手动。模型自己决定调 task()
信息损失
卸载 Offloading:零。原文还在 backend 里,随时 read_file / grep 捞回来 压缩 Summarization:有损且不可逆(上下文里)。原文写去了文件,但模型未必想得起来去读 隔离 Subagents:有损。中间过程主 agent 永远看不到
代价
卸载 Offloading:要用回内容就多一次工具往返 压缩 Summarization:一次额外的 LLM 调用(花钱、耗时);细节丢失导致后续判断变差 隔离 Subagents:每个子 agent 都要重付一遍 system prompt;并行调用放大延迟和 token
你能控制吗
卸载 Offloading:能:FilesystemMiddleware(tool_token_limit_before_evict=...) 压缩 Summarization:能:换 SummarizationMiddleware 的 trigger / keep 隔离 Subagents:能:subagents=[...] 的 description 和 system_prompt
三、卸载:20000 token 那条线
本地 0.7.3 反射 FilesystemMiddleware.__init__,阈值是硬参数:
FilesystemMiddleware( backend=..., tool_token_limit_before_evict=20000, # 工具返回值超这个数就卸载 human_message_token_limit_before_evict=50000, # 用户消息超这个数才卸载(宽松得多) grep_max_count=1000, max_execute_timeout=3600,)两种卸载方向,别搞混:
要点:卸载是零信息损失的。模型随时能 read_file 读回全文、grep 搜关键词。这是三招里唯一"白赚"的——代价只是多一次工具往返。
【最省的一招其实是砍工具】
压缩和卸载都是"事后补救"。真正从每一轮开始就省的,是减少工具 schema——工具描述是每次请求都要发的固定开销。用不到的内置工具直接砍掉(D7 的 HarnessProfile(excluded_tools={...})),比什么压缩都直接。
四、压缩:85% / 保留 10%
每次 create_deep_agent 都自动带 SummarizationMiddleware,不用你挂。它做两件事:
上下文内摘要:LLM 生成一段结构化摘要(本轮意图、已产出的文件、下一步),替换掉工作记忆里的历史消息。 文件系统留档:原始消息渲染成文本,写到 /conversation_history/{thread_id}.md。每次压缩追加一节,形成一份完整流水账。消息里的 base64 媒体单独存到 conversation_history/media/,用路径引用,保证这个 md 文件是纯文本的。
默认参数(本地 deepagents/middleware/summarization.py 反射):
另外:任何一次模型调用抛 ContextOverflowError,会立刻回退到"摘要 + 保留最近消息"再重试一次。这是最后一层保险。
【DeepSeek 走的是没有 profile 的那条路】
本地实测:init_chat_model("deepseek-v4-pro", model_provider="openai", ...) 建出来的模型,model.profile 是 None。
后果是压缩用保守的固定值:170000 token 触发、只保留最近 6 条消息。这两个数跟 DeepSeek 的真实窗口没关系。如果你的模型窗口小于 170k,压缩可能永远来不及触发——先撞的是硬报错。这种情况必须自己显式配:
from deepagents.middleware.summarization import SummarizationMiddlewaresumm = SummarizationMiddleware(model=model, backend=backend, trigger=("tokens", 50000), # 按你的真实窗口算 keep=("messages", 10))agent = create_deep_agent(model=model, backend=backend, middleware=[summ])官网文档只写了"85% / 10% / 回退 170000 / 6 条",没提这套回退在非官方 provider 上是常态而不是例外。用 DeepSeek、本地模型或任何走 openai 兼容接口的模型时,先 print(model.profile) 确认一下。
想让模型主动压缩(比如两个子任务之间),可以给它一个 compact_conversation 工具:
from deepagents.middleware.summarization import create_summarization_tool_middlewareagent = create_deep_agent( model=model, middleware=[create_summarization_tool_middleware(model, backend)],)它不会关掉自动压缩,两者共用同一套摘要引擎和 state。价值在于"在干净的边界上压"——任务 A 做完、任务 B 开始前压,比在任务中间被 85% 阈值打断要少丢东西。
【关键输入 / 输出】
输入(三个可调旋钮,都不是必填):
卸载阈值:FilesystemMiddleware(tool_token_limit_before_evict=20000) 压缩阈值:SummarizationMiddleware(trigger=("fraction", 0.85), keep=("fraction", 0.10)) 隔离:subagents=[{"name":..., "description":..., "system_prompt":...}]
怎么验证卸载真的发生了(这是唯一的硬证据,别靠感觉):
result = agent.invoke({"messages": [...]})# 1. 虚拟文件系统里有东西 —— 用默认 StateBackend 时它在返回值里for path in sorted(result.get("files", {})): print(path)# /retrieved/c3ec5240/chunk_1.md# /conversation_history/thread-1.md ← 这个出现 = 已经压缩过了# 2. 消息列表里没有对应的正文for msg in result["messages"]: for tc in getattr(msg, "tool_calls", None) or []: print(tc["name"], str(tc["args"])[:90])# task {'description': '...at /retrieved/c3ec5240/chunk_1.md...'} ← 只有路径,没正文压缩产生的 token 会混进流式输出。用 stream_mode="messages" 时靠 metadata 过滤掉:
for chunk in agent.stream({"messages": [...]}, stream_mode="messages", version="v2"): token, metadata = chunk["data"] if metadata.get("lc_source") == "summarization": continue # 不然用户会看到一段莫名其妙的会话总结五、隔离:唯一需要你设计的那一招
卸载和压缩都是自动的,隔离不是——它取决于你怎么定义子 agent、模型愿不愿意派活。三条实践:
子 agent 的 system_prompt 里明确要求返回摘要。不写的话,子 agent 会把它读到的一大坨原样吐回来,隔离就失效了: research_subagent = { "name": "researcher", "description": "Conducts research on a topic", "system_prompt": """You are a research assistant. IMPORTANT: Return only the essential summary (under 500 words). Do NOT include raw search results or detailed tool outputs.""", "tools": [web_search], } 大数据走文件,不走返回值。让子 agent 把结果 write_file,只在回复里说"存到了 /research/x.md"。主 agent 需要细节时自己去读。这是隔离 + 卸载的组合,也是 D6 那套 RAG 的完整形态。 description 决定派不派得出去。写得含糊,模型就自己硬扛,隔离一次都不会发生。这条规律从 L11 一直贯穿到这里。
六、诊断表:症状 → 该用哪招
七、和 LangChain 层上下文工程的差异
一句话:LangChain 层给你通道,Deep Agents 层给你策略。Deep Agents 的 backend 底下仍然是 LangGraph 的 state / store,只是包了一层文件系统的外壳——因为"路径"这个概念模型用得比"命名空间键"顺手得多。
【别把这三招当成万能药】
压缩是有损的,而且损在哪你不知道。摘要由 LLM 生成,它认为不重要的细节就没了。涉及金额、ID、时间这类不能错的信息,必须写进文件,别指望摘要保住。 压缩会花钱和耗时。它是一次完整的 LLM 调用,用长上下文当输入。一个跑 100 步的任务可能压缩三四次。 卸载不等于模型会去读。路径摆在那儿,模型可能就是不 read_file。prompt 里要明确说"细节在 X,需要时读它"。 本地 0.7.3:write_todos 是 opt-in 的。从 v0.7 开始 TodoListMiddleware 不在默认栈里(反射 create_deep_agent 源码确认)。想用规划工具锚定长任务的目标,得自己 middleware=[TodoListMiddleware()]。D1 里"规划自动内置"的说法是 v0.7 之前的行为。
八、什么时候不该用
小结
长任务的上下文单调增长,三种死法:硬报错、软失忆、成本爆炸。短任务碰不到,长任务躲不掉。 卸载(超 20000 token 自动,零信息损失)、压缩(85% 自动,有损且花钱)、隔离(手动设计,从源头避免)。前两招是兜底,第三招是设计。 压缩默认 85% 触发 / 保留 10%;模型没有 profile 时回退到 170000 token / 保留 6 条消息——DeepSeek 走的就是回退路径,务必自己显式配 trigger。 原始消息压缩后留档在 /conversation_history/{thread_id}.md;result["files"] 里出现这个文件就说明压过了。 子 agent 的 system_prompt 必须写死输出字数上限,否则隔离形同虚设。 压缩产生的 token 会混进流式输出,按 metadata["lc_source"] == "summarization" 过滤。 本地 0.7.3 起 write_todos 需要手动挂 TodoListMiddleware(),它是长任务里最便宜的目标锚点。
这是 Deep Agents 系列第 10 课,共 16 课。下一课:Deep Agents 流式:让跑几分钟的任务看得见进度。
GitHub:langchain-ai/deepagents
#DeepAgents #AIAgent #LangChain #ClaudeCode #Python #大模型应用 #程序员进阶