ARTICLE · 1338326
YOLO 啃不动异构文档?DocLayout-YOLO 用 MeshLayout-1M + 轴线注意力摆平


文档版面检测合成预训练 + 轴线注意力
📌 本期导读
背景引入:准确的文档版面分析是现代文档解析系统的基础:从论文、合同到票据,都要先把标题、段落、表格、图片等区域框出来,后续才能做 OCR 与结构化。YOLO 作为实时检测器的主流范式,在通用目标上已经很能打,但它在「异构文档」上的适配却长期被低估——文档版面千变万化,不同版式、不同扫描质量、不同语言混排,直接套用通用 YOLO 往往水土不服。之前的工作要么换重型专用模型牺牲实时性,要么只在特定数据集上微调,跨域一迁移就垮。
- 为什么读:
这篇的聪明之处在于不另起炉灶:它保留 YOLO 的实时主干,从「数据」和「模型」两侧同时补短板。数据侧造了一个百万级合成版面语料 MeshLayout-1M,用 Mesh-candidate BestFit 算法生成大规模多样版面,专门提升对异构文档的适配;模型侧提出 PALA 页面轴线注意力,沿水平/垂直页轴抓长程依赖,而且计算高效——实时性一点没丢。两条线一合,四个异构基准同时登顶。 - 核心看点:
① MeshLayout-1M:基于 Mesh-candidate BestFit 的合成预训练语料,大规模且版面多样;② PALA:页面轴线布局注意力,沿水平/垂直页轴捕获长程依赖且计算高效;③ 在 D4LA / M6Doc / HJDataset / PRIMA-LAD 四个异构文档基准上拿到 72.4% / 75.5% / 96.0% / 73.1% mAP50:95,优于现有实时检测器。 - 适合谁读:
做文档智能、版面分析、PDF/扫描件解析的算法工程师;研究合成数据预训练的同学;以及所有想把 YOLO 这套实时武器搬进垂直文档域的落地团队。
论文 | DocLayout-YOLO: Axis-Attentive Document Layout Detector with Mesh-Guided Synthetic Pretraining
 DocLayout-YOLO: Axis-Attentive Document Layout Detector with Mesh-Guided Synthetic Pretraining
论文标题DocLayout-YOLO: Axis-Attentive Document Layout Detector with Mesh-Guided Synthetic Pretraining
论文地址https://arxiv.org/abs/2610.28171
代码链接https://github.com/opendatalab/DocLayout-YOLO
论文机构Shanghai AI Laboratory
作者Zhiyuan Zhao, Hengrui Kang, Guang Liang, Bin Wang, Conghui He
时间2026-10-20
录用情况arXiv 预印本(2026-10-20 提交,未标注会议接收)
一、研究背景
文档版面分析是文档解析流水线的第一关,质量直接决定后续 OCR 与结构化的上限。YOLO 框架虽是实时检测器的领先范式,但它在异构文档上的适配长期未被充分研究:真实文档版面跨度极大,且常伴随扫描畸变、低分辨率与多语言混排,直接把为自然图像设计的通用 YOLO 搬过来,域差距明显。作者团队由此提出 DocLayout-YOLO——一个文档专用的实时检测器,同时从「多样化的合成文档预训练」与「页面轴线上下文建模」两个角度补上 YOLO 在文档域的短板,且不牺牲实时性。
二、研究方法
DocLayout-YOLO 从数据侧与模型侧两条线同时改造,且都围绕「异构文档适配」。
① MeshLayout-1M:Mesh-candidate BestFit 合成预训练语料
- 大规模多样版面:
用提出的 Mesh-candidate BestFit 算法生成百万级合成文档版面,覆盖大量版式组合,为预训练提供丰富多样的样本。 - 提升异构适配:
在合成数据上预训练后再迁移,显著降低对单一真实数据集的过拟合,增强跨版式、跨域的泛化。
② PALA:页面轴线布局注意力
- 沿页轴抓长程依赖:
在水平与垂直两个页轴上建模版面元素间的长程关系,符合文档天然的行/列结构。 - 计算高效:
轴线注意力在拿到长程上下文的同时保持低开销,不拖累 YOLO 的实时性。
③ 实时 YOLO 主干 + 两路协同
- 数据与模型双侧改造:
合成预训练提供泛化底子,PALA 提供版面结构先验,两者在同一个实时 YOLO 框架下协同。 - 精度-效率兼得:
改造后仍是实时检测器,不靠堆算力换精度。
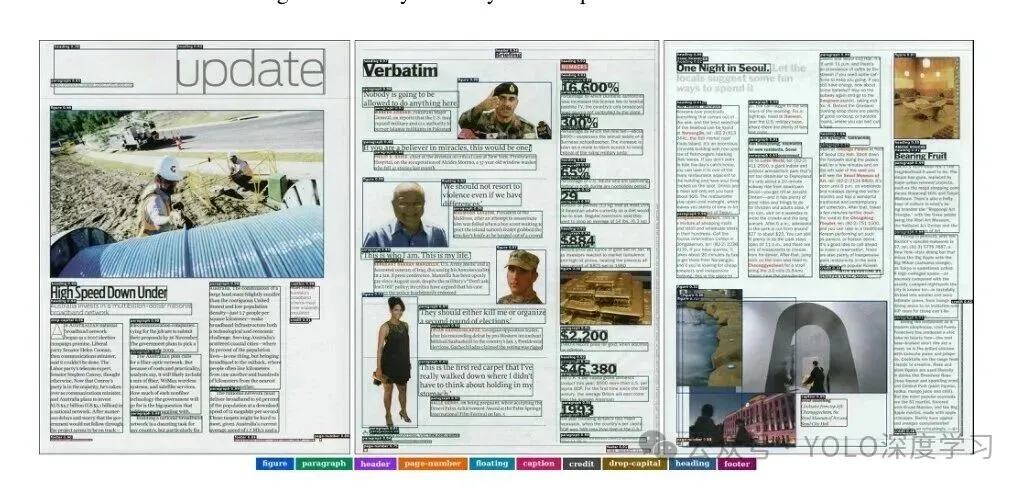 图1:DocLayout-YOLO 在异构文档上的定性检测结果,不同版面区域以边界框与图例区分
三、实验结果
论文在四个异构文档基准上系统评测:D4LA、M6Doc、HJDataset、PRIMA-LAD,DocLayout-YOLO 分别取得 72.4% / 75.5% / 96.0% / 73.1% mAP50:95,在四个基准上同时达到 SOTA 级别。与现有实时检测器的对比尤其说明问题:论文给出的延迟-精度与 FLOPs-精度权衡图显示,相对 YOLOv8 / YOLOv10 / YOLOv11 / YOLOv12 / YOLOv26 以及 RT-DETRv3,DocLayout-YOLO 在 M6Doc 上以更低延迟/FLOPs 拿到更高 mAP50:95,即实时检测器里最优的精度-效率权衡。消融实验确认 MeshLayout-1M 预训练与 PALA 各自独立贡献增益,两者叠加才是完整答案。
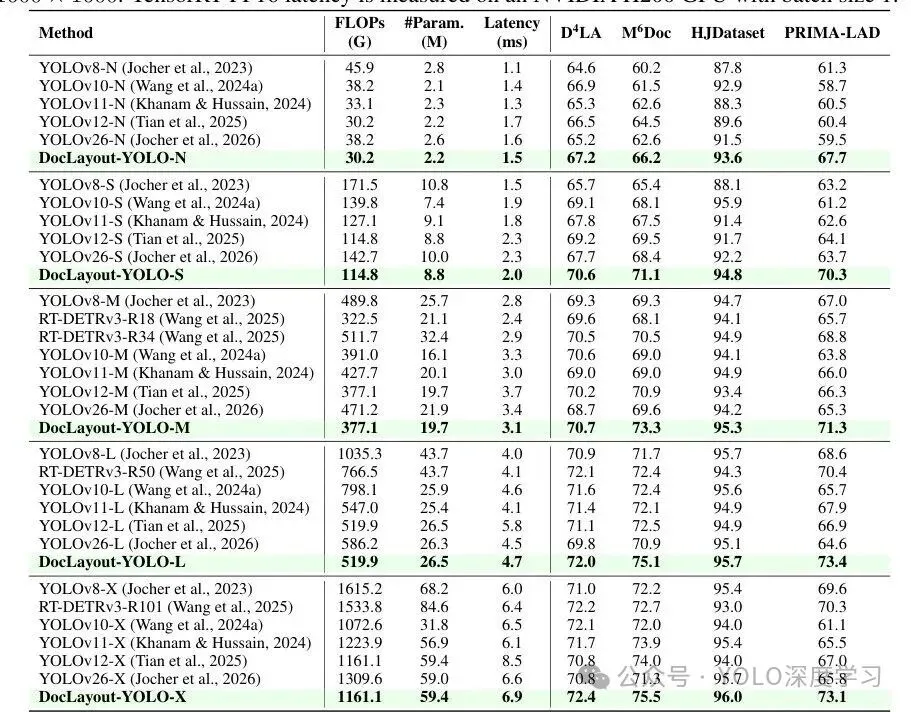 图2:D4LA、M6Doc、HJDataset、PRIMA-LAD 四个异构文档基准上的 mAP50:95 对比
四、研究贡献
指出 YOLO 在异构文档版面分析上适配不足,实时检测器在文档域长期被低估 提出 MeshLayout-1M:基于 Mesh-candidate BestFit 的合成预训练语料,大规模且版面多样 提出 PALA:页面轴线布局注意力,沿水平/垂直页轴捕获长程依赖且计算高效 在 D4LA / M6Doc / HJDataset / PRIMA-LAD 四个异构基准达 SOTA(72.4/75.5/96.0/73.1 mAP50:95) 相比现有实时检测器建立更优精度-效率权衡,代码、模型与数据全开源
五、局限与未来
合成预训练依赖版面元素与渲染管线质量,真实扫描件(低分辨率、扭曲、印章遮挡)的域差距未充分覆盖;PALA 的页轴假设对极不规则排版(古籍、表格密集页)可能失效;四个基准偏英文/学术文档,中文复杂版面与多栏报纸类的泛化待验证;与专用版面模型(LayoutLM 系等)的端到端精度对比未充分展开。
🚀 本系列后续选题预告
边缘端实时检测的另一条路:YOLOF-MLD 把多分支 FPN 砍成单流还更快 合成数据预训练的下一道坎:版面之外,表格与公式检测还能怎么造数据 实时检测器的文档域迁移:YOLO 系在垂直领域的适配清单
👉 下一期你想先读哪个方向?欢迎在后台留言论文题目或方向。
点击关注 | 获取更多
本文数据信息均来自网络收集 版权归原作者 仅作学习分享