ARTICLE · 1343133
不写用例,让AI自己把App走一遍
第 02 篇说:自然语言不是用例,得先编译成 YAML。
那如果连“编译”这一步都交给机器呢?
给一个目标——“找到这个活动页,验证能不能参与”——然后让它自己在真机上走。走完,把它走过的路径沉淀成用例。
这就是自主探索。听起来像放手,实际上比写用例更需要约束。
一、探索的骨架其实很朴素
一个循环,五个动作:
- 观察
:截一张图,同时问策略器“这是什么页面、下一步该去哪”。 - 规划
:返回 plan、subgoal、reflection、progress,以及一组候选动作。 - 过滤
:候选逐个过准入策略(第 22 篇那四道闸)。 - 执行
:只执行通过的那一个。 - 反思
:把“执行了什么、页面变成了什么”写进历史,进入下一轮。
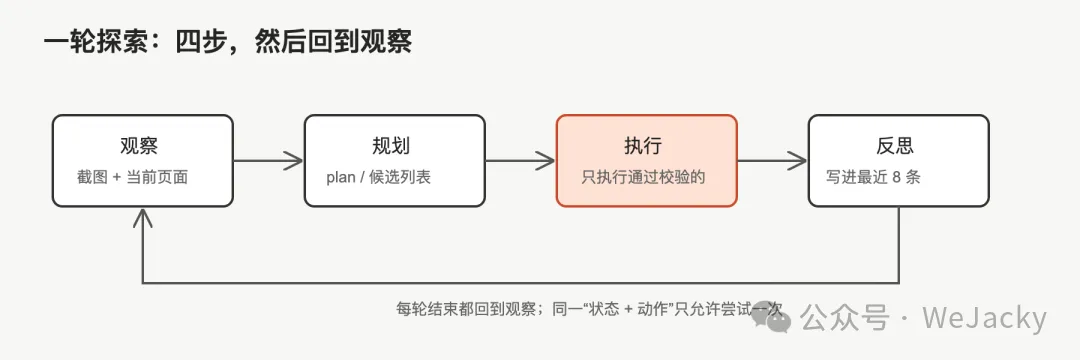
代码里就是 while (true) 加一次 await runtime.observe(...),没什么魔法。
真正决定它好不好用的,不是这个循环,是循环外面的三样东西。
二、第一样:预算,而且要分三种
开放式的探索必须有个头。我们设了三个上限:
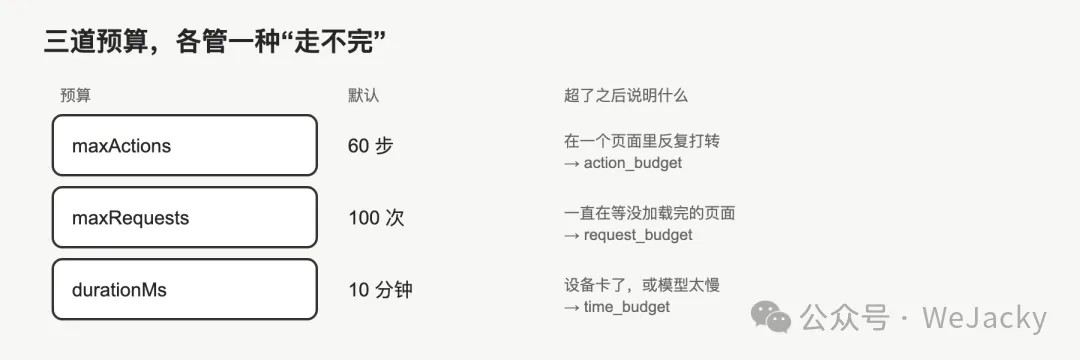
maxActions | action_budget | |
maxRequests | request_budget | |
durationMs | time_budget |
为什么是三种而不是一种?
因为它们的耗尽方式不一样。步数超了,通常是它在一个页面里反复转;请求数超了,通常是它在等一个一直没加载完的页面;时间超了,可能是设备卡了、模型慢了。
看 return 的那个字符串,你大概就知道该去查什么。
另外还有一个隐含的预算:每个“状态 + 动作”只允许尝试一次。
.filter(c => (attempts.get(`${key}:${actionKey(c)}`) ?? 0) < 1)这条比三个上限都重要。没有它,AI 会在同一个页面上把同一个按钮点八遍,然后告诉你“目标未完成”。
三、第二样:状态去重,认得出“同一个页面”
要判断“还是那个页面”,就得先定义什么叫“同一个页面”。
最直觉的做法是比较截图。不行——时间变了、红点变了、一个轮播图换了张图,hash 就全变了。
现在的做法是把观察结果归一化再 hash:
const normalize = text => String(text ?? '').toLowerCase() .replace(/\d+/g, '#') // 金额、时间、计数 一律折叠 .replace(/\s+/g, ' ').trim();页面名、状态描述、候选目标列表,三者归一化后拼起来做 sha256,取前 16 位。
把数字折叠成 # 是这里最关键的一步。“余额 1,280.00”和“余额 1,280.01”不该被当成两个页面,否则探索会以为每次刷新都到了新地方。
这个设计有个副作用:如果两个页面只有数字不同(比如两条不同的订单详情),它会被当成同一个页面。
我们接受了这个误判。因为对探索来说,“漏掉一个相似页面”的代价,远小于“把每个数字变化都当成新页面”导致的图和预算爆炸。
四、第三样:回退路径,而且不能无限回退
探索过程中一定会出现“这个页面没有新入口了”。
这时不能直接结束,要做的是返回已知页面:
action = { type: 'back', target: 'Android 返回', intent: 'navigate' };触发条件有三个:没有可用候选、原地打转超过 5 轮(stale >= 5)、当前路径长度超过 12 步。
返回也不能无限次。recoveries 上限是 6,超过就停,返回 recovery_budget。
这套东西合起来,实际效果是:它像一个人在一个陌生 App 里乱逛,但记得自己从哪来、去过哪、什么时候该放弃。
五、它的产出不是“一次成功”,是一张图
每一轮都会累积 nodes 和 edges:
一个状态 = 一个节点(含截图、页面名、断言)。 一次动作 = 一条边(从哪到哪、动作是什么、执行结果)。
跑完之后,最有价值的东西不是“它完成了目标”,而是这张图——你可以从中挑一条最短路径,沉淀成一条正式用例。
这也是它和第 02 篇的关系:第 02 篇把人的话编译成用例,这一篇把机器的行动编译成用例。
怎么解决
一张图要变成用例,中间还差三步。
第一步,挑路径。图里从起点到“目标达成”节点可能有很多条路,取边数最少的那条。不是取“最后走的那条”——最后走的那条常常绕了远路,因为中间试错了好几次。
第二步,补断言。这是最容易糊弄过去的一步。探索过程中每个节点都记了 assertion 字段,但它是模型写的,可能是一句“页面显示正常”。这种断言回放时毫无意义。
所以正式沉淀的时候,我会把每条路径的关键节点挑出来,换成可验证的东西:标题文案、某个固定控件的存在、列表至少一行。模型给的断言只能当提示,不能当结论。
第三步,删掉“探索专用”动作。scroll 找入口、back 回退、长按看详情,这些在探索里很常见,但一条稳定用例通常不需要它们。留着会让用例变脆。
三步做完,一条“AI 走出来的用例”才算真的能用。
三种结束方式,对应三种查法
探索跑完,返回值只有三种,各有各的含义:
goal_completed | ||
*_budget | ||
no_more_candidates |
第一种最容易误判。我遇到过“目标已完成”,因为页面上出现了“活动已结束”五个字——从某种意义上说确实“完成”了,但不是我们要的那种完成。
第二种最常见。action_budget 往往是页面结构太深,request_budget 往往是某个页面一直 loading(代码里连续 5 次观察到 loading 会主动挂起、请人处理)。
第三种最有信息量。它说明这个目标在当前账号权限下走不通,该去改测试数据,而不是改策略。
这张图也不是白来的
一次 60 步的探索,大概会产生 60 次模型调用(每轮一次观察 + 一次规划,通常是同一次请求里返回的),加上几十次设备交互。跑一次真机探索,成本比跑一条普通用例高一到两个数量级。
所以它不适合放进 CI,也不适合每次提交都跑。它的正确位置是需求早期:功能刚提测、用例还没写的时候,先让它走一遍,看能不能走通、哪里有坑。
走出来的图还有第二个用途:给人看。
产品同学看不懂 YAML,但看得懂一张“从首页到活动页”的路径图。很多时候他们看完会说一句“这里不该有入口啊”——这种反馈,用例是通过不了的。
一个我没解决的取舍
图是按“状态”合并的,不是按“操作序列”。这意味着同一个页面无论从哪条路进来,都是同一个节点。
好处是图不会爆炸;坏处是它记不住“我是怎么来的”。
在某些业务里这很致命——同一个“确认页”,从“充值”进来和从“提现”进来,下一步完全不一样。合并之后,路径就断了。
目前的处理是:如果发现某个页面有多个入口且后续不同,就在 state 描述里手工加区分词(比如“确认页-充值”),让它在 hash 上变成两个节点。
这是个人工补丁,不优雅,但比让图爆炸好。
它和“录制”有什么区别
第 17 篇讲过真机录制:人在手机上操作,系统把每一步记下来,生成用例。
探索和录制,经常被放在一起比较,但它们解决的不是同一个问题。
录制的前提是你知道该怎么走。你手上有业务知识,知道先点哪里、再填什么、最后看什么。录制只是把这套知识变成资产,省的是打字时间。
探索的前提是你不知道该怎么走。功能刚提测,需求文档只有一句话,你连入口在哪都要试。这时候没有“正确答案”可以录,只能让机器去撞。
所以两者的产出也完全不同:
录制产出的是一条确定的路径,精确、可回放、脆(页面一改就断)。 探索产出的是一张可能的图,粗糙、有冗余、但有覆盖面。
我不会拿探索去替代录制。真实的工作流是:先探索一遍,看这个功能大概长什么样、有哪些坑;然后人工走一条最优路径,录下来,做成正式用例。
探索负责“看清地形”,录制负责“修一条路”。
它最不适合的场景
探索不是万能的,有两种场景它一定做不好。
第一种是需要精确断言的。它只能判断“页面上看起来对”,判断不了“这笔订单金额算得对”。数值、状态、幂等,这些必须靠人写断言。
第二种是需要顺序副作用的。比如“先下单再取消”,探索可能只走到下单就宣布完成,也可能反复下单。它不理解业务语义,只理解“页面变了”。
认清这两条边界,比把探索做得更聪明更有用。
一次真实的探索长什么样
我给它的目标是“找到积分商城,确认能否兑换”。目标是中文,很随意,没有写入口在哪。
它走出来的过程大概是这样:首页 → 点“我的” → 看到“积分” → 进积分页 → 没找到商城入口 → 返回首页 → 点“更多服务” → 找到“积分商城” → 进入 → 看到商品列表 → 停在第一个商品上,progress: completed。
图上一共 9 个节点、11 条边,其中 3 条是 back。预算用掉 14 步,远没到 60。
值得注意的是中间那次“进错页面又退出来”。如果没有去重和回退,它很可能在积分页里反复点同一个按钮,把预算烧光。
探索看起来像在乱走,实际上每一步都在缩小范围。只是这个“缩小”的过程,在报告里看起来很像绕路。
一句提醒
如果只记一件事:探索的价值在“看见”,不在“通过”。
把它当成一个探路的实习生,而不是一个能替你签字的同事。它走一遍,告诉你哪里有坑、路有多长;至于这条路对不对、能不能交付,还得你自己看。
六、走过的弯路
方案一:把所有历史都塞进 prompt
跑到第 20 步时,prompt 已经几千 token,模型开始“记得太多”,反复引用很早以前的页面,判断越来越慢、越来越飘。
现在的做法是只保留最近 8 条,而且每条都截断(页面名 100 字、动作 120 字、结果 160 字)。记忆要有上限,否则它不是记忆,是噪声。
方案二:不做去重,靠模型自己记得
模型不记得。它每一轮看到的都是新截图,很容易把“我点过这个”忘掉。去重必须由代码做。
方案三:卡住就结束
一开始 blocked 直接返回失败。结果大量探索“失败”在登录页、权限弹窗、验证码——这些本来就应该交给人。
现在遇到 blocked 会发一个 waiting_user,人等处理完点继续,探索接着跑。该找人的时候找人,不要假装机器能解决一切。
方案四:让它自己判断“目标完成”
它会过早宣布完成。所以 progress: 'completed' 有一个附加要求:必须基于当前截图可见的证据,不许因为“点了一下看起来对了”就宣布完成。
即便如此,仍然会误判。所以最终的“完成”我还是看那张图,不看那句话。
七、下次再遇到,先问哪两句
第一,它的记忆有多长?
没有上限的记忆,会让它越跑越糊涂。
第二,它卡住的时候,谁来接手?
如果答案是“它自己想办法”,那它大概率会乱点。该设计的是“什么时候叫人”。
第 22 篇讲的是怎么不让它点错,这一篇讲的是怎么让它走完。两篇合起来,才是“自主”的完整含义:能自己走,也知道什么时候该停。
如果让 AI 在你的 App 里自由走 60 步,你最担心它走到哪里?
我猜不是首页,是那些“看起来只是查看、其实会产生副作用”的角落——订单详情、消息列表、设置页里的开关。