ARTICLE · 1353303
DeepSeek 把 App 能力开放给开发者,连聊天前端也开源了
昨晚 DeepSeek 发了个挺实在的更新:把网页版和 App 背后的整套工具搬进了 API。
联网搜索、读链接、解析文档图片、语音听写和朗读,都能靠几个参数接进自己的应用。
甚至连前端页面也一起开源了。点开在线地址,或者下个压缩包双击 index.html,填上密钥就能用。
更实在的是,它还支持把你在 DeepSeek 官网导出的聊天记录压缩包直接倒进去接着聊。
我把公告、技术文档和 X 评论区翻了一遍,先泼个冷水:这回整套工具只开放给 deepseek-flash,也就是 V4.1-Flash。
至于评论区大家狂催的 V4-Pro,目前还没跟上这波更新。
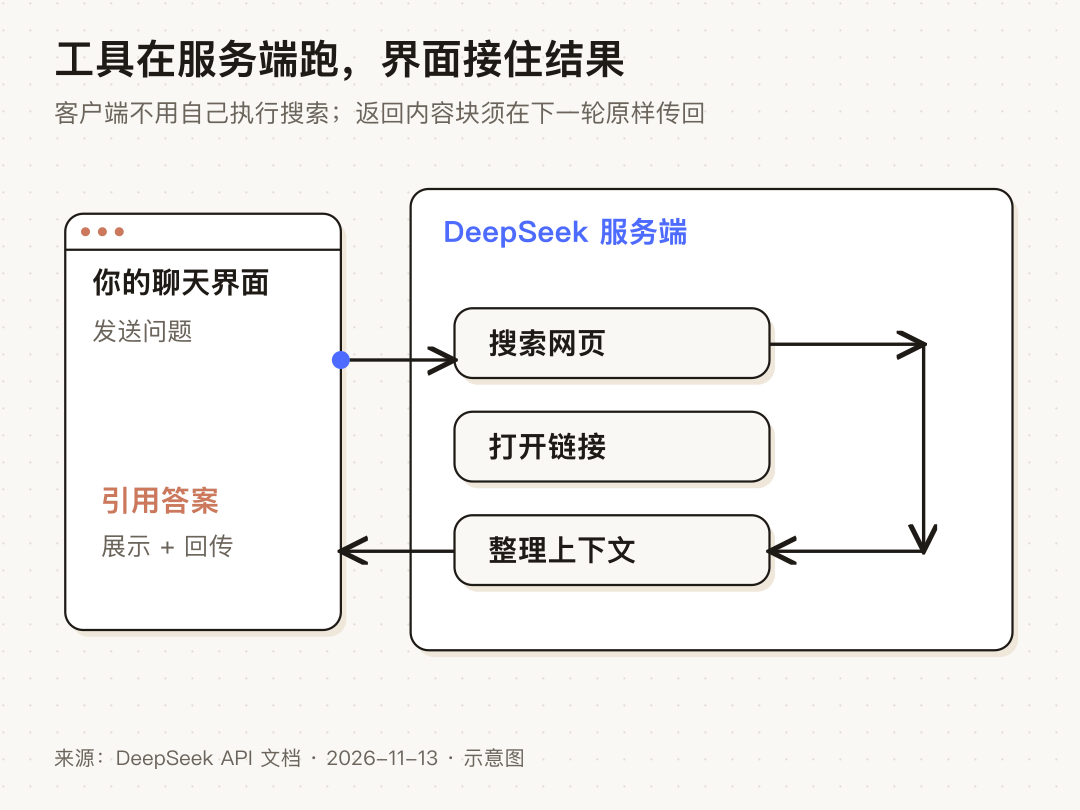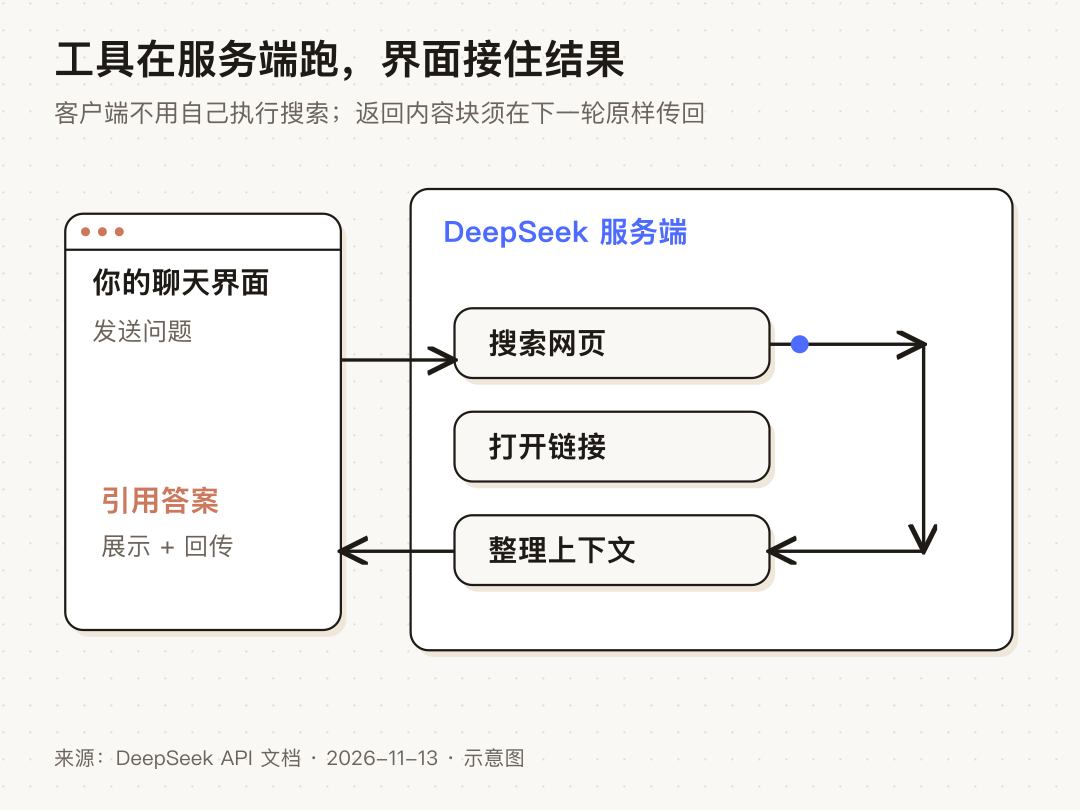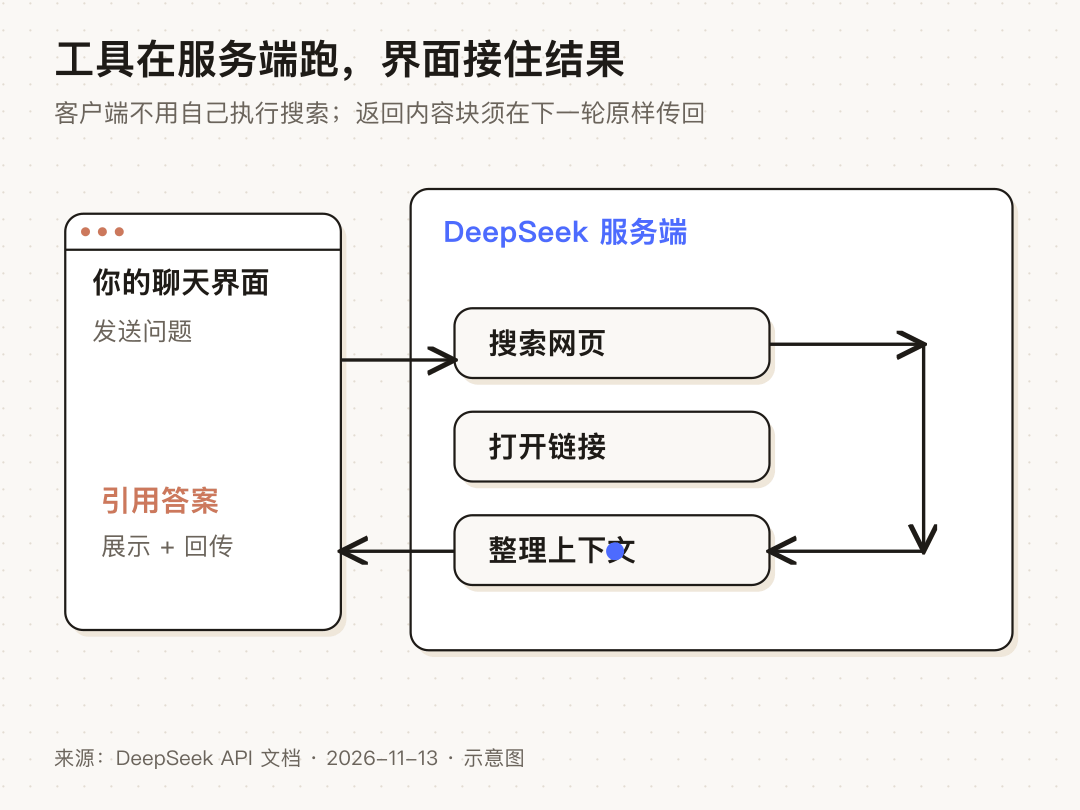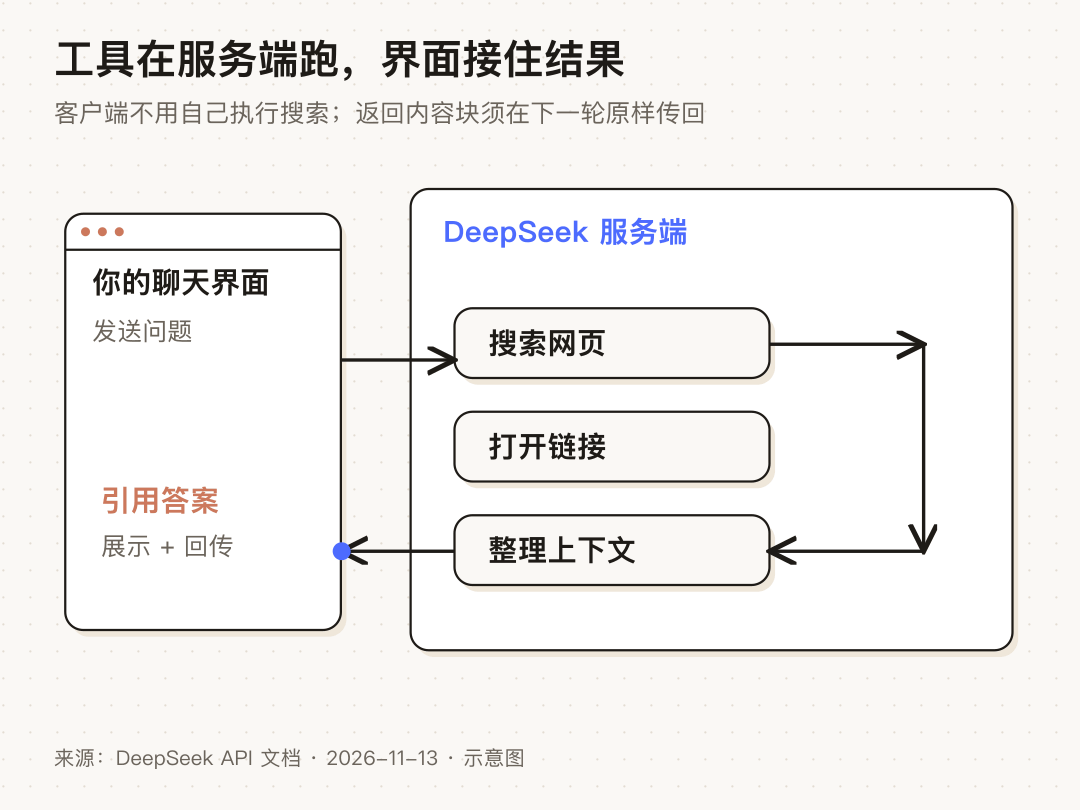
▲ 图:问题交给服务端工具
服务端把搜网页、搜图和抓链接接走了
以前接模型做联网聊天,接搜索、抓网页正文、抽字塞回上下文,全得自己写管线。
现在这段琐碎活全归服务端管。客户端只要把问题扔过去,搜不搜、搜几轮,模型自己会跑完。
关掉思考,模型会按需要搜网页或以图搜图,最后带着来源引用回答。
打开思考之后,它就能像 App 里的深度搜索那样边推理边补查。官方文档拿埃菲尔铁塔和东京塔比高度举了个例子。
演示流程里,模型先搜一遍,再打开两座塔的官网找数字,没找全就在页内搜关键词、换词补查,最多能连着调二十次左右的工具才收口。
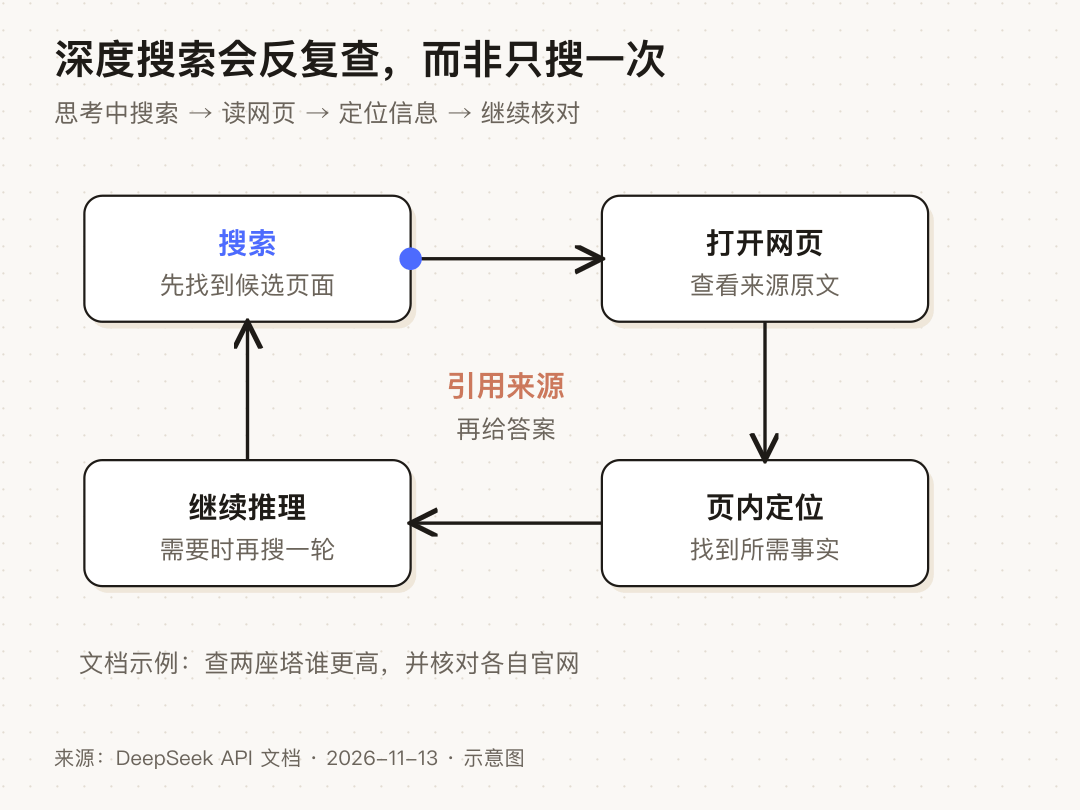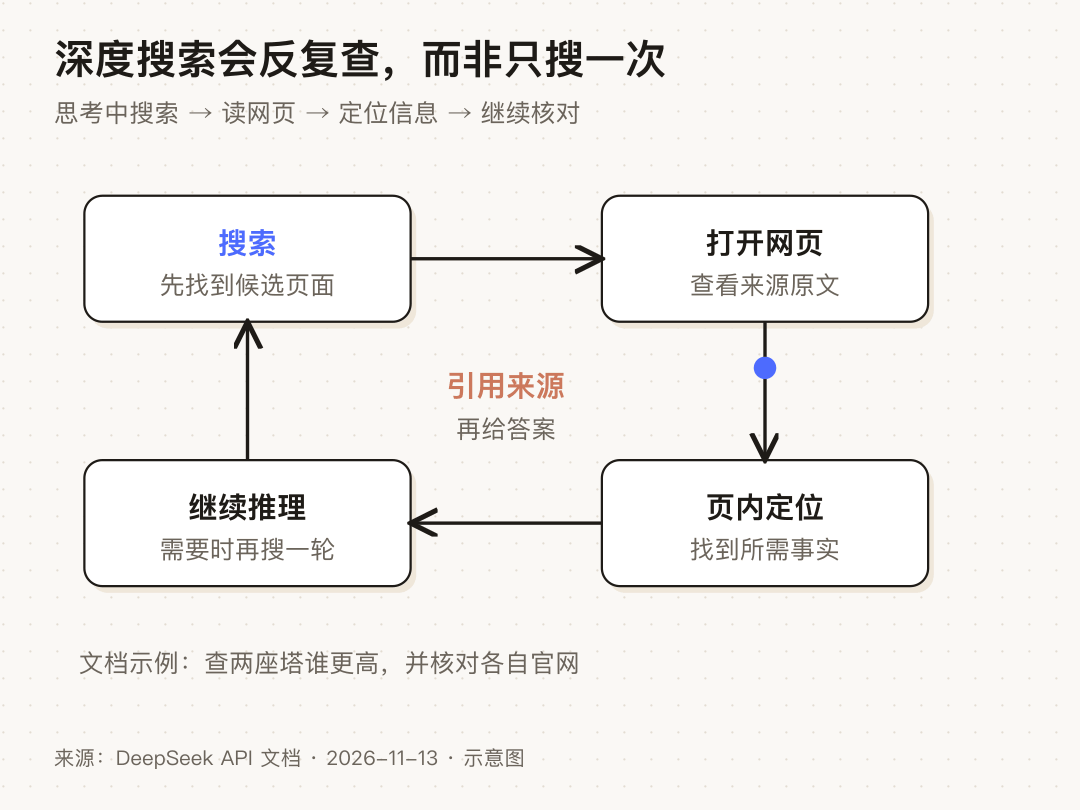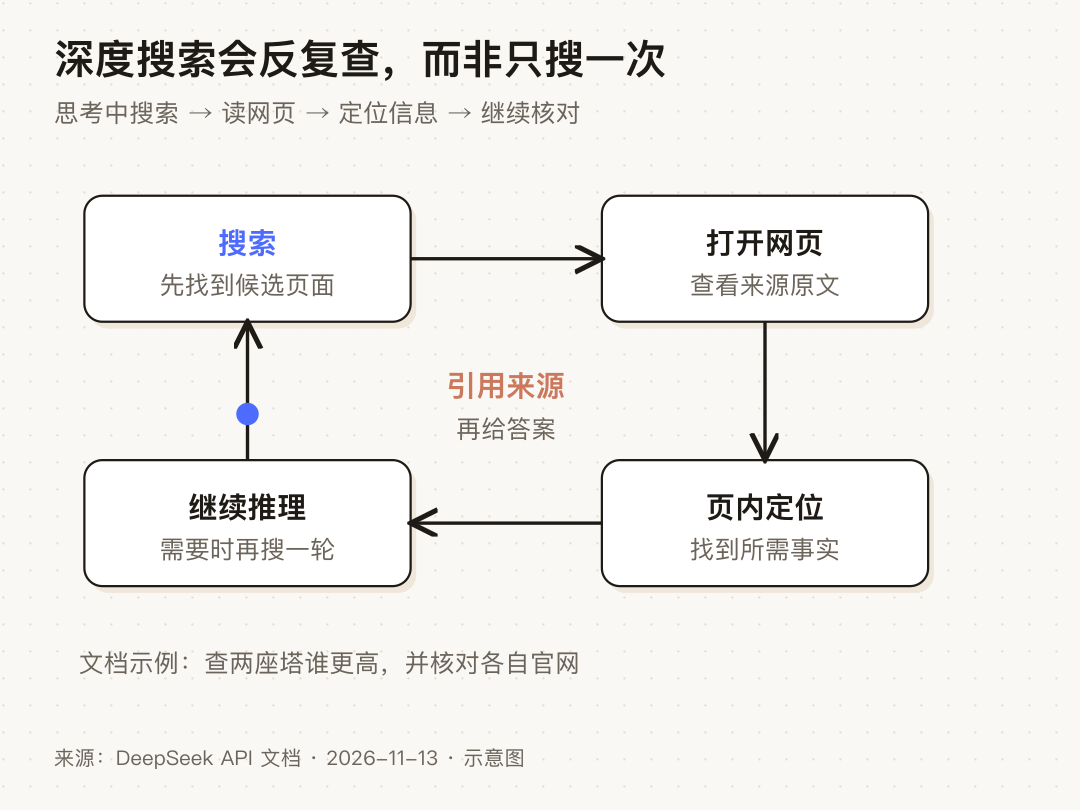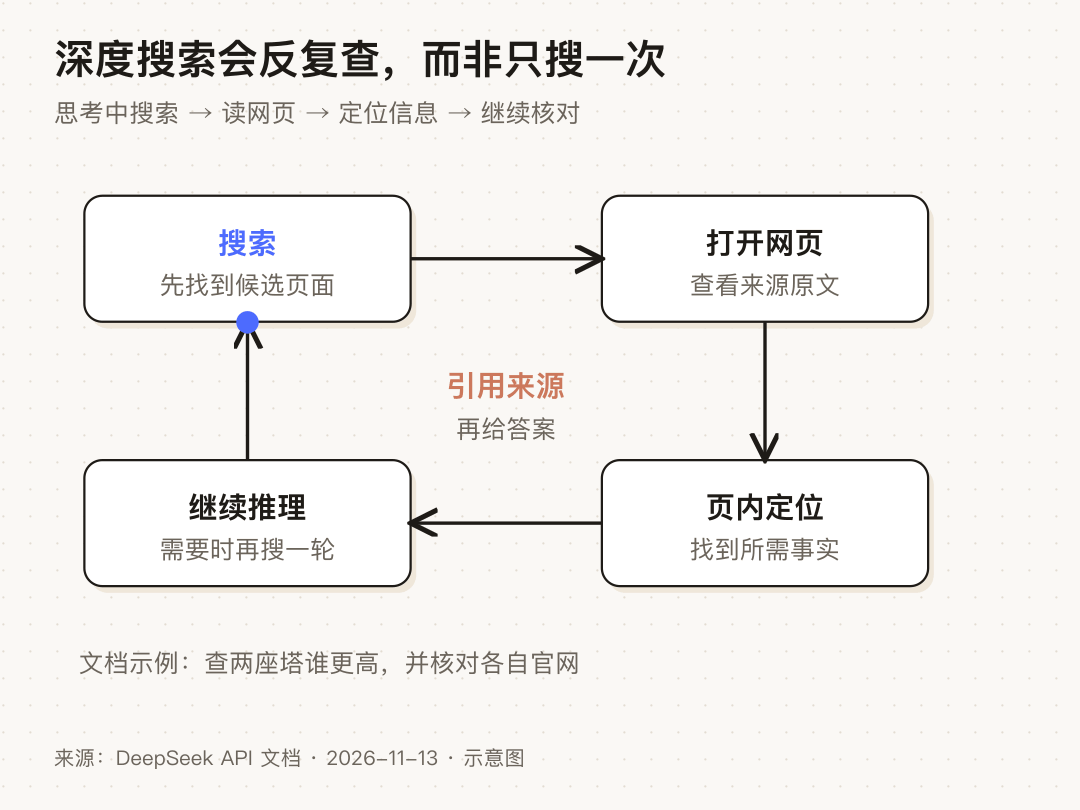
▲ 图:搜索会穿插在思考里
接口接入倒是挺省事。Anthropic Messages、OpenAI Responses 和 Chat Completions 这三种常见协议都能直接跑。
挂上 deepseek_web_search 管搜网页和搜图,再加一个 deepseek_read_url,就能顺手读用户丢进来的链接。
但前端千万别偷懒。文档里特意标了一条,服务端返回的思考、搜索和抓页结果块,下一轮对话必须原样回传。
中间如果自建网关把这些块滤掉了,请求照样能成功,模型却会把刚看过的网页忘光。
还有个坑得提前留意:只要开了工具调用、自动起标题或者高安全级别,服务端就会接管采样节奏。
请求里写的温度 temperature、top_p 等一批参数会被直接忽略,想细调模型脾气没法生效。
文件解析怎么省钱,图和语音卡在哪
先说清按页计费的文件:PDF、Word、PPT 和图片。它分纯文本提取和带版面解析两种模式。
拿财报举个例子。要是只抽纯文字,里面的营收走势图会直接丢掉,模型根本看不到图。
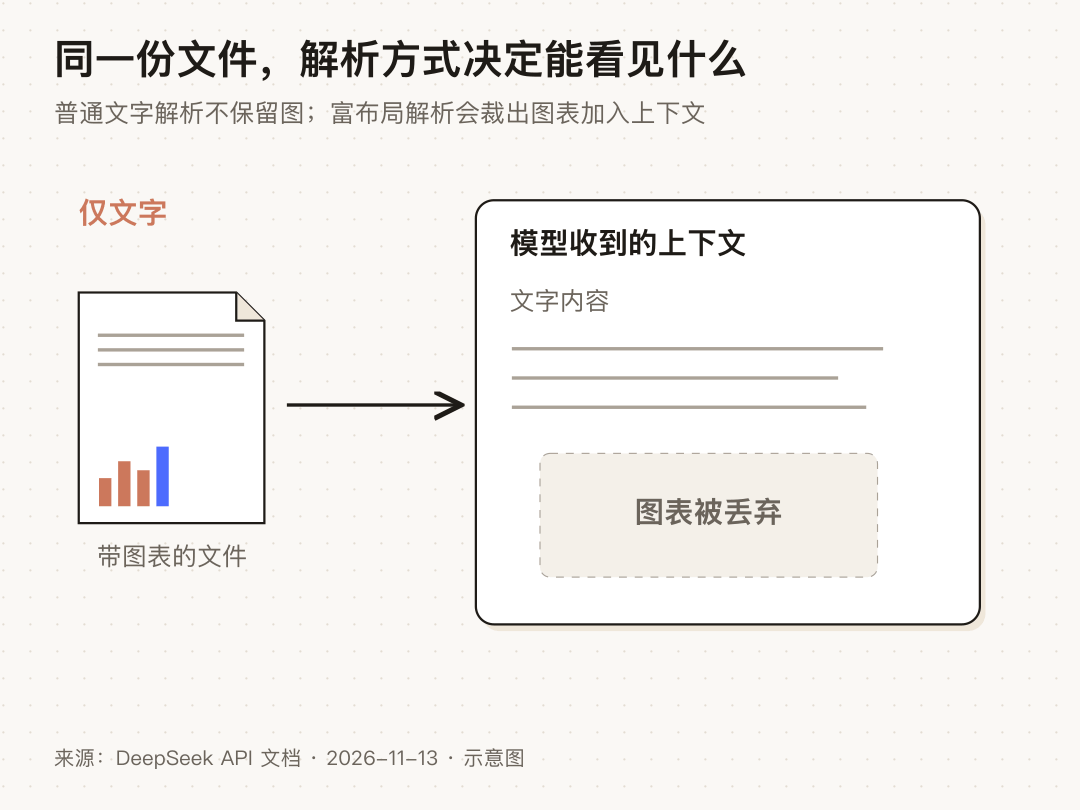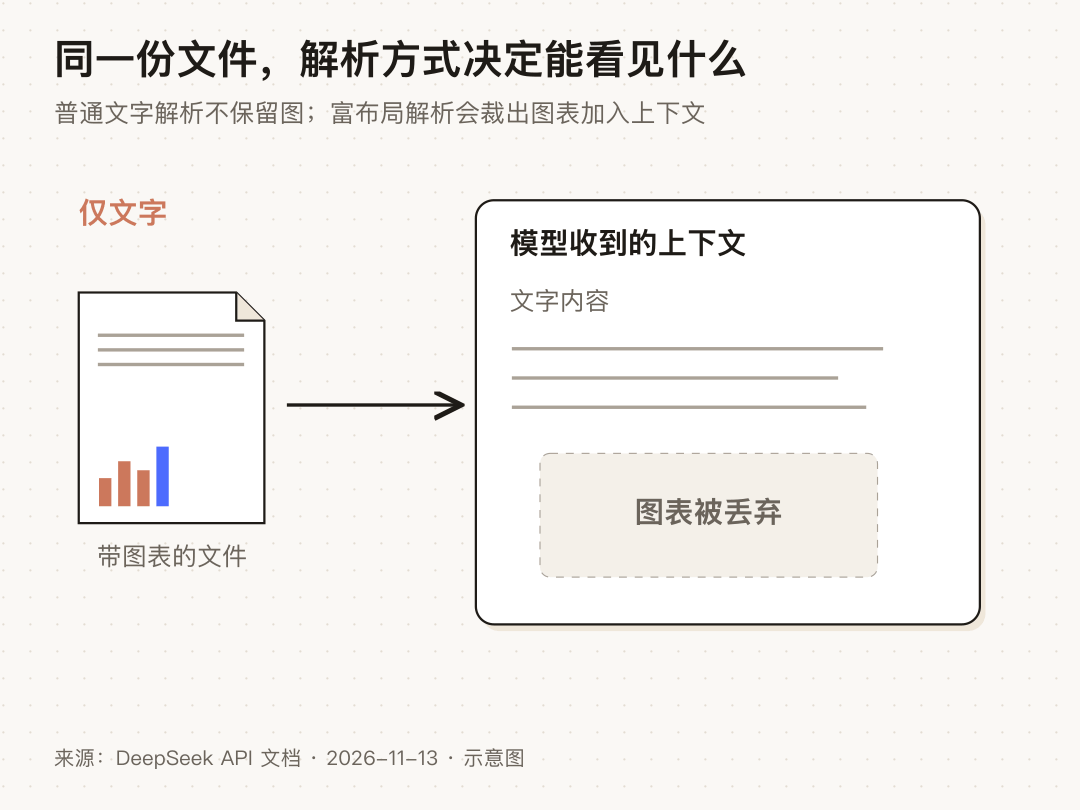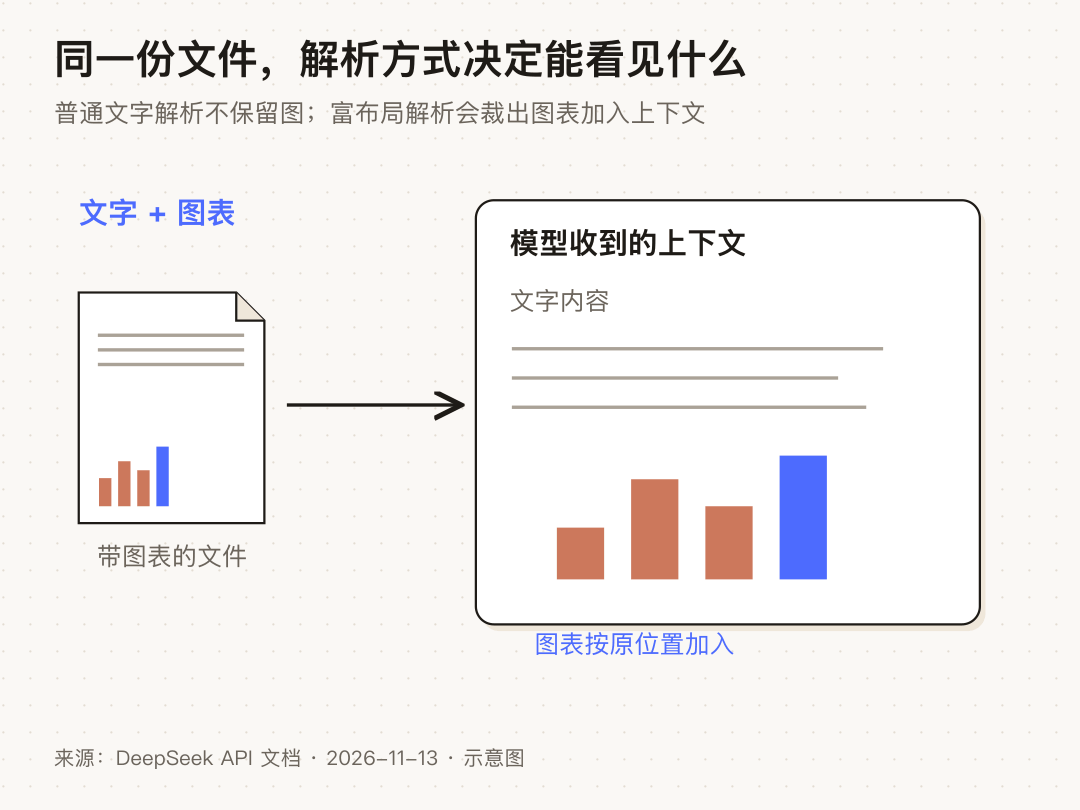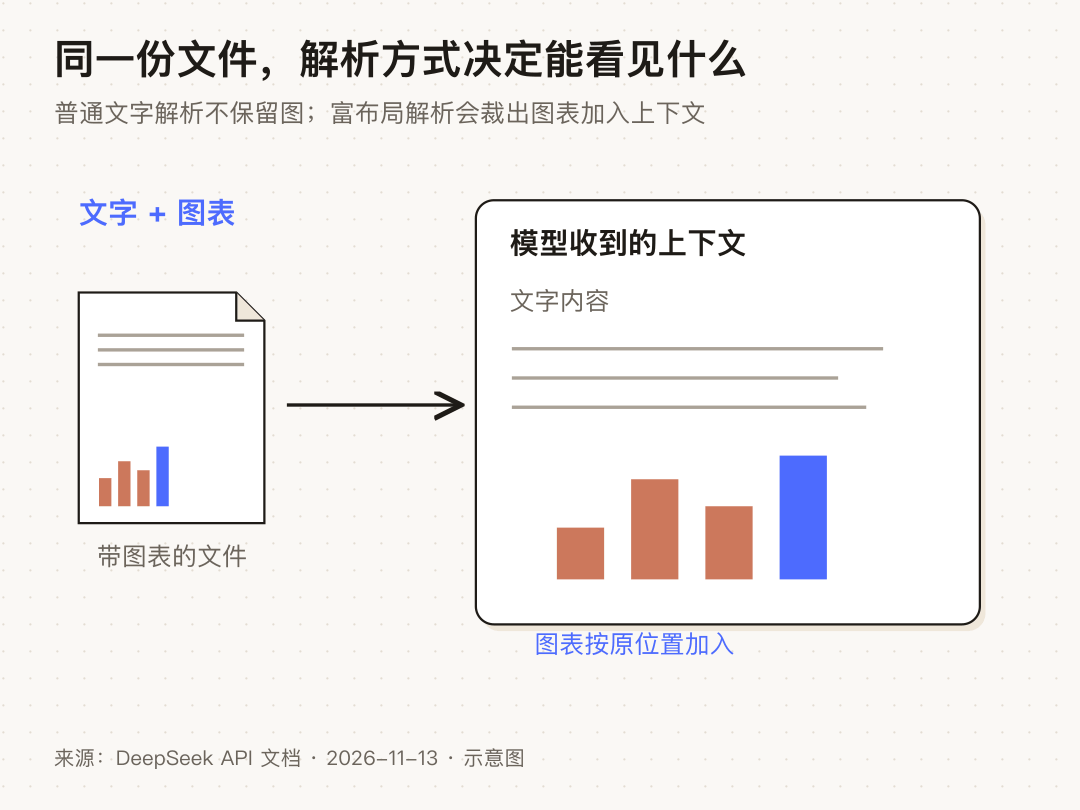
▲ 图:文档里的图也要进去
想问图表内容,就得选 rich_layout_recognition,系统会自动把图裁出来插回文字原位。
但这也有代价。裁出的图要算图像输入 token 钱,而且文档明说了,图表靠自动检测抓取,漏切了模型还是看不见。
其实也不用传什么都花钱。纯文本、CSV、代码文件,加上 Excel 表格和未加密的 EPUB、MOBI 电子书,上传时选 user_data 就免费转 Markdown。
走 Messages 协议的话,普通纯文字甚至能直接塞进请求里。手头只有扫描件想抽字也不用进聊天库,直接调独立 OCR 接口更干脆。
语音则拆成了听写和朗读两头,能各自嵌进自己的工作流。
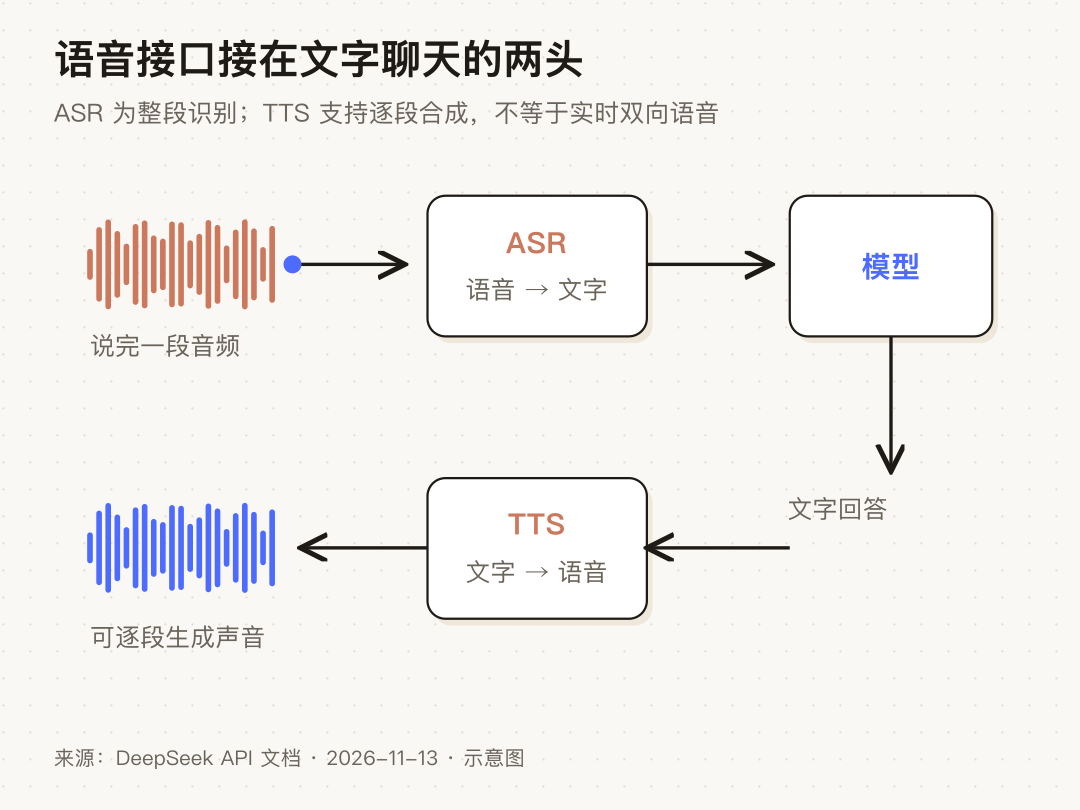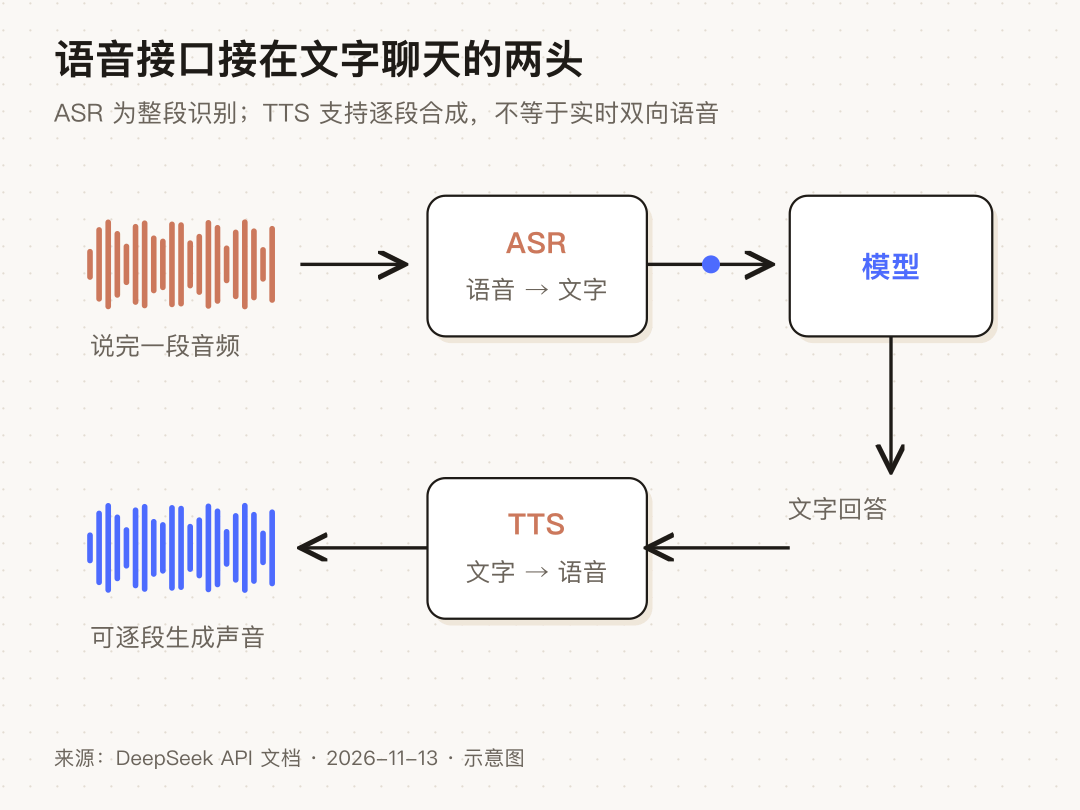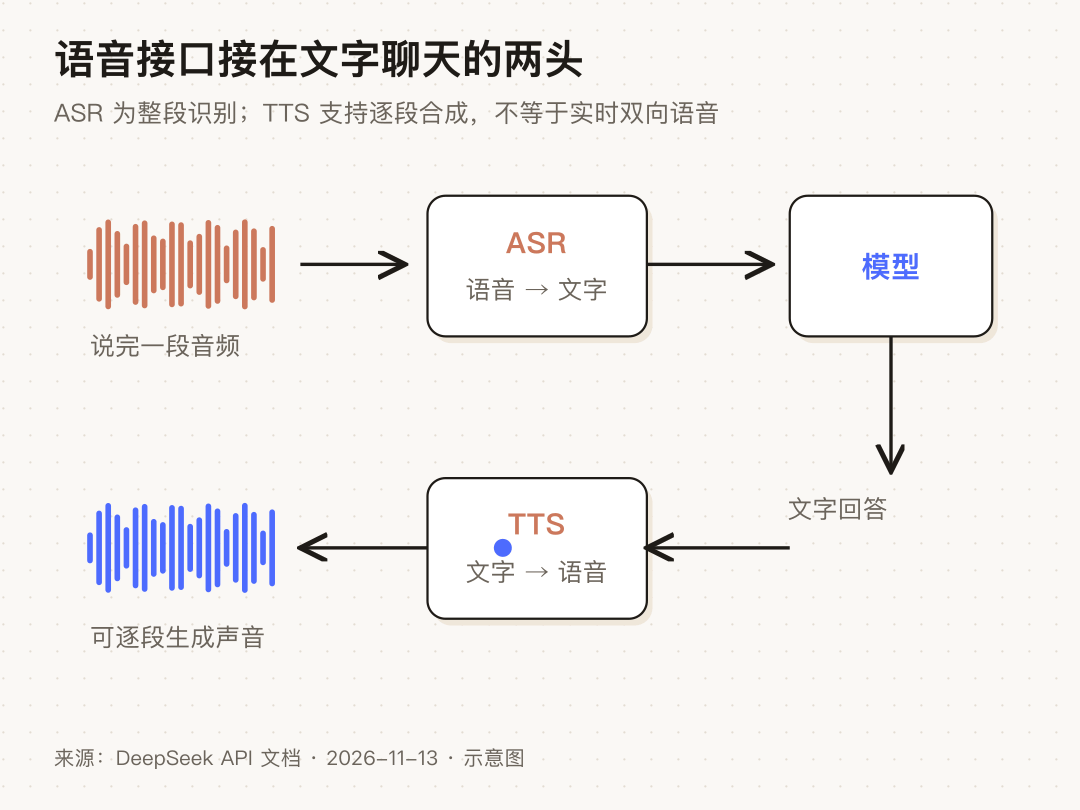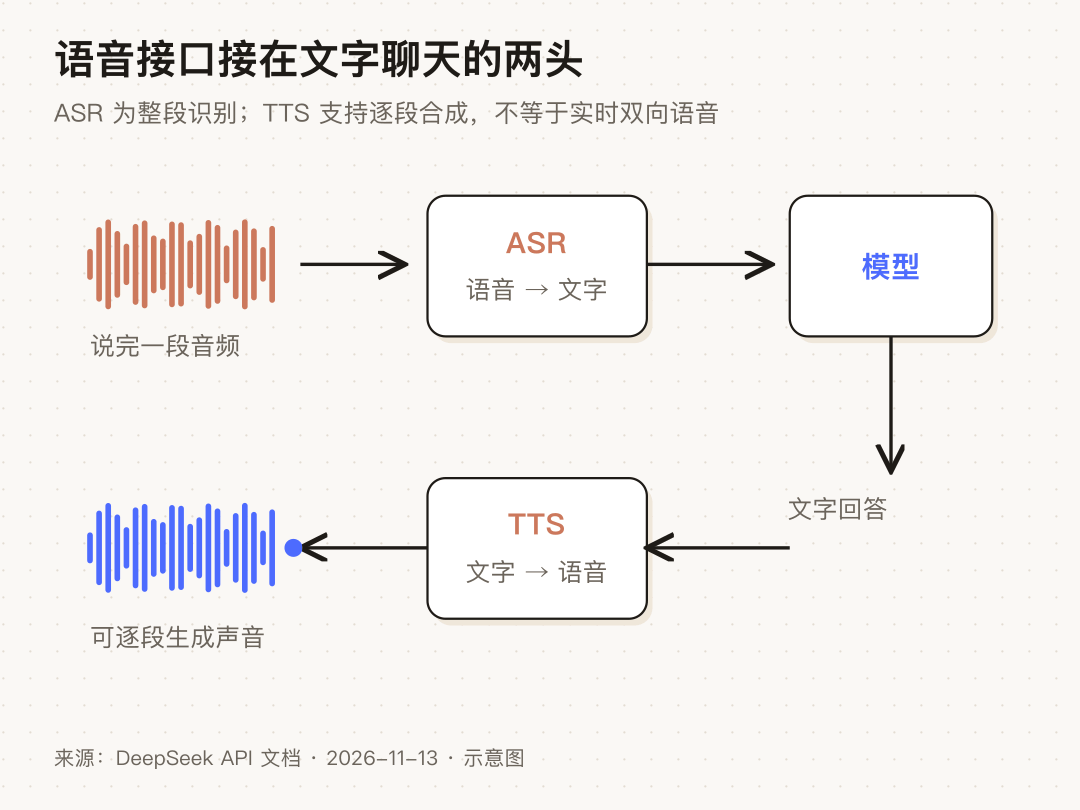
▲ 图:语音要经过文字这一站
听写接口 ASR 支持包括粤语在内的 21 种语言,不用手动填语种,上传就会自动识别。
限制也挺具体。录音得整段上传,最长两分钟、最大 8 MiB,还只认 16-bit PCM WAV 和 Ogg Opus 格式。
平时手机常用的 MP3 得先转码,双声道录音它也只认左声道,更不支持边说边出字。
朗读接口 TTS 倒能接 WebSocket,模型边生成文字,已经吐出来的那截就能先送去合成声音。
可惜音色太少,目前只有 stella 女声和 tide 男声两个,既不能调语速,断线也不能续传,单次上限一万计费字符。
拿来做微信那种按住说话、松手提问的语音入口很顺手。真想做成实时电话那样随时打断插嘴,这套接口拼不出来。
算一笔千次任务的账,工具费可能比模型还贵
DeepSeek 的模型 token 向来便宜,很多人算预算容易漏掉工具账,可这回工具费真不比模型少。
按官网最新价目表,搜一次(含搜图)和成功抓一页网页,单价都是每千次 0.75 美元。
文件解析和 OCR 每千页 0.225 美元。语音接口挂着限时半价,听写原价每小时 0.116 美元,朗读每万字符 0.45 美元。
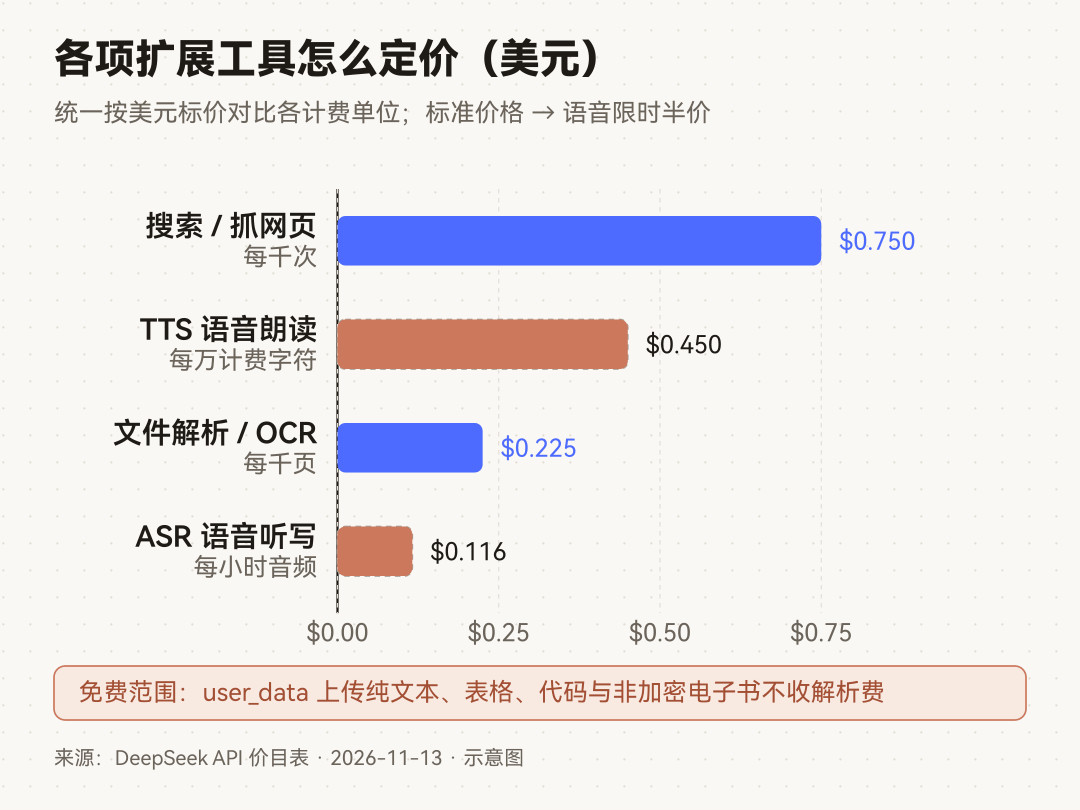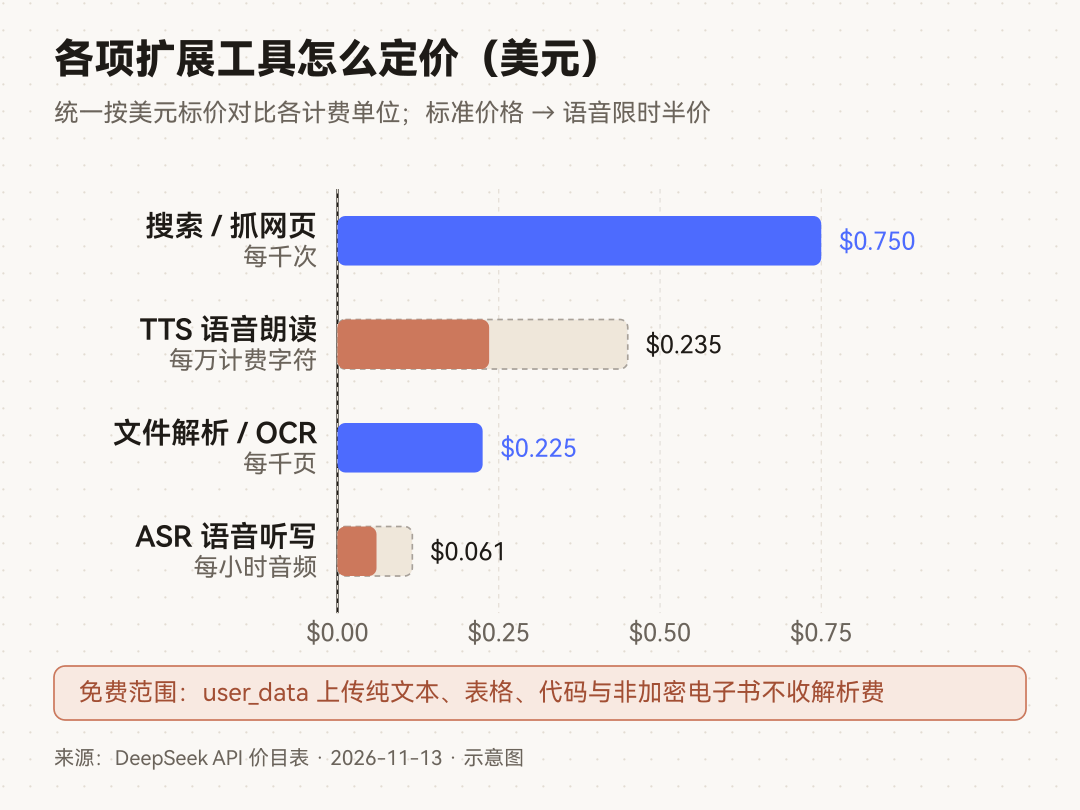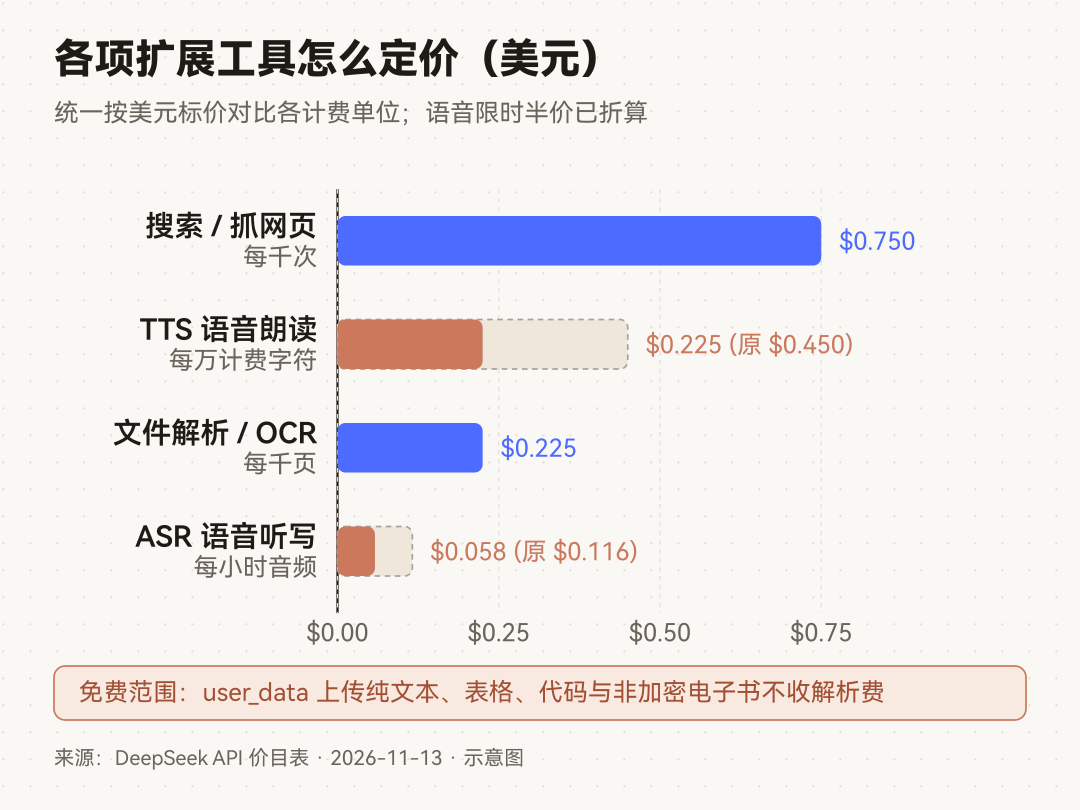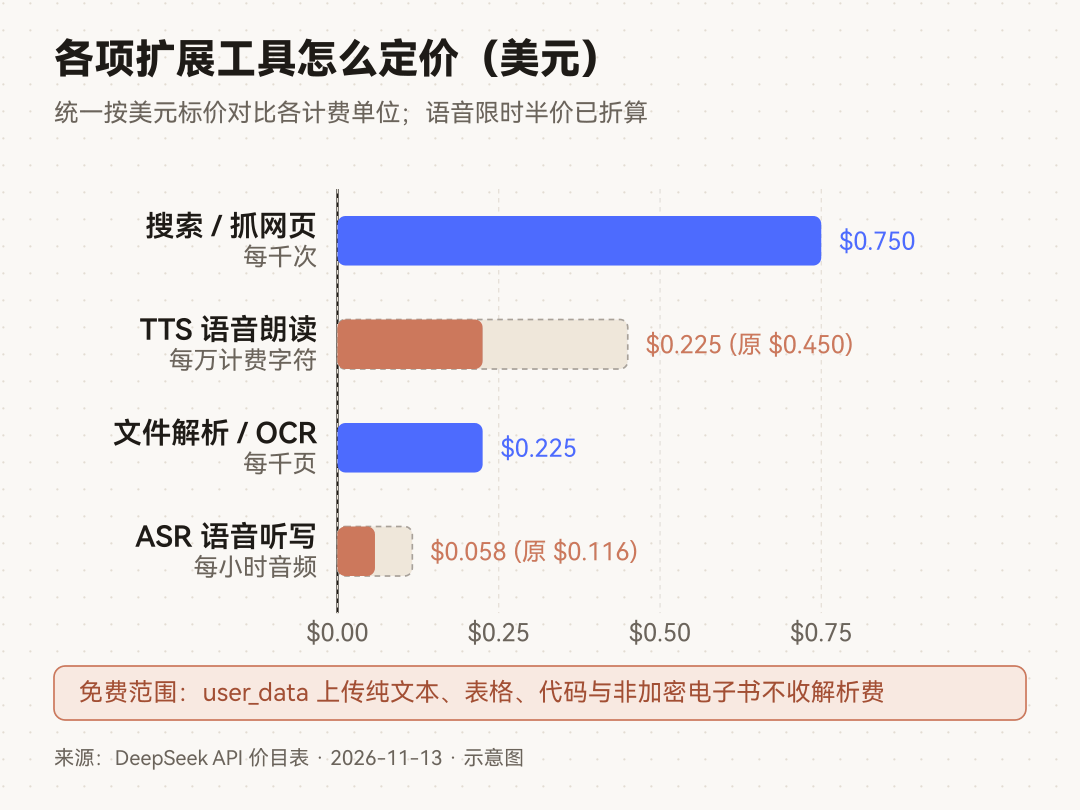
▲ 图:各扩展工具美元单价与半价折减
算这笔账最容易踩坑的是“按次计数”。一次深度思考如果同时发出三个搜索词,账单上就按三次搜来扣。
好在没结果或者抓取失败不扣钱。同一页在思考里反复翻看、页内找字,也有对应的免重复计费规则。
文件则只在上传解析时按页扣一次钱,后续围着它聊再多轮,只按正文和图片的输入 token 算。
顺着文档按中等用量推算一笔完整账单:假设每次联网提问发出三个有效搜索词,再成功抓取两页网页。
单算工具费,一次是 0.00375 美元,跑一千次就是 3.75 美元。
再看模型耗费,假设每轮累计吃进一万未命中缓存的输入 token、吐出一千输出 token,按 Flash 谷时价算,一千次只要 2.10 美元。
工具加模型凑一块儿,一千轮深度联网任务总共 5.85 美元。
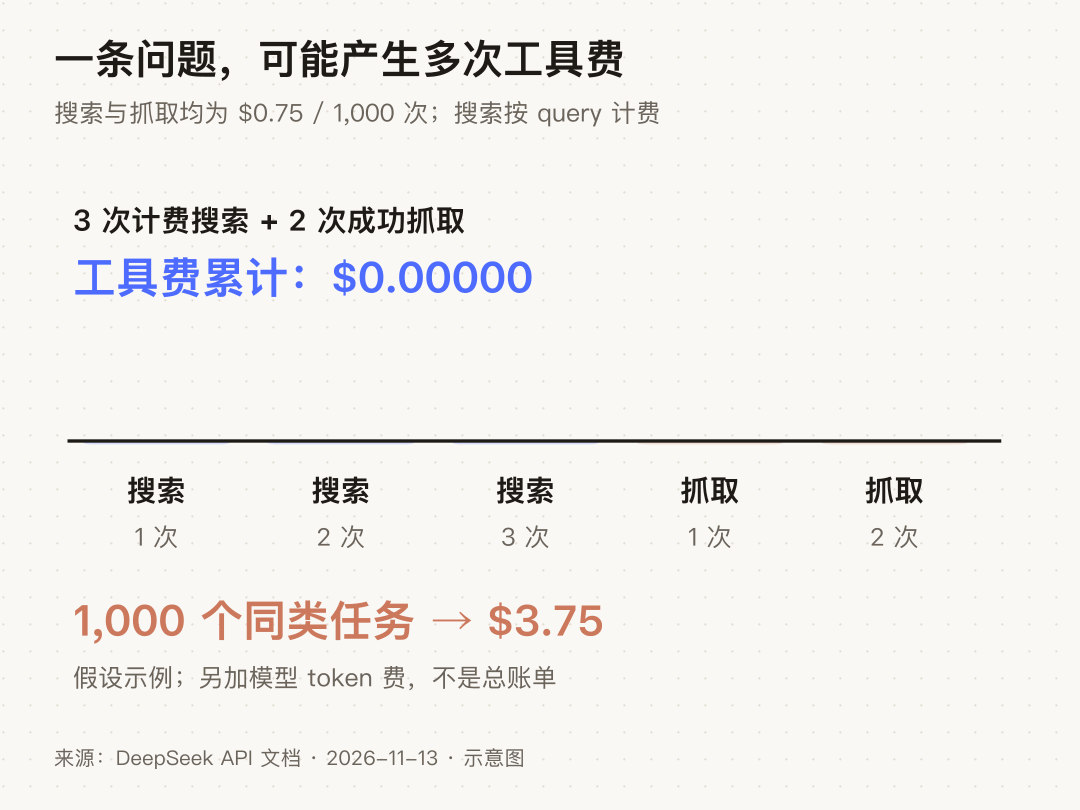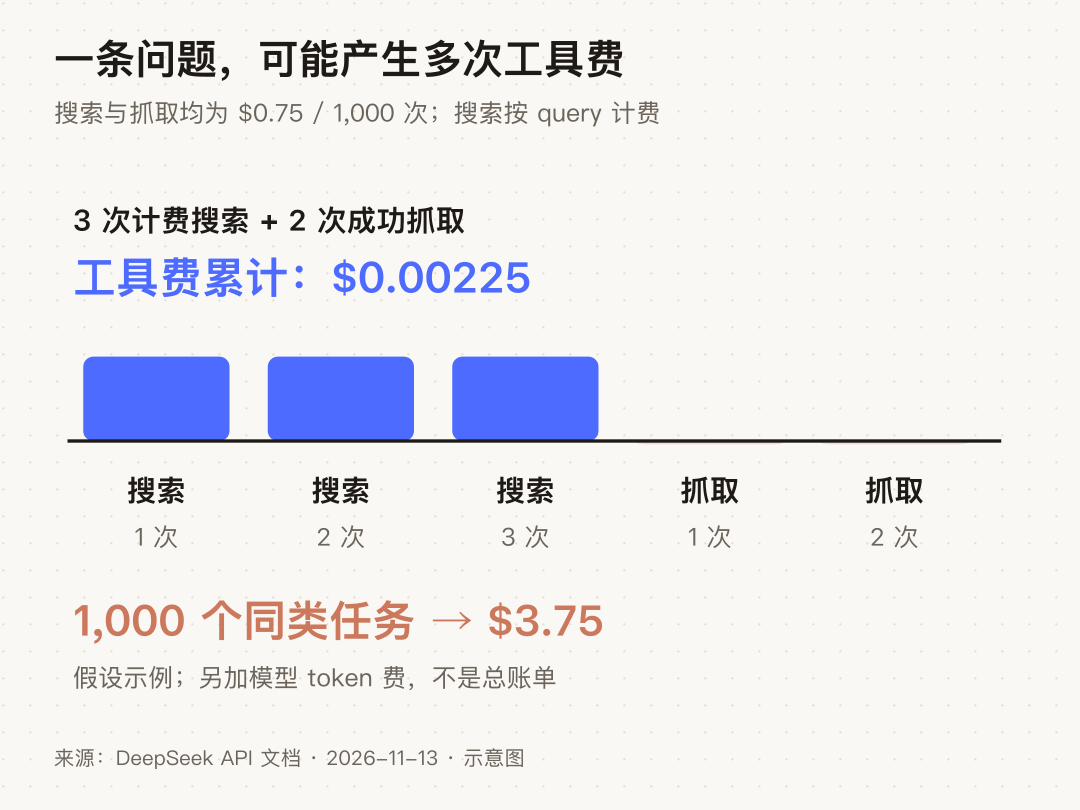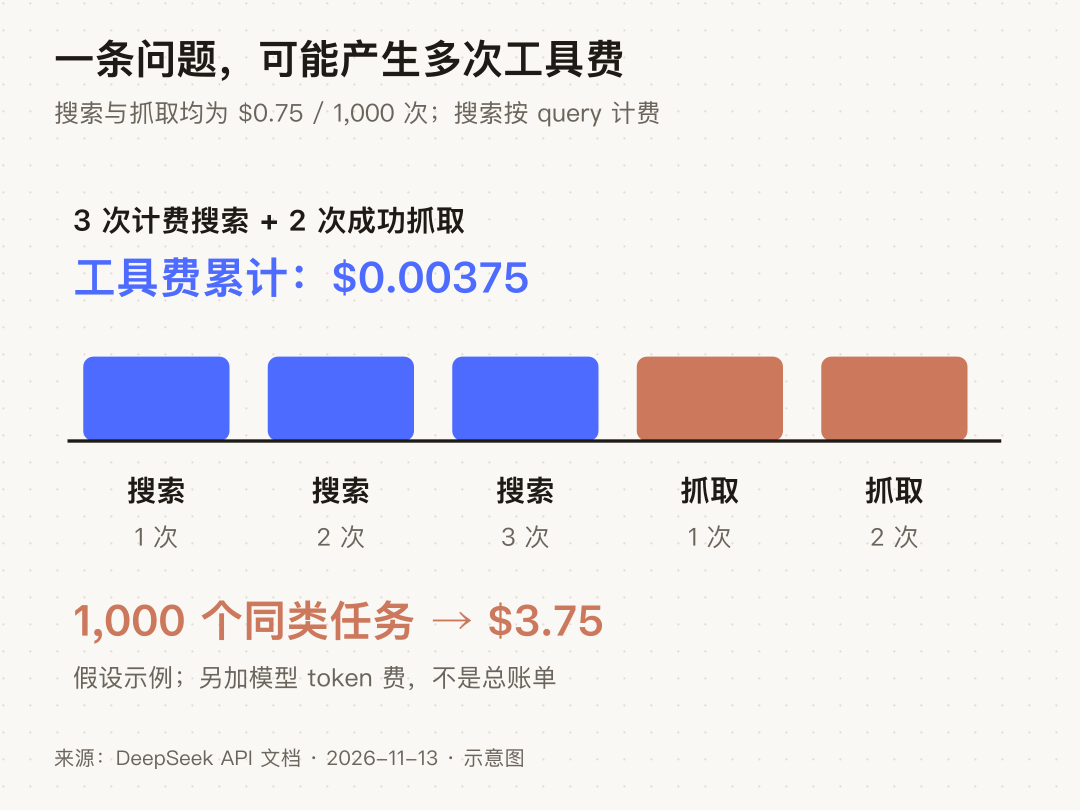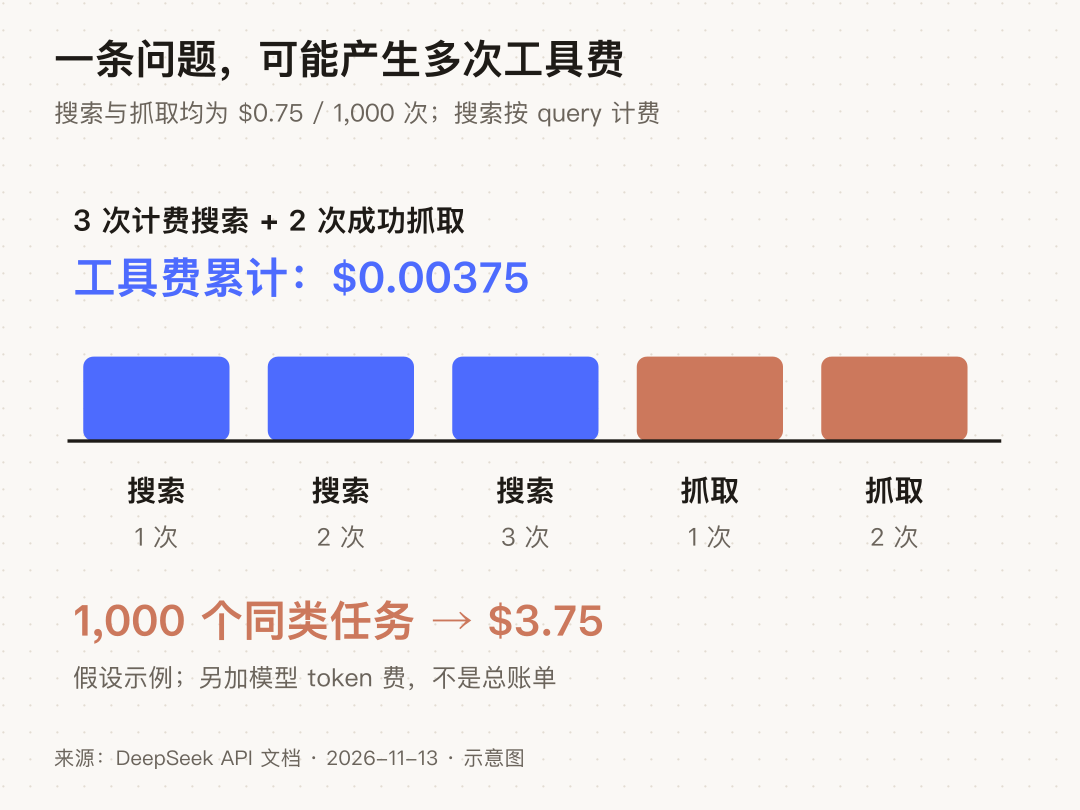
▲ 图:工具费怎样累加
你看这账就有意思了:配在 deepseek-flash 这种低价模型上,跑一轮多步检索,工具费反倒占了总开销的六成以上。
中文朗读还得留心字符算法。TTS 计费里一个汉字顶两个字符,单次一万字符上限,最多只能念大约五千汉字。
自己用或者小团队跑,这笔开销很轻松。真打算做高频公开产品,不卡死每轮搜索上限,工具费很快比 token 跑得还快。
想直接上手,先看懂开源前端的边界
懒得从零写代码,最省事的办法就是打开官方这次一起放出来的 chat-demo。
这个 MIT 协议开源的静态前端不用搭应用后端。点开在线地址,或者下压缩包双击 index.html,填上 Key 就能开聊。
深度思考、搜网页、读链接、传附件、自动起标题,连带语音输入和朗读全接齐了。
它还顺手加上了时间和地点标记,回答时知道今天是几号、用户在哪个城市。
对老用户来说,最香的是能迁移聊天记录。从 DeepSeek 官网导出的历史记录 ZIP 包,可以直接倒进这个本地页面里接着聊。
导入前记住两件事就行:导出包里只留文字和本地图片原件,不含密钥和其他文件。而且一确认导入,就会直接替换掉当前全部本地对话。
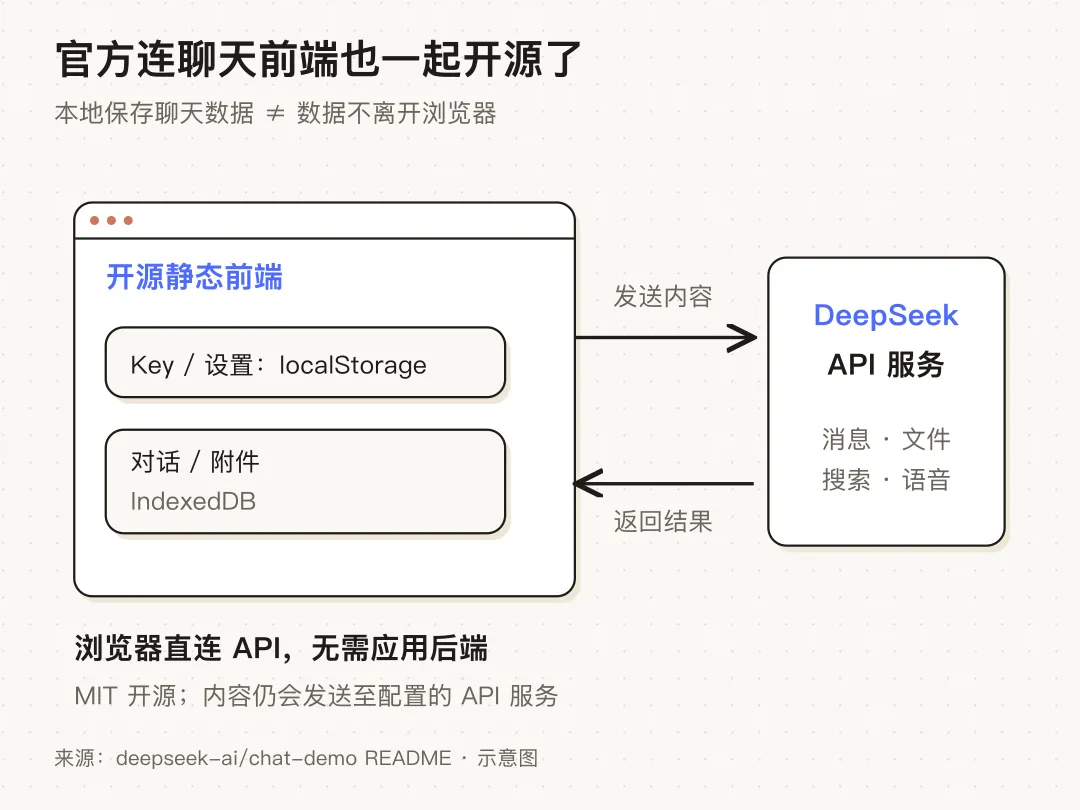
▲ 图:前端和接口怎样分工
看懂上面这张图,就能明白它的边界。密钥和记录虽然留在你自己的浏览器里,但只要发消息、传图或语音,数据还是会发给 API 服务端。
也正因为它是纯静态前端,千万别把 chat-demo 直接挂到公网上,再把自己的 API Key 写死给外人用。
那等于把自家钱包密码贴在网页源码里。这个前端只适合自己本地用,或者小范围各填各的密钥测试。
真要做面向公众的服务,除了自己老实搭层后端保住密钥,还得把官方要求的 safety_check 安全检查打开。
开启后,文字和版面解析裁出的图都会过一遍风控,撞到风险就直接拦截返回拒绝标记。
内容审核、大模型备案和 AI 生成内容标识这些合规责任,官方明确写了,还是得服务方自己扛。
把 App 的全套工具交出来,确实帮轻度开发者省了一大半基建功夫。
但 V4-Pro 还没接入,工具单价也压过了 Flash 算力。
个人拿 chat-demo 配自己的密钥做个顺手工作台很香,真要往外推产品,先把搜索限额和后端鉴权算明白再动。
参考资料
01|DeepSeek:App 能力开放公告https://api-docs.deepseek.com/news/news261113
02|DeepSeek:聊天应用接入指南https://api-docs.deepseek.com/guides/build_a_chatbot
03|DeepSeek:Web Toolshttps://api-docs.deepseek.com/guides/web_tools
04|DeepSeek:模型与工具计费https://api-docs.deepseek.com/quick_start/pricing
05|DeepSeek:chat-demo 开源仓库https://github.com/deepseek-ai/chat-demo