ARTICLE · 1355221
Meta新插件没解决风控,它把风控交给了你
插件出来一天,基本都在讲它能干什么:替你盯着某个页面等更新,替你把一堆表填了,替你把每天要点一遍的东西点完。
这些我都不太关心。我关心的是另一件事:它凭什么能这么干。
因为风控这道题没被解开,只是换了个付账的人。
Meta 在 11 月 13 日放出的这个 Chrome 插件,把 Muse 从云端搬进你的浏览器。它没有让机器更像人,它让机器用上了人的身份证。
01
云端那堵墙,是谁在付成本
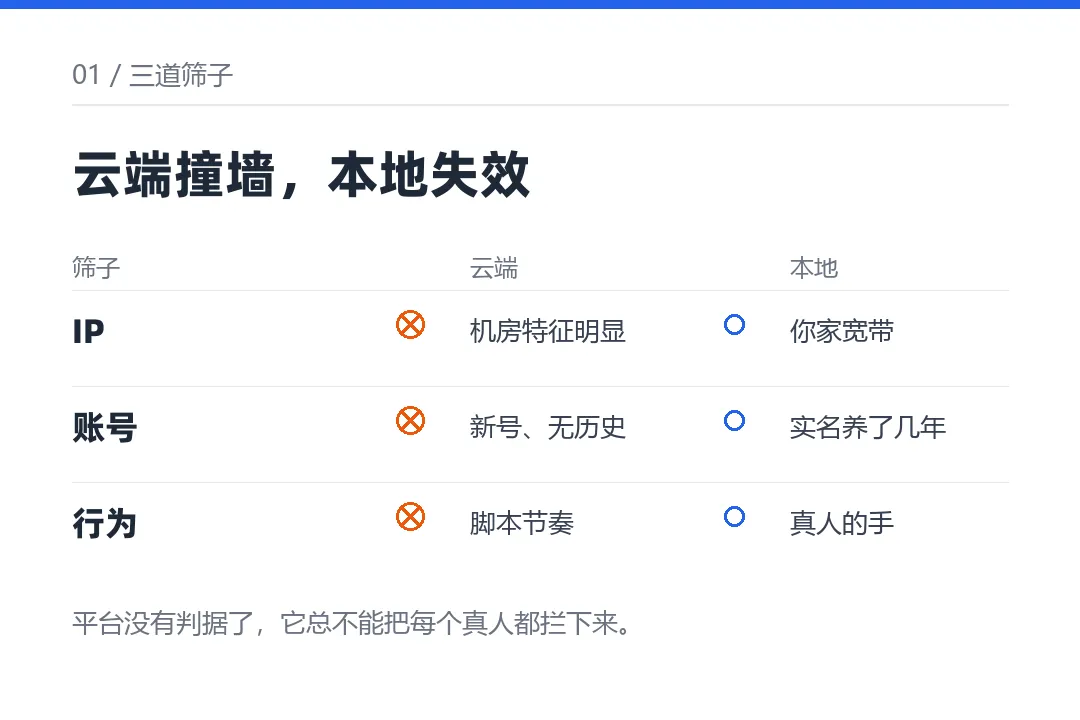
过去两年,云端 agent 撞的从来不是技术墙。模型早就会点按钮、会填表。撞的是三道筛子:这个 IP 像不像机房,这个账号像不像新号,这个行为像不像脚本。
这三道筛子,成本是平台在付。它得养一套风控,得雇人审申诉,得承受误封的骂名。你付的只是不便:验证码、等短信、任务跑到一半断掉。
搬到本地之后,三道筛子同时失效。流量是你家宽带的,Cookie 是你自己攒的,账号是你实名养了几年的。平台没有判据了——它总不能把每个真人都当机器人拦下来。
所以这不是"解决了风控",是"风控失效了"。这两件事听起来像一个,实际上差得很远。前者是技术进展,后者是成本转移。
02
账不会消失,只会换个人付
平台那侧的成本降下来了,降下来的部分不会凭空消失。它落到三个地方。
第一,归因。Meta 写在帮助页里:Muse 用你的 Chrome 时,浏览器和它访问的网站会按它的活动收集信息,并把这些活动算在你头上。可能进你的 Google 账号活动,也可能影响你看到的广告和推荐。
第二,撤回。读错了可以重读,发出去的东西收不回。这是 agent 和脚本最大的区别:脚本出错是日志里多一行,agent 出错是别人的通知栏里多一条。
第三,申诉。账号被判定的那天,你得用真人身份去证明自己是真人,而它已经换了个任务在跑。
还有个数字值得摆出来。免费一档每周 1 亿 token,20 美元一档 5 亿,100 美元一档 30 亿。听着用不完,按一次任务 6 个页面、每页读 3 遍、3000 字正文加 1000 的截图算,一次 7.2 万,一周约 1400 次,一天 200 次。够用。但一张截图顶三分之一页文字,先见底的从来不是字,是图。
四行里三行往下走了。技术上更顺,治理上更糟。这就是我对这次更新的全部判断。
03
该不该放权,我只问三句
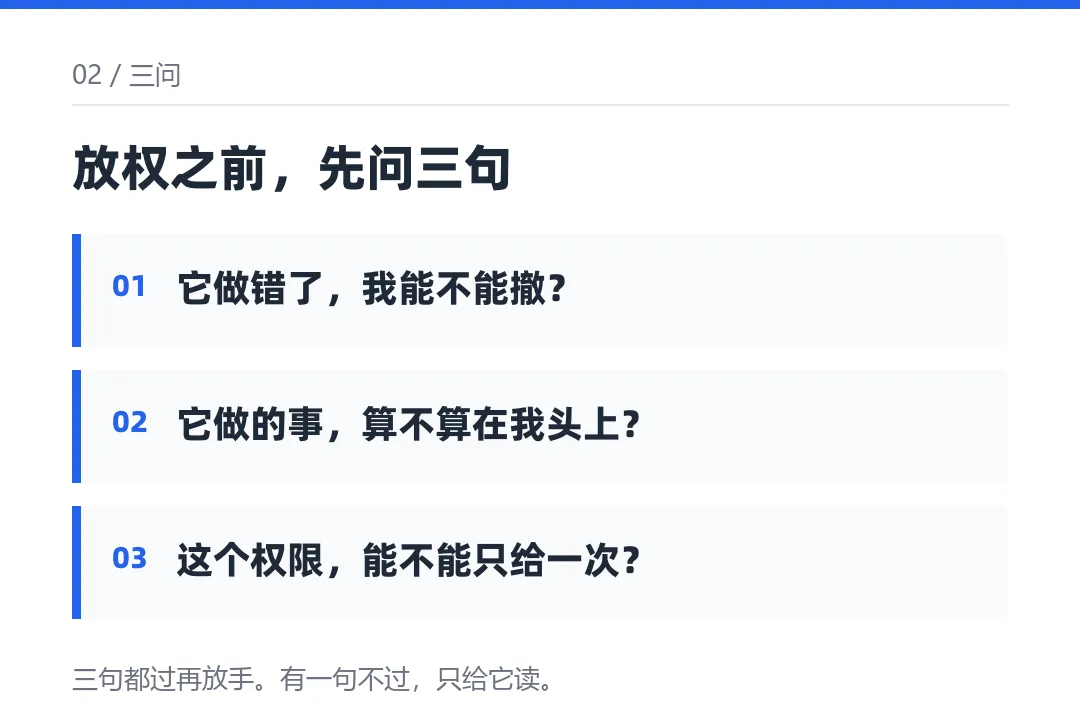
既然成本落到了我这边,我就得有一把尺。这一年试下来,能用的只有三句。
一、它做错了,我能不能撤?能撤的,放。撤不回的,留手。
二、它做的事,别人会不会算成我做的?算不到我头上的,随意。算得到我头上的,要么换号,要么不给。
三、这个权限,能不能只给一次?只能长期挂着的权限,等于把你的门钥匙复制一把放门口。
三句都过,放手。任何一句不过,只给它读。
拿这三句去过一遍最常被提到的用法,一个能过,一个不能。
能过的是盯视频。给它一个 YouTube 频道,新视频出来就把字幕拉下来,按段落整理成要点,再把同一频道的几条并成一份清单。Muse 本来就能读 YouTube 的字幕,接个连接器的事,不需要它多聪明,只需要它耐心。能撤——清单拉错了重拉一遍就是;算不到你头上——你只是看;权限一项一项给——三句全过,这种活早该交出去。
现在它也能自己在后台发视频了。但有个问题得先问:平台的风控会不会跟着加码。能跑通是一回事,跑得稳是另一回事——速度肯定比不上人,一步要多看两眼;新软件前期的细节,也不能全信
。别急着下结论,在自己的业务场景里多跑几轮,才知道它到底能不能用。
我没在任何一个公开渠道看到这三套玩法的实测。插件才 126 个用户,商店评论都没几条。现在把它们当"跑通了"讲,是拿设想当结果。
04
126 个人时它是干净的
现在有人说这插件安全:看不到你的密码、看不到浏览历史、看不到 Chrome 设置,网页上的密码文字在读之前就被抹掉。这几条我信。
但我觉得它安全的原因,跟设计关系不大。
126 个用户,等于 126 个愿意折腾的人的 126 个测试号。这个体量下,任何方案看起来都干净。麻烦是随规模来的:样本一多,误判、越权、被站点盯上,全都会长出来。
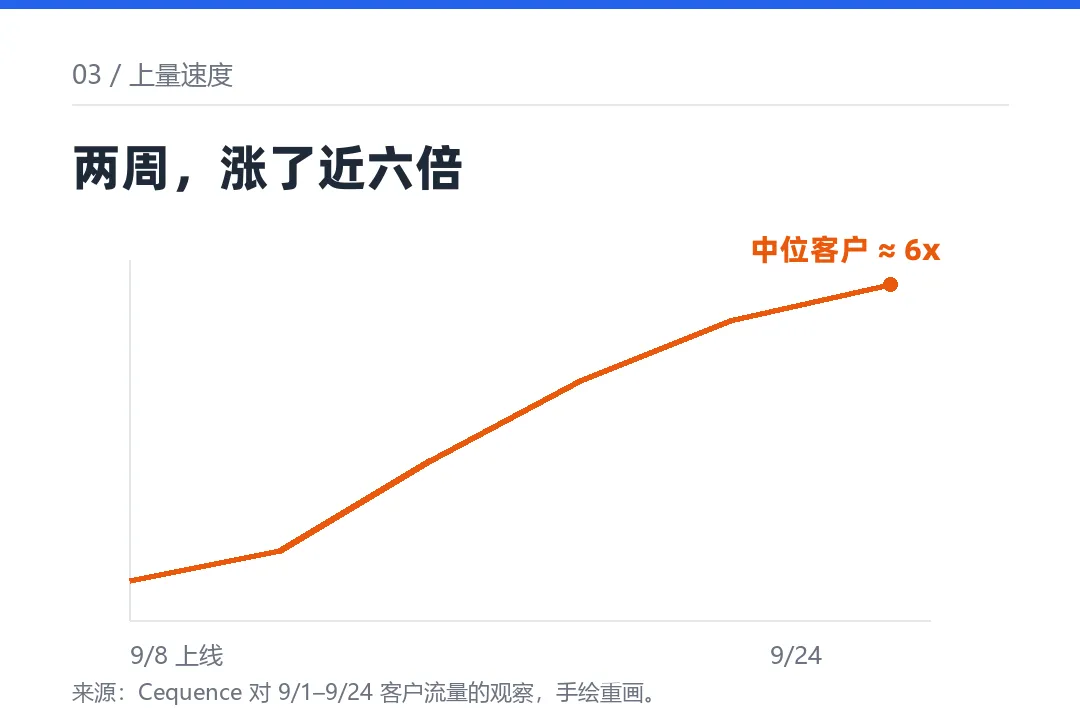
有个数据可以当参照。安全厂商 Cequence 看过九月 1 日到 24 日的客户流量:Muse 是 9 月 8 日上线的,不到两周,它出现在一半以上被观察客户的流量里,中位客户的量涨了近 6 倍。在金融机构,它替用户登录了账户,还过了多因素认证。
另外一个细节更值得记:Muse 在流量里把自己标成一个普通的 Chrome,不标 agent。网站看不出这是机器,也拦不住。
不被识别,是它现在顺滑的原因,也是它以后一定会被算账的原因。今天没有人管,是因为量还小。
顺着这条看,我更确定一件事:这不是模型之争,是入口之争。Meta 手里有 Facebook、Instagram、WhatsApp 的账号体系,Google 手里有 Chrome 和一个每天都在登的账号,OpenAI 手里只有 ChatGPT——它没有一个天天开着的浏览器。
模型差半档可以追。身份这一层,谁先占住谁就少走两年。
05
我会怎么用它
说清楚一点:现在只对美国 18 岁以上开放,国内装不上,但用法可以先定,工具会换,规矩不用换。
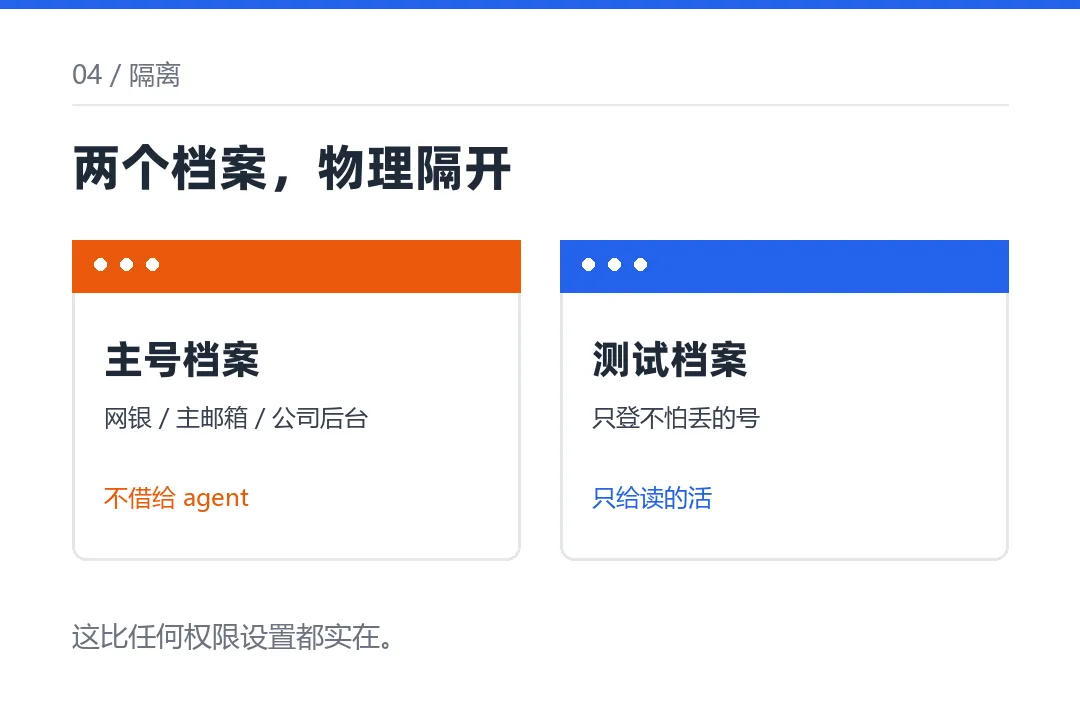
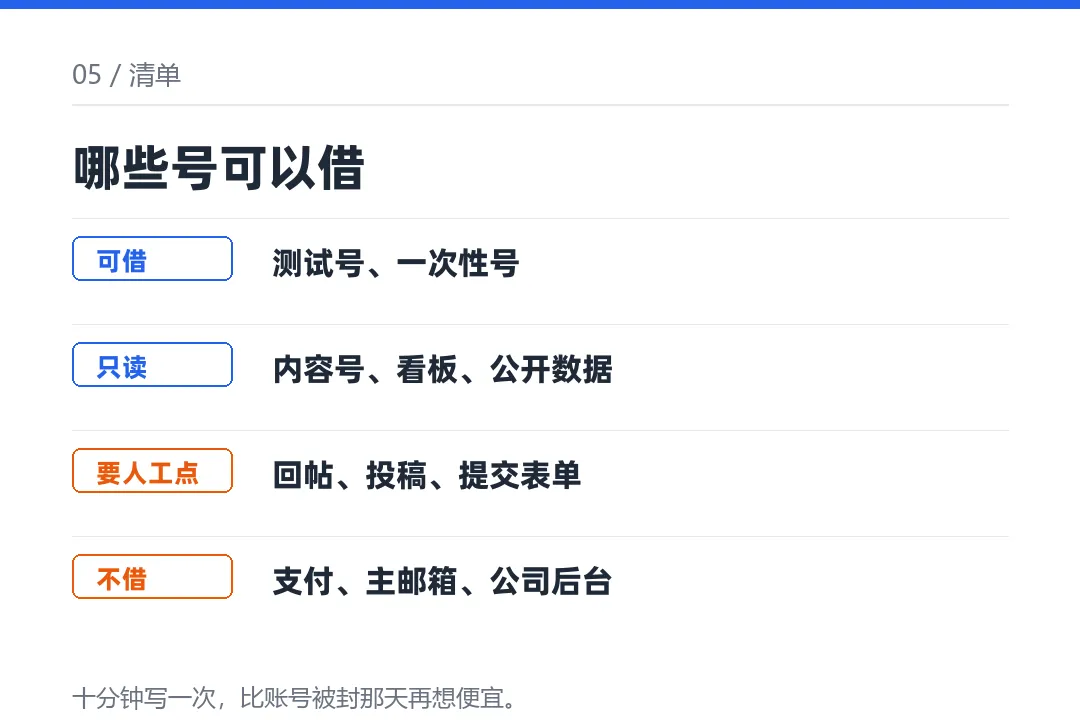
我会给它单独一个 Chrome Profile。里面只登测试号、只登不怕丢的号。网银、主邮箱、公司后台放在另一个档案里,物理隔开。这是唯一有效的一层隔离,比任何权限设置都实在。
它跑起来的时候,你可以去干别的,它就在那个标签组里继续点。方便是真的,可你不在看的时候,才最需要前面那三问。
我只让它读。筛帖、归类、汇总、截图、把一堆页面压成一份清单——这些出错的最坏结果是给我一份脏数据,我自己过一遍。这类活我一点不心疼。
要发的东西,最后一下我自己点。不是不信它,是不想让一个概率问题变成账号问题。
每周问它一次:把你这周访问过的网址列出来。它答得出来,说明可追溯;答不出来,说明我根本不知道它干了什么。这一问比任何隐私条款都好用。
最后一句可能不中听:这个插件现在被夸得这么干净,一半是因为它还没上量。等它有一千万用户,今天这些"安全承诺"会一条条变成"在特定条件下成立"。
到那天,占便宜的不会是用它的人,是早就把哪些号能借、哪些不能借写下来的人。
它省下你三次登录,换走你一段时间里的身份。这笔账不算亏,但你得知道自己付了什么。
🎁 关注公众号 脉路AI实验室 ,了解更多AI赋能姿势~。