ARTICLE · 1355715
从一堆Excel到一套系统:项目管理+研发管理双门户的落地实践
从一堆 Excel 到一套系统:项目管理 + 研发管理双门户的落地实践
技术栈:React 18 + TypeScript + Vite + Tailwind / Node + Express + TypeORM + MySQL 8
规模:3.4 万行代码、40 张表、168 个接口、96 项权限、35 个页面
交付形态:Linux deb 包 + Windows 免安装 exe
先说结论:这不是一个“什么都能干”的平台,而是一个专门治「项目管理和研发流程各玩各的」这个病的内部系统。写完这篇,你会看到它的取舍——哪些地方我故意做得很土,哪些地方宁可多写两百行也不引库。
一、痛点:不是没有工具,是工具之间不通
场景一:项目进度永远在“我发你一下”
一个项目立项之后,进度在一个 Excel 里,工时在另一个表里,风险清单在第三个文件里,验收资料在某个人的微信收藏里。
周五下午领导问“这个项目到哪一步了”,答案取决于谁在线、谁还记得文件放在哪个群的哪个压缩包里。
场景二:研发流程写在制度里,活在流程之外
研发这边跑的是 IPD(集成产品开发):概念、计划、开发、验证、发布、生命周期六个阶段,中间四个决策评审点(DCP)。制度文档写得很漂亮,实际执行是这样的——
需求评审在会议室白板上,交付物在每个人自己的电脑里,阶段门过没过全靠项目经理一句话。等产品上市出了问题回头看,“当初这个评审到底谁签的字”查不到。
场景三:买来的系统,买不起的是人
试过商用产品。功能确实全,问题是:要专职实施顾问、要按它的方法论改我们的流程、要上云、数据要存到别人服务器上。
我们这边的硬约束是四条:
- 纯内网
,服务器不给外网 IP - 不能上云
,图纸和需求文档不能出内网 - IT 只有半个人
(还有别的活),不能要求会 Linux 运维 - 必须能装在 Windows 上双击运行
,因为有几个部门的机器是 Windows
所以最后选了自研。不是为了炫技,是因为市面上没有“能塞进这个笼子”的成品。
二、整体架构:一个服务,别给自己找事
先看图。这是请求走到哪、哪些组件是必需品、哪些是加速器: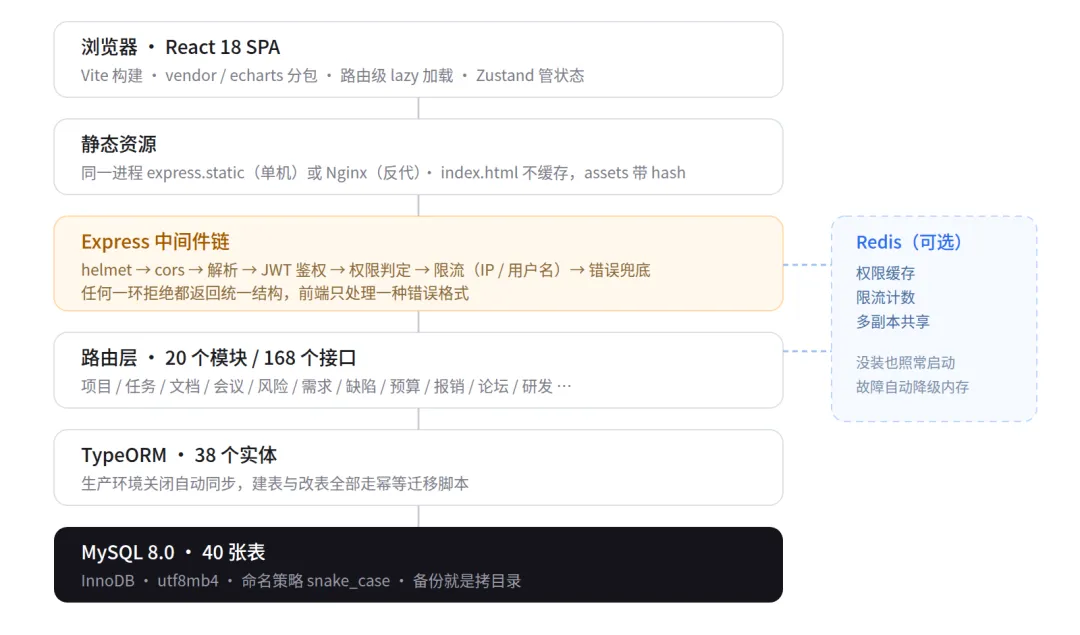
为什么是单体,不是微服务
说实话,这个系统的峰值并发大概几十——一个五百人规模的公司,早晨九点半集中登录,剩下的时间就是零星操作。
这种负载上微服务,得到的不是弹性,是多出来的几个部署单元、几套日志、几个要排查的故障点,以及一个从此不敢改数据库的团队。
所以:一个 Express 进程 + 一个 MySQL。168 个接口在一个进程里,要扩就先加机器,加机器不够就上 PM2 cluster,再不够再谈拆分。
分层长什么样
client/ 前端单页应用src/pages/ 35 个页面(27 个业务页 + 8 个研发页)src/components/ 布局外壳、侧边栏、顶栏、通用组件src/config/nav.ts 菜单与路由权限的唯一来源(下面重点讲)src/store/ Zustand:auth / appserver/ 后端src/routes/ 20 个路由模块,168 个接口src/entities/ 38 个 TypeORM 实体,对应 40 张表src/middleware/ auth / 限流 / 权限src/utils/ schema 迁移、种子数据、runtime 开关
前端用 Vite 构建,路由级 lazy(),状态只有两个 store(认证 + 全局 UI),没有 Redux,没有 RTK Query。后端没有 service 层套 controller 套 repository 那套三层——Express 路由 + TypeORM 实体,业务逻辑就在路由和实体方法里,看得见、改得动。 这个结构不优雅,但三个月后回来改需求的人(可能还是我)能十分钟找到地方。对我们这种没有专职架构师维护的团队,这是最高优先级。
三、双门户:一套账号,两种工作台
这是最近做的一次改造,也是我觉得最值得说的一段。
问题
项目管理和研发管理,用户群基本不重叠:
项目经理、PMO:天天看项目、预算、风险、会议 IPMT 委员、PDT 经理:只看研发的看板、阶段门、交付物、工时
最早研发管理只是侧边栏里的一个分组。结果研发同事登录进来,左边一屏全是“项目、财务、风险、费用报销”——他一个都用不上,还得每次自己往下滚找研发那几项。
两种错误解法
做法 A:拆成两个系统、两个域名、两套账号。
用户立刻会问:“我为什么要记两个密码?”更麻烦的是数据:同一个人在两个系统里是两条用户记录,项目成员关系要同步两遍,权限要配两遍。半年后必然出现“A 系统里能看到,B 系统里看不到”的扯皮。
做法 B:还是一个系统,只在登录后按权限过滤菜单。
这就是改造前的样子。问题是:研发同事的首页是“仪表盘”(项目统计),对一个只做研发评审的人来说,那屏数字跟他毫无关系。
最终做法:一个后端,两层外壳
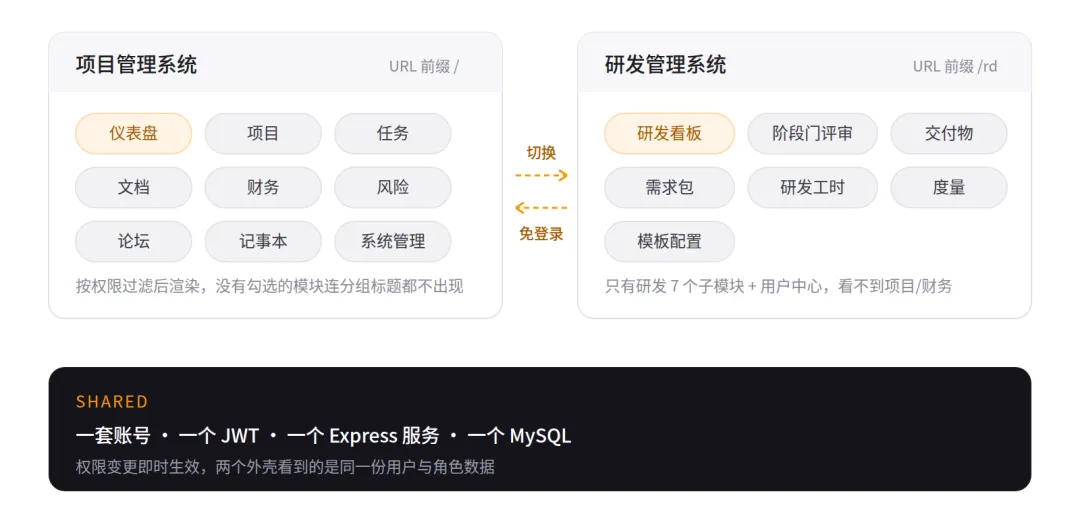
关键设计只有一句话:外壳由 URL 前缀决定,不由状态决定。
// App.tsx<Route path="/rd/*" element={<RdLayout />}> {/* /rd/* 全部走研发外壳 */}...</Route><Routepath="/*"element={<PmsLayout />}> {/* 其余走主系统外壳 */}...</Route>
一开始我想的是“用一个 activeSystem 状态控制渲染哪个外壳”。写到一半发现这是个坑:状态和地址栏会不一致——用户手敲 /rd/gates 进来,状态还停在 pms,于是渲染主系统外壳 + 研发页面,或者干脆撞权限墙。
改成 URL 派生之后,跳转就是普通跳转,不存在“状态和地址栏打架”这种死锁。activeSystem 只剩两个职责:决定登录后落哪个首页、决定顶栏切换胶囊的文案。
两层外壳共用同一个 PortalLayout:
// components/Layout.tsx —— 主系统,10 行export default function Layout() {return <PortalLayoutportal="pms"groups={pmsNavGroups}extraGroups={isAdmin ? [rdModuleGroup] : undefined} />;}// components/RdLayout.tsx —— 研发系统,8 行export default function RdLayout() {return <PortalLayoutportal="rd"groups={rdNavGroups} />;}
侧边栏、顶栏、会话恢复、消息提示、页脚全在 PortalLayout 里。两个门户的差异只有三处:菜单数据、品牌名、顶栏显示哪些按钮(研发门户里没有全局搜索和用户管理入口)。
登录时选系统,但绝不把人拦在门外
登录页密码下面加了两个卡片:进入项目管理系统 / 进入研发管理系统。选择记在 localStorage,下次预选。
判定逻辑就一条:选哪个校验哪个,没权限就降级到另一个,两个都没有才停在“无可用模块”页。
选了研发 → 有 menu_rd_* 权限?是 → 落地 /rd否 → 有主系统权限?→ 是:落地 /dashboard + toast 提示→ 否:/no-access
为什么不直接报错“该账户未开通研发管理系统”?
因为用户记不住自己有哪个系统的权限。把他拦在登录页,他只会做一件事:打电话给管理员。让他进去 + 顶部提示一句,问题自己就解决了。
顺带解决的越权直达
RequirePermission 里原来的兜底是 Navigate to="/"。这次改成跳「本门户第一个能访问的页面」:
// 没有研发权限的人手敲 /rd/gates// → 跳他自己门户里的第一个可访问页,而不是固定回 /if (!hasPermission) {return <Navigateto={getFirstAllowedPath(hasAny,portal)} replace />;}
为什么要改?因为固定跳 / 会遇到这种情况:用户被取消了「首页」权限,但 / 对应仪表盘,仪表盘他还能看(因为他有项目查看权限)——于是他在两个页面之间来回弹,看起来像“权限没生效”。
四、权限:全系统只能有一个源
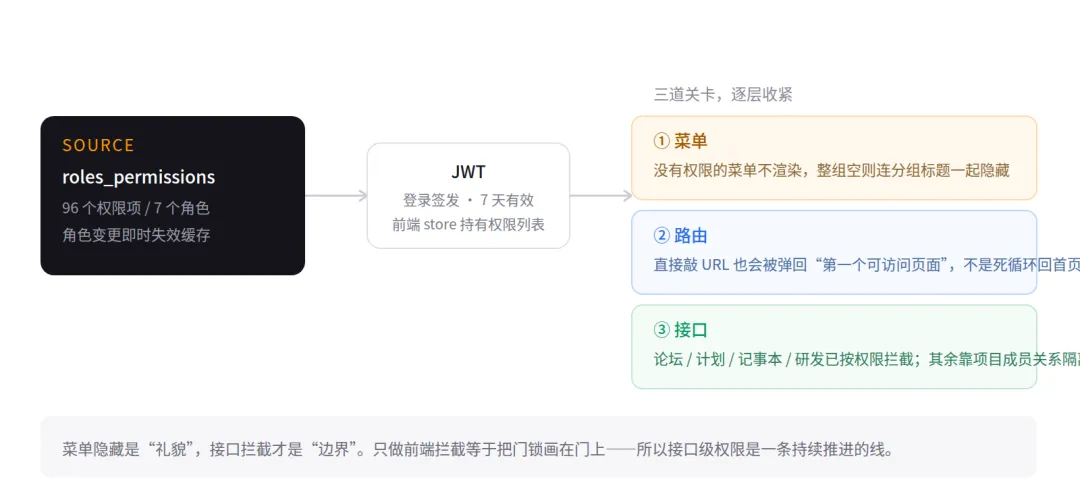
现在系统里 96 项权限、7 个角色。粒度做到按钮级和页面级混合:
menu_*管菜单和页面入口 *_view / *_create / *_edit / *_delete / *_approve管具体动作 能提交和能审批必须拆成两个权限,因为审批人通常不是提交人
三道关卡
Sidebar | |||
RequirePermission | |||
requirePermission('xxx') |
前两层是体验,第三层才是安全边界。这点必须说清楚:菜单隐藏不等于数据安全。我们的接口目前是“部分有权限中间件、全部要求登录”——论坛、计划、记事本、研发模块做了接口级校验;会议、风险这类模块还是靠项目成员关系做数据隔离,没有按菜单权限拦截。
这是有意的取舍(168 个接口逐个加中间件,工作量比收益大),但你得知道自己漏在哪,别以为藏了菜单就安全了。
唯一数据源:nav.ts
这是踩过坑之后重写的。改造前的 Sidebar.tsx 有 29 个菜单项,只有 10 个声明了 permissions,剩下的走这段逻辑:
// 危险:没有 permissions 就无条件放行group.items.filter(item => !item.permissions || hasAnyPermission(item.permissions))
结果就是用户反馈的那个 bug:在角色权限里取消勾选“项目管理、财务、风险管理、会议管理、首页”,登录进去这些模块照样在。
因为那 19 个没写 permissions 的菜单项,代码认为“没权限要求 = 人人可进”。home_page 更惨——前端从头到尾就没校验过它,仪表盘永远能进。
修法不是挨个补上 permissions,而是把菜单和路由权限合成一个文件:
// client/src/config/nav.ts —— 菜单与路由权限的唯一来源export const pmsBusinessGroups: NavGroup[] = [{label: '工作台',items: [{ label: '仪表盘', path: '/dashboard', icon: LayoutDashboard,permissions: ['home_page'] },{ label: '日历视图', path: '/calendar', icon: Calendar,permissions: ['task_view'] },],},{label: '分析',items: [{ label: '综合分析', path: '/analysis', icon: BarChart3,permissions: ['menu_analysis'] },],},// ……];// 路由守卫表从菜单配置推导,不再手写第二份export const routePermissions = deriveRoutePermissions(navGroups);
Sidebar 渲染菜单用它,App.tsx 的 RequirePermission 也用它。新增一个页面,只有一处要改——不会出现“菜单改了、路由忘了”这种半生效状态。
配套两条硬规矩:
- 新增菜单项必须写
permissions,类型上也做了: permissions: string[]是必填,不写编译不过。 - 无权限兜底不能固定跳
/,要跳「第一个可访问页」。
权限改了,多久生效
缓存 key 是 pms:auth:{版本号}:{userId}。这里有两个失效入口,很容易漏:
// 单用户维度:改用户名 / 改角色 / 改登录开关 / 改直接权限 / 删号await invalidateUser(userId);// 角色维度:改了这个角色的权限,版本号 +1,所有相关用户缓存自动作废await bumpAuthVersion();
漏掉任何一处,用户就会遇到“管理员明明改了权限,我这边还是老样子,退出重登才好”——这种问题排查起来极其费劲,因为它在缓存过期前是“偶发”的。
老库升级:权限项不能只往种子里加
新建库时 seed 会把 96 项权限和 7 个角色灌进去。但已经跑起来的库,permissions 表非空,种子逻辑直接跳过。
所以每次加新权限项,必须同时写一段幂等迁移:
-- 补权限项(存在就跳过)INSERT INTO permissions (name, category, description)SELECT 'menu_analysis', '首页', '访问综合分析'WHERE NOT EXISTS (SELECT 1 FROM permissions WHERE name = 'menu_analysis');-- 给默认角色补授(只加不删,绝不回收已有权限)INSERT INTO roles_permissions (role_id, permission_id)SELECT r.id, p.id FROM roles r, permissions pWHERE r.name IN ('项目经理', '开发人员', '测试人员', '普通用户')AND p.name = 'menu_analysis'AND NOT EXISTS (SELECT 1 FROM roles_permissions rpWHERE rp.role_id = r.id AND rp.permission_id = p.id);
“只加不删”很重要。升级时如果顺手把别人手工配的权限收掉,第二天就会被投诉。
还有一处顺序坑:这段迁移不能塞进 ensureExtraTables()——那个函数在 seedDatabase() 之前跑,空库时会因为表结构判断提前返回,导致种子整体跳过,系统起不来。必须放在 seedDatabase()之后。
五、研发管理:把 IPD 的“卡点”做成硬约束
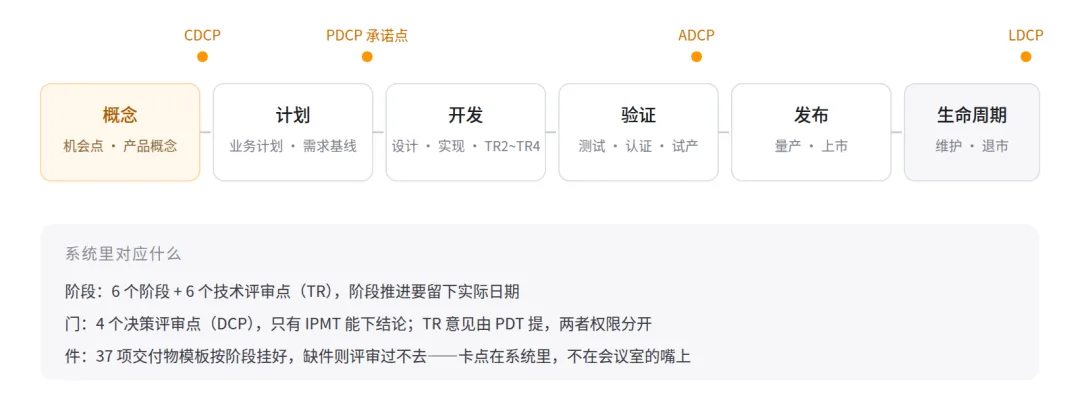
IPD 这套方法论,落不到系统里就只是 PPT。落到系统里最容易犯的错是——画个阶段流程图,每个阶段挂几个表单,然后完事。
那样做出来的东西,跟挂在墙上的制度没区别:谁都能跳过,因为系统不拦。
我们的做法是把评审做成状态机:
每个阶段有固定的交付物清单,缺一项就进不了 DCP DCP 有评审角色(IPMT 委员),评审结论决定阶段能否推进 上一阶段没过 DCP,下一阶段的交付物创建按钮直接不可用 所有评审留痕:谁、什么时候、什么结论、什么意见
代价是灵活性变差——遇到特殊情况想跳过评审,得管理员手工放行。但这是我们想要的:流程的价值就在“不能随便跳”,能随便跳的流程等于没有。
研发模块是独立一套表(11 张),删掉它项目侧的 29 张表照样跑。这个隔离是刻意的:研发流程变更比项目管理频繁得多,隔开之后改研发不会碰项目。
六、数据模型:按业务域切,不求第三范式
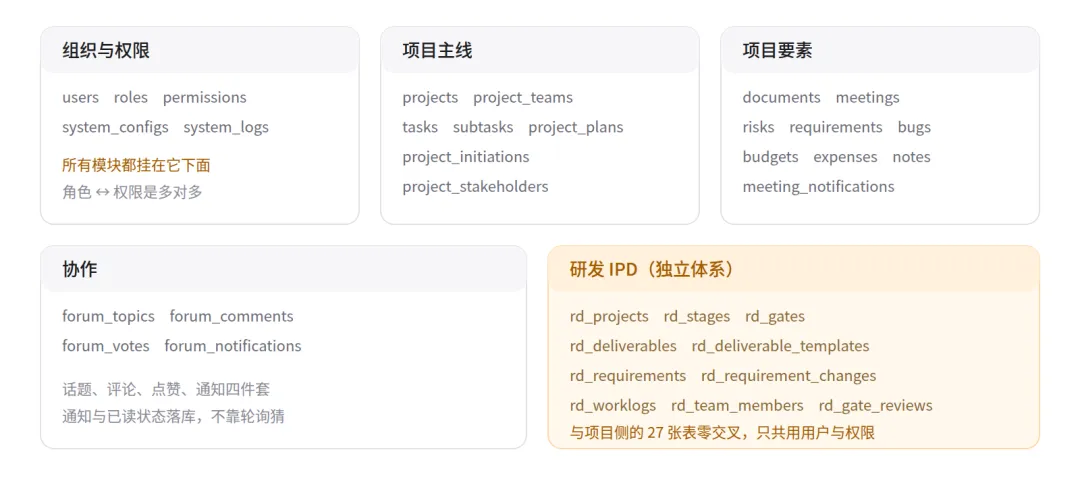
40 张表,大致这么分:
几个不那么“教科书”的决定:
工时口径统一成一条 SQL。 实际工时为空就取预估工时,时间归属按 COALESCE(end_date, due_date, DATE(updated_date), DATE(created_date))。这个口径写死在查询里,不允许每个报表自己发挥——否则月度工时统计和项目工时统计永远对不上,然后就是无穷无尽的“你们这个数怎么算的”。
树形结构只用 parentId + sortOrder,不做闭包表。 项目计划项最多四五层,用祖先链检测防环就够了。跨层拖动排序不做(只允许同层调整),因为这个交互的复杂度远超它带来的价值。
parentId 三道校验,一个都不能少:不能等于自身、必须同项目(防跨项目挂载)、祖先链不能成环(A→B→C→A)。第二点最容易被忘,忘了之后数据看起来正常,直到有人把需求挂到别的项目下面。
七、几个具体的实现取舍
这一节是踩坑记录,都是“当时图省事、后来被反咬”的那种。
1. Redis 必须可以是空的
单机部署的客户不会为了一个内部系统去装 Redis。所以所有缓存调用都要能在没有 Redis 时静默降级:
// cacheGet / cacheSet 内部吞掉所有异常,Redis 挂了等于没缓存,绝不 500export async function cacheGet<T>(key: string): Promise<T | null> {if (!redis) return null; // 没配 REDIS_URL = 全套 no-optry { /* ... */ } catch { return null; }}
限流也同理:自己写了个 HybridStore,内存 + Redis 双写,Redis 不可用就只用内存。不用 rate-limit-redis,因为它在 Redis 断连时会直接把请求打挂。
2. 可清空的字段,绝对不能用 ?? 兜底
这是我踩过最贵的一个坑:
// 错:前端提交 null 想清空备注,?? 把它当成“没传”,保留旧值const remark = body.remark ?? old.remark;// 对:用“字段是否出现”判断,而不是“值是否为空”const remark = Object.prototype.hasOwnProperty.call(body, 'remark')? body.remark // 传了 null 就是清空: old.remark; // 没传才是保持不变
症状是“备注删不掉,保存了还在”。用户会连着试五次,然后认为系统坏了。
配套前端规矩:清空要提交 null,不要提交空字符串。空字符串在业务上不等于“没有值”,它只是“有个空值”,后面统计、导出、判空全都会出问题。
3. Excel 导出不引 exceljs
exceljs 装下来带十几个依赖,我们只需要“把二维数组写成 xlsx”这一个功能。所以自己写了三百多行(server/src/utils/xlsx.ts),用最朴素的 XML 拼装 + 自己实现 zip 打包,零依赖。
写的时候有两个地方必须处理:
一是控制字符。Excel 对 XML 里的非法控制字符零容忍,混进去一个就报“文件损坏”,而这个提示完全不会告诉你哪一格的哪个字符有问题。所以在转义时直接剔掉 \u0000-\u0008、\u000b\u000c、\u000e-\u001f(制表符和换行保留):
function esc(v: string): string {return v.replace(/[\u0000-\u0008\u000b\u000c\u000e-\u001f]/g, '')// ……再做 XML 实体转义}
二是中文列宽。按字符数算列宽,中文列会挤成一条缝。所以量宽度时按“中文算两格、西文算一格”:
function displayWidth(v: CellValue): number {const s = v == null ? '' : String(v);let w = 0;for (const ch of s) w += /[\u4e00-\u9fa5\uff00-\uffef]/.test(ch) ? 2 : 1;return w;}
还有一条容易忽略的:导出的可见性条件必须和列表接口共用同一段 WHERE。分开写的话,迟早出现“页面上看不到的,导出文件里全有”——这是数据泄露,不是显示 bug。
4. 前端拆包,只拆 echarts
Vite 的 manualChunks 我一开始把 react、react-dom、react-router 拆成单独的 vendor chunk,觉得这样缓存命中率高。
结果白屏。原因是 manualChunks 拆出来的 chunk 之间形成了静态循环依赖——A 引用 B,B 又引用 A,浏览器加载时拿到的是半初始化的模块。
最后只拆 echarts + zrender(这两个包大且几乎不变,单独拆有意义),其余交给 Rollup 默认策略。拆包这事,收益远小于你以为的,风险远大于你以为的。
判断有没有拆坏,我写了个脚本,构建后扫一遍 assets:
node logs/analyze-chunks.mjs client/dist/assets# 必须输出:静态 import 环 0 / 引用缺失 0
5. 前端构建产物必须整目录替换
这个坑让我浪费过一下午:cp -r dist-new/. dist/ 是增量覆盖,旧的文件(尤其带 hash 的 chunk)不会删。于是浏览器加载的 index.html 指向新 chunk,但旧 chunk 还在,缓存和 Service Worker 一掺和,症状就是“有的人能看到新功能,有的人看不到”。
正确做法是先整体移走再拷:
mv dist dist-old-同样的坑在打包脚本里也踩过一次:便携版打包脚本是增量 cp -r,payload 里的旧前端不会自动清掉。所以打包前必须先 rm -rf portable-build/payload/client/dist。
八、交付:不会 Linux 的人也得能用
这套系统有两种安装包,因为客户分两种:
dpkg -i | ||
| 内置 MySQL,端口 3307 | ||
| 内置,不依赖系统环境 | ||
/var/lib/two-pms | %LOCALAPPDATA%\TWO-PMS\data | |
dpkg -i |
Windows 便携版是花时间最多的部分,因为它要把“一个 Web 系统”塞进“双击就能跑”这个盒子:
- 内置 MySQL 实例,端口 3307
(避开用户机器上可能已有的 3306) 数据目录放在 %LOCALAPPDATA%,不放安装目录——这样换版本、换盘符数据都不丢my.ini里全用相对路径, WorkingDirectory必须是 mysql 目录,否则 mysqld 启动后静默退出启动器用 PowerShell 写 UI( ui.ps1),文件必须是 UTF-8 带 BOM,否则中文全乱码;.bat用 GBK;.vbs保持纯 ASCII
最后这条特别提醒:PowerShell 7 能跑通 ≠ Windows PowerShell 5.1 能跑通。5.1 是不带 BOM 就按 ANSI 解析的,脚本里的中文注释会直接把语法搞坏,而报错信息通常指向一个看起来完全正确的行。上线前用 5.1 的解析器过一遍:
nullnull[System.Management.Automation.Language.Parser]::ParseFile(tokens, [ref]errors.Count -gt 0) {(($_.Message)" }}
这段只做语法解析、不执行脚本,在 CI 里跑也没有副作用。
九、这套系统适合谁,不适合谁
写完功能清单,更想说清楚边界。
适合
- 50 到 500 人的研发型公司
,项目管理和研发流程两条线并行 - 纯内网、数据不能出机房
的场景 - IT 只有一两个人
,要的是“装上就能用”,不是“再搭一套 K8s” 需要权限颗粒度到按钮、需要流程留痕可追溯的组织 想要一套账号覆盖两种工作台,而不是给研发单独开个系统
不适合
- 多租户 SaaS
:现在的数据隔离靠“用户 → 角色 → 项目成员关系”,没有租户维度的硬隔离。要做 SaaS 得动数据模型,不是加个字段的事。 - 超大规模
:单进程 + 单库,撑几百人没问题,几万人要重新设计缓存和读写分离。 - 需要复杂 BPM 引擎
:我们的流程是硬编码的状态机,不是可拖拽编排的引擎。流程经常变、还要求业务人员自己改流程的,别用这个。 - 要开箱即用的行业模板
:它没有预置的行业方案,得按自己的流程配。
十、踩坑清单(可以直接抄的)
permissions 就无条件放行 | ||
/ | ||
?? 兜底 | hasOwnProperty 判断出现与否 | |
invalidateUser,角色 bumpAuthVersion | ||
cp -r | ||
manualChunks | ||
最后
这套系统从最初只有项目和任务两个模块,长到现在 40 张表、168 个接口、96 项权限。中间没什么大重构,都是一块一块加上去的。
回头看,真正花时间的不是写功能,是这几件事:
- 权限只有一个源
(不然一定会有地方漏掉) - 流程要有硬约束
(不然制度就是 PPT) - 交付要能装
(不然写完也没人用) - 数据口径要统一
(不然每个报表都是一场辩论)
技术上没什么高深的——React、Express、MySQL,都是最普通的东西。难的是把这些普通东西组织成“业务能落地、IT 能维护、用户不骂人”的样子。
如果你也在做类似的事,欢迎在评论区聊聊你踩过的坑。特别是权限和部署这两块,我踩过的坑大概率你也躲不过。
最后放几张效果图展示: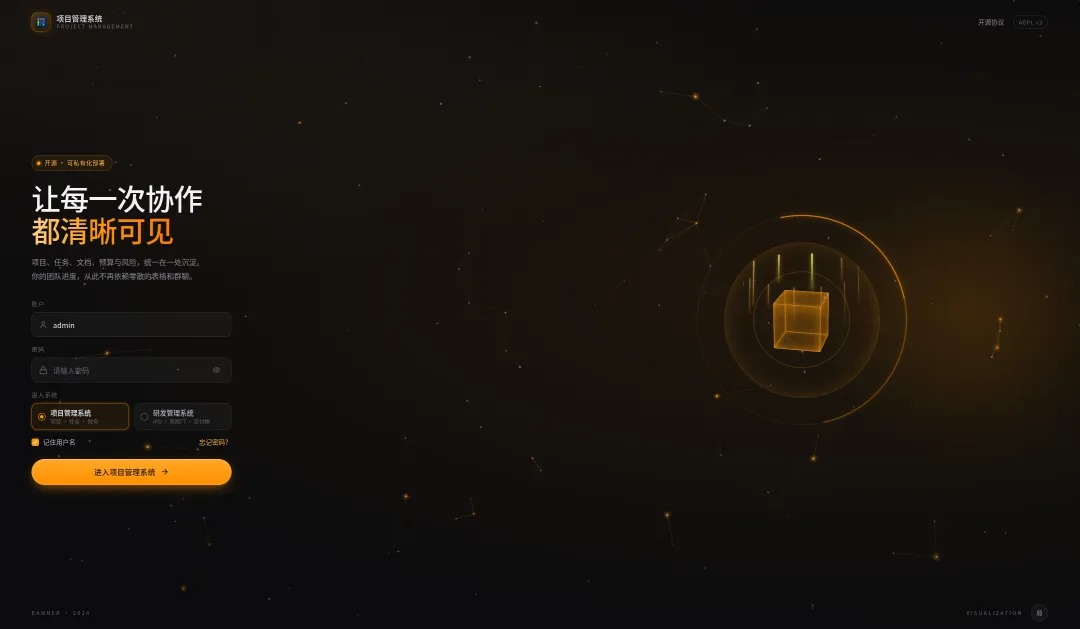 同一套用户体系,实现不同系统页面的登陆
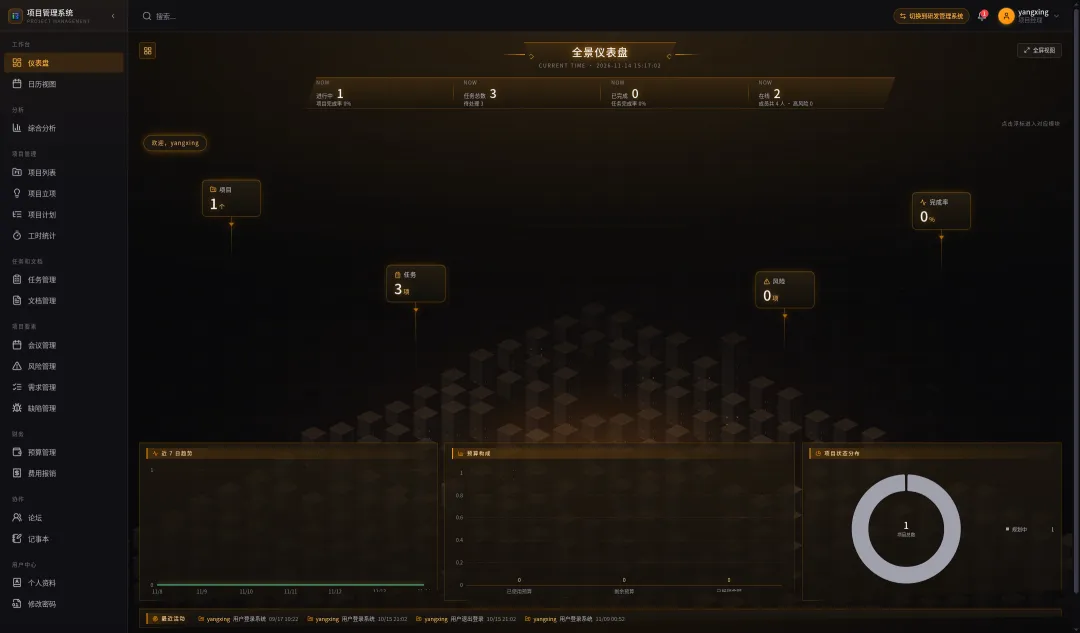 项目管理系统(交付项目经理页面)_系统首页登陆仪表盘全景展示
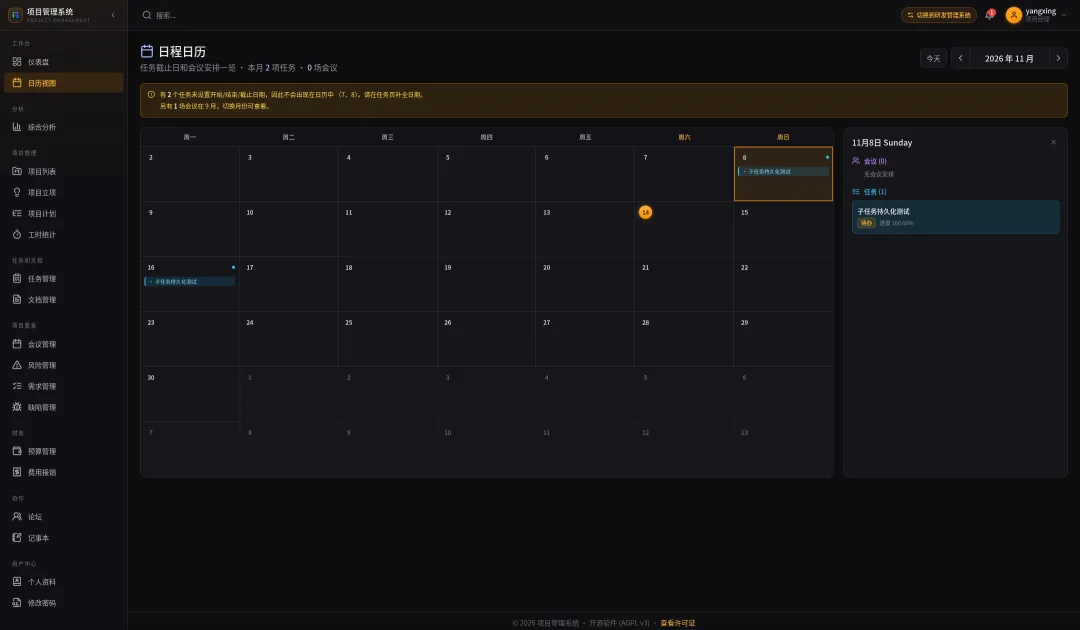 日历视图,同步所有任务\会议信息.
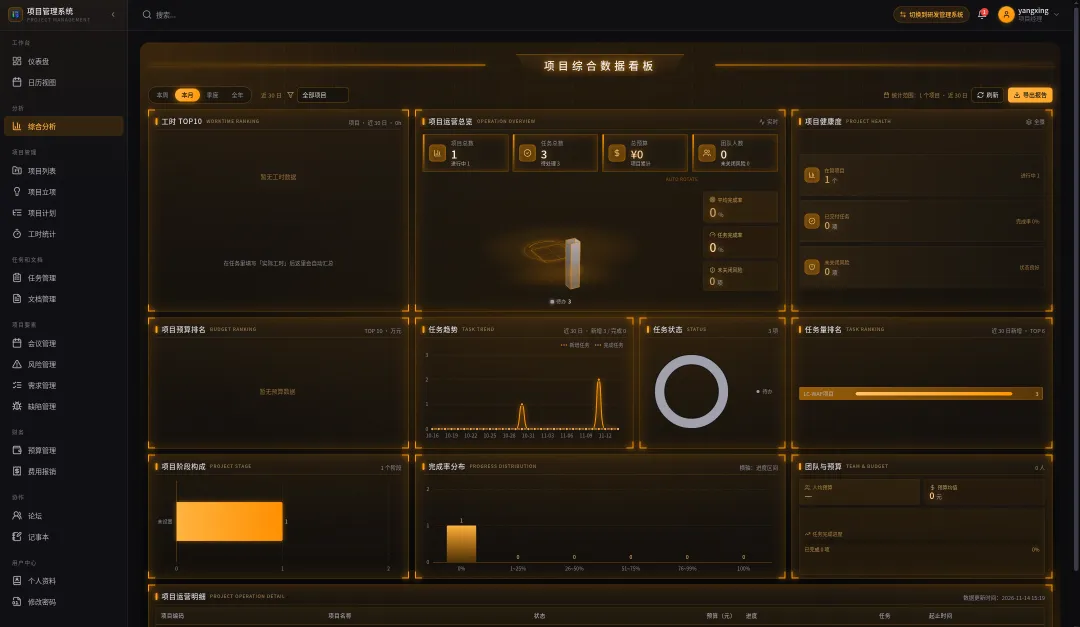 综合数据展示交付项目数据和进展情况
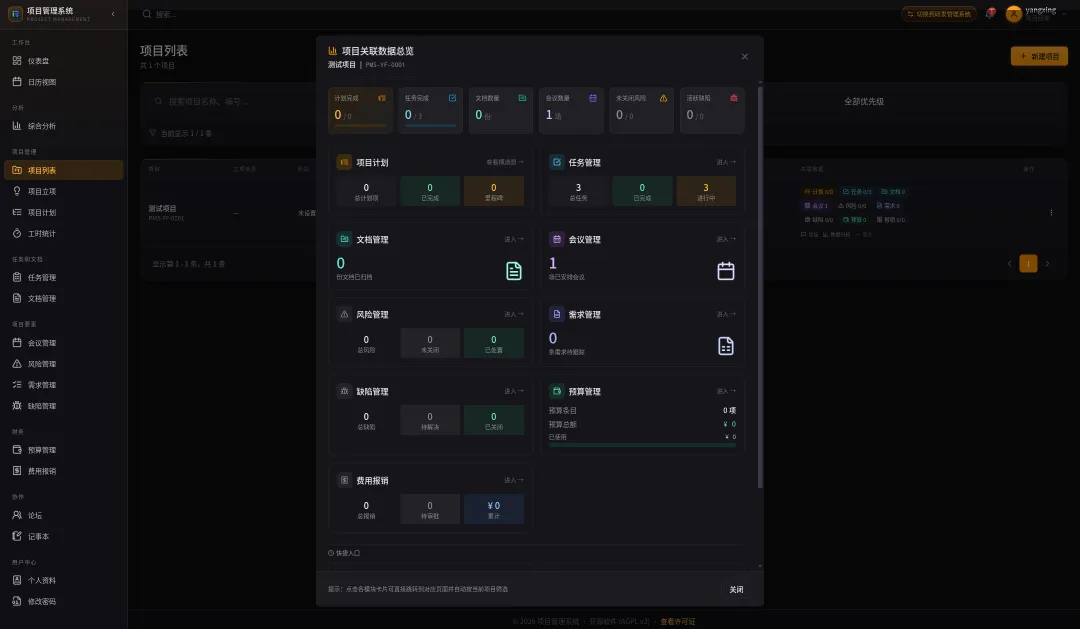 项目列表,展示项目全局数据
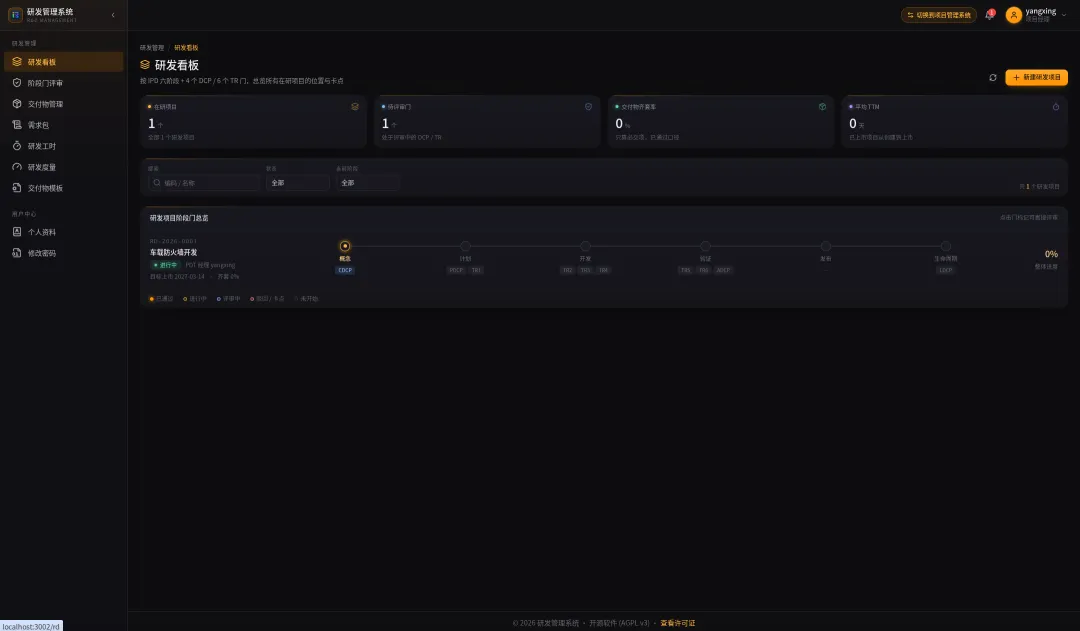 研发项目管理,贯彻IPD全流程,并可调控配置.