ARTICLE · 1363993
解剖 11 个编码 Agent 源码:模型之外那层 Harness,到底是怎么搭的
• 别只盯模型能力了:生产 Agent 真正拉开差距的,是模型外面那层运行时
• Agent = Model + Harness:一份源码解剖里的七个子系统与平台化信号
• 一百行脚本和百万行系统处在同一区间:源码解剖能看到什么,又看不到什么
• 从工具到平台:编码 Agent 的 Harness 正在变成什么
当所有人都在比谁的模型更聪明,真正决定一个 Agent 能不能在真实项目里跑起来的,往往是模型外面那一层。
最近王吉伟频道读到一篇很特别的 arXiv 论文。它不刷 Benchmark、不做运行跑分,而是直接打开 11 个生产级编码 Agent 的源码,回答一个更基础的问题:把大模型接上真实世界、让它能反复执行任务的那层运行时,到底由什么构成,各家是怎么搭的,又正在朝什么方向演化。
论文标题是 Harness Engineering: Anatomy, Architecture, and Evolution of Coding Agents — A Source-Code Study of Eleven Systems(arXiv:2609.00006v1,2026 年 7 月,CC BY 4.0)。作者来自 Inclusive Brains 与 Wavestone AI Lab。
这篇文章不会复述全文,只讲清四件事:Harness 是什么;11 个系统里反复出现的七个结构;两组最硬的反直觉证据;以及一个从工具走向平台的判断,和它成立的边界。
别只盯模型强弱,真正该解释的是外面那一层
讨论编码 Agent 时,最常见的做法是把差距归到模型能力上:参数多大、上下文多长、推理多强。
这个解释并不全错,但它回答不了一个现象:同样的底层模型,接上不同的运行时之后,任务成功率、权限边界、上下文管理和多步协作可以拉开明显差距。差距有一部分来自模型,另一部分则藏在模型外面的工程层里。
论文把已有研究分成三类,并指出各自的缺口:
这篇论文补的就是后两个缺口:把厂商原生系统和开源系统放到同一张源码对照表里,静态阅读、定性比较,不跑统一任务集,也不做性能排名。
它选了 11 个研究样本,外加 1 个元层对照,样本时间锚定在 2026 年 7 月:
先把 Harness 说清楚
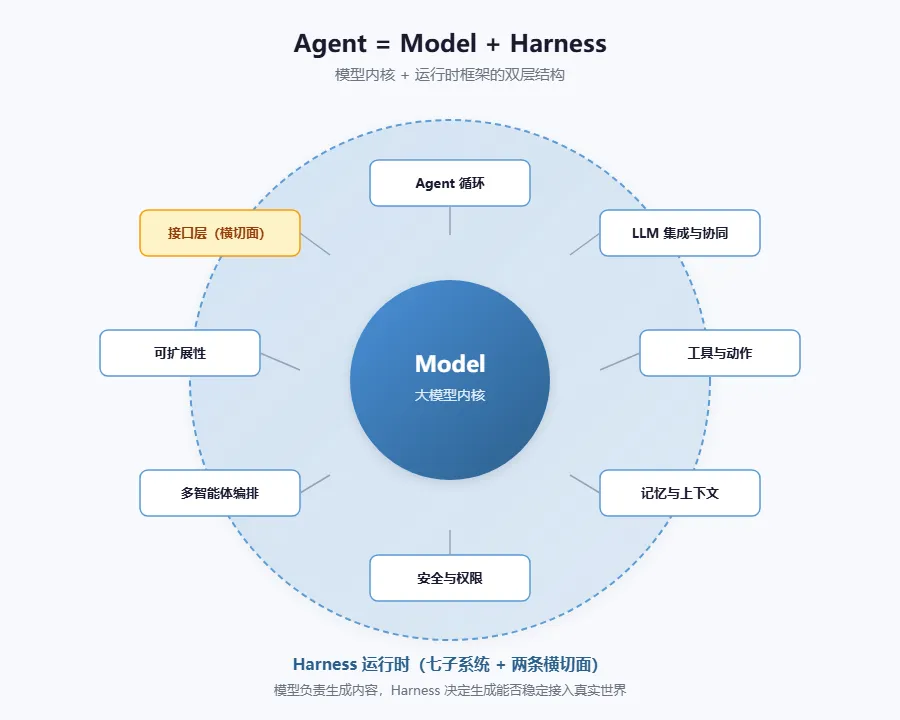
论文用一个很简洁的等式把问题摆正:Agent = Model + Harness。
Harness 可以理解成模型之外的那层运行时:它负责让模型观测环境、形成决策、调用工具、读取反馈,再循环推进任务。模型负责生成内容,Harness 决定这些生成能不能稳定接到真实世界里。
这里有个容易混淆的地方:Harness 不等于市面上那些 Agentic 框架(LangChain、LangGraph、AutoGen、CrewAI 这一类),也不等于临时拼装的脚手架、评测时套的 eval harness,更不等于只在顶层做任务分发的编排器。论文刻意把这些概念分开,避免一个词套所有东西。
放到生产环境里看就更清楚了:真正被使用的编码 Agent,差别往往不在"调了哪个模型 API",而在这层运行时怎么组织循环、怎么管上下文、怎么控权限、怎么接工具和编辑器。读懂 Harness,才看得懂这些系统的真实分工。
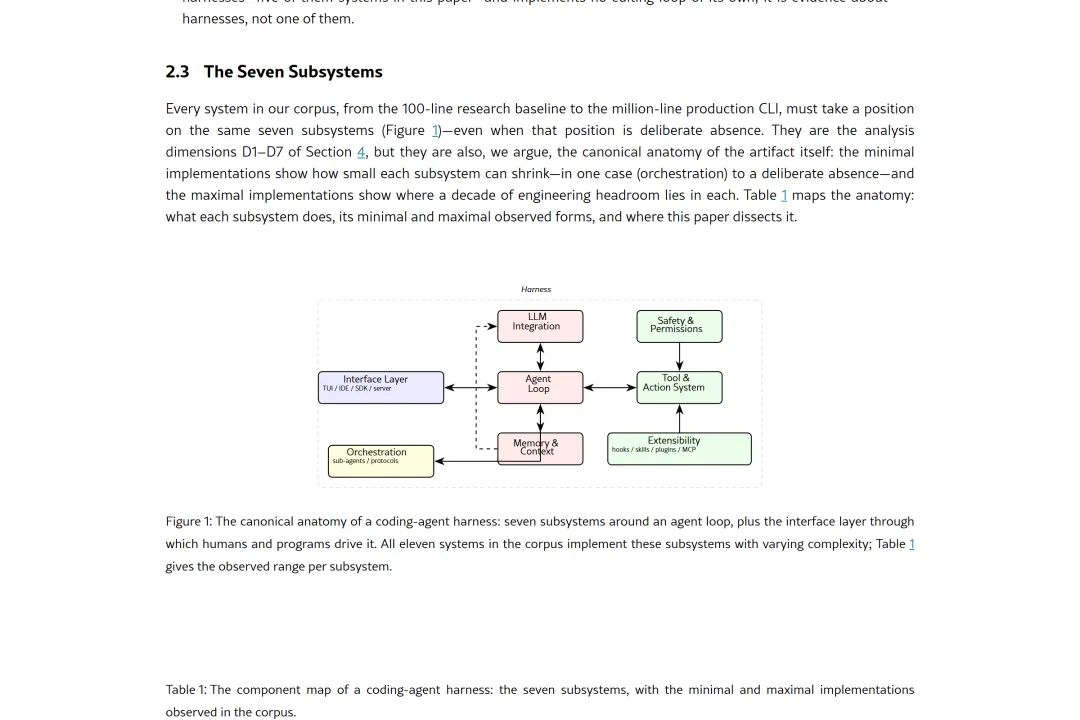
论文把 11 个系统的内部结构拆成七个子系统,再加两条贯穿全局的横切面:
两条横切面不单独成模块,却贯穿所有系统:一是接口层,也就是 CLI、编辑器集成、客户端与服务器的部署形态;二是会话基座,包括会话持久化、历史导入导出和跨会话延续。
需要说明的是,这七个子系统是一份解剖坐标系,不是评分表。论文用它统一描述各家结构,并不意味着每个系统都该把七块做全,也不意味着模块越多就越强。
两组最硬的证据:两种"缺席",一个反直觉对比
论文里证据最扎实的,不是某家系统做了什么,而是两件在 11 个系统里都没有出现的事。作者做过样本三倍扩张和三个月后的二次复核,结论保持一致。
缺席一:没有一个运行时采用通用 Agentic 框架
11 个系统里,没有一个在运行时引入 LangChain、LangGraph、AutoGen、CrewAI 这类通用编排框架。连 Google 自家的 Gemini CLI,也没有用自己的 Genkit 或 ADK。各家更倾向把循环、工具、记忆直接写在自己的代码里。
这说明至少在编码 Agent 这个场景,通用框架目前并不是生产运行时的默认底座;至于这是场景成熟度问题,还是框架定位问题,论文没有下定论。
缺席二:没有一个用向量嵌入做代码检索
11 个系统里,没有一个把向量嵌入用于代码库检索。读代码、定位符号和上下文,主要靠 ripgrep、tree-sitter、glob 匹配和 Markdown 上下文组织。嵌入只出现在对话记忆场景:OpenClaw 默认使用混合检索,Hermes 只在可选插件里提供嵌入。
这并不否定 RAG 本身,而是提示一个现实观察:在编码 Agent 当前的工作方式里,确定性的工具检索比语义嵌入更常被直接采用。在王吉伟频道看来,这比任何跑分都更能说明生产环境的真实选择。
反直觉对比:一百行脚本和百万行系统处在同一成绩区间
样本里的 Mini-SWE-Agent 大约只有 100 行,是研究地板级实现;它自报在 SWE-Bench Verified 上达到 74% 以上。Codex 源码约 110 万行,属于重型系统。两者的自报成绩落在相近区间。
你就说这事反不反直觉。
不过口径必须讲清楚:这些分数跨模型、跨日期、跨配置,论文明确不把它们当成可横比的排名,只作为背景。它能提示的是循环复杂度并不直接预测任务完成率;但绝不能反过来推出"简单实现就足够",因为运行时承担的权限、可靠性、上下文管理和多步协作,并不体现在单题分数里。
四个常见理解,需要先纠偏
王吉伟频道把论文里反复澄清的误解归成四条,每条都对应一个想当然的判断。
误区一:系统越复杂,能力越强。 复杂度和任务完成率之间,在这份样本里看不到直接对应。循环再厚,也可能只是在处理工程边界问题;而静态源码阅读本身无法测量运行性能,不能把结构规模读成能力高低。
误区二:大系统一定自带沙箱。 沙箱是一种主动选择,不是规模的必然结果。Hermes、OpenCode 体量不小,却没有做操作系统级隔离;而原生产品常把沙箱当成成本最高的部件之一。隔离强度对应风险偏好,不对应代码行数。
误区三:原生优化等于紧耦合。 原生系统确实和自家模型、服务协同更深,但紧耦合并不是厂商原生的专利:谁愿意为每个厂商维护条件代码,谁就能拿到对应的原生优化。紧耦合真正独有的好处,是和服务端一起协同进化、掌握更新循环的控制权;代价则是绑定和迁移成本。
误区四:工具协议已经统一。 事实是技能(Skills)被 9 个系统采用,数量上反超了接入 MCP 的 8 个。ACP 承担三类角色:编辑器与 Agent 对接、Harness 托管、跨厂商 mesh 式互通;其中真正做跨厂商 A2A 的,样本里只有 Gemini。自有子 Agent 也大多留在进程内,没有变成独立服务。
最终判断:Harness 正在从工具变成平台
论文最有分量的趋势判断是:编码 Agent 的运行时,正在从一个完成任务的工具,转向一个承载能力、规则和协作关系的平台。支撑这个判断的是四个可观察信号。
顺着这四个信号,论文看到两条相互靠近的路线:Harness 在吸收框架的编排能力,框架也在下沉成运行时;市场层面开始出现切换成本和企业级治理(如设备统一管理、权限与合规)的需求;最上层则出现了元 Harness,也就是像 Omnigent 那样编排多个厂商运行时、自己不建编辑循环的一层。
纵向看约 90 天的版本演进,还有一个值得留意的现象:系统之间的趋同已经从结构相似走到词汇层面的模仿,例如 Codex 沿用了 Claude Code 的 hook 词汇和会话导入器;特色的半衰期以周计;行为策略也从提示词里的自然语言散文,迁移到配置文件和开关 flag。
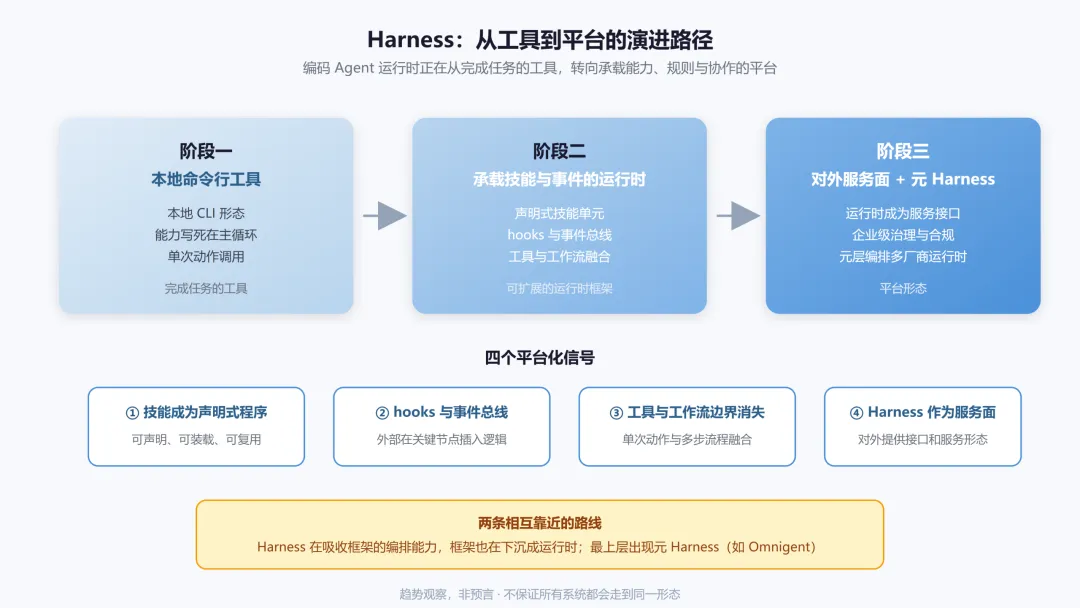
这是一条趋势观察,不是预言。它说明当下在发生什么,不保证所有系统都会沿着同一方向走到同一个形态。
这份研究能回答什么
读这篇论文时,我觉得有几条边界需要先摆清楚,否则很容易把结构观察误读成性能结论。
• 研究方式是静态源码阅读,不跑统一任务集,所以看不到真实运行性能、稳定性和失败率。
• 没有同任务、同模型的头对头对比,不能据此给产品排能力名次。
• Claude Code 采用 2026 年 3 月的流通快照,是样本里可复现性最弱的一环。
• "框架缺席"没有追溯动态加载、转译或二次发行的情形;代码检索的结论也限定在编码 Agent 当前实现。
• 这些结论面向编码场景,外推到其他类型 Agent 时需要重新验证。
• 版本号、工具数量、Star 数等清单信息容易过期,阅读时应以论文锚定时间为准。
• 系统之间是定性比较,其中包含作者的主观判断,不等同于可量化的客观测量。
后记:以后怎么看一个 Agent 的运行时
如果把这篇论文压缩成一套可以复用的判断框架,有两层。
看结构,回到七个子系统:循环怎么组织、模型怎么接入、工具怎么授权、上下文怎么管理、权限怎么隔离、子任务怎么协作、能力怎么扩展。再看接口层和会话基座这两条横切面。结构齐全不代表更强,但缺了哪一块,通常能对应到一类工程代价。
看平台化程度,对照四个信号:技能是否声明式、有没有事件与 hook、工具和流程是否打通、运行时是否对外成为服务面。信号越多,它越接近平台形态,也越可能沉淀出切换成本和治理需求。
最后再强调一个分工原则:源码解剖能回答"这层是怎么搭的",回答不了"它在真实任务上跑得多好"。看结构用这份研究,比性能还需要另一套基于统一任务和同模型的评测。
把这两件事分开,就不容易被任何一边的结论带偏。
论文地址:https://arxiv.org/html/2609.00006v1
看到这里了,如果觉得不错,随手点个赞、在看、转发三连吧,也可以给个星标,你的支持就是我的动力。
推荐阅读
【王吉伟频道,关注Agentic AI与AIGC,专注数字化转型、业务流程自动化与AI Agent,欢迎关注与交流。】