ARTICLE · 1378765
19.6 万星的微软工具,我把 PDF、Word、Excel 全转成了纯文本
19.6 万星的微软工具,我把 PDF、Word、Excel 全转成了纯文本
一份 PDF、一份 Word、一份 Excel,本来要三套工具分别转。我把 report.pdf、sales_q3.docx、orders.xlsx 一起丢给 markitdown,一条命令全转成纯文本。196520 星,上个月 PyPI 下载 1877 万次。README 里写着 OCR,但它读不了扫描件。
装一条命令,转一个 PDF 一秒出头。MIT 协议,Python 3.10 到 3.14 都能跑,安装包 88KB:
pip install 'markitdown[all]' markitdown 报告.pdf -o 报告.md 一点建议
三种人三种用法。只转网页、CSV、JSON、Markdown 的,装完就能用。给知识库、RAG 灌文档的,先看第二节:有一类文件转出来是空的,还不报错。扫描件、发票照片、合同拍照这些,还是得另配 OCR。
01 它替你省了什么
做文档抽取,每种格式一套代码:PDF 用 pdfminer、Word 用 python-docx、Excel 用 openpyxl、PPT 用 python-pptx,装齐这四个库要写四份解析逻辑,合并单元格这一项就够调半天。
markitdown 一个入口吃 12 种:PDF、Word、Excel、PowerPoint、HTML、CSV、JSON、XML、EPub、ZIP、图片、音频。用法两种,写文件或者走管道,管道适合写进脚本里:
markitdown 报告.pdf -o 报告.md cat 报告.pdf | markitdown 02 转之前,先看文件有没有文字层
PDF 分两类:软件导出的文件文字,pdfminer.six 抽得出来;
扫描的、拍照的、截图另存的,整页就一张位图,抽不出来就输出一个换行符,退出码还是 0。
判断用 pdfplumber 读一次,抽出 0 字符的就是扫描件,别丢给 markitdown:
import pdfplumber with pdfplumber.open("报告.pdf") as pdf: txt = (pdf.pages[0].extract_text() or "").strip() print("有文字层" if txt else "扫描件,走 OCR") 这一步能省掉后面所有排查。
03 批量转完,一定要查空文件
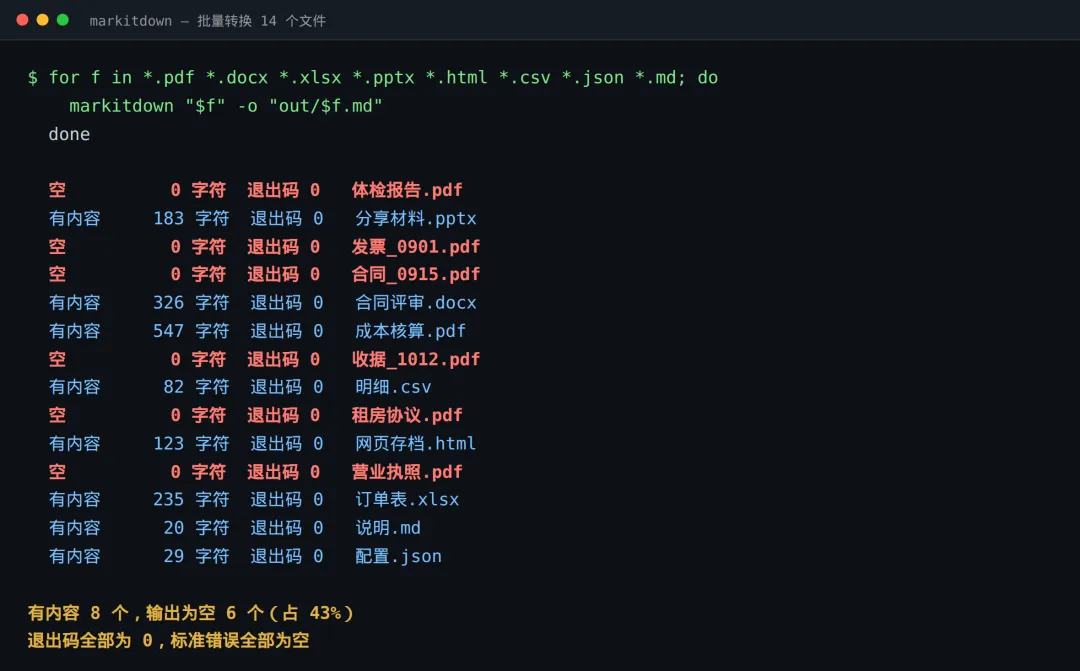
把一摞文件丢进目录批量转,是最容易出事的地方。14 份文件跑了一遍:6 份正常文档,6 份图片型 PDF,加 1 份 JSON、1 份 Markdown。8 份有内容,6 份输出为空。
批量跑用一个循环:
for f in *.pdf *.docx *.xlsx *.pptx *.html *.csv *.json *.md; do markitdown "$f" -o "out/$f.md" 2>/dev/null done 转完一轮必须查一遍。14 次调用,退出码全部为 0,标准错误 13 次为空,它一句话都不会说:
for f in out/*.md; do n=$(wc -c < "$f") [ "$n" -lt 20 ] && echo "空: $f ($n 字节)" done 20 字节以下的基本就是空的。唯一没被这条筛出来的是 report.pdf,它吐了 1892 字节报错,退出码却是 0,输出还是完整的 547 字符。有报错不一定有事,没报错可能是空的,这两个方向都得防。
04 表格:数字都在,位置全错
表格这一处不丢数据,只挪位置。Word 那份 sales_q3.docx 转出来,表头前面多一行空的 | | | | |。PDF 那份 report.pdf 4 列变 5 列:412.6 本来属于「Q2」,转完落在「Q3」;508.3 跑到「环比」;+23.2% 被挤进第 6 列。20 个数字一个没少,位置全错。
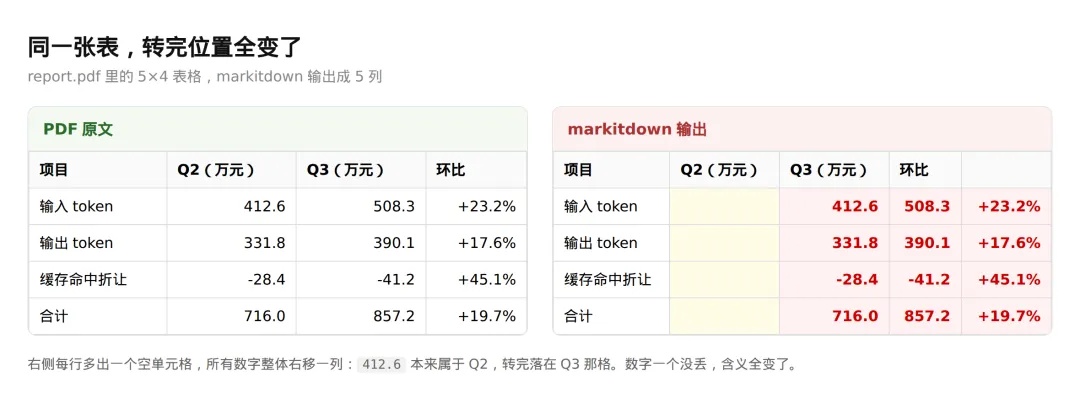
PR #2808 给了成因:单元格文本里出现一个裸的 |,会额外切出一列,整张表跟着错位。那份 PR 提上去以后在 11 月 2 日被关掉,没有合并。转完对着原表核一遍列数,比较可靠。财务报表、对账单这类以表格为主的分析,不要拿它的输出当数据源;做段落切块检索倒是无妨。
05 Excel:公式那一列会变成 NaN
orders.xlsx 的金额列写的是 =B2*C2,转出来 4 行全是 NaN。合并单元格 A6:C6 读成三段 NaN,中间还多插一行空行,只有两个 sheet 名「明细」「说明」保住了。
NaN 的来历有出处。issue #2824 说 pandas.read_excel 默认把空单元格和 NA、N/A、null、nan 这些文本当成缺失值,连国家代码 NA(纳米比亚)都会被替换掉。
办法是先把公式算成值再转。在 Excel 或 WPS 里复制整表,选择性粘贴为「值」,另存一份。同一张表实测两个结果:公式版转出来 4 行 NaN,值版转出来 360、320,一个不差。
markitdown 订单_值版.xlsx -o 订单.md 06 十二种格式,哪些真能信
按可信度往下排。网页存档这一项不需要核,page.html 的 h1 变成 # 季度报告,<b>17.6%</b> 变成 **17.6%**,表格对齐,链接变成 [链接](https://example.com)。CSV、JSON、Markdown 同样一字不差,一份 3 列的 CSV 转出来 82 字符,和原文逐字对得上,这一组没有要核的地方。
Word 和 PPT 的正文部分对得上。Word 的标题层级识别正常,#、## 都在,3 条产品线变成 3 个 *;PPT 2 个 h1 全保住,按 <!-- Slide number: 1 --> 分页,项目符号变成普通文字,3×3 表格也是对的。这两类的边界都在表格,按上一节的办法核列数。
PDF 和 Excel 各有条件,前面两节讲过:一个只吃文字层,一个只吃值。图片和音频走微软的托管服务,本地跑不了。11 月 6 日的 PR #2845 把 README 里 Images (EXIF metadata and OCR) 改成了 captioning,还补了一句「rely on web-hosted services」。改之前那个 OCR 的说法,让不少人以为装上就能读图里的字。
07 装之前要知道
版本 0.1.9,2026 年 10 月 21 日发布,安装包 88KB,装全了体积不小:
pip install 'markitdown[all]' 全量装完 382MB、41 个包,大头是 onnxruntime 和 magika。magika 是谷歌开的文件类型识别库,靠一个小模型判断文件真实格式,onnxruntime 是它的推理后端。只转 4 种常用格式,可以省掉这两个:
pip install 'markitdown[pdf,docx,pptx,xlsx]' 仓库 813 个未关 issue,100 多个贡献者,最近一次提交在 11 月 7 日。项目地址:https://github.com/microsoft/markitdown
只把网页和 Office 转成纯文本,装全量版就行。要往知识库灌文档,先照第二节筛文字层,再照第三节查空文件。手里是扫描件的话,另找 OCR 工具。
— END —