ARTICLE · 1380406
省 token 的插件先收你 4,694 过路费:billion-context 实测
我把同一个请求发了两遍。
第一遍直接打上游,一次假的 Anthropic 接口,什么都不改。第二遍走 billion-context 的本地代理,端口 8788,配置里只改了 upstream 一行。
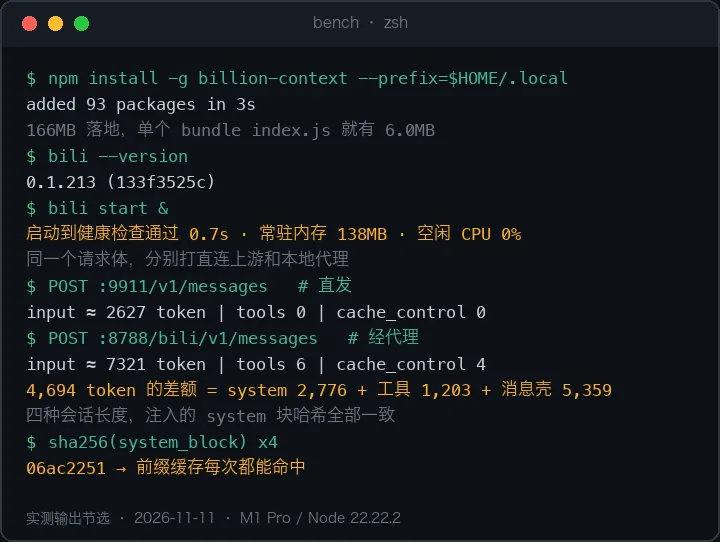
同一个请求体,10,599 字节,2,627 个 token。上游收到的不一样了:28,869 字节,7,321 个 token,多出 6 个工具,system 里多出一段 12,336 字的说明书。
那一段就是它的"压缩哲学"。
我不是来拆台的。这个项目 98 天攒了 6,400 多星,把一份四个半月的生产日志写成论文,随代码一起开源,工程密度是真的。但"省 token"这三个字,在它身上有个前提条件,而这个前提条件藏在一句 FAQ 里——第一次压缩要等到大约 20 万 token 才触发。
也就是说,在你真正需要它之前,它每一轮都在收过路费。我量了一下,过路费是 4,694 个 token。
先把结论摆出来
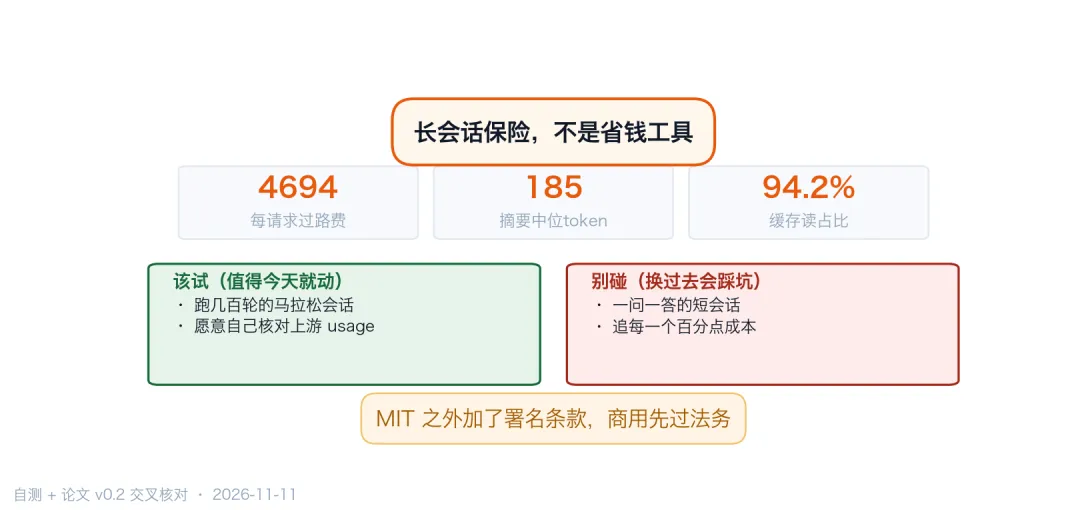
billion-context 不是省钱工具,是长会话保险。 它买的是"会话跑到 800 轮不撞墙",不是"每轮便宜一点"。短会话装它,净亏;长会话装它,赚的是不用重开会话的那部分隐形成本。
判断依据就一条:它的固定开销是每请求 4,694 token 起,而它省下的钱只在折叠真正发生之后才产生。折叠的触发线是增长 50K token(README 里 compress.nudgeGrowthTokens 的默认值),按我自己造的这个会话长度算,大概要 500 轮以上才碰得到。
这两个数字放在一起,答案很清楚:这是一把为马拉松准备的伞,不是日常通勤的雨衣。
它到底怎么做到的
要理解那 4,694 个 token 花在哪,得先看懂它在干什么。
折叠,不是截断
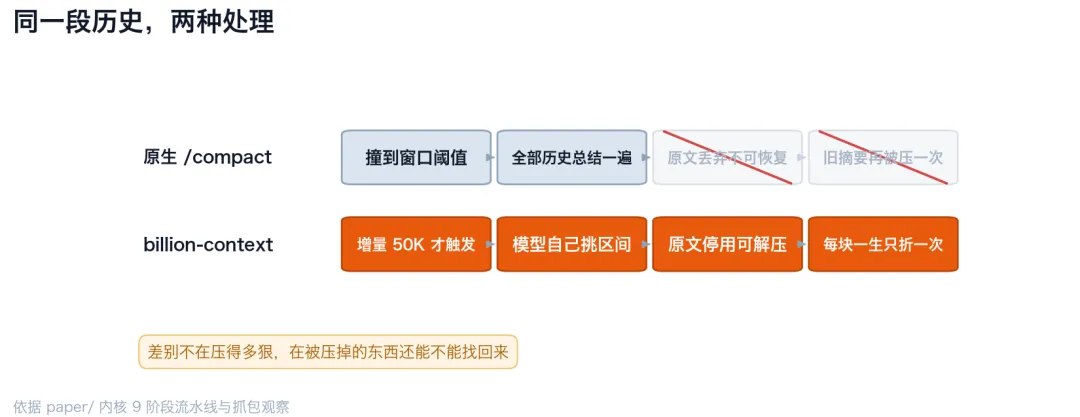
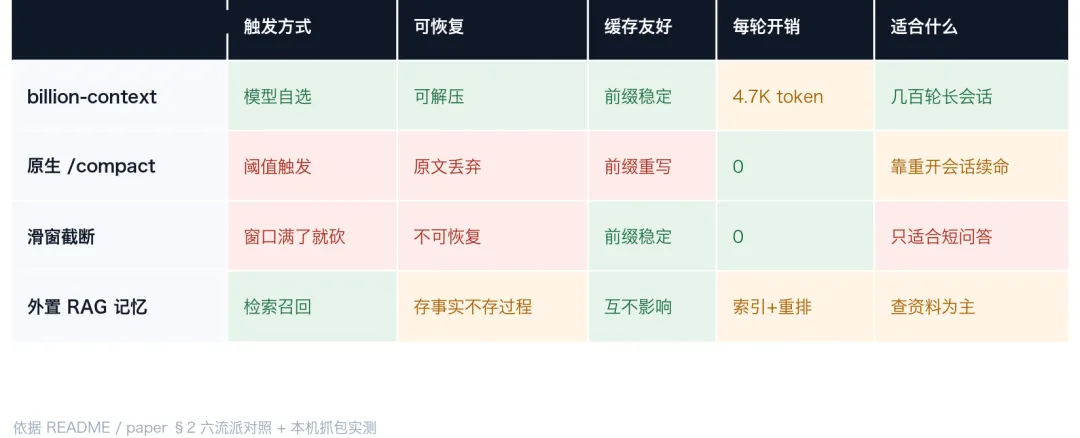
主流 CLI 的做法是阈值触发:上下文快到窗口上限,把全部历史总结成一个大块,塞回去,原文丢掉。丢完就没了,摘要写漏了细节你只能认。这就是所谓 /compact。
billion-context 换了个布局。它把上下文切成三段:
- 头部
:一摞可恢复的摘要块,按世代分层 - 中间
:被折叠掉的原文,不删除,只是"停用" - 尾部
:最近约 5 万 token 的工作区,保持原文
它管这个叫 fold(折叠)。摘要块还分世代:tier-1 块总结一段消息区间,tier-1 攒多了折成 tier-2,tier-2 再折成 tier-3。论文里的实测比例是 tier-1 占常驻 92%、tier-2 占 7%、tier-3 不到 1%,但 tier-2 加 tier-3 只占 8% 的体积却承载了 37% 的历史内容。
这就是它能说"单个会话吃到几十亿 token"的原因:摘要本身也在被压缩,每层的保留率逐层衰减,总量涨得比线性慢。
为什么不是"换个更大的窗口"
最直接的反驳是:现在窗口都到 1M 了,我为什么要压缩?
论文里引了一项我觉得最有说服力的对照研究(Compaction Cliff):20 个生产配置下,一轮 /compact 式摘要之后,安全规则的存活率掉到 53%,五轮之后只剩 10%。这条曲线是几何衰减——每压一次,早期内容被再摘要一次,ρ^k,ρ 大约 0.4 到 0.6,四轮下来只剩 3% 到 13%。
这解释了一个很多人都遇到过的现象:会话跑到后面,AI 开始犯前面已经纠正过的错。不是它变笨了,是那些纠正记录在第三、第四次压缩时被压没了。
折叠的思路是让每条内容"一生只被折一次"。折完之后那块摘要就常驻不变,不再参与后续压缩(论文里的数据:1,711 个 tier-2 块中只有 60 个被再蒸馏)。这样留存率停在一个常数,而不是随轮数复合衰减。
换更大窗口解决的是"什么时候撞墙",折叠解决的是"撞墙之后还记不记得"。两件事。
它要模型自己动手
关键设计是:压缩不是引擎按百分比砍的,是模型自己决定压哪一段。
代理往对话里注入了 6 个工具。我抓包看了一遍,名字和 token 开销如下:
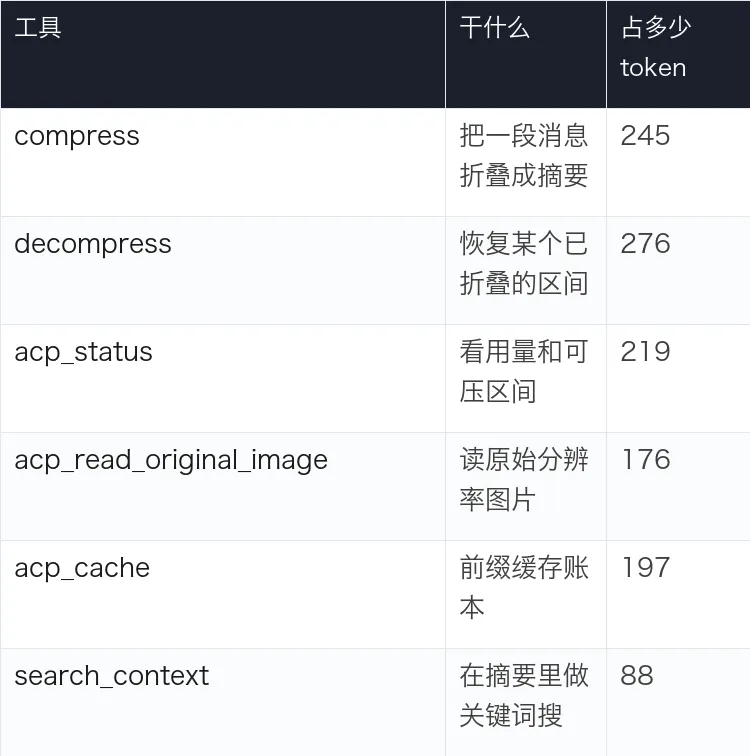
六个加起来 1,203 个 token,每一轮都要发。
光有工具不够,还要告诉模型"什么时候该用"。这就是那 12,336 字符的压缩哲学:两种失败模式(过压和欠压)、唯一判据("这段内容当前步骤还需要吗")、保护区规则、摘要的 KEEP/DROP 清单、以及摘要必须自包含到"后来者不需要原文也能接着干"。
它甚至在提示词里规定摘要要用过去时标注("TASK AS OF THIS BLOCK"),防止后来的模型把旧决定当成新指令去执行。这条细节让我对它多了几分信任——这是被真实事故教过的人才会写的规则。
引用标签:那 22 token/条从哪来
抓包里还有一处改动容易被忽略。代理给每条消息都套了个壳:
<acp tokens="18" type="text" time="2026-11-11 14:02:42">m00001</acp>m00001 是引用号。有了它,模型才能说"把 m00004 到 m00120 折了",decompress 也才知道该恢复哪一段。
代价是每条消息多 20 来个 token。我测了四组不同长度的会话,多出来的开销从 4,694 涨到 9,338,涨的那部分基本就是这些壳。
前缀缓存:它最像样的一个设计
这块是真的讲究。我数了一下,代理发出的请求里有 4 个 cache_control 断点:一个在 system 末尾,另外三个滚动打在消息的第 20、40、80 条上。Anthropic 的硬上限就是 4 个,它一个不多一个不少。
更关键的是我做了个哈希对比:31 条、61 条、121 条、241 条四种会话长度下,注入进去的 system 块 SHA-256 全是 06ac2251——逐字节一致。
这一条值钱。因为前缀缓存是按"从头开始完全一致的片段"算的,只要这段注入的提示词每次都一样,它就永远命中缓存,按 1/10 的价格计费。反过来,如果插件每轮往 system 里塞点变化的东西(比如当前时间戳、当前用量),整个前缀就废了,缓存全价。
论文里把这个当成核心卖点:历史只追加,压缩只停用后缀区间,缓存前缀永不失效。生产数据是活跃节奏下缓存读占比 94.2%。
硬数据:我自己跑的和它自己报的
我测的(本机,2026-11-11)
M1 Pro / 16GB / Node 22.22.2 / billion-context 0.1.213。方法:写一个假上游(本地 HTTP 服务,只记录收到的请求体、回一个最小合法 SSE),同一个请求体分别直发和经代理,用 tiktoken 的 cl100k 编码器数 token。
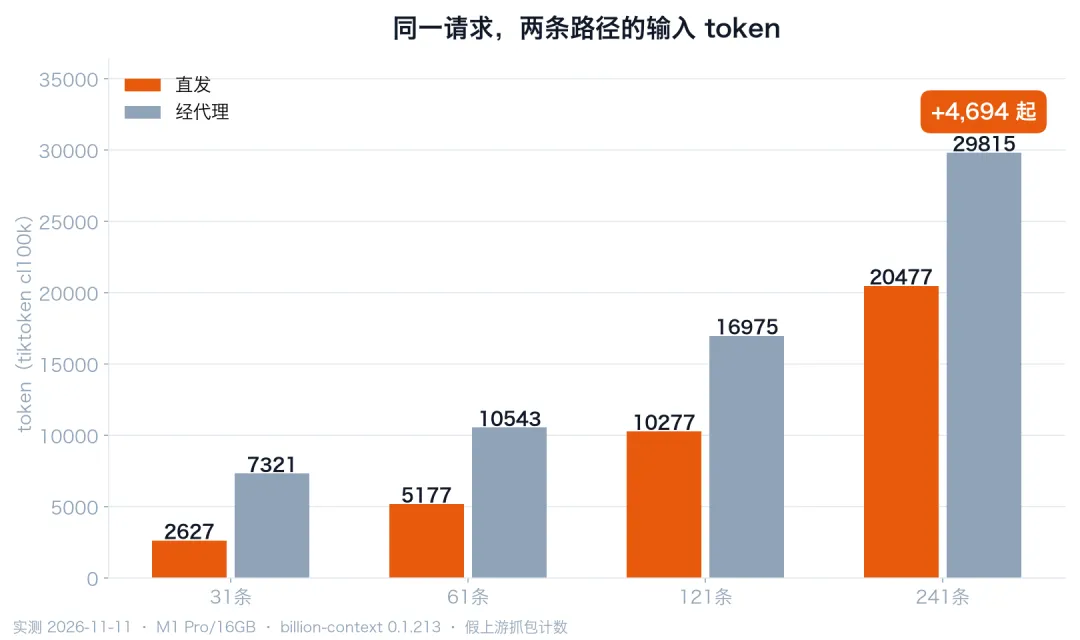
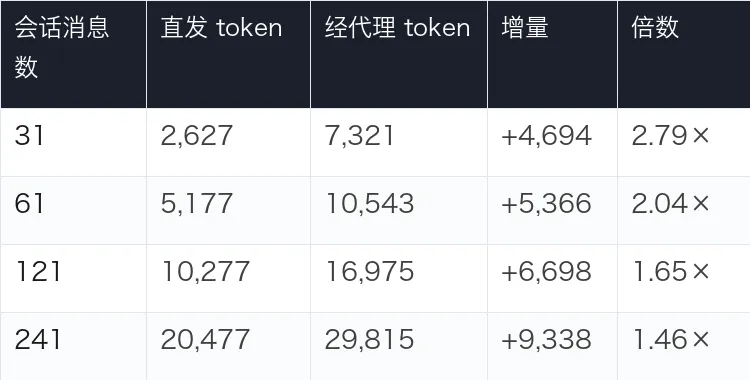
241 条那一组的增量可以拆干净:system 注入 2,776、工具 1,203、消息外壳 5,359。加起来 9,338,一分不差。
注意 tiktoken 的 cl100k 是 OpenAI 的分词器,跟 Anthropic 的实际计数会有个位数百分比偏差。我没用 Anthropic 的 count_tokens 接口,因为那需要真 key。这里比的是"同一个请求在两种路径下的相对差",口径一致,结论不受影响。
它自己报的(论文 v0.2,随包发布在 paper/ 目录)
4.5 个月、3 台宿主、174,327 次模型调用,累计输入 187.6 亿 token(新鲜 17.5 亿 + 缓存读 170.1 亿),三宿主合计约 247 亿 4,843 个会话用了折叠,其中 917 个留有用量记录;最长马拉松会话 8,584–12,049 次调用 每调用上下文:均值 88K、中位 72K、p99 218K(Pi 宿主,204,800 窗口) 摘要输出中位 185 token,97.5% 不超过 2K;单块压缩比中位 7.9×,工具主导块中位 24×(p75 45×) 计费 token 降 31–54%,探针得分持平,重读调用少 63% 内核约 1 万行 TypeScript,550 多个测试
这些数字我无法复核,只能核对它们是否自洽。有一处不自洽值得说:README 头条写"省 5 倍 token",论文正文写"计费 token 降低 31–54%"。5 倍是 80% 降幅,54% 是 2.2 倍,两个口径差得不算小。论文里倒是老实交代了——"5×"指的是被折叠区间那部分的压缩比,不是账单。
而账单口径,另一位实测者(moyu-green,2026-11-10,Linux + pi + DeepSeek)给的数字更冷:回忆轮首个上游请求,开压缩 150,044 token,关压缩 146,683,比值 0.98 倍——开了反而多一点。他明确写了"没测出官方约 5 倍"。
跟我测的方向一致。他量的是真实模型跑长会话,我量的是脚手架本身,两条路径都指向同一件事:省的钱不在请求里,在"你本来要重开会话"这件事里。
实测细节:装、跑、踩坑
装
npm install -g billion-context --prefix=$HOME/.local # added 93 packages in 3s三秒装完 93 个包,落地 166MB:dist 44MB(单个 bundle index.js 就有 6.0MB)、node_modules 120MB、论文 1MB。
一个"轻量代理"占了 166MB 磁盘,这个数字本身就是一个信号:它不是一个薄薄的中转层,是一个带 SQLite 存储、会话索引、归档 GC、Web UI 的完整系统。
跑
启动到健康检查通过 0.7 秒,常驻内存 138MB,空闲 CPU 0%。这个开销可以接受。
跑起来它自己会起 4 个后台巡检,每 180 秒一次:自动更新策略、公告、release 列表、通知。域名是 raw.githubusercontent.com 和 api.github.com。不算偷偷摸摸,日志里全写出来了,但"本地代理每 3 分钟往外发四次请求"这事儿,装之前你大概不会想到。
踩的坑
第一个坑:假上游 + 假模型,折叠那一步跑不出来。
我让它回一个真实的 compress 工具调用,参数写成 m00004–m00120 加一段摘要,再补上 tool_result 继续下一轮——上游收到的历史里,那段摘要原封不动还在,没有被折叠。
原因大概是折叠会话状态跟真实客户端的会话 id 绑着,我这个"手搓请求"没有那个身份。所以我这次验证的是脚手架(注入多少、稳定不稳定、缓存友好不友好),没有验证折叠本身。这个边界我得说明白:凡是文中说"压缩比 24×"之类的,都是它的生产数据,不是我跑出来的。
第二个坑:它会悄悄合并消息。
我发了 241 条消息,上游收到 161 条。查下来是把我"用户文字"和"紧跟着的工具结果"合并成了一条 user 消息——因为 Anthropic 接口要求角色交替,两个连续 user 必须合。这是对的,但如果你在数自己的消息条数做对照,会以为丢了 80 条。
第三个坑:它的配置项多到需要一本字典。CONFIGURATION.md 光是环境变量就 200 多个,从 BILI_CACHE_KEEPALIVE_INTERVAL_MS 到 BILI_GUARDRAIL_REPETITION_RECOVERY。默认值大多合理,但"默认值合理"和"你能说清它在干什么"是两件事。
第四个坑其实是"踩"出来的解释。我把消息丢了 80 条的事想通了:论文里写了内核是 9 阶段流水线——assign-refs(分配引用号)→ sync-blocks(切块)→ merge-blocks(合并可压区间)→ prune → filter → hide-compress-calls(隐藏压缩工具噪声)→ nudge-inject(注入压缩提示)→ emergency-truncate(兜底硬截断)→ render-refs(渲染带引用标签的消息)。
我观察到的三件事,正好对上三个阶段:引用标签来自 assign-refs 和 render-refs,消息合并来自 merge-blocks,12,336 字的说明书来自 nudge-inject。
有意思的是 hide-compress-calls 这一阶段在我的测试里没有生效——我手工塞进去的那条 compress 工具调用,原封不动出现在下一轮上游收到的历史里。按设计它应该被藏掉,免得模型看到自己上一轮的压缩动作占着位置。这可能又是因为我这条请求没有真实会话身份,不能算 bug,但值得记一笔。
泼冷水
第一,短会话是纯亏。 4,694 个 token 的入场费,在 2,627 的请求上就是 2.8 倍成本。它的 FAQ 自己承认:想更早压缩要"删减系统提示词、关闭不需要的工具、精简 skill,把 nudge 调到 50K 左右"。翻译一下——它也知道自己占地方。
第二,它依赖模型自律,而论文自己承认模型不自律。 原文写得很直白:恢复工具"在被明确指示时有效,但模型不会自己想起来调用"。也就是说 decompress 这个安全网,在真实使用中有很大概率没人去拉。摘要写漏了,模型不会回头查,它只会基于漏掉的摘要继续干。
第三,质量的证据链还差一环。 论文的受控实验用的是 qwen3.8-27b、温度 0、探针套件(作者自陈饱和度 85–95%)。作者在"局限"里列了七条,第一条是"单用户、观察性、无随机对照"。这不是黑它——能把局限写得这么老实的研究不多——但你得知道,那些漂亮的数字来自一个人四个月的自我观测。
第四,许可证不是纯 MIT。 LICENSE 在 MIT 之外加了一条署名条款:用在用户可见的产品上,要在首页或关于页注明用了 billion-context 并附链接。GitHub 识别成 NOASSERTION。公司内部用问题不大,做成产品卖之前让法务看一眼。
第五,迭代节奏快到不像生产软件。 我查了 npm:2026-08-05 建包,到今天 8,797 个版本号,平均一天 90 个。绝大多数是 PR 预览标签,但这说明它还在高频实验期。README 里专门维护着"严重缺陷公告"章节——这既是负责,也说明坑是真的有。
谁该装,怎么试
该装的:你有一个跑了几百轮、跨天甚至跨周的编码会话;你被"上下文满了只能重开"这件事伤过;你愿意花一个下午做 A/B 对照。
别碰的:你平时问一句答一句,会话不超过一小时;你在意每一个百分点的成本;你没有精力核对上游 usage。
试的方法我给一个:拿你真实的一个长任务,跑两遍——一遍裸跑,一遍挂 bili——然后只看上游返回的 usage 字段,不看插件自己的回执。插件说"省了 78,392 token"的时候,你要能自己验证上游收到的输入确实少了那么多。moyu-green 那篇实测的价值就在这:工具回执说压缩成功,上游计量说输入没降。
这也是我看完这个项目最大的感受:上下文压缩这个赛道,现在最缺的不是更多压缩算法,是让人能自己验证的计量。 它给了 acp_status 和 acp_cache,方向对了,但你仍然得自己拿上游的 usage 去对账。
工具是好工具。只是那句"省 5 倍 token",最好读成"在你已经跑了 500 轮之后,它可能替你省下不少"。
数据来源:本机实测 2026-11-11(M1 Pro/16GB/Node 22.22.2/billion-context 0.1.213,假上游抓包 + tiktoken cl100k 计数);生产数据引自包内 paper/模型驱动的分层增量压缩-免训练多代上下文管理.md(v0.2,2026-09-07);旁证引自 moyu-green《billion-context 实测:压缩开关输入比 0.98 倍》(2026-11-10)。