ARTICLE · 1400023
实操|如何批量下载全民健康信息平台的质控指标
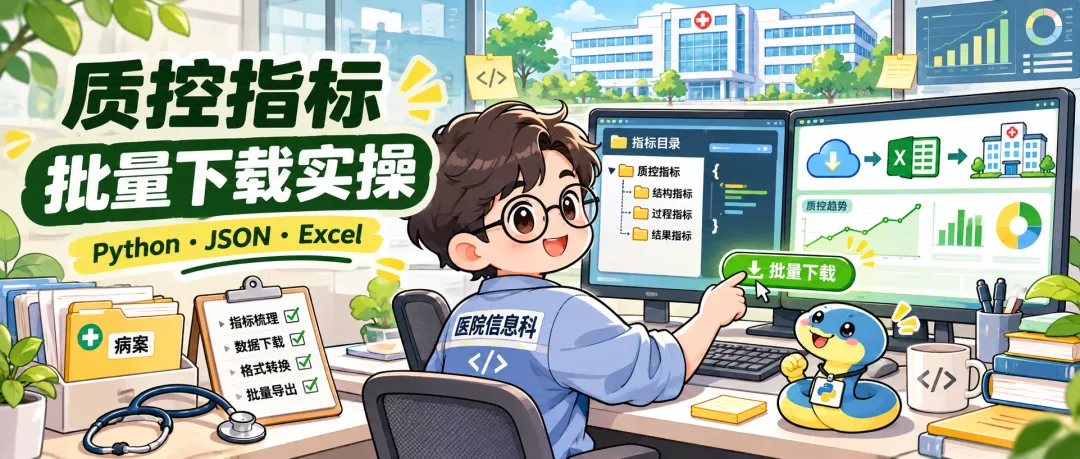
打开一个质控指标详情页,里面有临床分子、分母口径,还有提取规则、字段说明、ICD 编码和其他值域。少量指标可以逐条整理,整个专业批量整理时,可以把工作拆成三步:先拿目录,再按指标 ID 下载定义,最后汇总成工作簿。
01 · 从目录拿到指标 ID
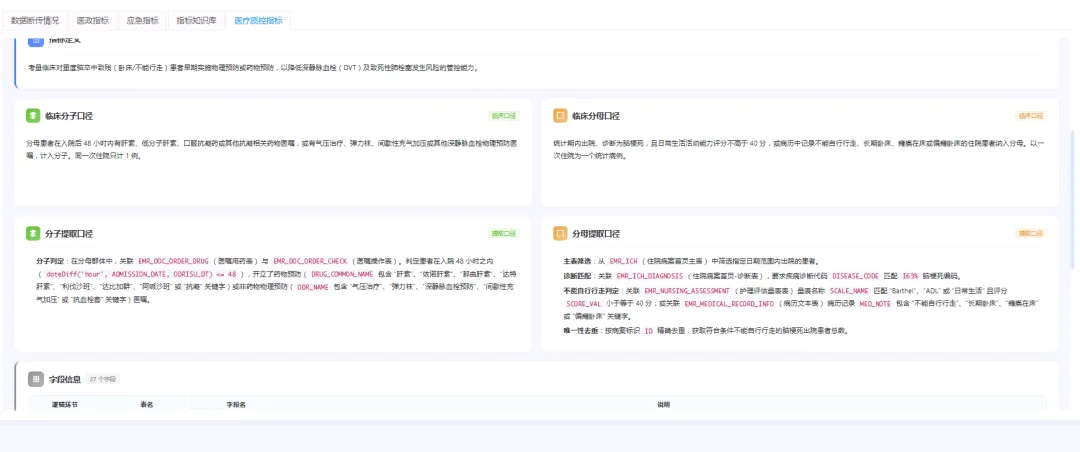
在院方授权范围内,使用平台已有的导出功能或获准调用的指标目录接口。目录按“机构 → 专业 → 指标”组织。递归遍历 children,遇到 type = index 的节点,取 indexId 作为主键,取 label 作为目录名称。相同 ID 只请求一次。
def collect_ids(nodes):
    for node in nodes:
        if node.get("type") == "index" and node.get("indexId"):
            yield str(node["indexId"])
        yield from collect_ids(node.get("children") or [])

index_ids = list(dict.fromkeys(collect_ids(tree)))
指标 ID 从读取到导出都按字符串处理,避免长数字在 Excel 中丢失精度。
02 · 先下载一条,确认拿到的是定义
用一个已知指标 ID 调用院方配置的定义详情接口。先检查 HTTP 状态,再检查业务状态,最后读取响应中的 data。已解码的对象可以直接校验。若接口返回封装后的数据,按平台提供的解码方式得到 JSON 后再进入同一套校验流程。
以“二尖瓣手术术中经食道超声使用率”为例,定义里可以看到 clinicalNum、clinicalDen、fieldList、icdList 等字段。若样本只有年度、指标值、分子数和分母数,应回到院方接口文档核对定义详情地址。样本通过后,再批量请求剩余 ID。
03 · 逐条保存,失败后从断点继续
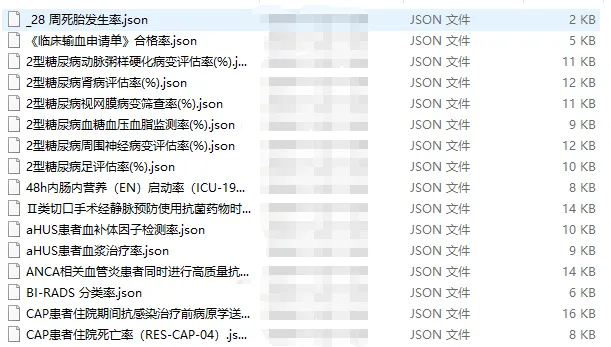
Python 脚本用 requests.Session 复用连接,逐条请求。每条响应校验定义字段和指标 ID 后,写入 UTF-8 JSON。文件名使用指标名称,替换 Windows 禁用字符,发生同名冲突时追加 ID。先写临时文件,写完再替换目标文件。
连接超时、限流或临时服务错误可有限重试。收到 401 或 403 时停止,分别核对会话和权限。失败原因写入 failures.json。重新执行时校验已有文件,已成功的指标直接复用。
python -m pip install requests "cryptography>=43" openpyxl
python .\download_qc_definitions.py --output .\qc_definitions

# 已有 JSON 时,离线重新汇总 Excel
python .\download_qc_definitions.py --output .\qc_definitions --excel-only
以上命令适用于院内下载脚本。运行前按院方接入配置设置接口地址、详情路径和授权凭据。
04 · 把 JSON 汇总成四张表
指标汇总每个指标一行,放定义、临床口径和提取口径。
字段信息展开 fieldList,列出逻辑环节、表名、字段名和说明。
ICD 编码清单展开 icdList,保留完整编码、名称和逻辑变量。
其他值域清单展开 valueRangeList,按指标 ID 回查收费项目、科室代码等取值。
导出后用目录中的去重 ID 数与成功数、失败数和未处理数对账。随机抽几项对照平台页面,尤其要检查编码前导零,以及分子和分母口径是否写到了对应列。
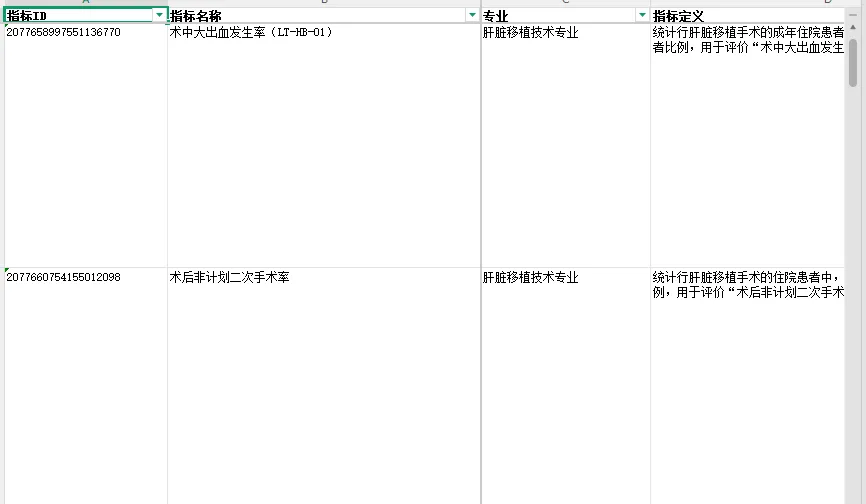
05 · 完整 Python 脚本
将下面的代码保存为 download_qc_definitions.py。运行前,按授权接入配置填入 QC_TOKEN、QC_SM4_KEY,并使用 --base-url 和 --detail-path 指定实际地址。仅从现有 JSON 汇总时,可直接使用 --excel-only。
"""Download QC indicator definitions using the current account's visible tree."""

import argparse
import json
import re
import sys
from pathlib import Path

import requests
from cryptography.hazmat.primitives import padding
from cryptography.hazmat.primitives.ciphers import Cipher, algorithms, modes
from requests.adapters import HTTPAdapter
from urllib3.util.retry import Retry


QC_TOKEN = "PASTE_AUTHORIZED_TOKEN_HERE"
QC_SM4_KEY = "REPLACE_WITH_32_HEX_CHARACTERS"


class AccessError(RuntimeError):
    pass


def decode_payload(response, key):
    try:
        payload = response.json()
    except ValueError:
        payload = response.text.strip()

    if isinstance(payload, dict) and "code" in payload:
        code = str(payload["code"])
        if code in {"401", "403"}:
            raise AccessError(f"接口业务状态 {code},请核对登录状态和权限")
        if code != "200":
            raise ValueError(f"接口业务状态 {code}")
        payload = payload.get("data")
    if isinstance(payload, str):
        cipher_hex = payload.strip()
        if not re.fullmatch(r"(?:[0-9a-fA-F]{32})+", cipher_hex):
            raise ValueError("响应不是有效的 JSON 对象、数组或 SM4 Hex 密文")
        decryptor = Cipher(algorithms.SM4(key), modes.ECB()).decryptor()
        padded = decryptor.update(bytes.fromhex(cipher_hex)) + decryptor.finalize()
        unpadder = padding.PKCS7(128).unpadder()
        plaintext = unpadder.update(padded) + unpadder.finalize()
        payload = json.loads(plaintext.decode("utf-8"))
    return payload


def fetch(session, url, key):
    with session.get(url, timeout=(8, 45), allow_redirects=False) as response:
        if response.status_code in (401, 403):
            raise AccessError(f"HTTP {response.status_code},请核对 Token 和权限")
        response.raise_for_status()
        if response.status_code != 200:
            raise ValueError(f"预期 HTTP 200,收到 {response.status_code}")
        return decode_payload(response, key)


def collect_indicators(tree):
    if not isinstance(tree, list):
        raise ValueError("tree 接口未返回数组")
    indicators = {}
    pending = list(reversed(tree))
    while pending:
        node = pending.pop()
        if not isinstance(node, dict):
            continue
        if node.get("type") == "index":
            index_id = str(node.get("indexId") or node.get("value") or "")
            if not re.fullmatch(r"[0-9]+", index_id):
                raise ValueError("目录中存在无效的指标 ID")
            indicators.setdefault(index_id, node.get("label") or "")
        children = node.get("children")
        if isinstance(children, list):
            pending.extend(reversed(children))
    if not indicators:
        raise ValueError("目录中没有指标节点")
    return indicators


def validate_definition(data, index_id):
    if not isinstance(data, dict) or not any(
        key in data for key in ("clinicalNum", "clinicalDen", "fieldList", "icdList")
    ):
        raise ValueError("详情未返回指标定义字段,请核对 --detail-path 是否为指标定义接口")
    if str(data.get("id") or data.get("indexId") or "") != index_id:
        raise ValueError("定义中的指标 ID 与请求不一致")


def named_output(directory, name, index_id):
    stem = re.sub(r'[<>:"/\\|?*\x00-\x1f]', "_", name).strip(" .")
    # Leave room for the output directory and any collision suffix on Windows.
    stem = stem[:70].rstrip(" .") or index_id
    if re.fullmatch(r"CON|PRN|AUX|NUL|COM[1-9¹²³]|LPT[1-9¹²³]", stem.split(".")[0].rstrip(), re.I):
        stem = "_" + stem

    number = 0
    while True:
        suffix = "" if number == 0 else f"_{index_id}"
        if number > 1:
            suffix += f"_{number}"
        path = directory / f"{stem}{suffix}.json"
        if path.name.casefold() == "failures.json":
            number += 1
            continue
        try:
            data = json.loads(path.read_text(encoding="utf-8"))
        except FileNotFoundError:
            return path, False
        except (ValueError, IsADirectoryError):
            number += 1
            continue
        try:
            validate_definition(data, index_id)
        except ValueError:
            number += 1
        else:
            return path, True


def save_json(path, data):
    temp = path.with_suffix(".tmp")
    temp.write_text(json.dumps(data, ensure_ascii=False, indent=2) + "\n", encoding="utf-8")
    temp.replace(path)


def export_excel(path, definitions, failures):
    from openpyxl import Workbook
    from openpyxl.cell.cell import ILLEGAL_CHARACTERS_RE
    from openpyxl.styles import Alignment, Font
    from openpyxl.utils import get_column_letter

    workbook = Workbook()
    workbook.remove(workbook.active)

    def sheet(title, headers, widths):
        ws = workbook.create_sheet(title)
        ws.append(headers)
        ws.freeze_panes = "C2"
        for column, width in enumerate(widths, 1):
            ws.column_dimensions[get_column_letter(column)].width = width
            ws.cell(1, column).font = Font(bold=True)
        return ws

    def append(ws, values):
        row = ws.max_row + 1
        for col, value in enumerate(values, 1):
            if value is None:
                continue
            if isinstance(value, (list, dict)):
                value = json.dumps(value, ensure_ascii=False)
            value = ILLEGAL_CHARACTERS_RE.sub("", str(value))
            cell = ws.cell(row, col, value)
            cell.data_type = "s"
            cell.alignment = Alignment(vertical="top", wrap_text=True)

    summary = sheet("指标汇总", ["指标ID", "指标名称", "专业", "指标定义", "临床分子口径",
                             "临床分母口径", "分子提取口径", "分母提取口径"],
                    [24, 46, 25, 52, 52, 52, 65, 65])
    details = [
        ("fieldList", "字段信息", ["逻辑环节", "表名", "字段名", "说明"],
         ["logicalStep", "physicalTableName", "fieldIdentifier", "ruleDescription"], [22, 42, 38, 65]),
        ("icdList", "ICD编码清单", ["编码类型", "编码", "名称", "逻辑变量"],
         ["codeType", "code", "name", "logicalVariable"], [16, 24, 48, 22]),
        ("valueRangeList", "其他值域清单", ["值域类型", "值域代码", "值域名称或含义"],
         ["valueType", "code", "name"], [32, 24, 60]),
    ]
    detail_sheets = [
        (list_key, sheet(title, ["指标ID", "指标名称", *headers], [24, 46, *widths]), keys)
        for list_key, title, headers, keys, widths in details
    ]
    for index_id, name, data in definitions:
        label = data.get("name") or name
        base = [index_id, label]
        append(summary, base + [data.get(key) for key in (
            "centerName", "indexDesc", "clinicalNum", "clinicalDen", "num", "den"
        )])
        for list_key, ws, keys in detail_sheets:
            for item in data.get(list_key) or []:
                if isinstance(item, dict):
                    append(ws, base + [item.get(key) for key in keys])

    if failures:
        ws = sheet("下载失败", ["指标ID", "指标名称", "错误"], [24, 46, 80])
        for failure in failures:
            append(ws, [failure["indexId"], failure["name"], failure["error"]])
    for ws in workbook:
        ws.auto_filter.ref = ws.dimensions

    temp = path.with_suffix(".tmp.xlsx")
    workbook.save(temp)
    temp.replace(path)


def read_saved_definitions(directory):
    definitions = {}
    for path in sorted(directory.glob("*.json")):
        if path.name == "failures.json":
            continue
        try:
            data = json.loads(path.read_text(encoding="utf-8"))
            index_id = str(data.get("id") or data.get("indexId") or "") if isinstance(data, dict) else ""
            if not re.fullmatch(r"[0-9]+", index_id):
                raise ValueError("缺少有效指标 ID")
            validate_definition(data, index_id)
        except (OSError, ValueError) as exc:
            print(f"跳过 {path.name}:{exc}", file=sys.stderr)
            continue
        if index_id not in definitions or path.stem != index_id:
            definitions[index_id] = (index_id, path.stem, data)
    if not definitions:
        raise ValueError("输出目录内没有有效的指标定义 JSON")
    return list(definitions.values())


def main():
    parser = argparse.ArgumentParser(description="下载当前账户可见的质控指标定义")
    parser.add_argument("--base-url", default="https://qc.example.org/qc_api")
    parser.add_argument("--detail-path", default="/qc/indexInfo/result/detail/{id}")
    parser.add_argument("--output", type=Path, default=Path("qc_definitions"))
    parser.add_argument("--excel-only", action="store_true", help="从现有 JSON 生成 Excel,无需连接接口")
    args = parser.parse_args()
    excel_path = args.output / "质控指标定义汇总.xlsx"
    if args.excel_only:
        definitions = read_saved_definitions(args.output)
        export_excel(excel_path, definitions, [])
        print(f"已导出 {len(definitions)} 个指标:{excel_path}")
        return 0
    if "{id}" not in args.detail_path or not args.detail_path.startswith("/") or args.detail_path.startswith("//"):
        parser.error("--detail-path 必须是含有 {id} 的站内路径")

    key = bytes.fromhex(QC_SM4_KEY)
    base = args.base_url.rstrip("/")
    args.output.mkdir(parents=True, exist_ok=True)

    failures = []
    definitions = []
    saved = 0
    skipped = 0
    with requests.Session() as session:
        retry = Retry(
            total=3,
            backoff_factor=1,
            status_forcelist=(429, 500, 502, 503, 504),
            allowed_methods={"GET"},
            respect_retry_after_header=True,
            raise_on_status=False,
        )
        for scheme in ("http://", "https://"):
            session.mount(scheme, HTTPAdapter(max_retries=retry))
        session.headers.update({"Authorization": f"Bearer {QC_TOKEN}", "Accept": "application/json"})
        indicators = collect_indicators(fetch(session, base + "/qc/indexInfo/tree", key))
        print(f"目录中共有 {len(indicators)} 个不同的指标 ID")

        # Verify the configured detail endpoint before starting bulk requests.
        sample_id = next(iter(indicators))
        sample = fetch(session, base + args.detail_path.replace("{id}", sample_id), key)
        validate_definition(sample, sample_id)

        for number, (index_id, name) in enumerate(indicators.items(), start=1):
            try:
                path, already_saved = named_output(args.output, name, index_id)
                if already_saved:
                    data = json.loads(path.read_text(encoding="utf-8"))
                    definitions.append((index_id, name, data))
                    skipped += 1
                    continue
                legacy_path = args.output / f"{index_id}.json"
                try:
                    data = json.loads(legacy_path.read_text(encoding="utf-8"))
                    validate_definition(data, index_id)
                except (OSError, ValueError):
                    data = sample if index_id == sample_id else fetch(
                        session, base + args.detail_path.replace("{id}", index_id), key
                    )
                validate_definition(data, index_id)
                save_json(path, data)
                definitions.append((index_id, name, data))
                saved += 1
                print(f"[{number}/{len(indicators)}] {index_id} {name}")
            except (requests.RequestException, ValueError, OSError) as exc:
                failures.append({"indexId": index_id, "name": name, "error": str(exc)})
                print(f"[{number}/{len(indicators)}] {index_id} 失败:{exc}", file=sys.stderr)
            except AccessError as exc:
                failures.append({"indexId": index_id, "name": name, "error": str(exc)})
                print(f"{exc},已停止下载", file=sys.stderr)
                break

    save_json(args.output / "failures.json", failures)
    export_excel(excel_path, definitions, failures)
    print(f"已导出 {len(definitions)} 个指标:{excel_path}")
    pending = len(indicators) - saved - skipped - len(failures)
    print(f"新增 {saved},跳过 {skipped},失败 {len(failures)},未处理 {pending}")
    return int(bool(failures or pending))


if __name__ == "__main__":
    try:
        sys.exit(main())
    except (AccessError, requests.RequestException, ValueError, OSError) as exc:
        sys.exit(f"下载停止:{exc}")
医院拿到工作簿后,可以先选一项重点指标,把字段和编码映射到院内病案、医嘱或费用数据,再按同一口径复算。复算差异可直接转成字段补齐、编码映射和流程整改任务。