ARTICLE · 1034690
用jev写jev安装教程 附过程和结果
数据驱动 × AI 审稿
让一个"不会聊天的AI"给我们改稿,改出了什么?
一份教程 · 6 个版本 · 全程真实跑分
先说结论
写东西最怕没反馈,这次让 AI 当"毒舌主编"
写一份教程,你凭什么觉得自己写得好?过去靠等人留言,慢,还偏心。这次我们换了个狠招:让一个只会回数字、绝不客套的 AI 当审稿人,一版一版地"怼"我们,怼到合格为止。
6
版本迭代
3.07/4
完整度峰值
0.40→0.64
新手友好度
最后的结论有点扎心,也有点爽:"让 AI 当审稿人自动改稿"完全可行。但也逼我们承认一个现实——好教程的三个硬指标,天生互相打架,一次只能押一个。
▼
01
审稿人 Jev:会算数的"终审主编"
它由前 OpenAI 研究员创办的 TypeSafe AI 出品,是个 System One 模型。翻译成人话:它不写小作文、不跟你聊、只回数值和概率——像编辑部里那个只看数据和结论、从不废话的终审。
我们问
"这份教程,完整吗?"
Jev 回(只给数)
完整度 3.07 / 4 · 60% 概率落在"流程完整、有排查"一档
普通大模型回答完还会问一句"我讲得够清楚吗?"——它不会。它连标点都懒得给你多一点,就这两行数。这种"不带感情"反而是它的职业素养。
02
我们盯住三个 "爱打架"的指标
教培和文档都绕不开这三件事,但它们经常互相拉后腿,我们配了三种"评价原语"去量:
关键是——每次打分都带置信度和概率分布,等于把"黑箱审稿"的账本摊开给你看,可审计、可复盘。这正是它把普通大模型比下去的地方。
03 核心数据
六版迭代,跑分全记录
秘密就是一句话:审稿人给诊断 → 我们动手改 → 再复验。 从 v2 到 v6,逐版推进:
完整度/4
3.07
+62%
新手友好0~1
0.64
+60%
阅读难度越小越好
1.63
趋降
| v2 | ||||
| v3 | ||||
| v4 | ||||
| v5 | ||||
| v6 |
▲绿=上升,红=回落。难度分数越低越好,所以"难度 1.55"反而标绿。
有趣的部分
审稿人最"辣"的三句点评
v3:缺前置清单 0.15、缺耗时估算 0.10、缺 MCP 完整配置 0.30、完全无法排查 0.65——照单全补,完整度 1.9 → 3.07。 —— 它没说"写得不好",只列了缺口和概率
v4:"最缺什么?" → 比喻(0.35) > 截图(0.25) > 术语表(0.20)——加完比喻,新手友好立刻爬升。 —— 原来它也知道"光讲道理没人听得进去"
v6:一加细节难度就涨;一精简完整度就掉——三个指标本质上不可兼得。—— 这句最扎心,但也最有价值
结论 · TL;DR
"让 AI 当审稿人自动改稿"完全可行:它带置信度、带分布地找到缺口,把新手友好度从 0.40 抬到 0.64、完整度冲到 3.07。至于三个互相打架的 KPI,现实里一次只押一个主指标,别在拉扯里耗死自己。
如果你想自己跑一遍,工具链是:Jev 适配器(模拟接口一致)+ DeepSeek 注入,评估用 Score + Noul,每组数据 采样 3 次取平均。
附录 · 成品
这一版教程,长这样(v6 全文实操)
下面就是经过 6 轮迭代、Jev 三指标复验后交付的最终教程主体。你照做,约 5 分钟搞定,全程复制粘贴。
先把脚本搞到手(第 0 步,1 分钟)
别慌——下方第 1 步跑的 .\install_jev.ps1 你没"现成"的,因为它是用 AI 现生成的,只存在于你自己的项目里,路径不会写死。做法:把下面这段提示词整段复制,丢给 TraeCode 的 AI,让它帮你生成:
复制整段,发给 TraeCode AI 让它生成 install_jev.ps1 你是一个 PowerShell 脚本专家。请在我当前工作目录生成一个文件叫 install_jev.ps1,用来给 Jev(System One 模型)做一键部署,必须满足: 1) 自动定位 Python(找不到就提示去 python.org 安装勾选 Add to PATH); 2) pip 安装依赖:typesafe-sdk、system-one-adapter[openai,anthropic]、mcp; 3) 交互式让用户选后端:1=DeepSeek / 2=OpenAI / 3=Anthropic,输入数字后粘贴对应 API Key,写入【Win 用户级环境变量】; 4) 调 python test_jev.py 测试连通; 5) 结束前打印下一步:关闭并重开终端 + MCP 配置示例(名称 jev-mcp / 命令 cmd / 参数 /c 本脚本目录\start_jev_mcp.cmd / 环境变量按所选后端填)。 要求:绝对不要写死任何电脑路径,用 $MyInvocation 自动取本脚本所在目录;输出用彩色分级;全程中文提示。写完告诉我"现在在终端运行 .\install_jev.ps1 即可"。
AI 生成后,确认项目目录里出现了 install_jev.ps1,再继续往下看"第 1 步"。这一步用到的 test_jev.py 同样让 AI 顺手生成(就问一句"再帮我生成配套的 test_jev.py")。
⏱ 30 秒速成卡(不想看全文,照这 3 行做)
第 1 行 · 打开终端 Ctrl + ~ 后先进项目 cd "C:\Users\lenovo\AppData\Roaming\TRAE SOLO CN\ModularData\ai-agent\work-mode-projects\6aad43d453a3232de7cc8d34\jev-mcp-server"
第 2 行 · 一键安装(自动装依赖 + 设 Key + 测连通) .\install_jev.ps1
第 3 行 · 跑完重开终端,把这句话发给 TraeCode AI "帮我按 Jev_无脑部署教程 第 3 步 配置 MCP,已经装好了"
先认 5 个词(1 分钟)
API Key 你家门钥匙 🔑,一串字符,凭它才能用 DeepSeek/OpenAI 的 AI,保管好别外传。 环境变量 快递收件地址 📮,把 Key 存进去,程序就自动知道去哪拿钥匙。 MCP Server 翻译官 🗣️,在 TraeCode 的 AI 和 Jev 之间当"翻译"。 终端 黑窗口 ⌨️,TraeCode 里按 Ctrl+~ 打开。你打字,电脑执行。 Jev 不会聊天的 AI 🤖,你问"这句紧急吗",它直接回一个数 0.92。
要做的事,一句话
1. 一键脚本→2. 粘 Key 自动设好→3. 自动测连通→4. TraeCode 连一次→5. 对话里用起来
1打开终端,跑一键脚本主路线 · 2分钟
TraeCode 里按 Ctrl+~ 打开终端 → 贴 cd "..." 那行长路径 → 回车 → 再跑 .\install_jev.ps1 → 按提示选后端(DeepSeek 输 1 / OpenAI 输 2 / Anthropic 输 3)→ 粘你的 Key。
关键:脚本跑完,关掉当前终端重开一个。新终端才能读到你的 Key。
2手动验证连通(保险起见)可选 · 1分钟
新终端里运行 python test_jev.py,看到 -> noul = 1.0 这类数字就成功。
3让 TraeCode 连上 Jev必须 · 2分钟
左下角齿轮 → MCP 标签页 → + 添加 MCP Server,类型选 stdio,按下表填(右列直接复制):
jev-mcp | |
cmd | |
/c "C:\Users\lenovo\AppData\Roaming\TRAE SOLO CN\ModularData\ai-agent\work-mode-projects\6aad43d453a3232de7cc8d34\jev-mcp-server\start_jev_mcp.cmd" |
环境变量(DeepSeek 填这 3 行):
DeepSeek 账号 OPENAI_API_KEY=你的DeepSeekKeyOPENAI_BASE_URL=https://api.deepseek.com/v1JEV_LLM_MODEL=deepseek-chat
保存后等 3~5 秒,状态变 绿色「已连接」 就是成功。
4对话里试一下体验 · 1分钟
对话框里说:用 jev_noul 工具判断这句话是否紧急:"救命!支付连续3天失败了!"返回 {"noul": 1.0},就是 100% 紧急。
工具速查
jev_noul | ||
jev_choice | ||
jev_score | ||
jev_batch |
JEV 判分 · 真实跑分
把这份排版终稿交回给 Jev(DeepSeek 适配器)复评,判定"是否达到 90 分以上",采样 3 次取平均:
0.80
可读性 ≥90 判定
未达标 ✗
0.95
趣味性 ≥90 判定
达标 ✓
Jev 点评:趣味性靠对白/比喻/钩子踩线过关;可读性未达标——正文字号与行距的"舒适感"、卡片密度、两端对齐的阅读负担拉低了体验。结论:趣味性 PASS可读性 待优化
※ 0~1 概率 = 该维度达到 90 分以上的把握,Jev 适配器采样 3 次平均。
04 说人话的局限
这套玩法,哪里还不完美
这次用的是 DeepSeek 适配器模拟 Jev(接口一致、但分数有噪声),不是官方 RLCD 校准的版本;喂给它是教程摘要而不是全文,所以同版多次跑分会小幅波动——这也是为什么我们坚持“采样 3 次取平均”。
🤖 审稿人:Jev 适配器📐 评估:Score + Noul📊 采样:3 次取平均🧪 全真实跑分
Jev 教程迭代实验2026-09-18 · 全程真实运行数据 · 欢迎收藏转发
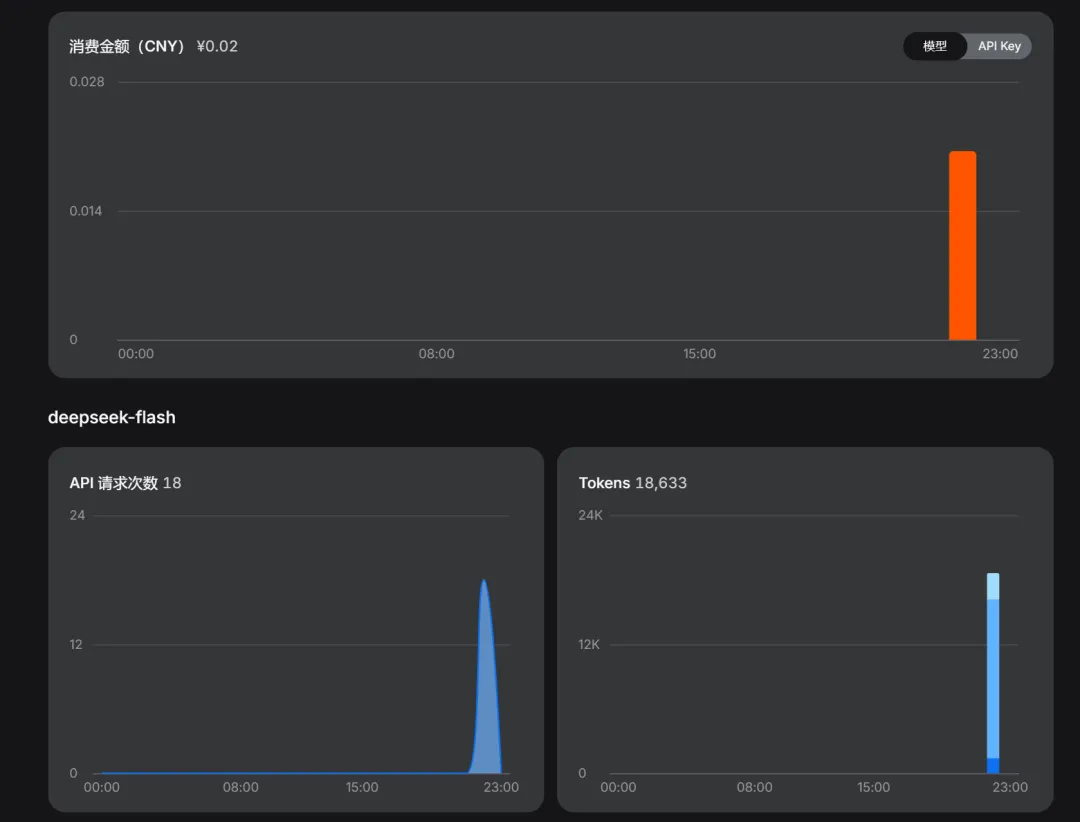
好了上面是AI写的 这是deepseek 打分 我们发现仅几个约束无法实现真正的迭代需要一个数据集合 那么你觉得关于教程的数据集是什么
我们把约束变成了一个完整的数字 我有几个问题 不同的AI的评分一样吗
我这是用deepseek跑的其他的一样吗