ARTICLE · 1036241
AI面试:Agent处理200份文档跑到83份的时候挂了,怎么办?
先看一段代码。这大概是很多人写 Agent 的第一步:
for (String doc : docs) { // 200 份文档Stringtext= readFile(doc);Stringresult= chatClient.prompt() .user("从这段文本里抽取合同要素:\n" + text) .call().content(); // 一次模型调用 contractMapper.insert(doc, result); // 一次写库}逻辑没问题。200 份,跑完收工。
问题在于它跑在凌晨三点。跑到第 83 份的时候,模型那边返回了一个 429;或者网络抖了一下;或者机器内存吃满,进程被系统直接干掉。这几种情况都不算罕见,随便中一个,进程就没了。
你的第一反应,是把它重新跑一遍。然后你会遇到三个后果:前面 82 份的模型调用,token 又烧了一遍;前面 82 份的插入,数据库里现在有 164 行;如果这段逻辑里还有「给审核人发邮件」,那位同事已经收到两封了。
第二次可能跑到第 61 份又挂。第三次,你开始盯着终端手动数进度。
这不是运气问题。这段代码从第一行起,就没考虑过「中途失败」这件事。
面试官问的「跑了 83 份挂了怎么办」,考的就是这个。
但这里有个坑:绝大多数人(包括我第一次被问到时)会把它当成一道重试策略题来答——加个 retry、套个 try-catch、挂个定时任务重跑。这么答,第一轮就出局了。
面试官真正在考的,不是「你会不会重试」,而是三层更基础的东西。而且这三层是递进的——只答第一层,等于没答。下面一层层拆。
01第一层:它到底跑到哪了
先说个反直觉的判断:你现在的进度,很可能存在一个最不该存的地方。
很多人会想:Agent 不是有对话历史吗?历史里不是记着「我已经处理到第 82 份」吗?
不行。原因是这个历史有三个特性,每一个都致命:它会持续膨胀,几百轮之后塞满过期的工具输出和无关内容;它会被污染,模型开始分不清自己进行到哪一步;最要命的是——它本身很可能就是这次崩溃的原因(上下文超限、序列化失败、请求体过大被拒)。
用一个已经崩掉的东西,去恢复崩溃,逻辑上就不成立。
正确做法只有一句话:进度必须是外部的、持久的、能被独立读取的。不要让它只活在进程内存里,也不要让它只活在模型的上下文里。
最小实现,真的就一张表:
CREATETABLE task_progress ( task_id VARCHAR(64) PRIMARY KEY, -- 哪一个任务 total INTNOTNULL, -- 总共多少个单元 last_done INTNOTNULL, -- 已完成到第几个(-1 表示一个都没做) updated_at TIMESTAMPNOTNULL);然后启动时读一次:有记录就从 last_done + 1 开始,没有就从 0 开始。听起来简单到不像技术方案,但它解决的是最关键的那一半问题。
这里有个顺序细节,反了会出生产事故。
只有当一个工作单元真正成功之后,才能推进度。绝不能提前写。如果提前写,你会把一个「看起来做完了、其实写库失败」的单元记成「已完成」——恢复时它被跳过,那份坏数据就永久留在系统里,而且不会报错。
好,现在你知道从哪接着跑了。但这只解决了「在哪」,没解决「接着跑会不会做错事」。
02第二层:接着跑,会不会重复做
回到刚才那段代码。你从第 83 份开始跑,看起来安全了。但如果崩溃发生在「模型已返回、写库还没提交」的那个瞬间呢?
恢复后第 83 份会被重新处理一次。对写库来说这可能是好事(补上了),但对「发邮件给审核人」来说,就是那位同事收到两封。
所以第二层要回答的是:哪些动作重复执行是安全的,哪些不是。
| 安全 | |||
| 基本安全 | |||
| 不安全 | 必须带幂等键 |
第三行的东西,是所有 Agent 系统的真实风险点。而处理它的办法,业界的答案高度一致:给每一个非幂等动作配一个幂等键,落到一张去重表里。
// 关键:幂等键绑定的是「哪个任务的哪一步」,不是「这一次调用」StringidemKey= taskId + ":" + docId;// 1. 先去重表占位,唯一键冲突说明这一步已经做过了if (dedupMapper.tryClaim(idemKey) == 0) { log.info("duplicate step, skip: {}", idemKey);return;}// 2. 真正干活(调模型、写业务库、发通知)Stringresult= extract(docId);contractMapper.upsert(docId, result);notifyReviewer(docId);// 3. 全部成功之后,才推进度progressMapper.advance(taskId, index);幂等键最容易写错的地方:把它绑到「这次请求」上。比如用 UUID.randomUUID() 当键,重试时你会生成一个新的,去重表根本拦不住。
正确的键,必须由任务身份 + 步骤身份确定性地推导出来——同一个步骤,无论重试多少次,算出来的键都必须一样。
到这里,进度表 + 幂等键,你已经能应付绝大多数批处理场景了。一整天的工作量,换来的是任务能安全地接上。
但前面这两层,都是「你自己写机制」。而工业界真正在用的东西,机制完全不一样——它甚至不保存「进度」这个东西。
03第三层:恢复这件事,可能根本不该由你来算
先破一个被普遍混淆的概念。很多人说「我上框架了,我有检查点,所以我能续跑」——这两件事不是一回事。
检查点 ≠ 持久化执行。
检查点保存的是数据;持久化执行保存的是执行本身。框架的 checkpointer 把状态写进了数据库没错,但那条 run 依然活在单个进程里——进程死了,run 就死了。真正要有人去做的事是:发现它失败了、判断该从图的哪一个点重入、然后把它拉起来。这套东西,checkpointer 不管,得你自己建。
那工业界怎么做的?答案有点反直觉:它不保存快照,它保存日志,然后重新跑一遍。
这套机制叫确定性重放(deterministic replay)。以 Temporal 为例,它的做法是:把每一次外部调用的输入和结果都追加进一条只增不改的事件历史(event history);崩溃之后,找一个新 worker,把工作流代码从头重新执行一遍,每遇到一个已经记录过的调用,就直接取历史里的结果返回,而不是真的再调一次。
代码自己会走到它该在的位置。于是「我该从哪继续」这个巨难的问题,被整个消解掉了。
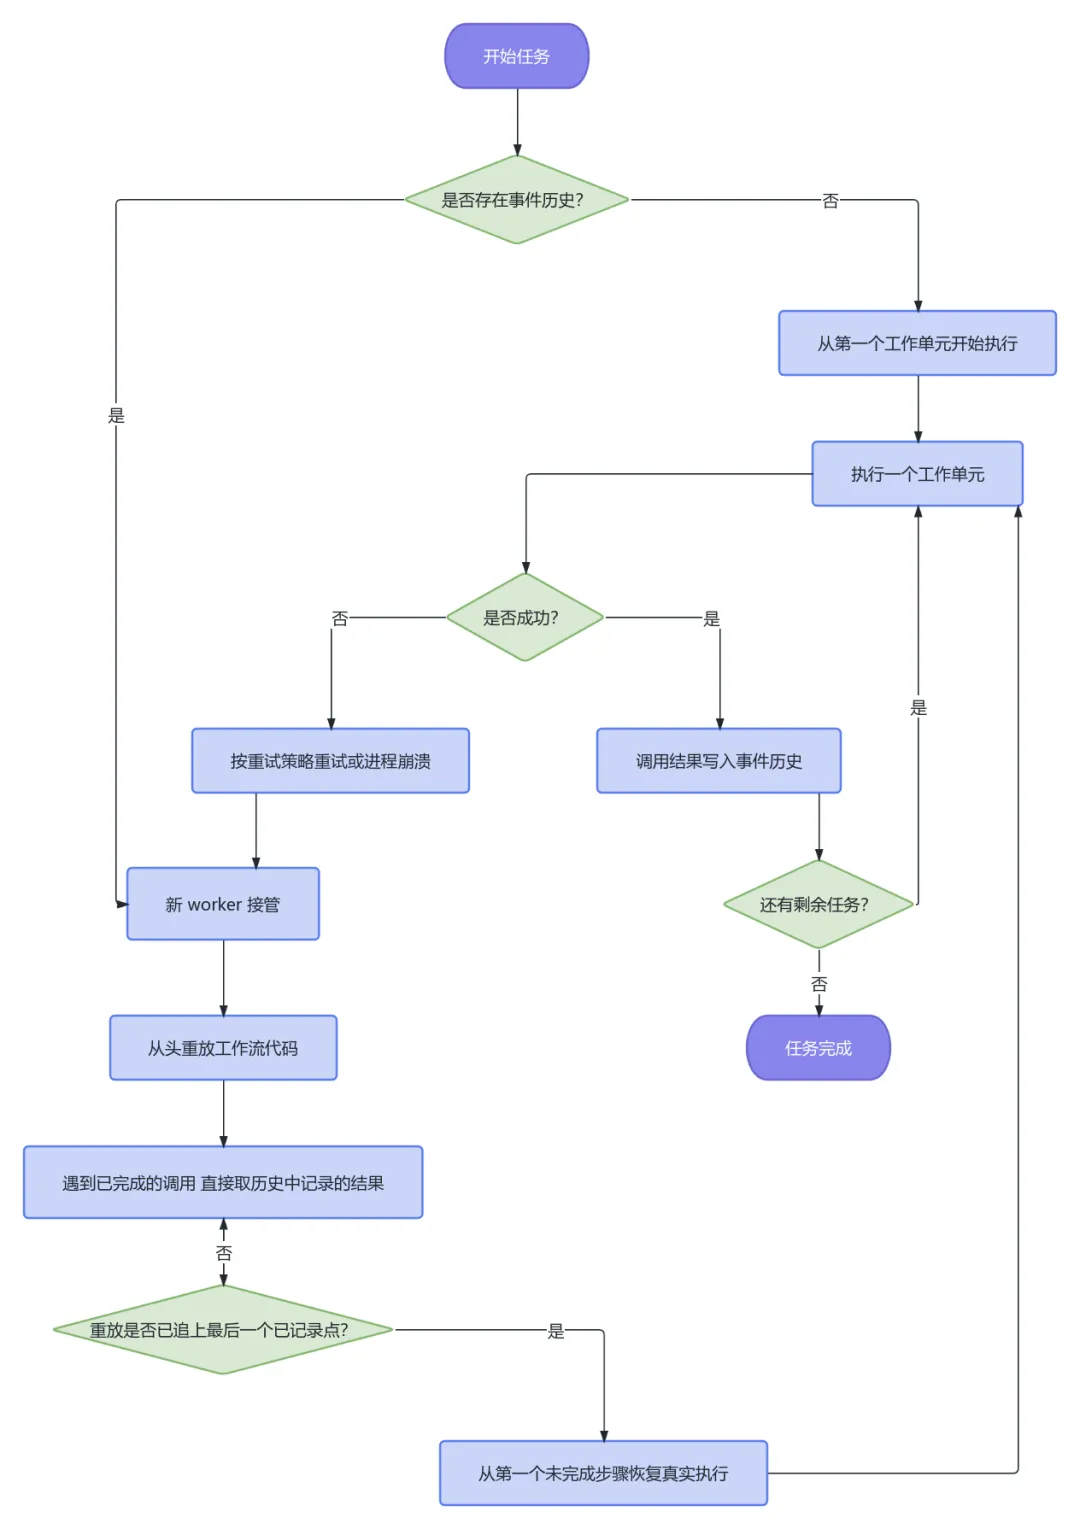
这套东西能成立,靠一个非常硬的前提:
工作流代码必须是确定性的。同样的历史输入,必须产生同样的执行路径。
| 必须包成 Activity |
注意最后一行。LLM 和这套机制存在天然冲突:模型的输出本来就不确定,而重放要求确定。矛盾的解法不是「让模型确定」,而是把它整体挪到边界外——第一次调用时,它的输出就被写进事件历史,从此变成一个固定输入。重放时不再调模型,直接读记录值。
所以这套架构真正的设计原则,是一个分界线:外面是确定性的编排层(可重放、可推演),里面是非确定性的调用层(结果落盘、副作用去重)。
把 LLM 放在确定性代码路径里,是绝大多数 Agent 线上事故的根源。——不是 LLM 不可靠,是它站错了位置。
顺带说,这也是为什么这套架构能承诺「崩溃后不重复任何已完成的工作」。它不是靠小心,是靠机制上让重复不可能发生——因为已完成的调用根本没有被再次执行的机会,代码取到的是日志里的旧结果。
讲到这里,有一个细节会让很多人翻车,而且翻车的人通常以为自己已经做对了。
问题很简单:你的检查点,是什么粒度?
以图编排类框架为例,它的 checkpointer 是节点级的——一个节点执行完,状态落一次。而一个节点,往往是一整个「推理步骤」:规划 → 调三次工具 → 汇总,全在一个节点里。
业内有一个被反复引用的例子:某个节点内部是一个处理 10000 条数据的循环,崩在第 8742 条。恢复时,因为这个节点从来没有正常返回过,框架只知道「这个节点没完成」,于是它从第 0 条重新开始跑。
你做了检查点,但你的检查点粗到救不了你。
而与此对照,事件日志式引擎的粒度是调用级的:每一次调用和它的返回值都进历史。崩在第 8742 条,恢复时前面 8741 条的结果全部从历史里读,代码从第 8742 条继续。两者相差的不是性能,是「你愿意在哪里丢工作」。
跑几个月的任务,事件历史会涨到几十万条,重放开销越来越大,而平台通常还设了硬上限。成熟引擎给的解法是「换一条新的 run」——跑满一定步数就主动收尾,把当前状态作为新 run 的输入,历史归零重来。
所以检查点机制其实包含两件事,不是一件:什么时候存,以及什么时候该截断。只想到前者,长期任务迟早会撞到天花板。
机制讲完了,接下来是个更现实的问题:我这活儿,到底要上到哪一层?
先给结论:多数团队从第 1 级起步就够了。重机制不是能力强,是成本高——一个小任务引入一个运行时,是典型的过度设计。
就是前面那段 Java。三个动作,顺序不能换:占位去重 → 真正干活 → 推进度。它土,但它在生产上真的能拦住重复。
graph.py
from langgraph.checkpoint.postgres import PostgresSaverfrom langgraph.graph import StateGraph, START, ENDdefbuild(conn_string, task_id): g = StateGraph(State) g.add_node("plan", plan) # checkpoint 在每个 node 返回后触发 g.add_node("execute", execute) g.add_edge(START, "plan") g.add_edge("plan", "execute") g.add_edge("execute", END)with PostgresSaver.from_conn_string(conn_string) as saver: saver.setup() # 内存版重启即丢,生产必须落库 app = g.compile(checkpointer=saver)# thread_id 代表"这条任务",恢复时用它找回检查点 cfg = {"configurable": {"thread_id": task_id}}return app, cfg用这一层必须盯住两件事:第一,确认存储后端不是内存版——内存版重启即丢,是新手最常见的假成功;第二,回头看看你的 node 有多大。node 内部如果有长循环,你只能得到节点级的恢复能力,要么把循环拆成 per-item 的节点,要么这一层根本不适合你。
L3 的最小骨架(以 Temporal Java SDK 为例)
publicclassExtractWorkflowImplimplementsExtractWorkflow {privatefinalExtractActivitiesactivities= Workflow.newActivityStub( ExtractActivities.class, ActivityOptions.newBuilder() .setStartToCloseTimeout(Duration.ofMinutes(2)) .setRetryPolicy(RetryOptions.newBuilder() .setMaximumAttempts(3) .setInitialInterval(Duration.ofSeconds(2)) .build()) .build());@Overridepublicvoidrun(List<String> docIds) {for (String docId : docIds) {// 每个 Activity 的返回值都会进事件历史,// 重放时直接读记录值,不会重复调用 activities.extractOne(docId);// 历史太长就换一条新 run,把剩余任务带过去if (Workflow.getInfo().getHistoryLength() > 10_000) { Workflow.continueAsNew(remaining(docIds, docId)); } } }}注意这段代码里没有一处直接调系统时间、随机数或网络——所有 I/O 都在 Activity 里。
这不是风格洁癖,是重放的前提。工作流代码一旦碰了不确定的东西,重放就会和历史分叉,任务直接失败。
一个给 Java 读者的现实提醒
如果你和我一样主要写 Java,这里有个客观情况值得知道:这一赛道的生态是Python / TypeScript 优先的。图编排类框架基本是 Python 主场,几个主流引擎里有的只提供 TS 和 Python SDK。
Java 侧能用的是:Temporal Java SDK(最成熟,workflow/activity 模型完整)、Restate(有 Java SDK,单二进制部署,注意是 BSL 许可不是标准开源)、DBOS Transact(把运行时塞进数据库,支持 Java)。选型时这三个是能落地的,其它几个多数要先接受「服务用 Java、编排用 Python」的混合架构。
这个信息在面试里说出来,比背概念更值钱——它说明你真的做过技术选型,而不是只读过文档。
06回到面试:这段话可以直接背
面试官:「200 份文档跑了 83 份挂了,怎么办?」
建议按这个顺序答,压到 90 秒以内。五句话,层层加码:
第一句,先拆问题。「这件事要拆成两个:怎么知道跑到哪,和怎么保证接着跑是对的。只解决前一个不够。」
第二句,给最小可用方案。「活跃进度必须落在外部存储,比如一张 progress 表记 task_id 和 last_done。顺序上一定是先完成任务、再推进度,反过来会把半成品记成已完成。」
第三句,补正确性。「光有进度不够,恢复会重复触发副作用。所有非幂等动作必须带幂等键,键要绑任务加步骤,不能绑单次请求,否则重放时去重会失效。」
第四句,拉高到框架层。「框架层是持久化执行。以 Temporal 为例,它不存快照存事件历史,恢复时把工作流代码从头重放,已完成的调用直接读记录结果。代价是工作流代码必须确定性,所以 LLM 调用要包成 Activity。」
第五句,收边界。「但要不要上引擎取决于量级。十分钟以内、副作用可逆的,进度表加幂等键就够了,上引擎是过度设计。」
这五句话的分量在于:前三句证明你写过一个真实的系统,第四句证明你知道工业界在怎么做,第五句证明你会做取舍。
而最容易加分的,其实是第五句。因为能说出「什么时候不该用」,比能背出「怎么用」更难,也更难伪装。
07回到那段 for 循环
它本身没有语法错误。它错在假设了「200 份都能跑完」——而真实系统里,这个假设几乎从不成立。
所以断点续跑这件事,说到底不是一道容错题,是一道状态该放在哪的题。
你把状态放在进程内存里,进程就是你的单点;放在模型的对话历史里,模型就是你的单点;只有把它放到外部、持久、可独立读取的地方,并且让每一个副作用都能被去重,任务才真正拥有了「活过崩溃」的能力。
再往上走一层,成熟的引擎干脆不问你「恢复到哪」,它只记日志、然后重放——把「从哪继续」这个问题本身取消了。这是工程上很典型的一种解法:不解决难题,而是让难题不存在。
下次你的 Agent 挂在第 83 份的时候,希望你不用盯着终端手动数进度。
如果这篇帮你把「断点续跑」从一句话讲成了三层机制
• 想继续看 Agent 编排的源码级拆解(AgentScope 2.0 / MCP / Harness Engineering / 流式取消),关注「Fox爱分享」
• 有具体落地方案想聊,或者想看哪一层的完整代码,评论区留言
• 觉得有用,转给正在写长任务 Agent 的同事——他大概率还没处理幂等键
参考与可核实来源
1. Temporal 官方文档:Workflows、Activities、Determinism(工作流代码确定性约束)
2. Diagrid 工程博客:《Checkpoints Are Not Durable Execution》,关于检查点与持久化执行的边界划分
3. LangGraph 官方文档:Persistence / Checkpointers,节点级检查点与存储后端说明
4. DBOS / Restate / Inngest 官方文档:事件日志、幂等键、零算力挂起机制