ARTICLE · 1037236
我给自己搭了个 AI 助手,328 次对话的真实账单
内网运维实录 · 每篇一个能直接抄的方案
我给自己搭了个 AI 助手,328 次对话的真实账单
七月下旬那阵子,我每天在干一件很蠢的事:从编辑器复制一段代码,切到浏览器,粘进对话框,等它回,再把结果粘回来。一天来回几十次,剪贴板里最后剩什么自己都不知道。
八月三号我不干了,自己搭一个。
我砍掉了大部分需求
一开始我列了很长的需求清单,什么都要。后来全删了,剩下的只有三条。
它得一直开着,别每次用都重新启一遍。它得能碰我本机的文件,不然跟网页版没有任何区别。第三条最要紧,每一次请求花了多少 token,我得看得见 —— 看不见的东西,用着用着就会失控。
结构上没玩花样。Flask 起一个本地服务,pywebview 开一个原生窗口指向它,界面是 HTML,后头是 Python。选 HTML 是因为改界面不用重新打包,挪个按钮存盘刷新就完了。代价是它依赖系统里的 WebView2 运行时,换一台干净的机器可能起不来。这个亏我认了,换来的是我改界面不用等编译。
启动这件事被我搞复杂了
入口文件第一件事不是启动服务,是检查依赖。
第一轮 import flask 和 webview,第二轮单独 import openai 和 PIL。
查两遍不是洁癖。我遇到过 pip 装到一半失败,import flask 照样成功 —— 挂掉的那个包排在后面。程序一路往下跑,跑到真正要用它的时候才炸,报错位置跟真正的原因隔着几百行。
两轮查完,起 Flask 线程,轮询等它就绪,就绪了才开窗口。日志按步骤打点,真实时序是这样:
RUNPYW: checking dependencies
RUNPYW: importing main
RUNPYW: starting flask thread
RUNPYW: waiting for flask
RUNPYW: flask ready=True
RUNPYW: creating webview window
RUNPYW: starting webview
从检查依赖到窗口起来,四秒左右,光依赖检查就占了三秒 —— 两轮 import 本身就要一秒多,剩下的全是库自己加载的开销。这个数后来成了我优化启动的靶子。
按步骤打点这件事,是我被"它慢"这三个字教育过一次之后才做的。不按步骤打,你只能看到"从双击到窗口出现花了四秒",知道四秒之后干什么?什么也干不了。
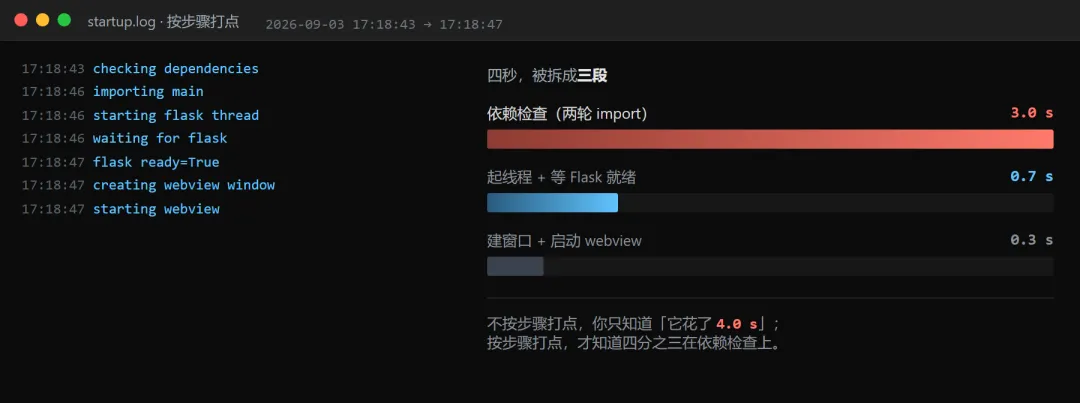
启动日志按步骤打点,四秒被拆成七段,哪一段贵一眼就看出来
让它干活,而不是聊天
真正的分水岭是工具调用。聊天谁都会,让它真的去读一个文件、跑一段脚本、把结果整理成表,是另一回事。
我把所有工具统一注册在一个文件里,现在那个文件一百多 KB。每个工具定义三样东西:名字、参数结构、执行函数。模型不直接调 Python,它返回一个"我要调某个工具、参数是这些"的结构,我这边解析、执行、把结果塞回对话,再让它接着想。
第一次做这件事的人多半会低估一点:一轮不够用。
引擎里跑的是个循环。模型说要用工具,我执行完把结果喂回去,它可能还要再调一次,甚至再调两次。界面上我给了个状态提示——「思考中(第 3/5 轮)」,上限五轮。设三轮经常卡在半路,设十轮又可能绕进去出不来,五轮是我试出来的。
这里翻过一次车,很蠢。有一版我在循环结束后直接取最后一条消息当答案返回,结果工具调用完那一轮的内容是空的,界面上就一片空白。我盯着那个转圈看了半天,一度以为程序卡死了,后来把中间每一轮的原始返回打出来才想明白:模型那一轮说的是"我要调工具",不是"这是我的答案",我拿错了那条。
工具越多,每次请求越贵
工具定义是跟着每一次请求一起发出去的。
名字、参数结构、每个参数的说明,全都在系统提示词里,模型每次都要重新读一遍。工具加得越全,前缀越长,每一次对话都要为这堆定义付一次钱 —— 哪怕这一轮根本没用到它们。
我那个注册文件一百多 KB,每天真正在用的工具不到十个。写工具的时候很爽,减工具的时候才发现自己攒下了一堆只用过一次的东西。
所以后来我给它划了条线:只管本机的文件、命令和文档转换,不接任何需要联网的外部服务。工具少一点,前缀短一点,出错的面积也小一点。
托盘图标是另一件必须做的事。程序挂在系统托盘上,关掉窗口不退出进程,下次点一下直接回来 —— 「一直开着」这条需求,最后是靠一个图标实现的。
账本得先做,不能等
用量统计模块几乎是第一批写的东西。原因很实际:这是我自己最想看的数据。
跑到现在的数字是:328 次请求,1,591,816 个 token,平均一次请求 21.4 秒。
分模型摊开是这样:
四行里最扎眼的是第一行。98 次请求只记到两万一千多个 token,平均一次 222 —— 光系统提示词就不止这个数,这行账明显是错的。
原因在流式返回上。流式默认不带用量,我得在请求里加 stream_options.include_usage,服务端才会在流末尾额外吐一个 chunk,把真实的 prompt 和 completion 数带上。
而这几家里有不吃这个参数的,带了直接报错。我的代码会 catch 住、退化成都不要用量只管读流 —— 于是那 98 次请求的账全是残的。
同样的坑我后来在别处又撞见过一次。用量统计从来不是你写个计数器就算完的事,它取决于服务端愿不愿意告诉你。你没法事后补,只能提前确认;确认不了,就得接受账本上有一块永久是空的。
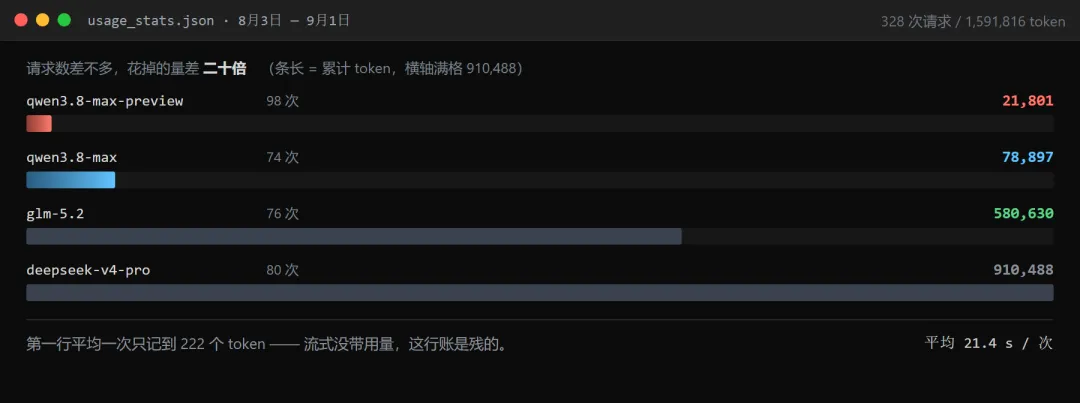
四个模型的请求数与累计 token:请求数差不多,花出去的量差二十倍
上下文是唯一真正的旋钮
账本里还有一件事,成本跟对话长度强相关,而对话长度是你自己一天天攒出来的。
所以消息拼装的顺序我固定死了:系统提示词、长期记忆这些几乎不变的内容放最前面,历史对话和用户这次的输入放最后。这样做是为了让前面那一段每次完全一致,服务端的前缀缓存能直接复用,不用重算。
有没有真的命中,我看不见 —— 命中率在服务商的账单后台,客户端拿不到这个数。我能做的只有让前缀保持稳定,剩下的不归我管。
会话历史我是落盘的,现在那个文件已经 1.1 MB。配置里有个 max_context_messages = 50 的上限就是为它设的。不设的话,聊到第三天的对话会把前两天的全部内容一起发出去,token 涨得比你想的快得多,而且大部分是白花的。
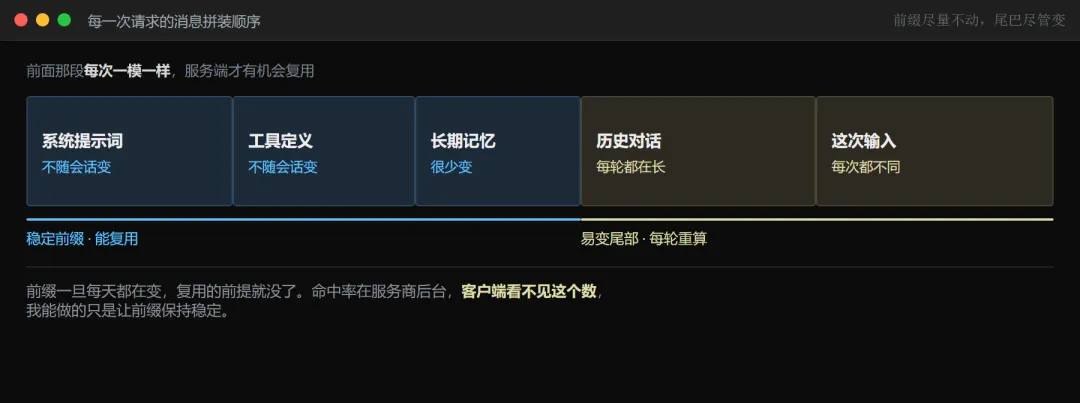
消息拼装的顺序:能复用的部分放最前面,每次都在变的部分压到最后
后来
这东西现在还在跑,最后一次启动是九月三号。中间我改过几轮工具、加过本地文档检索,也换过模型 —— 换模型是最省事的,改一行 base_url 和模型名就完了。
真正花时间的从来不是接模型。我原本以为难点在"怎么把大模型接进来",实际一个下午就通了;后面两个月全耗在接完之后:依赖检查、上下文裁剪、用量统计、窗口起不来的兜底、工具报错的提示。
模型只是最上面那一层,底下垫着的那些东西,才是它能不能天天开着用的原因。
配置清单在文末
这个号只写内网运维的实操记录,都是能直接抄的东西觉得有用,点上方蓝字关注一下