ARTICLE · 1040272
Linux 6.12 源码深度剖析: try_to_wake_up
📌 技术点速览
try_to_wake_up 函数是 Linux 调度器模块的核心组成部分,它负责将一个处于睡眠状态(如 TASK_INTERRUPTIBLE 或 TASK_UNINTERRUPTIBLE)的任务唤醒,使其重新变为可运行状态(TASK_RUNNING),并将其放置到合适的 CPU 运行队列上。这个函数是连接内核同步机制(如等待队列、互斥锁)与调度器之间的关键桥梁,确保事件发生后,等待的任务能够及时被调度执行。
🗺️ 软件功能架构图
try_to_wake_up 函数在调度器模块内部扮演着核心角色,并与多个其他内核模块紧密协作,以实现任务的唤醒和调度。
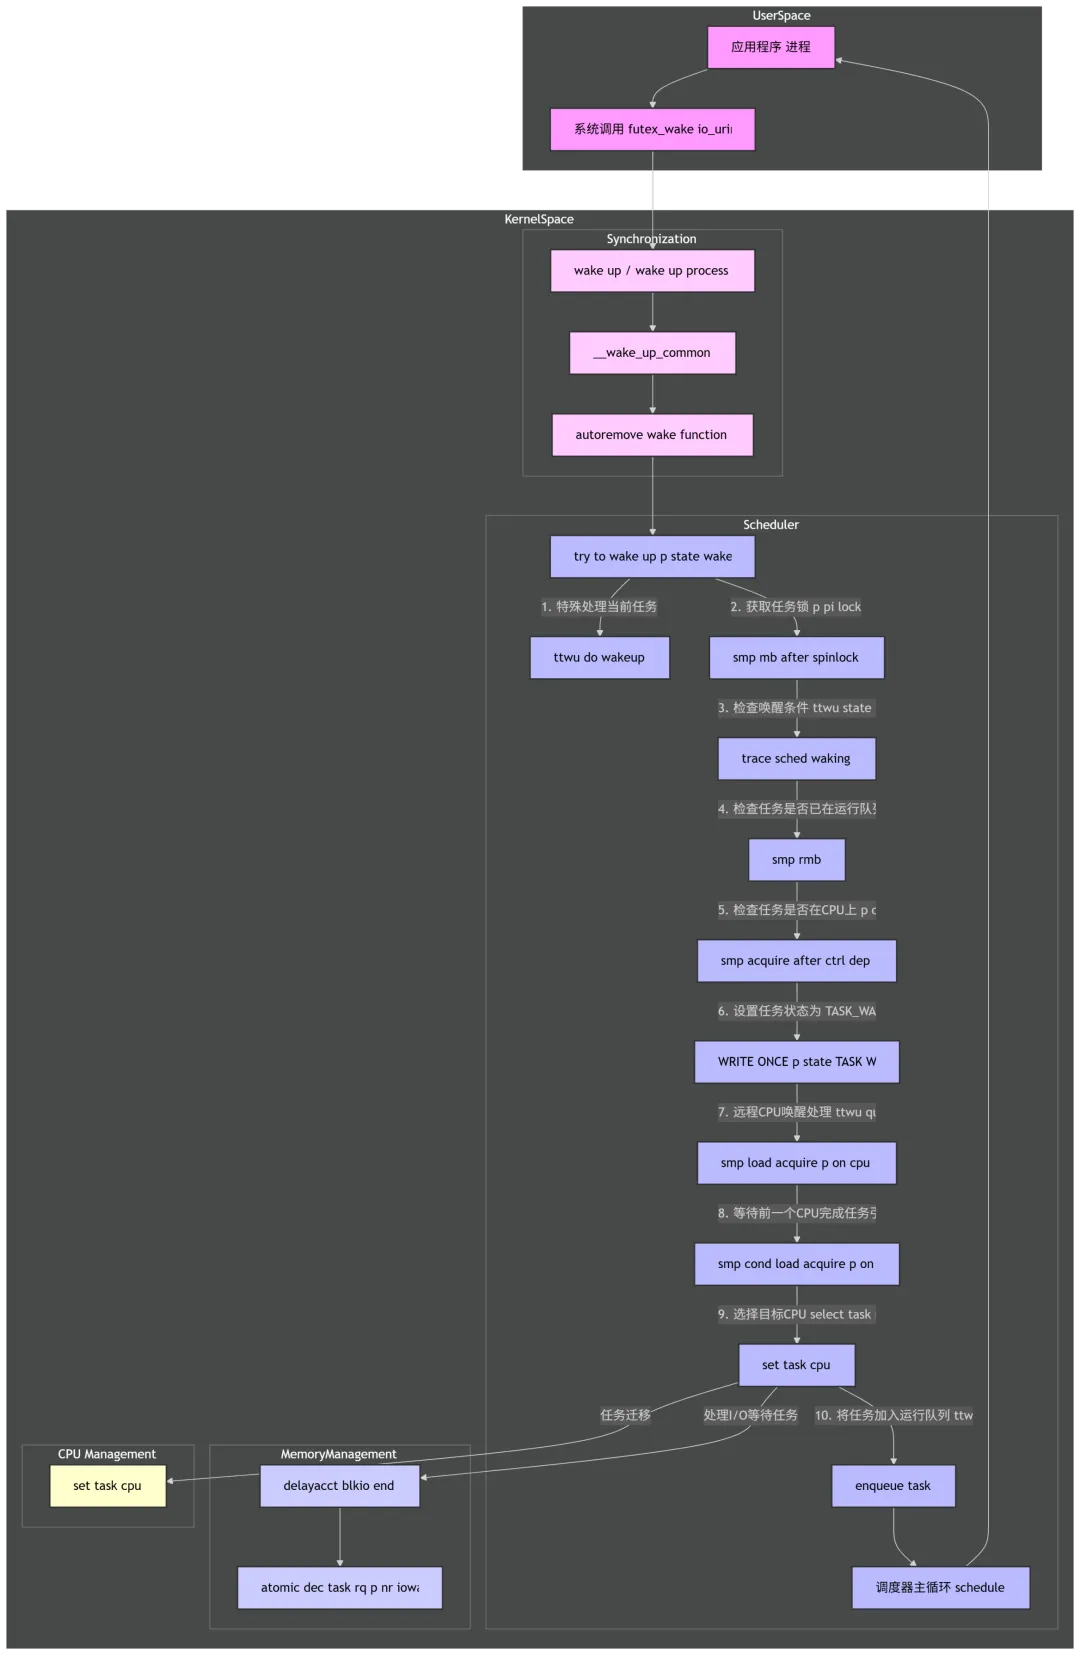
图例说明:
UserSpace: 应用程序通过系统调用请求内核服务。
Synchronization (同步机制模块): 负责管理等待队列和唤醒事件。
wake_up系列函数是其主要接口,它们最终会调用try_to_wake_up。Scheduler (调度器模块):
try_to_wake_up的核心逻辑所在,负责任务状态转换、CPU选择、运行队列管理。MemoryManagement (内存管理系统): 当任务处于 I/O 等待状态时,唤醒过程可能涉及更新 I/O 统计信息。
CPU Management (CPU管理模块): 任务迁移到不同 CPU 时,会更新任务的 CPU 归属。
🔍 核心源码硬核解析 (基于 Linux 6.12)
try_to_wake_up 函数是唤醒一个任务的入口点,其复杂性主要体现在对并发、内存顺序和 SMP 架构的精细处理上。源码文件路径: kernel/sched/core.c。
int try_to_wake_up(struct task_struct *p, unsigned int state, int wake_flags){guard(preempt)(); // [1] 禁用抢占,确保当前CPU上的操作原子性,防止在关键操作期间被中断。int cpu, success = 0;wake_flags |= WF_TTWU; // [2] 设置WF_TTWU标志,表示这是一个由try_to_wake_up发起的唤醒。if (p == current) { // [3] 特殊情况:如果尝试唤醒的任务就是当前正在运行的任务。SCHED_WARN_ON(p->se.sched_delayed); // [4] 调试检查:当前任务不应处于延迟调度状态。if (!ttwu_state_match(p, state, &success)) // [5] 检查任务状态是否与期望的唤醒状态匹配。goto out; // 如果不匹配,则无法唤醒,直接跳到out。trace_sched_waking(p); // [6] 记录调度器唤醒事件,用于ftrace等追踪工具。ttwu_do_wakeup(p); // [7] 执行实际的唤醒操作,将任务标记为可运行。goto out; // 唤醒成功,跳到out。}scoped_guard (raw_spinlock_irqsave, &p->pi_lock) { // [8] 获取任务的per-task自旋锁p->pi_lock,并禁用中断。// 这是保护任务状态、CPU归属等关键字段的锁。smp_mb__after_spinlock(); // [9] 内存屏障:确保在获取锁之后,所有对共享数据的读写操作都发生在屏障之后。// 这与set_current_state()中的smp_store_mb()配对,保证唤醒条件和任务状态的可见性。if (!ttwu_state_match(p, state, &success)) // [10] 再次检查任务状态是否可唤醒。break; // 如果不可唤醒,释放锁并退出。trace_sched_waking(p); // [11] 记录调度器唤醒事件。smp_rmb(); // [12] 读内存屏障:确保在此屏障之前的读操作(如p->state)在屏障之后的读操作(如p->on_rq)之前完成。// 这对于正确判断任务是否已在运行队列上至关重要,防止因乱序导致错误判断。if (READ_ONCE(p->on_rq) && ttwu_runnable(p, wake_flags)) // [13] 检查任务是否已经在运行队列上且可运行。break; // 如果是,则无需再次唤醒,释放锁并退出。#ifdef CONFIG_SMP // [14] SMP(对称多处理器)配置下的特定逻辑。smp_acquire__after_ctrl_dep(); // [15] 控制依赖获取屏障:确保在p->on_rq == 0的条件判断之后,// 对p->on_cpu的加载操作能看到最新的值。这与__schedule()中的操作配对。WRITE_ONCE(p->__state, TASK_WAKING); // [16] 将任务状态设置为TASK_WAKING。这是一个中间状态,// 表示任务正在被唤醒,但尚未完全加入运行队列。// 允许在释放p->pi_lock后进行后续操作。if (smp_load_acquire(&p->on_cpu) && // [17] 原子加载p->on_cpu,并带有获取语义的内存屏障。ttwu_queue_wakelist(p, task_cpu(p), wake_flags)) // [18] 尝试将任务加入远程CPU的唤醒列表。break; // 如果成功,则释放锁并退出。这通常涉及发送IPI。smp_cond_load_acquire(&p->on_cpu, !VAL); // [19] 条件加载p->on_cpu,直到其变为0(即任务不再在任何CPU上运行)。// 这是一个自旋等待,确保前一个CPU已经完全处理完该任务。// 这与finish_task()中的smp_store_release()配对。cpu = select_task_rq(p, p->wake_cpu, &wake_flags); // [20] 选择一个合适的CPU运行队列来放置任务。// 考虑负载均衡、任务亲和性等因素。if (task_cpu(p) != cpu) { // [21] 如果选择的CPU与任务当前所在的CPU不同,表示需要进行任务迁移。if (p->in_iowait) { // [22] 如果任务处于I/O等待状态,更新I/O统计信息。delayacct_blkio_end(p); // 结束I/O等待的延迟统计。atomic_dec(&task_rq(p)->nr_iowait); // 减少运行队列的I/O等待任务计数。}wake_flags |= WF_MIGRATED; // [23] 设置迁移标志。psi_ttwu_dequeue(p); // [24] 更新PSI(Pressure Stall Information)统计。set_task_cpu(p, cpu); // [25] 更新任务的CPU归属。}#else// [26] 非SMP配置下,任务始终在当前CPU上。cpu = task_cpu(p);#endif/* CONFIG_SMP */ttwu_queue(p, cpu, wake_flags); // [27] 将任务实际加入到目标CPU的运行队列中。} // [28] 释放p->pi_lock并重新启用中断。out:if (success)ttwu_stat(p, task_cpu(p), wake_flags); // [29] 更新唤醒统计信息。return success; // [30] 返回唤醒是否成功。}
核心职责体现:
try_to_wake_up 函数完美体现了调度器模块的核心职责:
任务状态管理: 它负责将任务从睡眠状态 (
TASK_INTERRUPTIBLE,TASK_UNINTERRUPTIBLE) 转换为可运行状态 (TASK_RUNNING,通过TASK_WAKING中间态)。并发控制与同步: 通过
p->pi_lock保护任务的关键状态,并利用大量的内存屏障 (smp_mb__after_spinlock,smp_rmb,smp_acquire__after_ctrl_dep,smp_load_acquire,smp_cond_load_acquire) 确保在多处理器环境下,不同 CPU 之间对任务状态的读写操作具有正确的可见性和顺序性,避免数据竞争和不一致。这对于 arm64 和 x86 这样的弱内存序架构尤为关键。CPU 资源分配:
select_task_rq函数是负载均衡和任务亲和性策略的体现,它决定了任务应该在哪个 CPU 上运行,以优化系统吞吐量和响应时间。任务迁移: 当
select_task_rq决定将任务迁移到另一个 CPU 时,try_to_wake_up会负责更新任务的 CPU 归属并设置迁移标志。性能追踪与统计:
trace_sched_waking和ttwu_stat提供了对调度器行为的可见性,对于性能分析和调试至关重要。
⚙️ 系统运行背景与上下文
try_to_wake_up 函数是 Linux 内核中一个高度并发和性能敏感的代码路径。它不单独工作,而是作为整个内核协同机制中的关键一环。
与同步机制模块的协同:
当用户空间进程或内核线程需要等待某个事件时(例如,等待 I/O 完成、等待互斥锁释放、等待条件变量满足),它们会调用
schedule()进入睡眠状态(TASK_INTERRUPTIBLE或TASK_UNINTERRUPTIBLE),并把自己加入到某个等待队列 (wait_queue_head_t) 中。当事件发生时(例如,I/O 完成中断、另一个线程释放了锁),内核中的事件处理代码(可能在中断上下文、软中断上下文或另一个进程上下文)会调用
wake_up()或wake_up_process()。这些
wake_up系列函数会遍历等待队列,并对队列中的每个任务调用try_to_wake_up,将其从睡眠状态唤醒。与中断/系统调用模块的协同:
中断上下文: 硬件中断(如网卡接收到数据、磁盘 I/O 完成)通常会触发中断处理程序。这些处理程序在完成硬件操作后,会调用
wake_up来唤醒等待数据的进程。系统调用上下文: 许多系统调用(如
read()、write()、futex())在无法立即完成操作时,会将当前进程置于睡眠状态。当条件满足时,另一个进程或中断处理程序会通过wake_up唤醒它。例如,futex_wake()系统调用就是直接调用try_to_wake_up来唤醒等待futex的进程。与内存管理模块的协同:
当一个任务因为等待 I/O(例如,页面换入、文件读写)而进入
TASK_UNINTERRUPTIBLE状态时,p->in_iowait标志会被设置。try_to_wake_up在唤醒这样的任务时,会调用delayacct_blkio_end(p)和atomic_dec(&task_rq(p)->nr_iowait)来更新 I/O 延迟统计和运行队列的 I/O 等待计数。这有助于内核追踪和优化 I/O 相关的性能瓶颈。与 CPU 管理/负载均衡模块的协同:
select_task_rq是try_to_wake_up中一个非常重要的子模块,它负责根据当前的系统负载、任务的亲和性(cpuset)、调度策略(CFS、RT、Deadline)以及缓存拓扑结构,智能地选择一个最适合任务运行的 CPU。如果选择的 CPU 与任务当前所在的 CPU 不同,
try_to_wake_up会执行任务迁移 (set_task_cpu),这涉及到更新任务的cpu字段,并可能触发跨 CPU 的缓存同步操作。在 SMP 系统中,
ttwu_queue_wakelist机制允许将任务添加到远程 CPU 的唤醒列表,并通过 IPI (Inter-Processor Interrupt) 通知目标 CPU 处理,而不是直接在当前 CPU 上操作远程运行队列,从而减少锁竞争和提高并行度。
总而言之,try_to_wake_up 是一个高度协调的函数,它在调度器模块内部处理任务状态转换和 CPU 分配,同时通过明确定义的接口与同步、中断、内存管理和 CPU 管理模块进行交互,共同维护系统的响应性和效率。其内部大量的内存屏障和锁机制,正是为了在多核环境下保证这些复杂交互的正确性和数据一致性。
💡 10年老兵避坑指南/实战案例
在生产环境中,对 try_to_wake_up 及其相关机制的理解不足,常常会导致一些隐蔽但影响巨大的性能问题,尤其是在高并发、多核的系统上。
实战案例:高并发服务中的“惊群效应”与 CPU 暴涨
背景: 假设你有一个基于 Linux 的高并发网络服务,使用 epoll 监听大量连接。当数据到达时,epoll 会唤醒等待的 worker 线程来处理数据。为了提高吞吐量,你可能配置了大量的 worker 线程,并且这些线程在没有数据时会通过 epoll_wait 进入睡眠状态。
问题现象: 在流量高峰期,系统 CPU 使用率异常高,但 perf 或 top 观察到的 CPU 消耗并不完全集中在应用程序的业务逻辑上。相反,你可能会看到 ksoftirqd/x、migration/x 线程或内核态 CPU 占用率显著增加,同时伴随着应用程序响应延迟的升高。
根本原因分析: 这很可能是“惊群效应”(Thundering Herd)在 try_to_wake_up 层面导致的。
epoll_wait唤醒: 当有新的网络事件(如数据到达)时,内核网络栈会触发wake_up调用,最终会进入try_to_wake_up。大量线程被唤醒: 如果有多个 worker 线程都在等待同一个
epoll实例上的事件,wake_up可能会唤醒所有等待的线程(取决于epoll的具体实现和wake_up的参数,但通常会唤醒多个甚至所有)。try_to_wake_up的开销:锁竞争: 大量线程同时被唤醒,意味着多个 CPU 上的
try_to_wake_up调用会同时尝试获取不同任务的p->pi_lock。虽然p->pi_lock是 per-task 的,但如果这些任务恰好在同一个 CPU 上被唤醒,或者在ttwu_queue阶段需要获取同一个rq->lock,就会导致严重的锁竞争。CPU 选择与迁移:
select_task_rq会为每个被唤醒的线程寻找最佳 CPU。在高并发下,这可能导致频繁的负载均衡决策和任务迁移 (WF_MIGRATED)。每次迁移都意味着缓存失效、TLB 刷新等开销,增加了migration/x线程的负担。运行队列操作:
ttwu_queue将任务加入运行队列,这涉及到对运行队列数据结构的修改,在高并发下同样会增加锁竞争和缓存开销。内存屏障:
try_to_wake_up中大量的内存屏障(如smp_mb__after_spinlock,smp_rmb等)虽然是保证 SMP 正确性的必要条件,但在高频执行时也会带来额外的 CPU 周期消耗,尤其是在 arm64 这样的弱内存序架构上,屏障的开销可能比 x86 更显著。无效唤醒与上下文切换: 即使所有线程都被唤醒,通常也只有一个或少数几个线程能真正处理事件(例如,只有一个线程能成功
epoll_wait返回并获取到数据)。其他被唤醒的线程会立即发现没有事件可处理,然后再次进入睡眠。这种“无效唤醒”导致了大量的上下文切换,浪费了宝贵的 CPU 资源。
排查与调优方法:
使用
perf sched分析调度行为:perf sched record -a sleep 10记录一段时间的调度事件。perf sched latency查看任务的唤醒延迟和调度延迟。perf sched script详细分析sched_wakeup、sched_switch、sched_migrate_task等事件,观察是否有大量任务在短时间内被唤醒、频繁上下文切换或迁移。关注
try_to_wake_up的调用栈,确认是哪个内核模块触发了大量唤醒。使用
ftrace追踪:启用
sched_wakeup、sched_switch、sched_migrate_task等事件:
echo 1 > /sys/kernel/debug/tracing/events/sched/sched_wakeup/enableecho 1 > /sys/kernel/debug/tracing/events/sched/sched_switch/enableecho 1 > /sys/kernel/debug/tracing/events/sched/sched_migrate_task/enableecho 1 > /sys/kernel/debug/tracing/tracing_onsleep 5 # 运行一段时间echo 0 > /sys/kernel/debug/tracing/tracing_oncat /sys/kernel/debug/tracing/trace > trace.log
分析
trace.log,查找短时间内大量sched_wakeup事件,以及紧随其后的sched_switch和sched_migrate_task。应用程序层面的优化:
减少惊群: 对于
epoll,Linux 3.9+ 引入了EPOLLEXCLUSIVE标志,可以有效缓解惊群效应,确保每次只有一个线程被唤醒。这是最直接有效的解决方案。线程池大小: 仔细评估 worker 线程池的大小,避免创建过多线程导致过度竞争。
负载均衡策略: 如果应用程序有自己的负载均衡逻辑,确保它能有效分发请求,避免单个
epoll实例成为瓶颈。内核参数调优 (谨慎):
sysctl kernel.sched_migration_cost_ns: 调整任务迁移的成本阈值。如果设置为一个较大的值,调度器会更倾向于让任务在当前 CPU 上运行,即使它不是最优选择,从而减少迁移。但这可能导致负载不均。sysctl kernel.sched_wakeup_granularity_ns: 影响调度器在唤醒任务时,是否倾向于让任务在唤醒它的 CPU 上运行,或者立即进行负载均衡。调整此参数可能影响唤醒延迟和负载均衡的积极性。cpuset或taskset: 对于关键服务,可以考虑使用cgroups cpuset或taskset将其绑定到特定的 CPU 核心,减少任务迁移,提高缓存命中率。但这需要仔细规划,可能牺牲灵活性。
总结:try_to_wake_up 是一个高度优化的函数,但其性能表现与系统负载、并发模式以及应用程序的同步策略息息相关。在高并发场景下,理解其内部的锁、内存屏障和 CPU 选择机制,并结合 perf、ftrace 等工具进行深入分析,是解决性能瓶颈的关键。很多时候,问题并非出在 try_to_wake_up 本身,而是其上层调用者(如同步原语、I/O 子系统)触发了不必要的或过度的唤醒,导致 try_to_wake_up 的开销被放大。解决之道往往在于从应用程序层面优化同步和并发模式,或利用内核提供的更精细的唤醒机制(如 EPOLLEXCLUSIVE)。