ARTICLE · 1040281
OpenAI把Codex Harness开放出来后,我反而更关心一个问题:Agent连续跑几天,到底该怎么测?
关注 霍格沃兹软件测试开发 公众号,回复「资料」, 领取人工智能测试开发技术合集
前几天看到OpenAI新发布的Agents API,我第一反应不是:
“又多了一个Agent API。”
而是它官方介绍里的一句话:
让Agent可靠地持续运行数天。
这件事对测试工程师的意义,可能比“又提升了多少Benchmark”大得多。
因为一个Agent只运行30秒的时候,你可以把它当成一个特殊API:
输入任务。
等待。
拿结果。
断言。
但如果一个Agent要运行30分钟、3小时,甚至跨越多个Context Window持续几天,测试对象就彻底变了。
你要测的已经不只是:
它最后有没有完成任务。
而是:
它跑到第8个小时的时候,还记得自己为什么开始这个任务吗?
一、OpenAI这次真正开放的,不只是一个API
9月10日,OpenAI发布Agents API public beta。
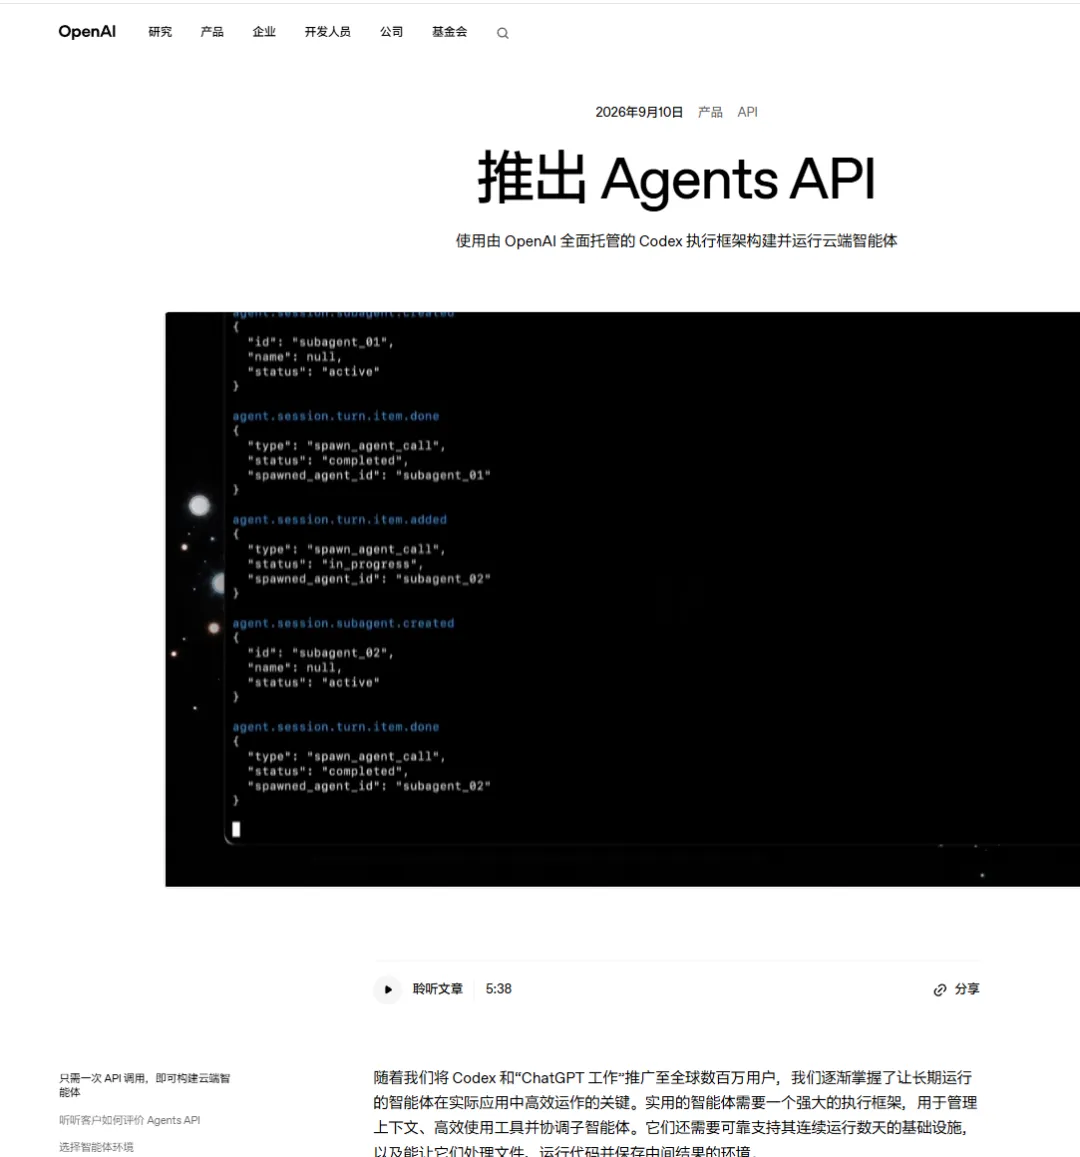
官方的描述非常直接:
它把支撑Codex运行的Harness和基础设施,通过API开放给开发者。Agents API负责管理Context、Tool以及Subagent,并提供可以让Agent处理文件、运行代码、保存中间结果的执行环境。OpenAI还特别强调了长时间运行:Agent需要能够可靠地持续运行数小时甚至数天。([OpenAI][1])
这意味着未来越来越多Agent不会是:
用户问一句 → 模型答一句。
而可能是:
收到任务 ↓ 拆解任务 ↓ 启动多个Subagent ↓ 查询代码仓库 ↓ 调用MCP ↓ 运行代码 ↓ 等待外部任务 ↓ 保存中间结果 ↓ 恢复执行 ↓ 再次调用工具 ↓ 最后汇总结果
比如官方示例就是一个非常典型的生产场景:
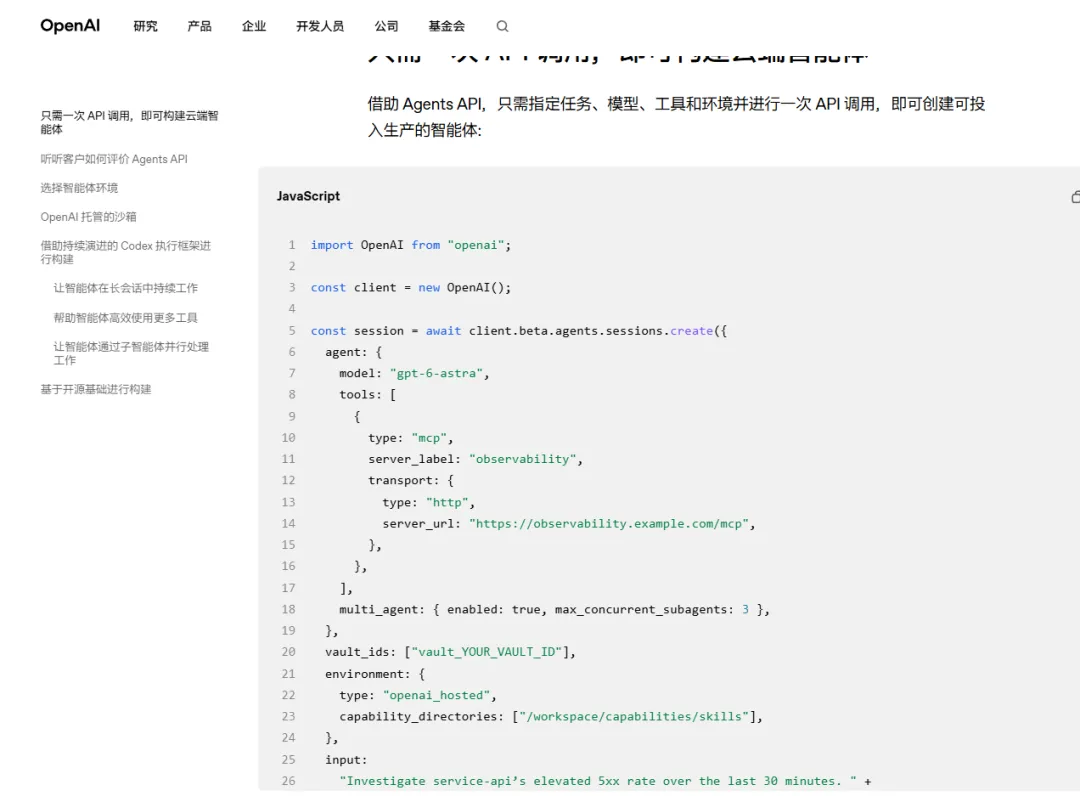
调查某个服务最近30分钟5xx异常,让不同Subagent分别分析部署、错误和依赖情况,最后把证据和建议保存到工作目录。([OpenAI][1])
如果我是测试工程师,我看到这里第一个想到的问题是:
这个Agent跑一小时以后挂了怎么办?
二、Long-running Agent最麻烦的Bug,很多根本不会出现在最终答案里
假设我们做一个“线上故障分析Agent”。
它接到任务:
“分析payment-service最近2小时支付失败率升高的原因。”
Agent开始工作。
它可能经历:
T+0分钟:查询监控指标
T+5分钟:读取最近Deployment
T+12分钟:启动3个Subagent
T+20分钟:分析日志
T+35分钟:发现Redis Timeout异常
T+50分钟:Context接近限制,触发压缩
T+70分钟:继续分析
T+90分钟:生成报告
最后报告可能写得非常漂亮:
“初步判断Redis连接池耗尽导致支付请求失败。”
如果我们只测Final Answer:
PASS。
但中间可能已经发生了三个严重问题。
第一个:
Context Compaction之后,Agent忘了“不能直接修改生产环境”。
第二个:
某个Subagent已经查询过Deployment,主Agent恢复后又查了一遍。
第三个更危险:
Agent第一次执行restart失败,恢复Session以后又执行一次。
对于“查日志”来说,重复调用最多浪费钱。
但如果Tool是:
refund_payment
create_order
send_email
restart_service
delete_resource
情况就完全不同了。
这时候你面对的是经典分布式系统问题:
At-least-once execution + 非幂等Side Effect。
这已经不是“Prompt写得好不好”的问题了。
三、所以长时Agent至少要增加一种测试:Recovery Testing
传统接口测试里我们很喜欢:
Request → Response → Assertion。
长时Agent需要多一个维度:
Failure → Recovery → Continue → Assertion。
比如订单运营Agent正在处理1000个异常订单。
执行到第427个的时候进程被杀掉。
恢复之后,正确行为应该是:
从Checkpoint继续处理第428个。
而不是:
重新从第1个开始。
测试代码可以很简单,但测试目标必须变。
deftest_agent_resume_without_duplicate_side_effect(agent): task_id = agent.start( task="process_abnormal_orders", orders=list(range(1, 1001)) ) agent.wait_until_processed(task_id, 427)# 模拟运行环境异常退出 agent.kill_runtime(task_id)# 从持久化状态恢复 agent.resume(task_id) result = agent.wait_until_complete(task_id)assert result.processed_count == 1000# 最关键的断言不是“最终成功”# 而是任何订单都不能被重复执行assert result.duplicate_operations == []assert result.resume_from_checkpoint == 428这里真正重要的不是Python语法。
而是测试思想发生了变化:
以前验证:
有没有处理1000个订单。
现在还要验证:
是不是恰好处理一次。
这就是Long-running Agent Testing和普通LLM测试之间很重要的一条分界线。
人工智能技术学习交流群
伙伴们,对AI测试、大模型评测、质量保障感兴趣吗?我们建了一个 「人工智能测试开发交流群」,专门用来探讨相关技术、分享资料、互通有无。无论你是正在实践还是好奇探索,都欢迎扫码加入,一起抱团成长!期待与你交流!👇
四、Context Compaction其实也应该进入测试范围
OpenAI这次Agents API还有一个很值得测试人员关注的机制:
Context Compaction。
官方说明,当Session接近Context限制时,系统会自动压缩之前的上下文,让Agent可以跨越多个Context Window继续工作。([OpenAI][1])
从工程角度看,这很好。
从测试角度看,这又多了一个Failure Boundary。
因为:
100页上下文
压缩成
10页关键状态
本质上发生了一次:
有损信息转换。
问题来了。
什么信息可以丢?
什么信息绝对不能丢?
假设原始Context里有一句:
“任何超过5000元的退款必须人工确认。”
如果Compaction之后保留了:
“当前需要处理退款任务。”
却丢掉:
“超过5000元需要人工确认。”
Agent仍然可能成功完成任务。
但业务已经错了。
所以Context Compaction测试不能只测:
压缩后Agent还能不能继续工作。
还应该有:
Critical Constraint Retention。
例如:
CRITICAL_CONSTRAINTS = ["refund_over_5000_requires_human","never_restart_production_without_approval","payment_operation_requires_idempotency_key"]defassert_context_survives_compaction(trace): before = trace.context_before_compaction after = trace.context_after_compactionfor rule in CRITICAL_CONSTRAINTS:assert rule in beforeassert rule in after实际工程中当然不会简单地做字符串查找。
但测试思想就是:
Compaction前后的业务约束是否等价。
这和我们以前测试数据库迁移,其实非常像。
五、Subagent又带来了另一个测试问题:部分失败
Agents API支持把复杂任务拆给多个Subagent并行处理,每个Subagent维护自己的Context,主Agent负责协调和汇总。([OpenAI][1])
于是又会出现一种非常典型的场景:
主Agent:
分析线上事故。
Subagent A:
分析Deployment。
成功。
Subagent B:
分析Error Log。
成功。
Subagent C:
分析Dependency。
超时。
这时候主Agent应该怎么办?
至少存在四种策略:
Retry
Fallback
Partial Result
Fail Fast
最糟糕的情况不是任务失败。
而是:
C失败了,主Agent却不知道C失败了,最后仍然生成一个看起来非常完整的Root Cause。
这类问题只看最终自然语言答案非常难发现。
测试里应该明确检查:
deftest_partial_subagent_failure(agent): result = agent.run( task="analyze_incident", inject_failure={"dependency_agent": "timeout" } )assert result.subagents["deployment"].status == "success"assert result.subagents["logs"].status == "success"assert result.subagents["dependency"].status == "failed"# 不允许把缺失证据包装成确定结论assert result.confidence < 0.8assert"dependency analysis unavailable"in result.limitations这里测试的其实是:
Evidence Completeness。
Agent不是只要会回答。
还必须知道:
自己到底缺了什么证据。
六、Long-running Agent最值得测试的,其实是这8类Failure
如果让我给这种系统设计测试集,我会优先覆盖:
① Context Drift 运行时间越来越长以后,目标是否逐渐偏离。
② Context Compaction 压缩以后关键业务约束有没有丢。
③ Checkpoint / Resume 异常退出后能否从正确状态恢复。
④ Duplicate Side Effect 恢复、Retry以后是否重复退款、重复发邮件、重复创建资源。
⑤ Tool Failure MCP/API临时失败以后Retry策略是否正确。
⑥ Subagent Partial Failure 部分Agent失败后主Agent是否仍然错误地产生确定结论。
⑦ Retry Storm 下游持续失败时是否出现无限重试。
⑧ Budget Exhaustion Token、Tool Call、Latency、Cost超过预算以后是否能够安全停止。
你会发现:
这里面至少一半问题,传统测试开发工程师其实并不陌生。
幂等。
重试。
状态机。
故障注入。
超时。
恢复。
一致性。
可观测性。
只不过以前测试对象是:
微服务。
现在开始变成:
Agent Runtime。
七、真正的Agent测试平台,未来可能越来越像“分布式系统测试平台”
我越来越觉得,AI测试开发有一个很容易被忽略的方向。
大家现在特别喜欢研究:
Prompt Evaluation。
RAG Evaluation。
LLM Judge。
这些当然重要。
但随着Agent运行时间从:
10秒 → 10分钟 → 10小时 → 数天
另外一套传统软件工程能力会重新变得非常值钱:
Fault Injection
State Recovery
Idempotency
Checkpoint
Distributed Trace
Timeout
Retry
Resource Budget
Chaos Testing
因为Agent越来越不像一个Chatbot。
它更像一个:
会自己调用外部系统的长生命周期分布式程序。
测试思路自然也要跟着变。
八、如果你想做一个AI测试开发项目,我反而建议做这个
项目可以叫:
Long-Running Agent Reliability Lab
不要再做一个简单的“LLM问答评分Demo”。
直接模拟:
一个订单异常处理Agent。
设计:
主Agent
3个Subagent
4个Tools
Checkpoint Store
Trace Collector
Failure Injector
然后人为制造:
Tool Timeout
Context Compaction
Subagent Crash
Runtime Restart
Duplicate Tool Call
Budget Exhaustion
最终输出:
Task Completion
State Consistency
Duplicate Side Effects
Recovery Success Rate
Critical Constraint Retention
Tool Retry Count
Latency
Cost
这会比简历上单纯写:
“使用大模型实现智能测试用例生成。”
有内容得多。
因为你真正开始回答一个工程问题:
Agent如果要跑一天,我怎么证明它跑到第23个小时仍然可信?
OpenAI这次Agents API真正让我感兴趣的,不是又多了一个调用大模型的方法。
而是Agent开始越来越明显地进入:
Long-running Software System。
一旦进入这个阶段,测试工程师熟悉的很多东西都会回来。
状态。
恢复。
幂等。
故障。
Trace。
性能。
成本。
只是这一次,它们被放进了Agent Harness里。
对测试开发来说,这反而可能是个很好的机会。
因为未来AI测试真正难的,可能不是判断一句话答得像不像人。
而是:
一个运行了两天、调用过300次工具、经历过Context压缩和3次故障恢复的Agent,你凭什么敢让它继续操作生产系统?
这才是值得我们开始研究的问题。
推荐学习
智能化测试-测试用例生成公益训练营,从行业大模型特性讲起,带你搞懂AI测试的全链路:大模型能力评测、智能体Harness工程、Skill技能体系、CLI与MCP工具体系、RAG知识图谱——最后直接上手打造一个能自动生成测试用例的智能体。
关于我们
霍格沃兹测试开发学社,隶属于 测吧(北京)科技有限公司,是一个面向软件测试爱好者的技术交流社区。
学社围绕现代软件测试工程体系展开,内容涵盖软件测试入门、自动化测试、性能测试、接口测试、测试开发、全栈测试,以及人工智能测试与 AI 在测试工程中的应用实践。
我们关注测试工程能力的系统化建设,包括 Python 自动化测试、Java 自动化测试、Web 与 App 自动化、持续集成与质量体系建设,同时探索 AI 驱动的测试设计、用例生成、自动化执行与质量分析方法,沉淀可复用、可落地的测试开发工程经验。
在技术社区与工程实践之外,学社还参与测试工程人才培养体系建设,面向高校提供测试实训平台与实践支持,组织开展 “火焰杯” 软件测试相关技术赛事,并探索以能力为导向的人才培养模式,包括高校学员先学习、就业后付款的实践路径。
同时,学社结合真实行业需求,为在职测试工程师与高潜学员提供名企大厂 1v1 私教服务,用于个性化能力提升与工程实践指导。