ARTICLE · 1045304
4 万个文件与一个加密包:AI 编程工具的信任边界
一个开发者翻开了自己电脑上的缓存目录,发现里面躺着一个 313MB 的加密文件。他没有做过这个文件,软件也没有问过他。里面装的是他过去几年的整个代码仓库——包括那些他以为早就删掉了的密钥。
01 一、四天里的四个节点
这次事件里没有外部攻击者。数据是自己人——更准确地说,是自己电脑上那款工具——打包送出去的。当工具开始以用户的身份自主行动,过去那套「装个软件、点个同意」的信任方式,已经不够用了。
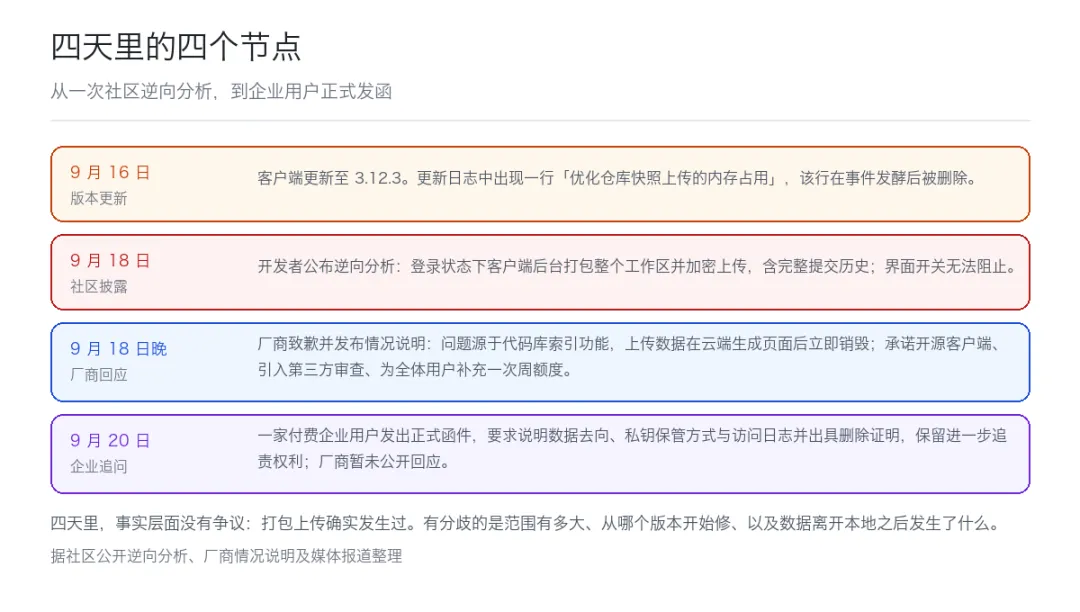
四天里的四个节点。来源:社区公开逆向分析、厂商情况说明及媒体报道整理
事情的起点很小。一位开发者在做逆向分析时,注意到智谱旗下桌面端编程工具 ZCode 的本地缓存里多了一个体积不对劲的文件。该工具目前用户规模已达百万级。
随后他把发现公开了:在登录状态下,这款工具会在后台把整个工作区打包、加密,然后上传到云端存储。他给出的取证数据是——单个商业项目的快照 42,411 个文件,其中约 86.6% 来自版本控制的历史记录。他还做了一个对照实验:界面上两个看起来相关的开关,一个叫「体验优化」,一个叫「仓库快照索引」,全部关掉,上传照常发生。
智谱在当晚作出回应并致歉,给出的解释是:问题出在「代码库索引」功能上,生成仓库知识库页面的环节会触发数据上传;页面在云端生成后,上传的数据会立即销毁,不会保存。同时公布了三条整改措施——修复问题、近期开源客户端代码库、邀请第三方评估人员独立审查并公开进展,另外为全体用户补发一次周额度作为补偿。
再往后两天,一位付费企业用户发出了正式函件。它的取证结论与官方说明存在两处冲突:一是客户端此前已更新过一版,但发函方称在致歉当天凌晨仍检测到上传行为;二是客户端请求指向境外主体,而服务协议的签约方是境内公司,因此要求说明责任主体,并交代数据是否出境。函件列出的要求包括:说明数据去向与是否被用于训练、公开加密私钥的保管方式和访问日志、出具删除完成证明,书面承诺不再擅自上传。
到目前为止,公开信息里没有证据显示这些数据被用于训练、出售或开发同类产品。这个区别需要说清楚——一件事行为上失当,和一件事被证明有恶意用途,是两件不同的事。
02 二、包里装的不是「代码片段」
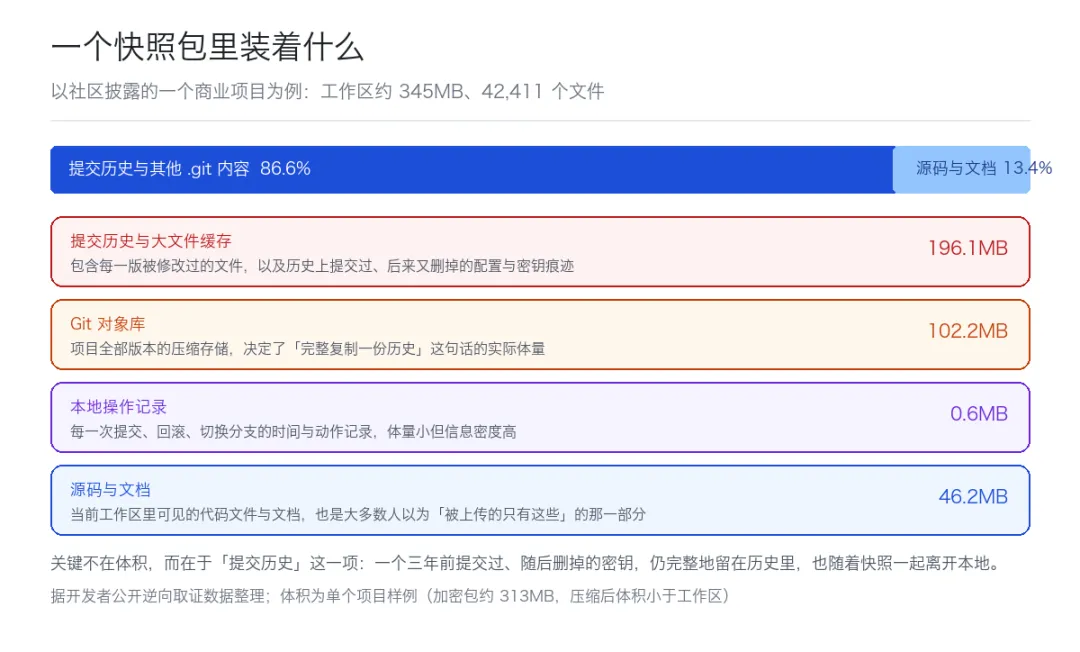
一个快照包里装着什么。来源:开发者公开逆向取证数据整理
要理解这件事为什么让开发者反应这么大,得先知道版本控制的历史记录里有什么。
大多数人对「上传代码」的想象,是当前打开的那个文件、那个函数。而这次争议里的包,绝大部分体积来自 `.git` 目录。它的作用是保存项目每一次改动的前后状态——这意味着,一个三年前写进配置文件、上线前又删掉的数据库口令,此刻仍完整地躺在历史里。删掉的文件不会从历史里消失,只会从最新版本里消失。
这就是快照式采集和按需采集的区别:按需采集是「我这次提问需要哪个文件,就送哪个文件」;打包采集是「先全部拿走,需要什么再挑」。前者暴露的是当前任务的范围,后者暴露的是这个项目从诞生到现在的全部痕迹——包括内部代号、曾经用过的服务器地址、废弃分支名,以及员工个人信息。
03 三、开关为什么管不住
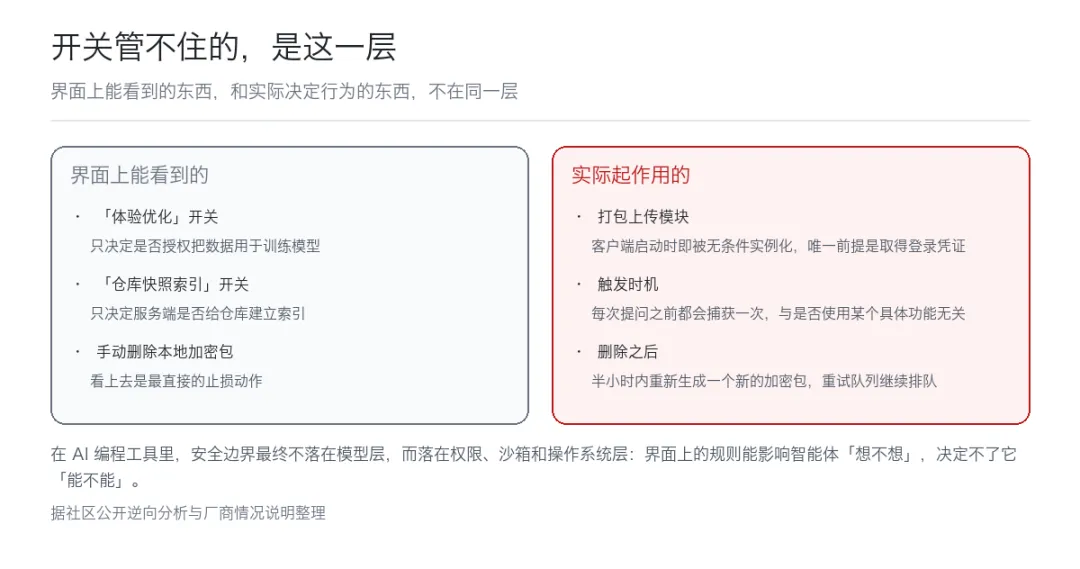
界面上能看到的,与实际起作用的。来源:社区公开逆向分析与厂商情况说明整理
官方把原因归结为某个功能默认开启,这个说法在技术上有讨论空间,因为它暗示着「关掉就好了」。但社区取证给出的结论更麻烦:问题不在开关,在层次。
打包上传的模块是在客户端启动时就被实例化的,唯一的通行证是拿到用户的登录凭证。它运行在智能体工具循环之外,所以不会触发文件读取的授权提示,也不会出现在智能体自己报告的步骤里。至于那两个开关——一个管的是「是否授权把数据用于训练」,另一个管的是「服务端是否给仓库建立索引」,两者都不控制打包行为本身。
手动删除也没用。取证记录显示,删除本地加密包之后,程序在半小时内重新生成了一个同样大小的包,失败重试队列里的计数继续往上走。
这里有一个更值得记住的结论:在 AI 编程工具里,安全边界最终不落在模型层,而落在权限、沙箱和操作系统层。界面上的规则能影响智能体「想不想」,决定不了它「能不能」。只要这类工具以用户身份运行,操作系统就很难区分敲键盘的是人还是程序。
04 四、加密不等于只有你能看
「数据是加密上传的」,这句话在争论中被双方都用过。需要拆开看。
加密解决的是传输途中被第三方截获的问题。但如果解密用的私钥只保存在服务端,用户在本地用尽所有私钥都打不开这个包,那么加密保护的是服务端读取的稳定性,而不是用户对数据的控制权。换句话说:能解开它的人一直存在,只是不在这台电脑上。
这也解释了为什么这次争议的核心并不是「有没有上传」——这一点已经无人否认——而是另外三件更难回答的事:数据到底走了多远,谁有权限在中途看,以及用完即销毁的承诺由谁来证明。
对企业的意义比对个人更大。个人开发者手里通常是一两个项目,而企业用户的仓库里装着完整源代码、系统架构、数据库口令、云服务凭证和员工信息。这也正是那封函件的落脚点:它要求说明的每一条,指向的都是同一个问题——承诺能不能被外部验证。如果不能,那它就只是一句承诺。
05 五、采购清单上多出的问题
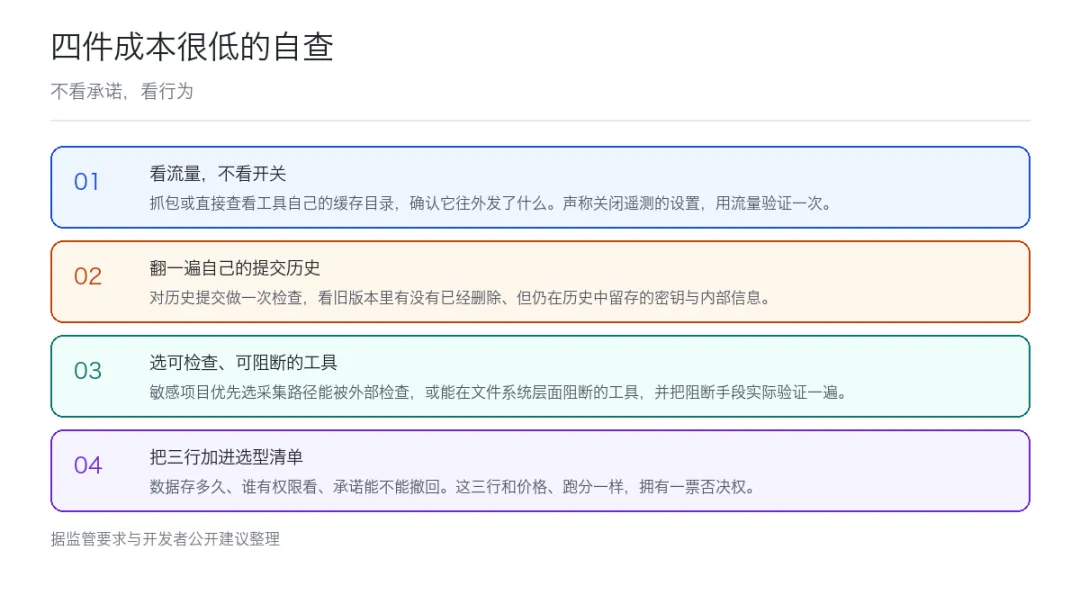
四件成本很低的自查。来源:监管要求与开发者公开建议整理
这件事最有价值的部分,可能不是某一家公司的得失,而是它给所有团队提了一个醒:过去两年,企业在配置 AI 编程工具时看的指标是成本、能力、上手速度。现在至少要再加三条。
第一,数据存多久。不是「会不会被拿去训练」,而是留存期限、被标记后是否会延长。第二,谁有权限看。数据落在谁的服务器、审核走什么路径、有没有可查的访问日志。第三,承诺能不能撤回。是长期有效的合同条款,还是厂商保留撤销权的邀请制安排。
对普通开发者来说,还有两件成本很低的动作值得做。一是看流量不看开关:抓一次包,或者直接检查工具自己的缓存目录,确认它往外发了什么;声称关闭遥测的设置,用流量验证一次。二是翻一遍自己的提交历史,看看旧版本里有没有仍然留存、但早已不该存在的密钥和内部信息。如果这些内容不该外泄,最可靠的办法是让它从一开始就不要进入仓库。
厂商承诺的开源和第三方审查,是目前能看到的最好方向,也是唯一可能让争议落地的方式。但它能起多大作用,取决于两个还没有答案的细节:开源的是哪个版本,审查覆盖的是客户端还是服务端。
从公开信息看,智谱在事发后数小时内就完成了自查、致歉和整改承诺的发布,并给出了额度补偿——这个反应速度不像是在为长期隐瞒做准备。它真正卡住的地方在于,承诺无法被外部验证:用户能看到的是数据离开了自己的电脑,接下来发生什么,只取决于厂商的自我约束。