ARTICLE · 1047753
腾讯微信团队开源文档解析模型WeVisDoc :公式不糊、表格不散,端到端里排第一
• 论文(HTML 全文):https://arxiv.org/html/2609.20423v1 • 论文(摘要页):https://arxiv.org/abs/2609.20423 • 项目主页与交互演示:https://tencent.github.io/WeVisDoc/ • 代码仓库:https://github.com/Tencent/WeVisDoc • 模型权重(4B):https://huggingface.co/Tencent/WeVisDoc-4B • 模型权重(2B):https://huggingface.co/Tencent/WeVisDoc-2B • 许可:Apache-2.0 • 发布机构:腾讯微信视觉团队(WeChat Vision, Tencent Inc.) • 发布时间:2026-09(技术报告 arXiv 2609.20423 与 2B / 4B 权重同步开源)
做过知识库或 RAG 的人,大概都挨过同一记闷棍:一份带公式、带合并单元格表格的 PDF 或翻拍件丢进解析器,出来的东西看着差不多,公式糊成一串乱码,表格散成互不相干的碎片。文本是拿到了,可它一进检索链路,就是从头烂到尾的脏输入。
病根通常不在某一环,而在流水线本身。老办法是一串模型接力:先做版面检测,把页面切成文本块、表格块、公式块;再叫 OCR 引擎认字;表格解析、公式识别各跑一个模型;最后拼装成 Markdown。每一级都会带入误差,误差顺着链条往下传,到最后一环已经积重难返。歪斜的扫描件、光照不均的翻拍、跨栏的阅读顺序,任何一处出错,整页的产出就报废。
更麻烦的是,这条流水线的每一段都得单独部署、单独调参、单独维护。流程越长,出错后的排查成本越高:到底是版面切错了,还是 OCR 认错了,还是拼装阶段把顺序搞乱了?很多时候只能靠人工逐页对。
对做知识库的团队来说,这套流程的隐藏成本还在于数据规模。几百页还能人工抽查,一旦上到几十万页,任何一环的系统性偏差都会被放大成灾难:公式全糊、表格全散,检索召回率直接塌方。这也解释了为什么“文档解析”看起来是个老问题,却一直有人愿意重新做一遍。
WeVisDoc 换了个做法:一个视觉语言模型,从页面图像直接生成结构化内容,中间不拆流水线。
WeVisDoc 是腾讯微信视觉团队开源的端到端文档解析模型。给它一页文档图片,它直接输出结构化 Markdown:正文是 Markdown,公式是 LaTeX,表格是 HTML(合并单元格、嵌套结构都保留),阅读顺序也照着原页面走。模型基于 Qwen3-VL 微调,放出 2B 和 4B 两个版本,许可为 Apache-2.0,可商用。
就这样。一个模型,一次推理,不需要再接其他工具。
它的输出格式约定:
• 正文文字 → Markdown(含标题、段落、列表) • 数学公式 → LaTeX(行内用 \\( \\),块公式用\\[ \\])• 表格 → HTML(支持跨行跨列合并单元格) • 图像 / 图表 → 忽略,不描述(这是设计决策,不是 bug)
底座是 Qwen3-VL-Instruct,提供 2B 和 4B 两个尺寸,在此基础上做了大量的数据工程和精调。
要理解这件事的价值,得先看清一页文档里同时挤着多少种麻烦。
一页论文或试卷,至少藏着四个隐形的坑:分栏的阅读顺序怎么定;合并单元格的表格怎么还原成 HTML;带积分号、上下标和分式的公式怎么转成 LaTeX;歪斜、带噪点的扫描件怎么稳住不乱猜。传统 OCR 只负责“认字”,完全不碰这些结构关系,所以它能给你一堆文字,却给不了你一篇能用的文档。
端到端模型把这四件事收进同一个网络里,用一次前向就产出结果。好处不止是“少几个模型”,更关键的是没有中间产物需要对齐。版面切错导致的连锁错误、多个模型对同一区域理解不一致的问题,都被绕开了。
代价也有:所有压力都压在一个模型身上,它对训练数据的要求会比流水线里任何一个单点都更高。这也正是 WeVisDoc 把主要精力放在数据构造,而不是单纯堆模型参数的原因。
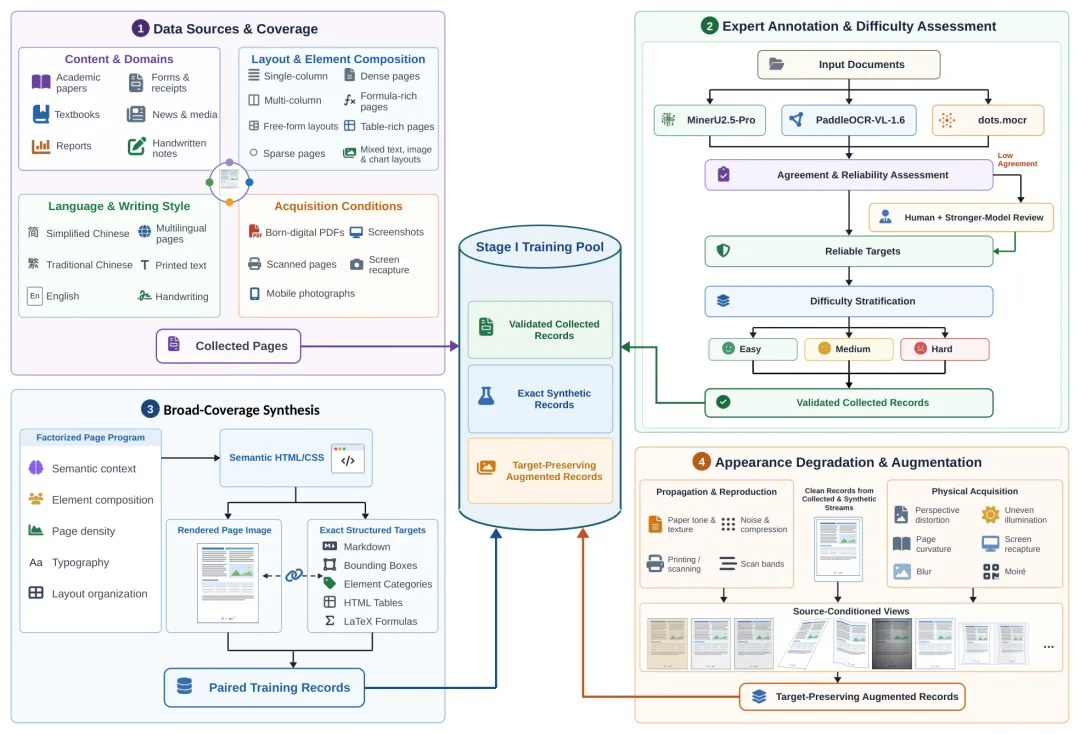
图注:Stage I 数据构建流水线。收集页经多模型标注归一化后与通用合成数据汇入同一个干净池,再按来源施加外观增强,最终形成阶段一的训练混合。(图源:论文 Figure 2)
WeVisDoc 的做法,是让一个模型同时承担版面理解、文字识别、公式识别和表格重建,输出统一进一个空间:
正文转成 Markdown
数学公式转成标准 LaTeX(行内
$...$、块级$...$)表格转成 HTML`<table>`,保留合并单元格与嵌套
结构全程维持原始阅读顺序
官方把这套输出叫“一个可检查的序列”。文本、公式、表格、阅读顺序都留在同一条输出里,下游不再需要去对齐几个模型的产物。对做检索的团队来说,这句话的实际含义是:切分、召回、重排全都能建立在一份稳定的结构化文本上,而不是建在一堆需要猜的碎片上。
举个具体的例子:一份跨两栏、中间插了一张合并单元格表格的财报,流水线方案可能把表格的左栏和右栏切成两个块,再拼接时顺序就乱了;端到端模型直接把表格当成一个整体来重建,HTML 里的行列结构天然对齐。这类结构对齐上的错误,往往比认错一个字更致命,因为它会污染整份文档的语义。
项目最有意思的部分不在模型本身,而在它怎么造数据。论文标题就是「From Coverage to Capability」,直白说就是先铺广度、再补短板。
阶段一(Stage I)的目标是覆盖面。团队把异构数据源凑到一起,从语义、结构、外观三个维度把文档形态铺开,数据量约四千万条。同时做了一件关键的事:结构保持的降质合成。给干净的数字页面人为加上噪点、模糊、歪斜、复印或传输的痕迹,但保证结构标注不丢。这样模型在合成退化样本上也能拿到正确的监督信号,而不是被噪声带偏。
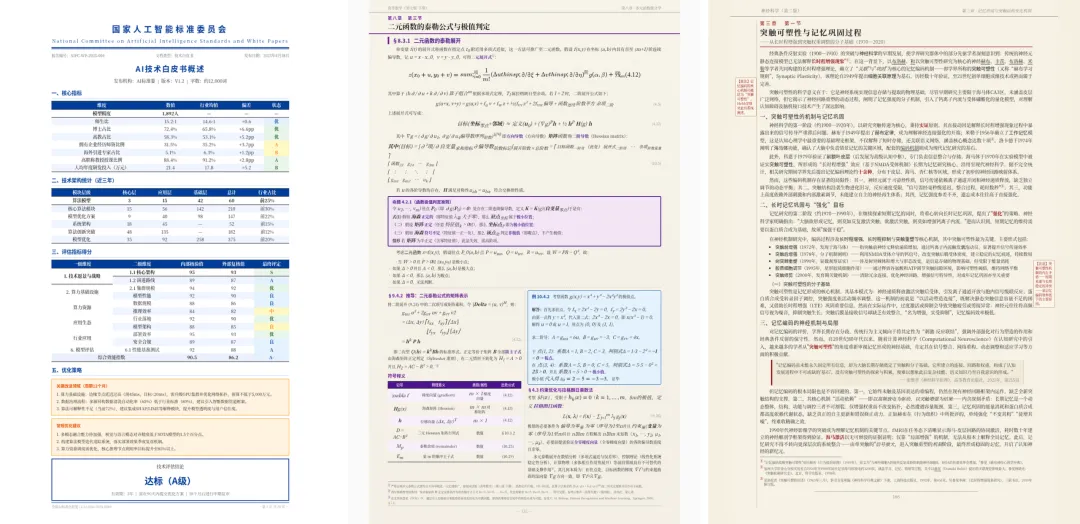
图注:通用数据合成产出的代表性页面。结构化技术报告、公式密集的教学页、长篇学术页并列,覆盖语义、元素组成、页密度与版式的联合变化。(图源:论文 Figure 3)
阶段二(Stage II)才是分水岭。铺完面之后,团队先用一个独立留出的探针集去测模型到底错在哪:把残余错误归到固定的“视觉-结构簇”里,比如手写批注、彩色教材、密集公式页。定位完弱点,才定向造数据、重新分配训练的 target-token 预算。数据量约五百万条,规模远小于第一阶段,但每一份都花在刀刃上。
这里还有个工程细节:阶段一更新整个模型(视觉编码器加语言模型),阶段二只冻结视觉编码器、单独精调语言模型部分。也就是把“看懂页面”的能力锁住,只去修“写对结构”的表达。
这种分工背后是一个判断:识别页面上有什么,靠的是视觉编码器见过足够多的形态;把结构写对,靠的是语言模型这一侧的表达能力。阶段一把两者都练起来,阶段二则专注打磨后半段,避免把已经学好的视觉能力又搅乱。
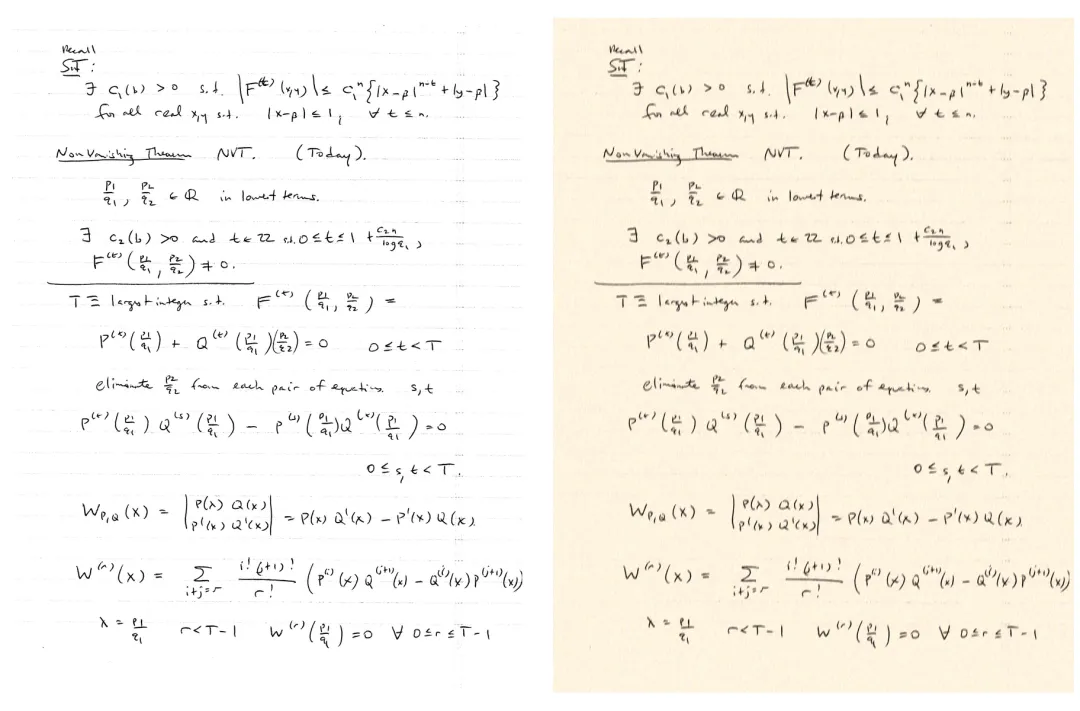
图注:外观变换对比。左侧是源页,右侧是变换视图,对应纸张、复印与传输效应。(图源:论文 Figure 4a–b)
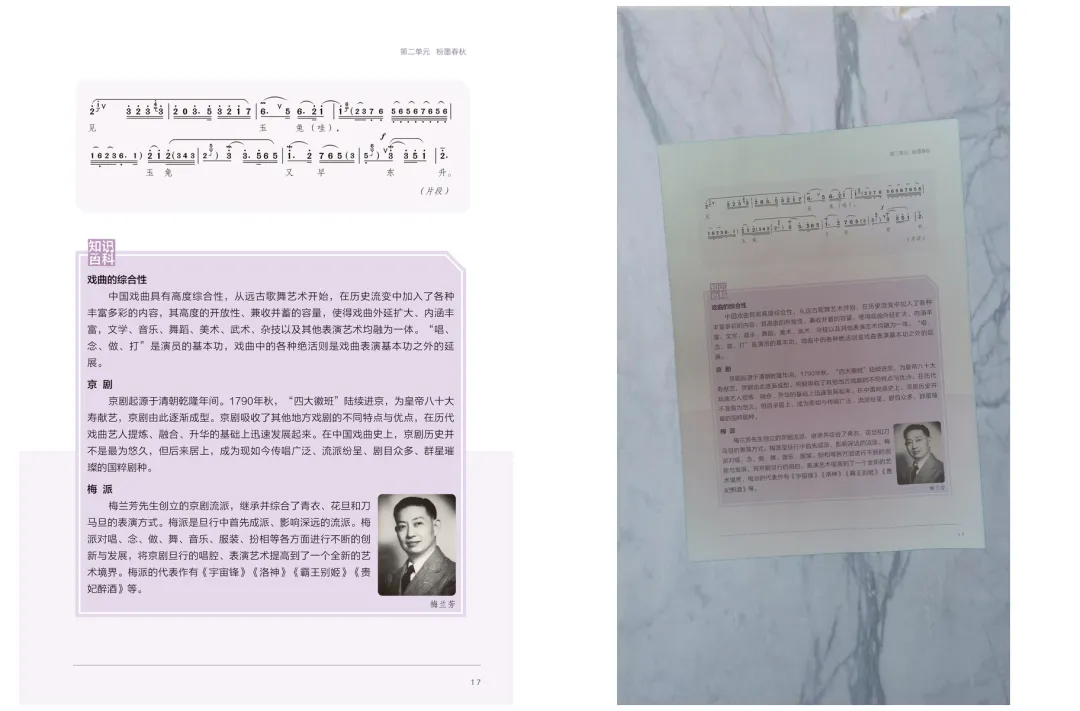
图注:物理采集效应。同一页教材从平整数字页变成大理石台面上的翻拍,带透视畸变、光照不均与模糊。(图源:论文 Figure 4c–d)
那“视觉-结构簇”具体长什么样?无监督聚类给出的两组代表很直观:一组是手写笔记,共享横格纸纹理、笔画组织方式和自由批注规律;一组是彩色教材,按栏目框、例题、习题块、插图来分组。团队要做的,就是从错误里找出模型反复栽跟头的那几类簇,专门给它们补数据。
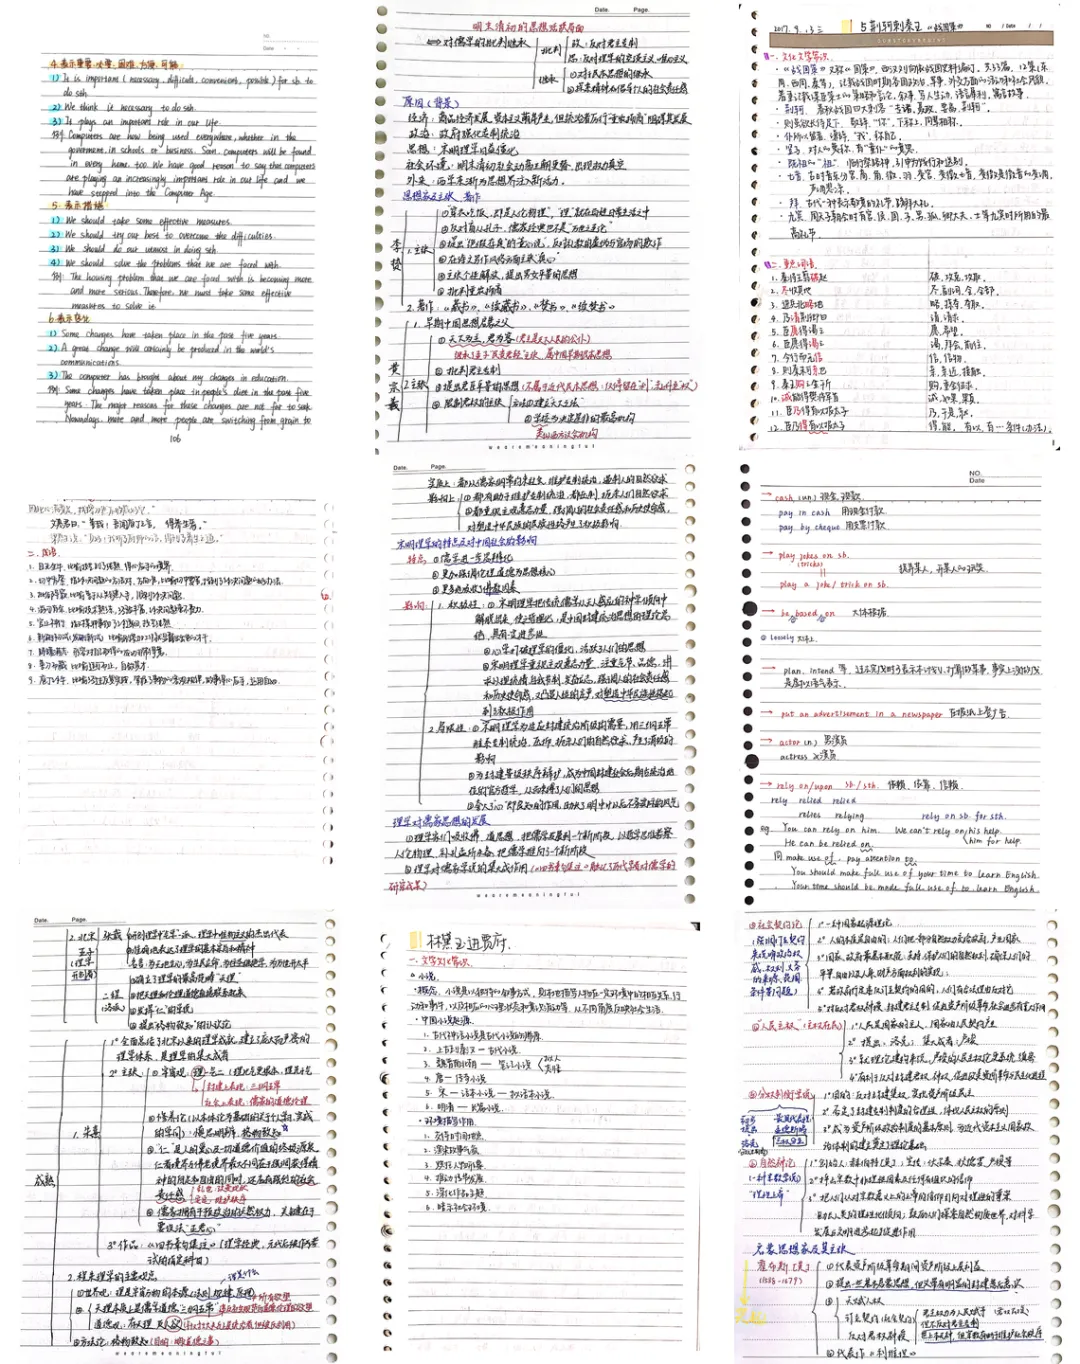
图注:全局无监督聚类得到的代表群组之一。手写笔记共享横格纸纹理、笔画组织方式与自由批注模式。(图源:论文 Figure 6)
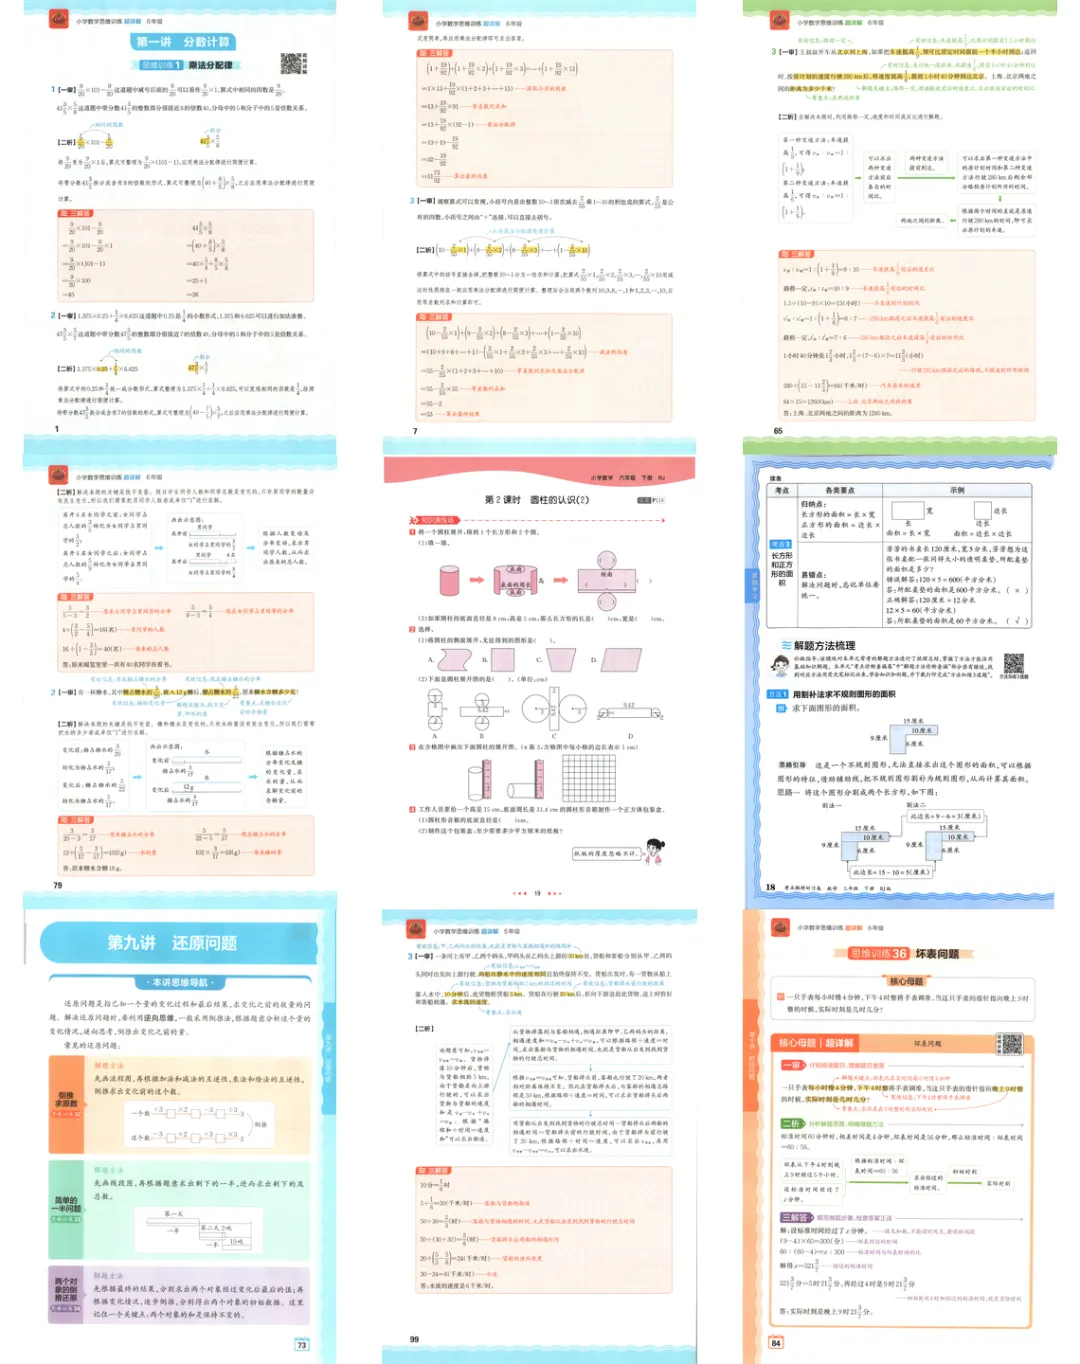
图注:另一组聚类代表。彩色教材按栏目框、例题、习题块、插图与图解说明分组。(图源:论文 Figure 6)
针对诊断出的低覆盖能力,团队会定向构造样本:公式密集、表格密集、多区域考卷、密集报纸版。这四类恰好是普通 OCR 翻车最狠的地方。
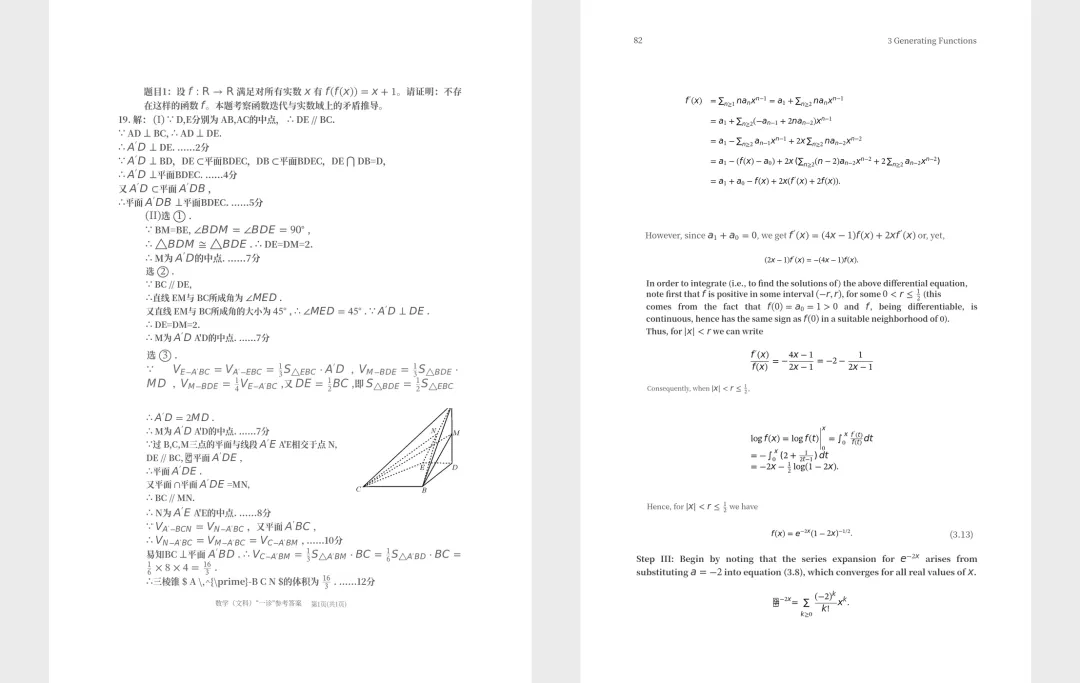
图注:定向构造样本之一,公式密集的推导页,含微分方程与级数展开。(图源:论文 Figure 7a)
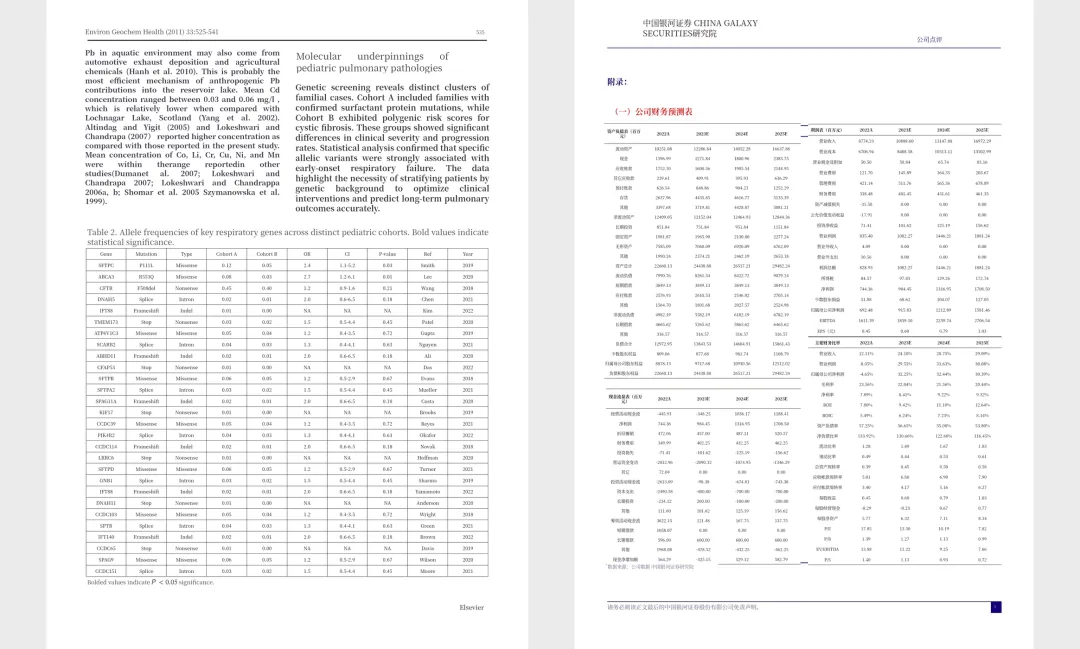
图注:定向构造样本之一,表格密集页,含科研数据表与券商财务报表。(图源:论文 Figure 7b)
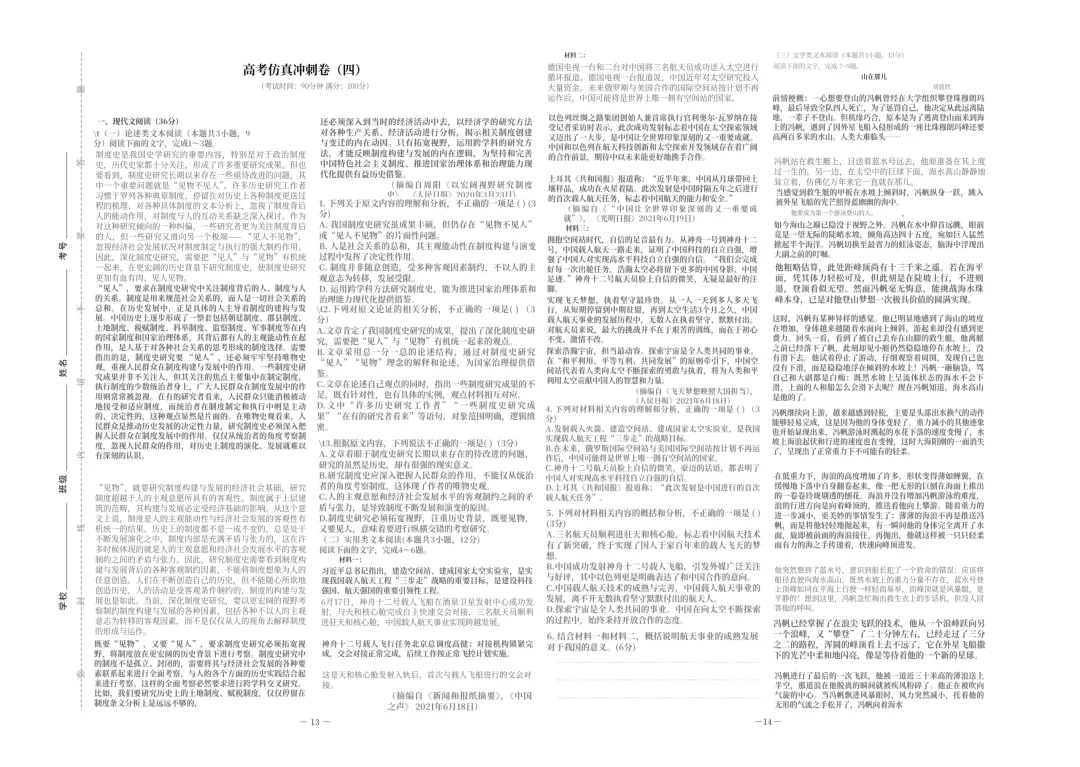
图注:定向构造样本之一,多区域结构的考试卷面。(图源:论文 Figure 7c)
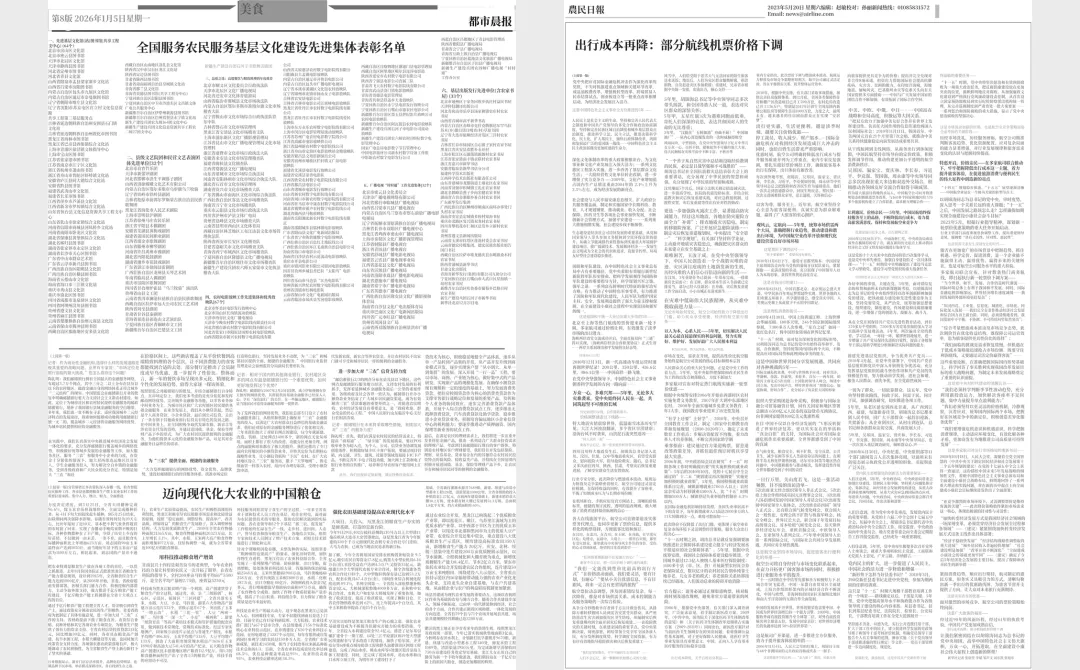
图注:定向构造样本之一,排版密集的报纸版面。(图源:论文 Figure 7d)
这套“先诊断、再补课”的顺序,是 WeVisDoc 最想让同行记住的一点:盲目堆数据量并不等于解决弱点,得先知道模型差在哪,再决定算力往哪花。训练本身也走的是常规配置:Fused AdamW、5e-6 学习率配余弦退火、全局 batch 512、序列长 8192,精度用 bfloat16,配上 FlashAttention 和 DeepSpeed ZeRO-2;报告里的成绩取三次推理的均值。
把这套方法抽象出来,其实是三步:先扩大覆盖面,再找出能力盲区,最后把预算花在残余缺口上。项目主页把这三步写成了三句口号:扩大文档覆盖面、定位能力区域、把 token 花在残余缺口上。它的普适性在于,任何数据驱动的模型都能套用:先量化失败,再定向投入,而不是拍脑袋加数据。
看分数之前,得知道分是在哪测的,不然容易被数字带偏。
OmniDocBench v1.6 是目前中文文档解析圈常被引用的评测集之一,共 1,651 页,覆盖公式、表格、阅读顺序等维度。PureDocBench 则是团队为这次工作自建的基准,1,475 页 HTML/CSS 页面、横跨十个领域,并且把同一个页面按三种观看条件切开:Clean 是干净清晰的原件,Digital Degraded 是算法降质后的版本,Real Degraded 是真实拍摄(翻拍、光照不均、透视畸变)的版本。第三档最难,也最接近日常使用里那些由人手拍出来的文档。
把同一个模型放到这三档上看,才能看出它到底是“在标准集上刷得高”,还是“真的抗退化”。WeVisDoc 的答案偏后者。
先看硬数字。WeVisDoc-4B 在 OmniDocBench v1.6 上拿到 95.38 的 Overall,PureDocBench 三条赛道的 Overall 均值是 75.54,在论文所比较的端到端解析器里,四个评测设置全部排第一。2B 版本也没有掉队,OmniDocBench v1.6 拿到 95.06,PureDocBench 均值 73.86。
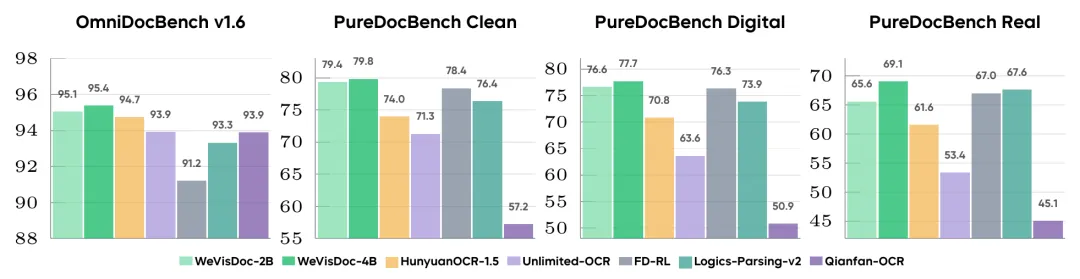
图注:四个评测设置的成绩总览。WeVisDoc-4B 与 2B 在 OmniDocBench v1.6 以及 PureDocBench 的 Clean、Digital、Real 三条赛道上领先所比较的端到端解析器。(图源:GitHub README)
真正拉开差距的地方是退化场景。4B 版本在三档上的得分分别是 Clean 79.81、Digital 77.74、Real 69.08,全部第一;其中最难的真实降质一档,比第二名高了约 2 分,是所有维度里差距最大的一处。
更能说明方法论价值的是阶段二的增益:从阶段一到阶段二,4B 在 OmniDocBench 上涨 1.16 分,Clean 档只涨 0.49 分,可到了 Digital 档涨 2.55 分,Real 档直接涨 4.03 分。反过来说,模型在标准清晰页面上和头部模型基本持平,优势几乎全部来自退化场景。这恰好印证了那条思路:把训练资源压在薄弱环节上,而不是继续在标准集上刷分。
换个角度看这组数字:Clean 档只涨 0.49,说明模型在干净页面上已经接近天花板,再往上抠分性价比很低;真正值得投入的是那些平时看不见、一用就翻车的退化场景。这既是 WeVisDoc 的方法论选择,也是它给同行的一条提醒:评测集里的平均分,未必等于用户手里的真实表现。
一个具体案例能看得更清楚。项目主页的交互演示里有一页数独:阶段一的模型整个漏掉了那个 9×9 的表格,阶段二把完整表格补了回来,Overall 从 65.87 跳到 99.22,TableTEDS 从 0.333 涨到 1.000。
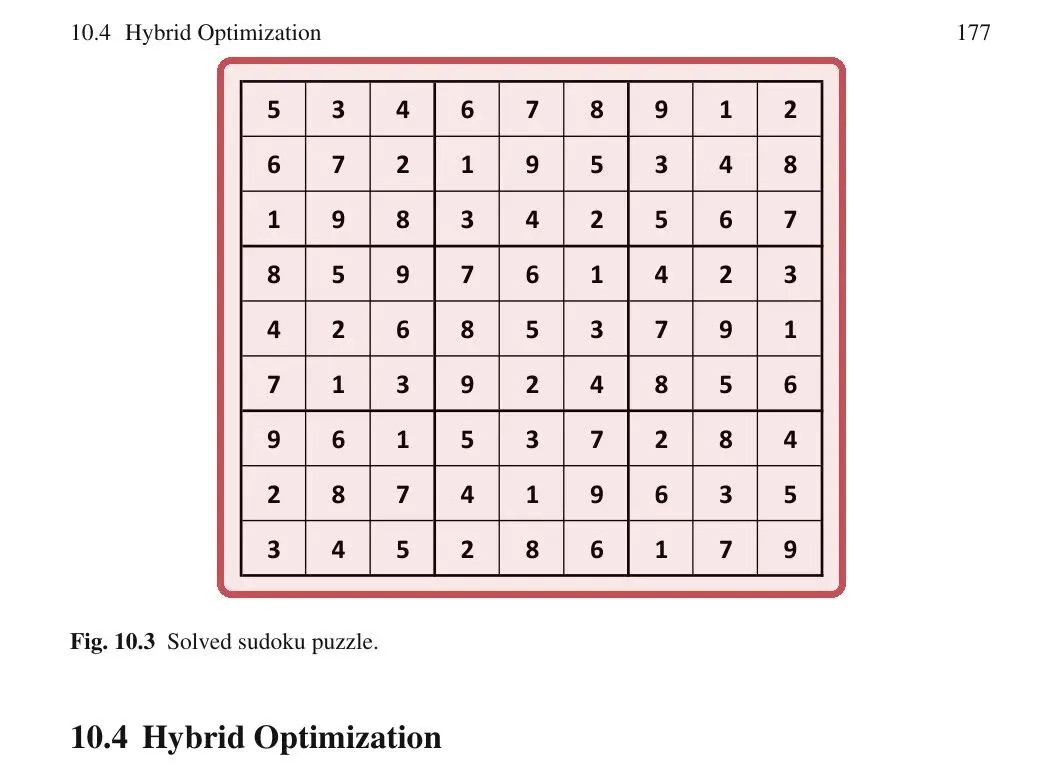
图注:OmniDocBench 数独案例。红框标出表格区域,阶段一漏识别,阶段二补全 9×9 表格。(图源:项目主页 OmniDocBench 案例)
真实拍摄的合同单,也是它重点照顾的对象。下面这份实拍《股权转让协议》里,红框标出的都是容易读错的关键字段。
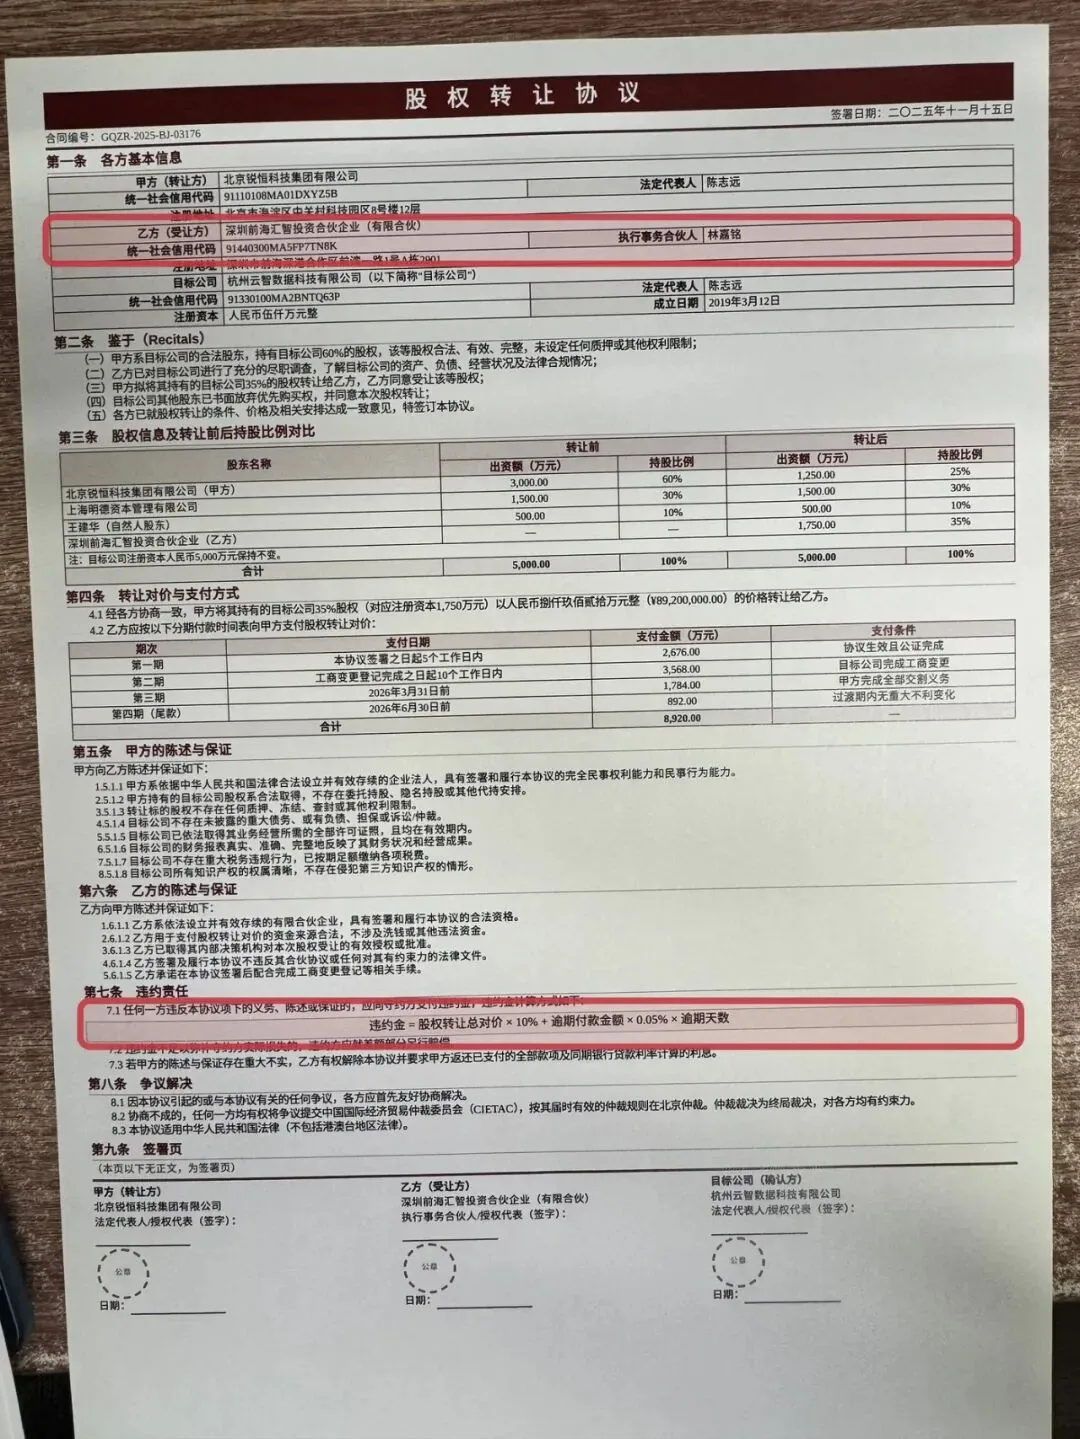
图注:PureDocBench 真实降质案例。手机翻拍的股权转让协议,红框标出受让方、违约金等关键字段。(图源:项目主页 PureDocBench 案例)
数字原生的密集版面同样在覆盖范围内,比如这份工厂员工手册,班次表、PPE 要求、异常响应流程、KPI 条带挤在一页里。
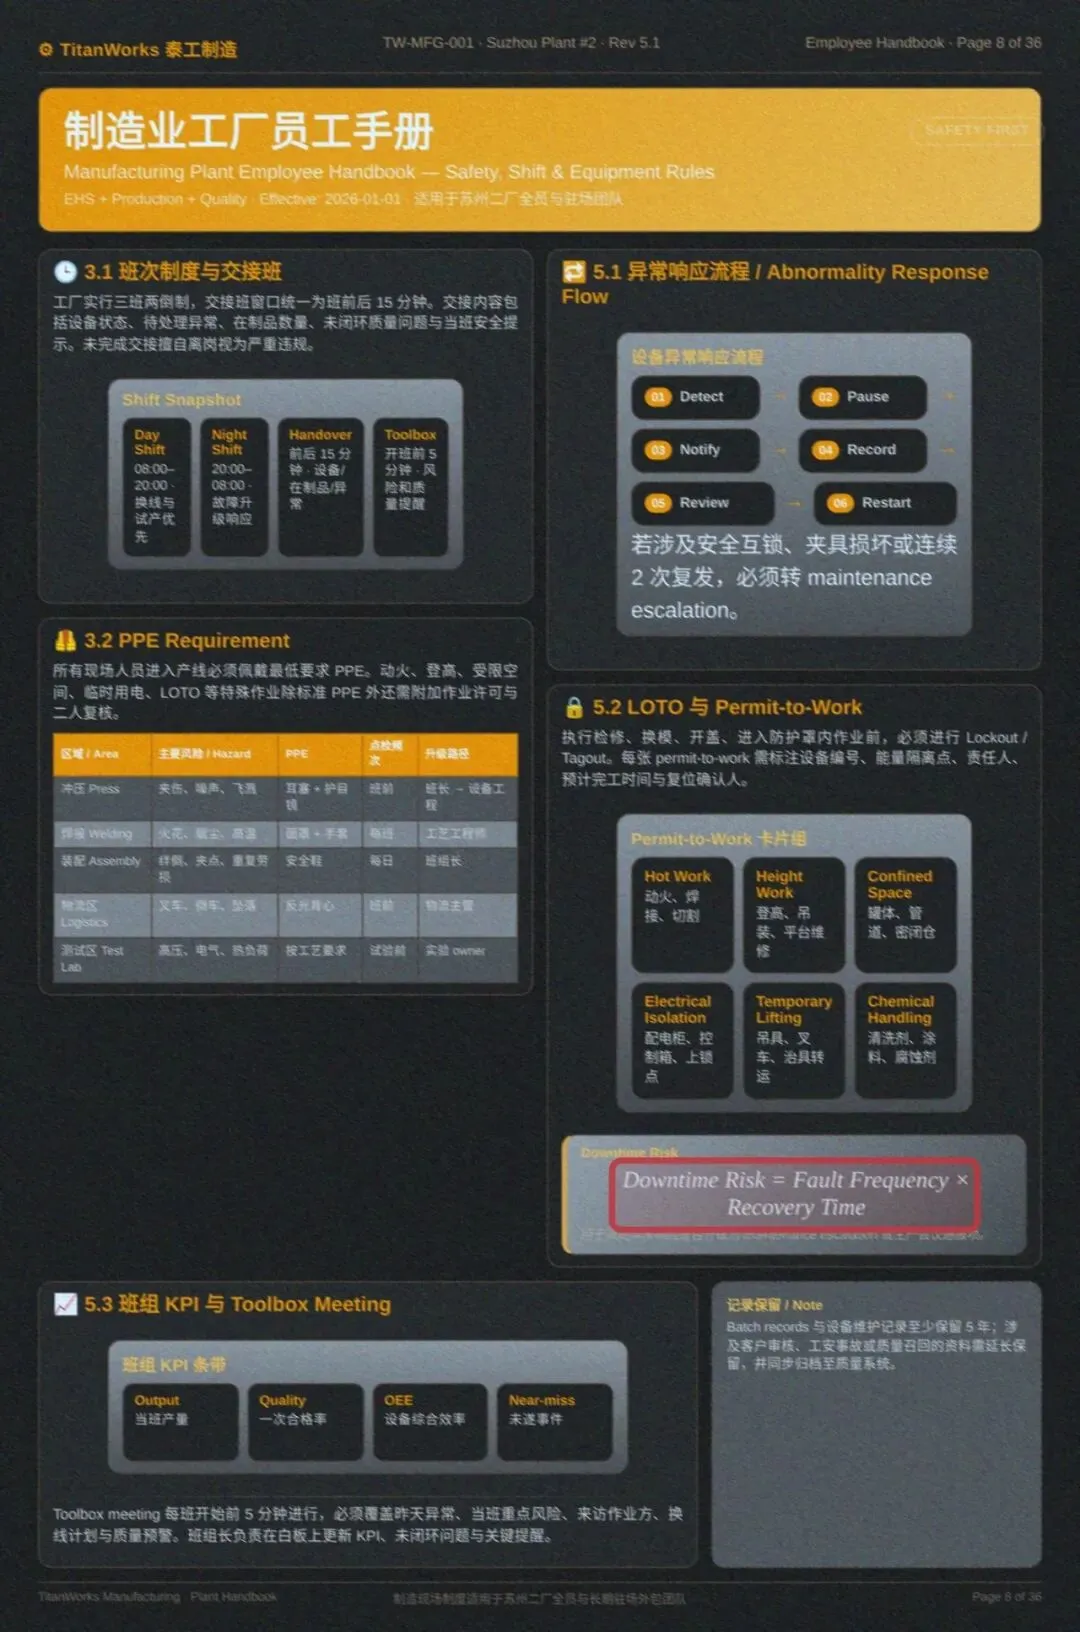
图注:PureDocBench 数字退化案例。数字原生的工厂员工手册页,密集表格与流程块并存。(图源:项目主页 PureDocBench 案例)
文档解析这两年挤得厉害,几个名字绕不开。腾讯自家混元团队的 HunyuanOCR(1B)走轻量路线,OmniDocBench v1.6 报 94.74,是 WeVisDoc 之外最强的端到端基线之一。再往外,百度的 PaddleOCR-VL-1.6 在同一个基准上报出 96.3,分数比 WeVisDoc-4B 还高。
这里有句话得说清楚:PaddleOCR-VL-1.6 是“VLM 加 PP-DocLayoutV3 版面分析”的组合,属于流水线、模块化路线,和 WeVisDoc 这种单一端到端模型不是同一个赛道。所以 WeVisDoc 的准确表述是“所比较的端到端解析器里第一”,而不是“所有文档解析器第一”。搞清楚这一点,才不会被标题里的一句“第一”带偏。
再看同一个榜单上的其他名字。DeepSeek-OCR 2、dots.ocr、FD-RL、Logics-Parsing-v2、Qianfan-OCR 都已挤到 90 分上下,彼此咬得很紧;1B 的 HunyuanOCR 能摸到 94.74,说明轻量端到端路线还有空间。分数越往上越难拉开差距,这也是为什么 WeVisDoc 把叙事重心放在退化场景,而不是标准集上的零点几分。
把 WeVisDoc 家族摆在一起看:
两者的综合分差 0.32,差距主要出现在退化场景。选择逻辑因此很朴素:页面本身干净、要拼吞吐,用 2B;手头多是手机翻拍、光照不均的扫描件,上 4B。
部署门槛不算高。按 README,需要 Python 3.10 及以上,用 vLLM(要求 0.11.1 及以上)起一个 OpenAI 兼容的服务,再把客户端指向它即可。
开服务和批处理长这样:
bash scripts/serve_vllm.sh Tencent/WeVisDoc-4Bpython -m wevisdoc.client --image-dir images --result-dir results --workers 4几个实操要点值得记一下。第一,PDF 不能直接喂,得先渲染成 PNG 或 JPEG 页面图,并且记好 DPI,分辨率压太低会丢掉小字证据。第二,--image-dir 会批量处理目录下的图片(不递归),每张图输出一个 Markdown 文件,已有结果默认跳过,需要重跑就加 --overwrite。第三,上下文默认是 32768,输出被截断就调大 token 或上下文预算;显存吃紧就降图片尺寸、上下文长度或并发数。
至于显存,官方 README 没有给专门的显存表,只给了模型别名、显存占用比(默认 0.9)这类参数。按参数量粗估,4B 模型以 bf16 加载,权重本身大约 8GB 量级,再加上 KV 缓存和激活,一张 12GB 级别的消费卡是比较稳的起点;2B 则更轻。想省事的话,官方仓库同时注册了 llama.cpp 和 MLX,苹果芯片用户也能本地跑。
Q:和 MinerU、Marker 这类开源工具有什么区别?
MinerU、Marker 走流水线路线,要跑版面检测、文字识别、公式识别、表格解析多个模型,在 OmniDocBench 上整体分数更高,工程成熟度也更高。WeVisDoc 是单模型端到端,部署比流水线简单,在测试集上的结构化解析效果不错。两种路线各有场景,不是谁淘汰谁。
Q:扫描件、手机拍照的文档能用吗?
能处理,但质量越差(严重弯曲、过度模糊、极低分辨率),解析质量就越难保证。论文里 Real Degraded 赛道 69.08 的分数意味着还有明显改进空间,不能理解为"什么条件都能搞定"。
Q:GPU 显存至少要多大?
2B 版大约需要 6-8GB 显存(bfloat16、合理上下文长度),RTX 4090 跑 4B 没问题。实际消耗取决于 MAX_MODEL_LEN 和并发数。建议先用默认参数试跑,显存不够再调低。
Q:支持哪些语言?
主要是简体中文、繁体中文、英文,以及中英混排。论文中没有对其他语言的明确测试结果,需要自行评估。
Q:和用 GPT/Claude 直接"看"PDF 相比怎么样?
功能定位不同。通用大模型对文档以"理解"为主,结构化输出通常不稳定,格式不统一。WeVisDoc 专门针对文档解析精调,输出格式固定(Markdown + LaTeX + HTML),适合 RAG 建库、数据清洗这类需要精确结构化提取的场景。
Q:HunyuanOCR 和 WeVisDoc 都是腾讯的,有什么关系?
两个不同团队开发的不同产品线。HunyuanOCR 来自混元多模态团队,底座是混元原生多模态架构,强调轻量(1B)和推理速度。WeVisDoc 来自 WeChat Vision 团队,底座是 Qwen3-VL,专注端到端文档解析,有 2B 和 4B 两个尺寸。
Q:论文里的4000万条训练数据会开放吗?
目前没有公开计划。模型权重(Apache-2.0)已开源,但训练数据是内部构建的,论文和仓库里都没有说会发布数据集。
Q:在实际业务场景里,什么时候应该选 WeVisDoc,什么时候选别的?
如果你的场景是混合内容(文字 + 公式 + 表格混排),文档来源多样(数字 PDF + 扫描件都有),部署资源有限,又希望一个模型搞定——可以认真评估 WeVisDoc-2B。如果场景以纯文字文档为主,或者对精度要求极高(比如金融合规),流水线方法目前在主流测试集上分数更高,也更成熟,可能更合适。
Q:它和普通 OCR 到底差在哪?
普通 OCR 输出的是文字流,丢掉了版面结构;WeVisDoc 输出的是带层级和语义的结构化 Markdown,公式、表格、阅读顺序都在里面。做检索时,前者需要你再猜结构,后者可以直接切分。
Q:2B 和 4B 怎么选?
页面干净、追求吞吐,选 2B,综合分只差 0.32;手头多是手机翻拍或严重降质的扫描件,选 4B,差距主要就体现在这类场景上。
WeVisDoc 是腾讯这一波开源里的新面孔。把它放回腾讯近两年的开源盘子里看,能看出一些规律。
一是主力模型已经很敢开放。2026 年 8 月 28 日,腾讯混元发布并开源了新一代旗舰 Hy4 preview:770B 总参数、49B 激活、1M 上下文,用的是标准的 Apache-2.0 许可,没有地域或营收门槛,权重直接可下载。往前数,Hy3 preview(295B / 21B、256K 上下文)在 2026 年 4 月发布,迭代节奏大约两个月一个大版本。
二是多模态几乎全线铺开。混元这条线里,图像有 HunyuanImage 3.0,视频有 HunyuanVideo 与 HunyuanVideo-I2V,3D 有 Hunyuan3D-2.1,翻译有 Hy-MT2,语音有 AuK,文档检索还有走 Apache-2.0 的 EVIE。从发布节奏看,图像、视频、3D、翻译、语音、检索几乎每个月都有新东西落地,且大多同步配了开源权重。
这些模型并不只是躺在仓库里。腾讯把它们接进了自己的产品线:元宝、ima 知识库、腾讯文档、CodeBuddy、WorkBuddy 等都在用混元系模型,Hy4 preview 上线时也同步进了这几个应用。对开源社区来说,这意味着模型经过真实产品的调用压力测试,而不是只在实验室里跑分。
三是文档解析这条线上,腾讯其实同时押了两支队伍。一支是混元团队的 HunyuanOCR(1B),走轻量单模型路线,成绩不错,但它走的是腾讯混元社区许可,不是标准 Apache-2.0。另一支就是这次微信视觉团队的 WeVisDoc,许可换成 Apache-2.0,商业使用更少掣肘。两支队伍同属腾讯,路线和许可却不同,放在一起看反而有意思:轻量 OCR 归混元,重度端到端解析归微信视觉,各自补位。
对使用者来说,这个细节有个实际含义:如果你需要的是标准 Apache-2.0、能放心商用的端到端解析,WeVisDoc 是更省心的选项;如果只需要一个轻量的 OCR 做辅助,HunyuanOCR 也够用。许可差异不是小事,在真正落地的时候往往比几分成绩更重要。
把这些串起来,腾讯在开源上的动作可以概括成一句话:既要旗舰级的底座(Hy4),也要贴着具体场景的专用模型(OCR、文档解析、翻译、语音),并且在许可上越来越多地用 Apache-2.0 这种对商业最友好的选择。WeVisDoc 正好踩在这条线的中间:模型不大,却盯准了一个高频又琐碎的刚需。
再好的成绩单也得配一份使用说明。团队在论文结论里写得很直白:WeVisDoc 的能力受两个东西约束,一是基准覆盖范围,二是合成退化的保真度。换句话说,合成出来的脏数据再逼真,也不可能穷尽现实里所有脏法。
几个明确测得不充分的场景要留意:手写体、历史扫描件、严重破损的文档。这几类在评测里覆盖不足,实际用的时候别默认它能稳住。另外,凡是高风险场景,比如合同、票据、医疗文书,团队建议加上出处追溯和人工复核,别让模型输出直接当最终结果用。
还有一点容易被忽略:模型输出的是结构化文本,不是校对过的真相。它能保住结构、认出公式和表格,但识别本身仍可能出错,尤其在低分辨率输入上。
也要看清它没打算解决什么。WeVisDoc 做的是页面到结构化文本这一段,它不负责理解文档讲了什么,也不负责判断内容真假。它的定位是一道更干净的预处理工序,先把能不能被机器读懂这件事解决掉,至于读懂之后做什么,交给下游的检索和推理环节。
另外,2B 和 4B 都是较小的模型,推理成本低是优点,但也意味着它在极端复杂的版面上未必比大参数模型更强。选它,看中的是端到端的干净产出和可私有化的成本,而不是参数规模上的碾压。
如果你做知识库或 RAG,WeVisDoc 的价值在源头:先把脏 PDF、翻拍件解析成干净的结构化 Markdown,公式走 LaTeX、表格走 HTML,后面的切分和检索质量会跟着上一个台阶。建议直接把 PDF 渲染成页面图这一步写进流水线,并固定 DPI,避免小字丢失。
如果你做私有化部署,4B 这个档位意味着单卡就能起服务,不必上大集群。可以先拿自己领域的一批页面跑一遍,重点看退化件的表现,再决定 2B 还是 4B。想省事就直接拉 vLLM 服务加客户端脚本,两条命令跑通全流程。
还有一个容易被低估的用法:老文档的数字化。很多企业手里压着一批扫描件、翻拍件,格式杂乱、质量参差,人工录入成本高。用 WeVisDoc 先批量转成结构化 Markdown,再让下游做检索或归档,能把从纸质到可用数据这一段缩短不少。
代码和权重都在 GitHub(Tencent/WeVisDoc)和 HuggingFace(Tencent/WeVisDoc-2B 与 4B)上,拿一篇自己领域的论文或合同试一试,很快就能判断它值不值得进你的链路。