ARTICLE · 1071248
具身智能技术文档我看了 3 遍还是没看懂,但这 3 件事我拿到了
今天,是我公开转型具身智能产品经理的第一天。
我本来打算事以密成,等转成了再说,过程不必给人看。但后来给自己算了一笔账:具身智能产品、智能硬件产品、智能体产品、AI coding 实操,这些课我全都报了。只报不学,钱和时间就都白花了;学完不输出,又很容易变成"感觉自己学会了"。
所以我把这两件事捆在一起,给自己定了个死线:三个月,把报过的课全部学一遍。
公众号就是我的自我监督机制,每学完有心得,就写一篇。写得好不好另说,先保证不断更。
现在关注这个号的人一共 3 个,挺好的。没压力,可以完全按自己的想法写。等哪天人多起来了,我大概还会怀念现在这种想说什么就说什么的日子。
一、昨天的真实体验:看 3 遍,没看懂
昨天听了"WAM 与 VLA 实战小班课"的第一讲,文档形式。
说句实话,第一遍我完全是懵的。
太久没碰代码了。面对这种纯技术文档,每个字都认识,连起来就不知道在讲什么。我前后看了两三遍,技术细节那部分,依然没真正看懂。
但我没关掉文档。因为就算细节看不懂,里面还是有 3 件事,是我作为产品经理能拿走、也觉得重要的。下面写下来。如果你也是刚转过来、被那些术语拦住的人,这篇或许能当个入口。
二、第一件事:VLA 到底在干什么
VLA 的全称是 Vision-Language-Action,视觉、语言、动作。
我自己的理解是,它把"看得见、听得懂、做得出来"这三件事合到了一个模型里。目标就是让具身实体能看得清、听得懂、做得到。
它由 4 部分组成。我按人体来记:
视觉编码器是眼睛,把看到的画面编码成计算机能识别的特征; 语言编码器是耳朵,把用户说的指令转成语言 Token; 多模态大模型是大脑,把视觉特征和语言 Token 融合,输出动作解码器能控制的动作表示; 动作解码器是手,把大脑的决定翻译成关节动作、位姿、夹爪开合,这些机器人真正能执行的东西。
串起来就一句话:眼睛看到画面,耳朵听到指令,大脑做决策,手去执行。
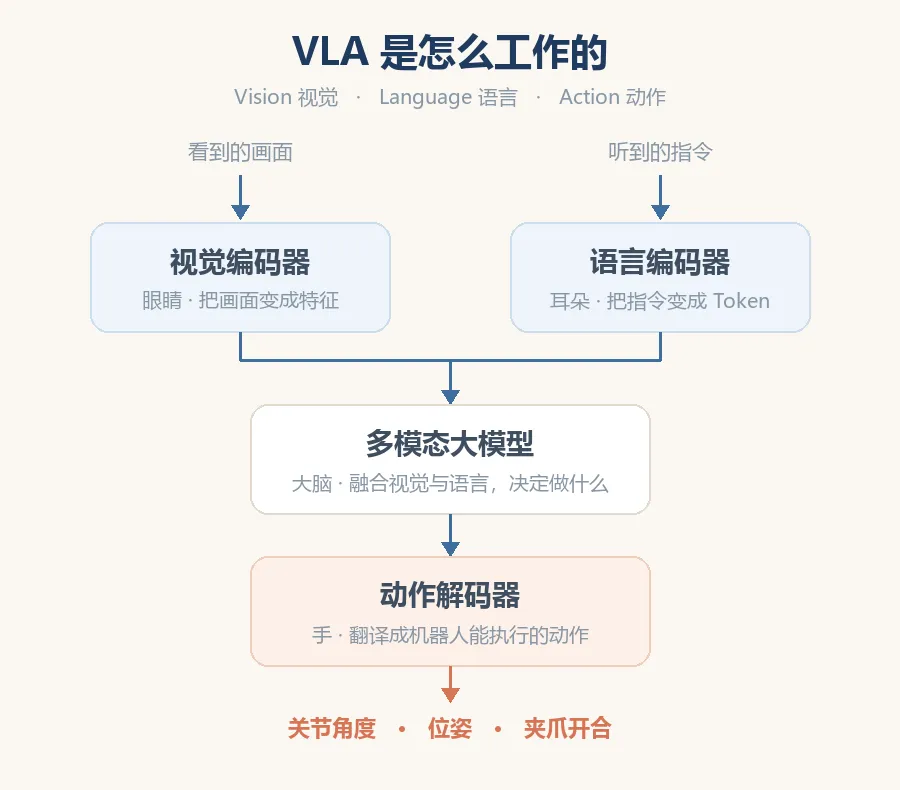
VLA四模块结构图
我理解 VLA 真正想解决的,是把过去分开的"感知"和"控制"收进同一个模型。好处是省掉了人为设计的中间接口,代价是模型对数据的要求变得极高。这正好是下一件事。
三、第二件事:现在 VLA 还卡在这 6 个地方
这是文档里信息密度最高的一段。我按"我自己能不能说清"分成两类讲,说不清的也如实讲。
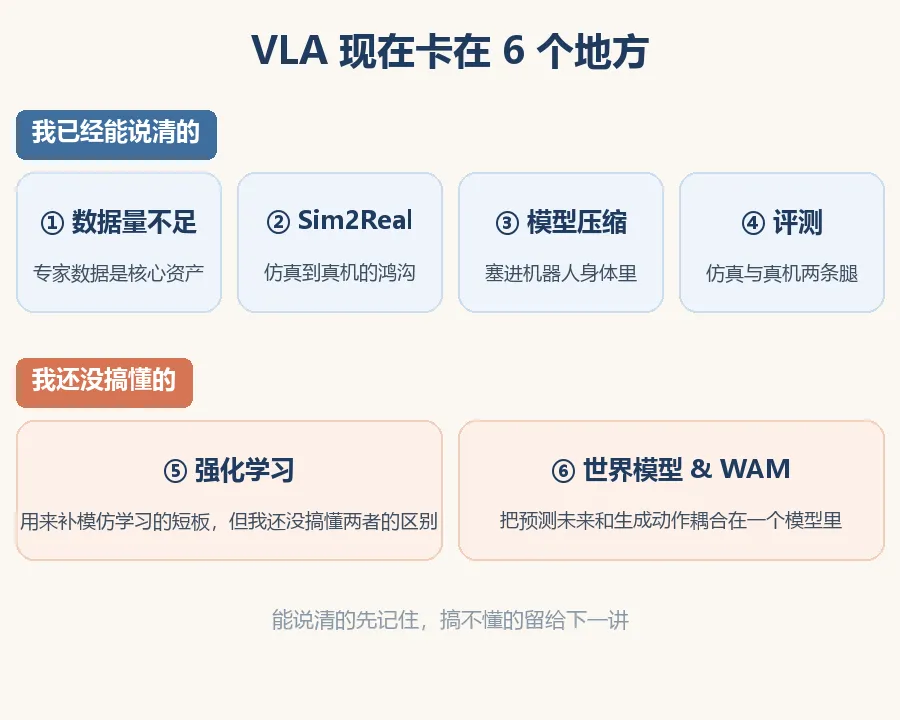
VLA六大痛点分布
能说清的
1)数据量不足
这个我最有体感。具身智能真正爆发就是这两年的事,数据积累远远跟不上。文档里有一句话我抄下来了:高质量、多模态的专家数据,是决定 VLA 模型能力的核心资产。模型架构可以抄,数据抄不了。
2)Sim2Real:从仿真到真机的最后一公里
它的定义我看了两遍才消化,是把仿真环境里训好的算法、模型或策略,迁移到真实物理世界。核心价值是用虚拟环境的低成本、高可控性,去解决仿真和现实之间的差距。
说白了,模型训完不能直接装上机器人,得先在仿真里跑测试,验证过关了才上真机。有点像在驾校模拟器上练科目二。模拟器里练得再溜,上了真车还是得重新适应一下离合。
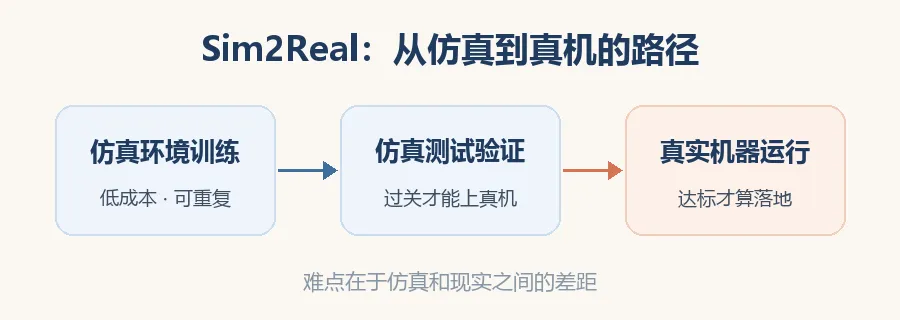
Sim2Real路径图
3)模型压缩:让模型塞进机器人的身体里
机器人本体又大又重,算力和存储都有限,而模型跑起来非常吃容量。所以必须做压缩,才能满足端侧推理低延迟、实时响应的要求。
这块我认为是产品经理最该盯的。它直接决定一个功能在真机上到底跑不跑得起来。
4)评测:两条腿走路
目前是仿真评测和真机评测共同组成 VLA 的评测体系。评测不只是打分,它其实在牵引整个行业的方向。你考什么,大家就往哪里使劲。
还没搞懂的
5)强化学习
文档里说,强化学习是为了解决只靠模仿学习训练出来的 VLA 的三个毛病:累计误差、泛化性差、长程任务表现不理想。
问题就在这儿,我到现在还没搞明白强化学习和模仿学习的区别。目前的理解大概是,模仿学习是照着专家的示范学,强化学习是自己试错、靠奖励纠偏。对不对,我打算下一讲验证一下。有懂的朋友,也欢迎在评论区给我讲讲。
6)世界模型 & WAM
这块我特意查了一下,因为一开始我完全不知道 WAM 是什么。
WAM 是 World Action Model,中文一般叫世界动作模型。它和 VLA 的区别在于,VLA 只负责输出动作,而 WAM 是把"预测未来会发生什么"和"生成动作"这两件事耦合在同一个模型里。容易混的还有纯世界模型,它只做预测、不生成动作。
这个方向今年热度很高,光 WAM 相关的综述论文就出了好几篇。业内的判断是,2026 年下半年开始,行业正从 VLA 和世界模型各自探索,走向融合。国内也有公司在做这条线。
这是我目前最想持续跟下去的一个技术方向。
四、第三件事:做具身智能,到底要不要会写代码
先说结论:学具身智能不需要很强的代码能力,但至少要会两样,基础的 Python,以及会用 AI coding 工具。
这个结论让我松了一口气。作为产品经理,我不可能去拼算法和工程,但我至少得能看懂模型在干什么,也能自己动手验证一些小想法。
文档里还引了黄仁勋今年 5 月在卡内基梅隆大学 2026 届毕业典礼上的演讲,他在这场典礼上获授荣誉科学与技术博士学位。有几句话我记了下来。
一份工作的"任务"和"使命"是两码事。他举了放射科医生的例子,AI 把看片子这个任务自动化了,但医生照顾病人的使命反而被抬高了。 AI 不会取代人类的目标,它只会放大人类的能力。 答案不是担心未来,而是明智地引导它。
刚看到的时候,我第一反应也是"又是鸡汤"。但结合自己的处境再想,这是实话。
我从来没担心过 AI 会取代我。我担心的是,我是不是被留在了原地。AI 既是焦虑的来源,也是解药,关键在你把它当威胁,还是当工具。
最后
Flag 立在这儿:每次学习有心得,都写一篇。
不追求写得多好,只求不断更。三个月后,我们再回来翻这一篇,看看那时候的我,能看懂今天的我多少。
如果你也在转型,也在啃那些看不懂的东西,评论区聊聊,我们一起往前挪。