ARTICLE · 1072272
论文画图又有新工具!143 个科研绘图模板,自动生成论文图表


今天分享的科研绘图 Skill是Vivid Figures,目前项目已经整理了 143 个完整源码图表配方、3 套完整组合模板和 146 张模板说明卡,同时提供 7 套内置配色,可以处理模型比较、实验分布、置信区间、相关性、SHAP、3D 图和空间数据等科研可视化任务。
它不需要你提前决定"到底画什么图"
把实验数据交给 AI,再告诉它希望这张图帮助读者看清什么,AI 可以先分析数据和科研表达目标,然后从现有模板中寻找合适的图,读取完整模板源码,再把真实实验数据接进去。
Vivid Figures
简单来说,Vivid Figures 是一个给 AI 助手使用的科研绘图 Skill。
项目地址:
https://github.com/yjz211/vivid-figures-skill
项目根目录有一个 SKILL.md,可以把它理解成 AI 使用这套科研绘图资源时首先阅读的说明书。具体的模板、源码、预览图和辅助工具则放在项目的其他目录中。
提供 143 个完整源码图表配方、3 套完整组合模板以及 146 张模板说明卡,同时内置 7 套配色。常规的 CSV、Excel、JSON 和实验结果文件都可以作为数据来源。
它覆盖的科研场景也比较广,机器学习论文里常见的模型性能比较、消融实验、训练曲线、参数敏感性、结果分布、相关性分析和 SHAP 都能找到对应的思路;如果做工程、空间数据或者仿真研究,也可以处理三维曲面、三维柱状图、轨迹和地图等图形。除此之外,项目还涉及流程图、技术路线图以及部分 TikZ 技术图。
所以它并不是简单给 Matplotlib 增加几套配色。真正用起来以后,AI 可以参与"分析数据、选择图表、调用模板、替换数据、运行代码、检查成图"这一整套过程。
它是怎么让 AI 自己选图的?
假设我们现在有四种算法,每种算法都进行了 30 次重复实验。
如果按照以前的使用习惯,我们可能先自己决定:"这里画一个 violin plot。"然后让 AI 写代码。
使用 Vivid Figures 时,可以把问题换一种方式描述:
我要比较四种算法在 30 次重复实验中的性能。除了整体性能,还希望读者能够看出不同方法的离散程度和实验稳定性。请分析数据,并选择适合论文展示的可视化方式。
收到任务之后,AI 可以先读取数据,看看有哪些变量、哪些字段代表实验分组、每组有多少样本、有没有重复实验以及现有数据能支持哪些统计信息。
接下来,它会根据我们希望表达的科研内容去搜索模板。找到几个候选方案以后,还可以查看对应的预览,再决定最终使用哪一个 recipe。
选好模板后才进入真正的绘图阶段。
整个过程其实很好理解:先看数据,再理解我们希望读者从图中看到什么,然后选图,最后才写代码。
和我们直接说"帮我画一个箱线图"相比,这种方式多了一层非常重要的科研判断。
哪些论文场景比较适合用?
如果你做的是机器学习、深度学习或者预测模型,最容易用上的应该就是模型性能比较。
比如一篇论文同时比较 Proposed Method、Random Forest、XGBoost、LSTM 和 Transformer,每个模型都有 Accuracy、Precision、Recall 和 F1。如果还有多次重复实验,就可以直接告诉 AI:
这是多个模型的重复实验结果。我希望比较不同模型的整体性能,同时展示实验结果的分布和稳定性。请根据真实数据选择合适的科研图。
这里没有提前规定柱状图、箱线图还是小提琴图,让 AI 根据数据结构来判断。
消融实验也是常见场景:
假设模型由 A、B、C 三个模块组成,我们有 Baseline、Baseline+A、Baseline+B、Baseline+C 和完整模型几组结果。可以告诉 AI,希望读者能够直观看出每个模块加入以后性能发生了什么变化,以及完整模型和各个消融版本之间的差异。
这种描述比一句"帮我画消融实验柱状图"提供了更多科研语境。
参数敏感性实验也是类似的思路:
假设 λ 分别取 0.001、0.01、0.1、1 和 10。我们可以告诉 AI,重点展示模型性能随着 λ 变化的趋势,以及性能较优的参数区域。如果 λ 跨越多个数量级,还可以让 AI 判断横轴是否应该使用对数尺度。
如果做的是训练过程分析,则可以把 epoch、train loss、validation loss、train accuracy 和 validation accuracy 一起交给 AI,让它帮助展示模型的收敛过程,并检查训练后期是否出现明显的训练集和验证集分离。
还有一类特别适合这种工作流的数据,就是重复实验结果。
很多论文最后只报告:Mean ± SD
其实只要保留了每一次实验结果,我们完全可以进一步展示数据分布。箱线图、小提琴图、雨云图或者其他组合分布图,都可以让读者看到平均值之外的信息。
如果研究涉及变量相关性、特征重要性或者模型解释,也可以使用相关性和 SHAP 模板。不过这里一定要注意数据来源。SHAP 图需要真实特征值和 SHAP 值,显著性标记需要真实统计检验,置信区间同样需要有对应的数据或计算方法。
数据里没有的信息,不要为了让图片完整而让 AI 补出来。
这一条在后面还会反复用到。
实战:把自己的 CSV 直接变成论文图
假设我们有一个 results.csv:
Model,Seed,Accuracy,F1ResNet,1,0.912,0.905ResNet,2,0.918,0.909ResNet,3,0.907,0.901ViT,1,0.941,0.936ViT,2,0.938,0.934ViT,3,0.945,0.939Swin,1,0.948,0.943Swin,2,0.951,0.946Swin,3,0.946,0.941
这里有三个模型,每个模型进行了多次实验,同时记录 Accuracy 和 F1。
很多人的第一反应可能是:给我画一个柱状图。
如果已经安装 Vivid Figures,可以直接把科研目的告诉 Agent。
可以复制下面这段:
使用 vivid-figures-skill 读取 results.csv。 这是三个模型在多次重复实验中的性能结果。我希望比较不同模型的 Accuracy 和 F1,同时让读者能够看到模型之间的性能差异和实验稳定性。 请先分析数据结构和我希望表达的内容,再从 Vivid Figures 中选择合适的图表模板。 使用珊瑚青绿配色。 选定模板以后,从完整 recipe 源码开始修改,不要重新手写一个简化版本。 所有统计量必须根据真实数据计算。不要虚构置信区间、显著性、误差或额外实验结果。 完成后实际检查生成的图片,处理明显的标签遮挡、裁切、图例和坐标轴可读性问题。 最终输出 PNG、PDF 和可复现的 Python 绘图源码。work Buddy生成示例:
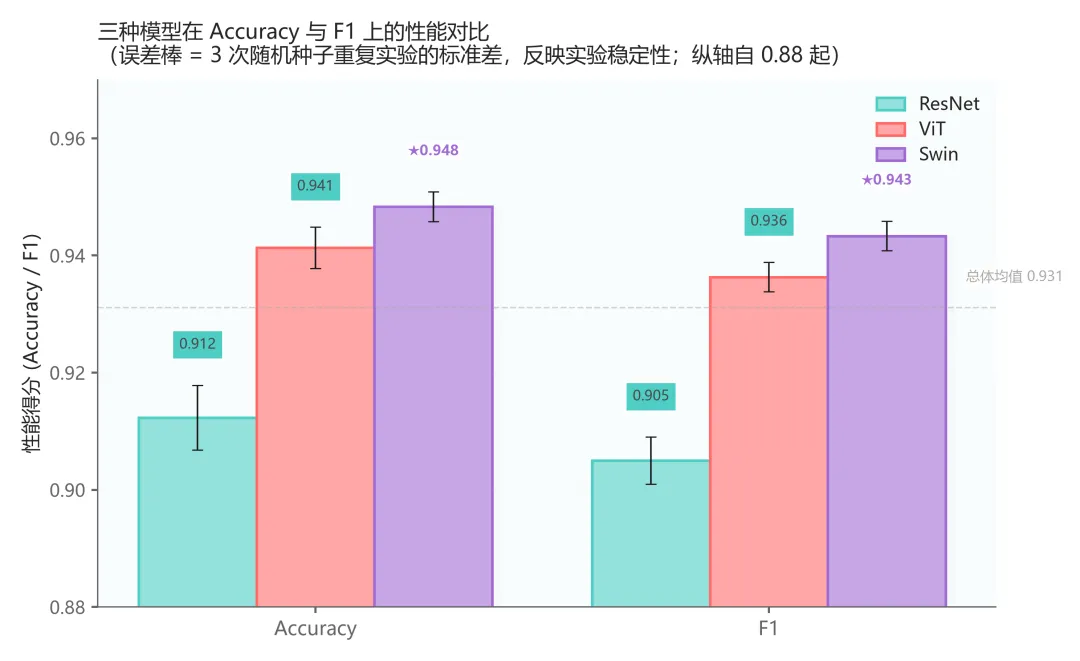
AI 知道我们的科研任务是比较模型性能和稳定性,并且它拥有选择图表的空间。再往后,我们明确要求从完整 recipe 修改,并限制它只能使用真实数据支持的统计信息。最后还要求实际检查成图。
这样就形成了一套相对完整的绘图任务。
少说"画什么",多说"想看什么"
如果想进一步发挥这类 Skill 的效果,可以慢慢改变自己给 AI 下绘图任务的方式。
例如以前我们可能会说:"给我画一个箱线图。"
可以改成:
我要比较四种算法在 30 次重复实验中的性能稳定性。除了中心位置,还希望读者看到不同方法的离散程度和异常值。请根据数据选择适合论文展示的可视化方式。
以前可能会说:"帮我画一个折线图。"
可以改成:
我要展示不同算法随迭代次数增加时的收敛过程,重点比较收敛速度、最终性能和训练后期的稳定程度。请根据数据选择合适的图表结构。
相关性分析也一样。与其直接要求"画一个热力图",可以告诉 AI:
我要分析多个连续变量之间的相关关系,希望读者快速识别强正相关、强负相关以及可能存在信息冗余的变量组合。
这样给出的信息和论文真正想表达的内容更接近。
AI 知道我们希望读者从 Figure 中读出什么以后,选图通常也会更有依据。
几套可以直接复制使用的 Prompt
如果不想每次重新组织语言,我整理了几个比较常见的科研任务,可以直接在此基础上修改。
自动选图
使用 vivid-figures-skill 读取我的数据文件。 先分析数据包含哪些变量、变量在实验中的含义、分组方式、样本数量、是否存在重复实验,以及哪些统计信息能够由现有数据可靠计算。 我的核心表达目标是: 【在这里写你希望读者从图中看出的内容】 请结合数据和研究目的,从 Vivid Figures 中搜索合适的图表模板。选定 recipe 后,从完整模板源码开始适配真实数据。 不要为了套用模板虚构任何数据、误差、置信区间、显著性或实验结果。 生成图片以后实际检查结果,处理标签遮挡、裁切、图例、坐标轴和可读性问题。 最终输出 PNG、PDF 和完整可复现 Python 源码。模型性能比较
使用 vivid-figures-skill 分析 results.csv。 这是多个模型在重复实验中的性能结果。重点比较各模型整体性能、模型之间的性能差异以及多次实验中的稳定性,同时检查是否存在明显异常结果。 请根据真实数据选择合适的科研图,不预先限定柱状图或箱线图。 使用珊瑚青绿配色。保留所选模板原有的渐变、透明度、描边、标记和层次设计,只根据真实数据和可读性进行必要调整。 不要添加数据中不存在的统计信息。 输出 PNG、PDF 和 Python 源码。消融实验
使用 vivid-figures-skill 读取 ablation.csv。 这是论文的消融实验。请分析不同模块加入或移除后对各项性能指标造成的变化。 我希望读者能够清楚看到 Baseline 的表现、各模块带来的性能变化、完整模型的表现,以及不同评价指标上的变化是否一致。 根据数据选择适合论文展示的模板,不要添加数据中不存在的统计信息。 完成后检查标签、图例和坐标轴是否适合直接放入论文,并输出 PNG、PDF 和绘图源码。参数敏感性
使用 vivid-figures-skill 分析 sensitivity.csv。 这是超参数 λ 的敏感性实验。请重点展示参数变化与模型性能之间的关系、性能较优的参数区域,以及参数过大或过小时模型性能如何变化。 如果 λ 跨越多个数量级,请判断是否适合使用对数坐标。 如果数据包含重复实验,可以展示有真实数据依据的不确定性;如果没有,不要自行生成误差范围。 选择适合论文展示的模板,并输出 PNG、PDF 和 Python 源码。修改已经生成的论文图
继续修改刚才生成的图。 将图例移动到上方,增大坐标轴字号,解决右侧标签遮挡,并调整画布比例,使图片更适合论文双栏排版。 沿用当前模板和配色,保留原有渐变、透明度、描边、marker、annotation 和主要图层结构。除上述要求外,不重新设计整张图。 修改完成后重新渲染,并检查实际图片。这最后一种 Prompt 在真实科研场景里其实会用得非常频繁。
论文图很少一次完成。导师一句"这个字太小""图例挡住曲线了""这个颜色打印出来看不清",都意味着还要继续修改。
有了完整源码以后,这种修改会轻松很多。
配色怎么处理?
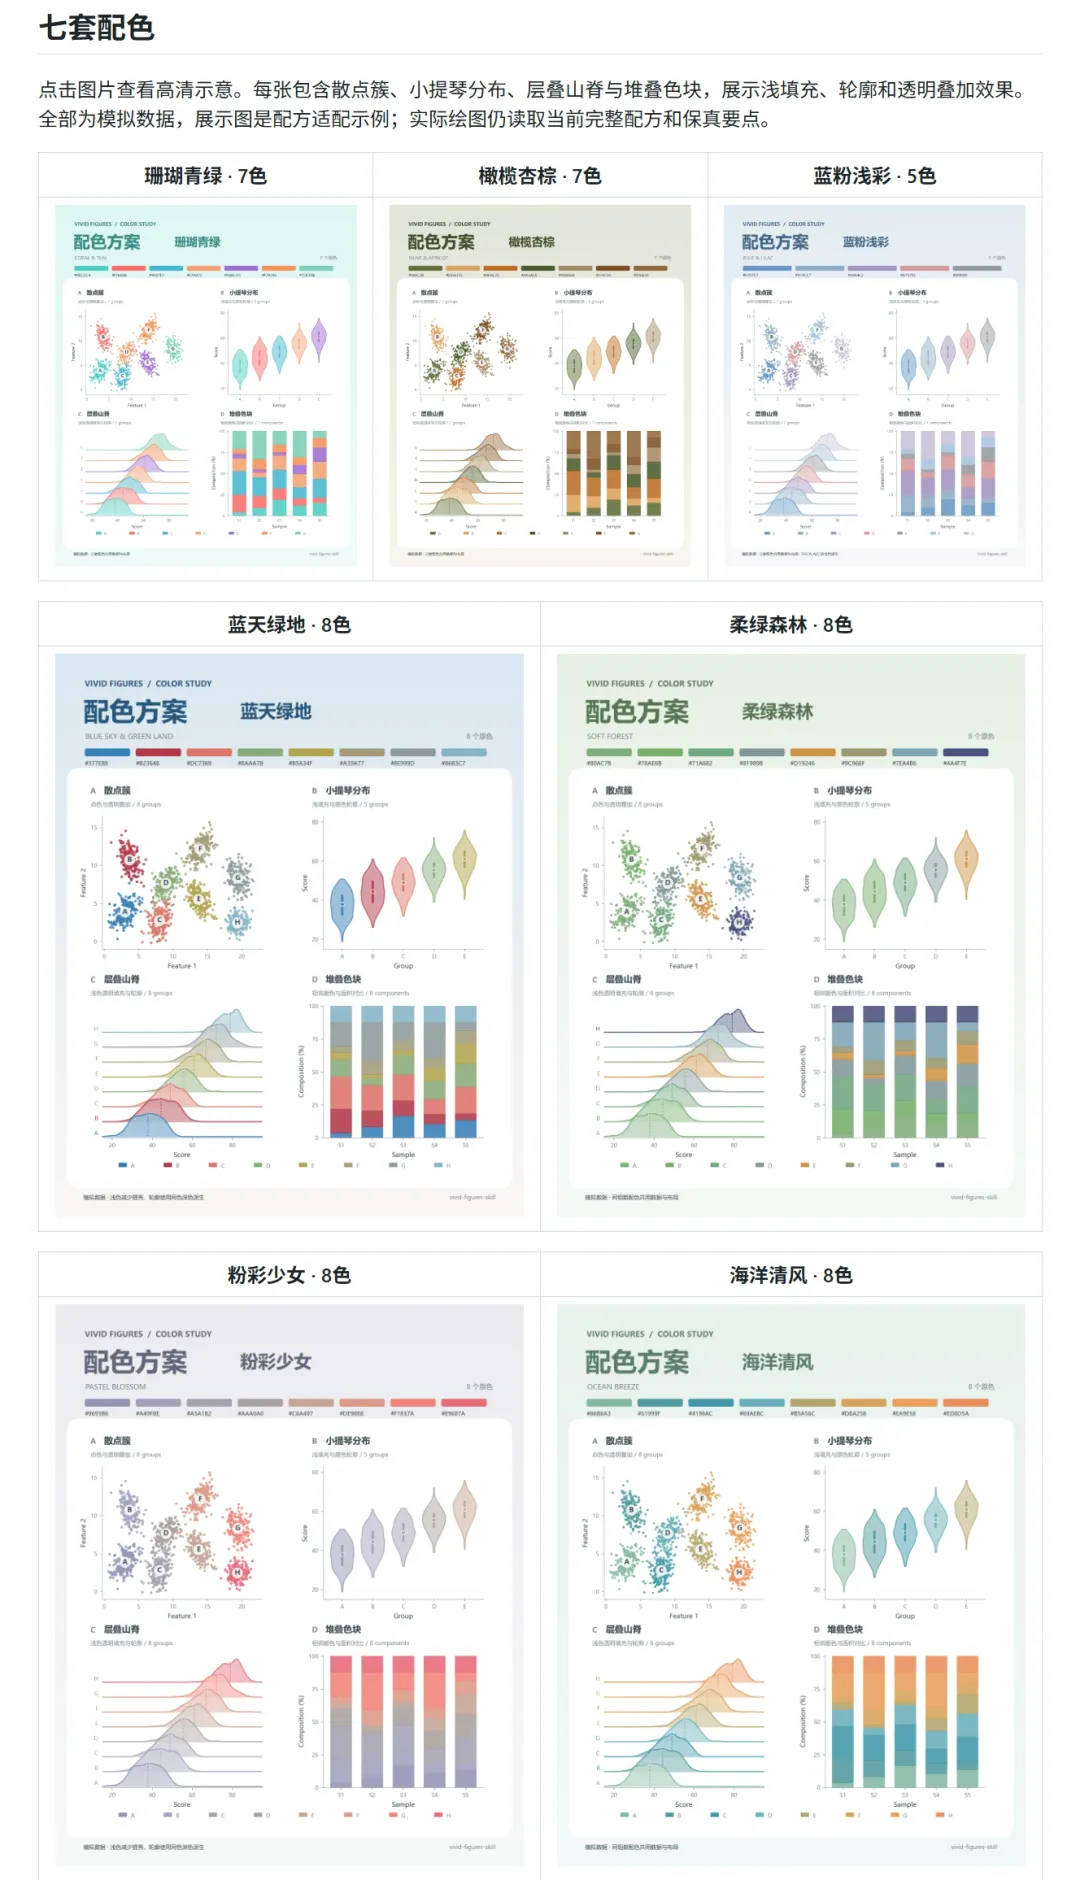
Vivid Figures 当前提供了 7 套内置配色,包括珊瑚青绿、橄榄杏棕、蓝粉浅彩、蓝天绿地、柔绿森林、粉彩少女和海洋清风。
没有特殊要求时,可以让 Agent 使用项目默认配色;如果想统一整篇论文的视觉风格,也可以直接在 Prompt 中指定:
整组 Figure 使用珊瑚青绿配色,并保持颜色含义一致。这里的"颜色含义一致"其实很重要。
假设 Proposed Method 在 Figure 2 里是青绿色,到了 Figure 3 又突然变成橙色,整篇论文看起来就容易混乱。
如果课题组或者论文已经有固定配色,也可以直接提供十六进制颜色:
整组图片优先使用以下颜色: #1F77B4 #FF7F0E #2CA02C #D62728这样比让 AI 自己反复猜"高级一点的科研配色"稳定很多。
生成完以后,别看到图片好看就结束
这里我特别想多说一句。
AI 科研绘图最大的风险之一,就是我们很容易被视觉效果吸引,然后忽略数据本身。
一张图生成以后,我一般会先检查数据有没有漏组、标签有没有对应错误、单位是否正确,以及多个坐标轴有没有把不同量纲混在一起。
如果出现误差棒、置信区间或者显著性标记,还要继续追问:这些数字是怎么算出来的?
*像单星、双星、三星这样的显著性标记,更不能因为模板里原本有,就直接保留下来。真实数据没有完成相应统计检验,就应该删掉。
然后再看视觉问题,例如图例有没有挡住数据、坐标刻度是否重叠、annotation 有没有跑到画布外、字号放进论文后是否还能看清。
建议在每个正式绘图 Prompt 最后加一句:
生成后实际打开并检查图片,不要以代码成功运行作为任务完成标准。
代码没有报错,只能证明 Python 跑完了。它不能证明 Figure 已经可以投稿。
以前我们让 AI 画图经常依赖一句:"帮我画得像 SCI 论文一点。"现在可以把成熟的科研图模板、选图逻辑、源码、视觉规范和检查流程一起交给 AI。
当这些资源能够被 Agent 调用以后,很多重复性的科研绘图工作就可以逐渐自动化。
课程推荐:
我们联合中科软研重磅打造的AI智能体赋能科研实战课程,零门槛上手、全程实操带练,适配硕博、科研从业者、高校教师及企业人员等各类科研人群!
🔥 课程核心核心内容(全场景落地实战)
1、AI全流程论文辅助,告别无效摸索
3、硬核技能+权威双认证,赋能职业发展

刘老师 13261851751(微信同号)
点击下图了解详细信息
如果你觉得这篇文章对你有帮助,记得 点赞、在看、转发 给身边还在科研里挣扎的伙伴。欢迎持续关注我们的公众号,后续还会分享更多 AI学术写作技巧、大模型与科研结合的实战案例,帮你把科研效率拉满。
点赞鼓励一下