ARTICLE · 1085597
AI编程工具集体"裸奔"——GitSpawn撕开安全口子,CAITLYN自进化防御中间件给出新思路
9月1日,安全团队Manifold Security扔出一颗炸弹:GitSpawn,8个漏洞,覆盖7款主流AI编程工具——Claude Code、OpenAI Codex、Cursor CLI、Goose、Qwen Code、Grok Build、Hermes Agent。这些工具加起来接近50万GitHub Star,光Claude Code一个就有7700万月npm下载量。
攻击方式朴素到离谱:你收到一个zip包,解压,用AI编程工具打开,代码还没跑,攻击者已经拿到了你的SSH密钥、云凭证、所有本地仓库的访问权限。
整个过程不需要你输入任何prompt,不需要你点击任何确认按钮。
这不是某个工具的小bug,这是AI Agent时代安全模型的根本性裂缝。
一、GitSpawn到底打了什么位置
所有CLI编程工具都有一个共同习惯:打开项目文件夹时,自动在后台执行git status或git diff来收集项目上下文。问题出在Git自身的core.fsmonitor配置——这个设置允许仓库的.git/config文件指定一个外部程序,Git在刷新索引时会自动执行它。
攻击者只需要在恶意仓库的.git/config里写一行core.fsmonitor = /path/to/malware,当你用AI工具打开这个文件夹的那一刻,恶意程序就以你的用户权限静默执行了。
关键细节:
- Claude Code和Hermes Agent
攻击发生在workspace trust确认弹窗之前 - Qwen Code
发生在用户认证之前 - Grok Build
第一次按键就触发 沙箱完全不在执行路径上,Agent的权限模型根本看不到这次调用
Manifold的8个报告里有5个和其他研究团队撞车了。不是某一个人聪明,而是这个攻击面太大了,多个团队同时摸到了这里。
Sonar早在2026年4月就报告过同样的sink。Anthropic在2025年11月的2.0.34版本修复过,但到2026年6月的2.1.193版本,同样的问题又回来了。原因很简单:修复方式是调整执行顺序,而不是改变不变量。顺序可以被新版本打乱,不变量不会。
二、AI Agent的攻击面比你想的大得多
如果你觉得GitSpawn只是个Git层面的trick,那就小看问题了。2026年这一轮安全事件暴露的是一个系统性困境:
Prompt Injection在Agent时代已经不是prompt层面的对抗,而是系统安全问题。
传统场景里,Prompt Injection是用户在聊天框里塞一段恶意指令。但在Agent场景里,攻击可以藏在任何Agent会读取的外部内容中——网页正文、搜索结果摘要、README文件、API返回数据、工具日志。这些内容看起来完全正常,但可能夹带"忽略原有指令""调用某个工具""泄露文件内容"的恶意目标。
9月19日arXiv上一项多Agent系统注入研究给出了更扎心的数据:在6个Agent组成的生产级系统中,即使有系统级prompt防护,67%的Agent仍然对至少一种作用域违规攻击脆弱;通过工具输出的间接注入成功率高达43%。
OWASP连续四年把Prompt Injection排在LLM安全威胁榜第一名。2026年2月,OpenAI自己承认AI浏览器中的Prompt Injection"可能永远无法完全修补"。
翻译一下:这不是一个能被修掉的bug,这是一个结构性的对抗面。
三、防御困境:不可能三角
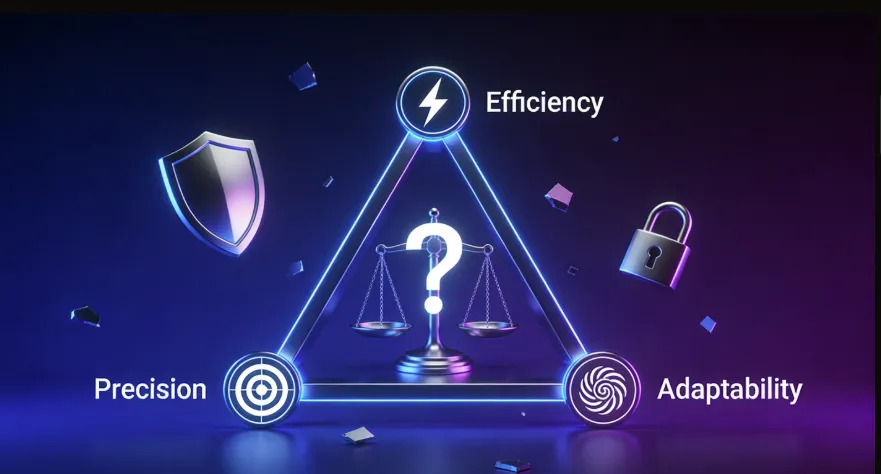
当前AI Agent防御方案面临一个"不可能三角"——运行效率、上下文精度、适应能力三者不可兼得。
现实情况是:每次遇到外部内容都调一个大模型做安全审查,成本和时间都不允许;完全依赖人工规则,又会被新攻击轻松绕过;沙箱再严密,如果Agent的启动流程本身就在沙箱外面跑命令,等于没设防。
这就是CAITLYN出场的背景。
四、CAITLYN的思路:让防御自己长出来
CAITLYN(Continuous Agents for Injection Threats via Lifelong Yielding Nexus)是8月底发布在arXiv上的一项研究。它的核心主张很直接:不要把防御写成静态规则,让系统从失败中自动合成新的防御。
架构分两层:
System I——快速运行时防御:外部内容首先进入Tier-0过滤器,用可执行脚本、签名规则、启发式检测等低成本手段快速处理高置信度风险。命中就拦,没命中再进Tier-1——一个优化过的LLM分类器,专门处理需要语义判断的模糊case。
System II——反例驱动的防御进化:当新型攻击绕过了System I,System II不是简单记录失败日志,而是把"漏网之鱼"转化为counter examples,自动生成新的防御技能,在沙箱验证后写回共享防御库。
每一次miss都会被炼成下一条defense skill。
五、数据说话
研究人员在AgentDojo-S250、ASPI-S、SafeClawBench-S240以及一个专门测试新攻击适应能力的Emerging基准上做了评估。
核心数据:
在已知攻击上,CAITLYN的检测性能与当前最优方案持平,但token开销低于LLM-as-Judge基线 - 在Emerging attack场景(新型未知攻击)中,CAITLYN-evolved将攻击成功率降低了约40个百分点
静态防御和单独的System I在Emerging场景下仍然脆弱,只有System II的进化能力真正补上了缺口 顺序合成设置中,系统展示了持续积累能力——防御能力随新攻击暴露不断叠加
40个百分点不是小数字。它意味着从"基本防不住"到"大部分能挡住"的质变。
六、对你有什么实际意义
你可能不直接用CAITLYN,但它揭示的方法论对每个在用AI工具的人都有参考价值:
1. 你的AI工具启动流程可能不安全
检查你的工具版本是否已修复:Claude Code 2.1.196+、Goose 1.44.0+、OpenAI Codex 0.131.0+。收到zip格式的项目,打开前先检查.git/config里有没有core.fsmonitor。
一条命令临时封堵:git config --global core.fsmonitor false
2. "分层防御"比"单一银弹"靠谱得多
CAITLYN的System I + System II设计验证了一个原则:低成本规则拦已知攻击,LLM处理模糊case,进化模块应对未知威胁。这比把所有鸡蛋放在一个篮子里都有效得多。
3. 自进化是AI安全的必经之路
攻击在变,防御也必须跟着变。CAITLYN把"被绕过"变成"进化的燃料",这个思路不只适用于prompt injection防御,对任何对抗性场景都有启发。
4. 工具选型多一个维度
选AI编程工具,别只看功能多不多、速度快不快。安全架构是否分层、启动流程是否sanitized、是否有运行时防御机制——这些在GitSpawn之后应该成为硬指标。
七、一张表看清当前主流防御方案
写在最后
AI Agent的能力越强,攻击面越大。这不是某个工具能单独解决的问题,而是整个生态需要重新思考安全边界。
CAITLYN给出了一个方向:防御不应该是静态的城墙,而应该是一个活的系统——每次被攻击,都变得更强一点。
GitSpawn事件最大的教训不是某个漏洞有多危险,而是:当一个攻击面被多个团队同时发现时,说明这个面早就该被正视了。
你的AI工具遇到过安全问题吗?你检查过自己的.git/config吗?评论区聊聊