ARTICLE · 1087856
Linux 6.12 源码深度剖析: ___slab_alloc
Linux 6.12 内核深度解析:___slab_alloc 核心机制与多核协同架构
1. 📌 技术点速览
在 Linux 内核中,___slab_alloc 是 MemoryManagement (内存管理系统) 模块中 SLUB 分配器的慢速路径(Slow Path)核心控制引擎。
当内核执行 kmalloc 或 kmem_cache_alloc 时,会首先尝试极其高效的“快速路径(Fast Path)”——直接通过无锁的 this_cpu_cmpxchg 从当前 CPU 的本地缓存 kmem_cache_cpu 的 freelist 中获取空闲对象。然而,一旦本地空闲链表枯竭、发生 NUMA 节点不匹配、或者发生 CPU 抢占重调度,分配流程就会退化并调用 ___slab_alloc。
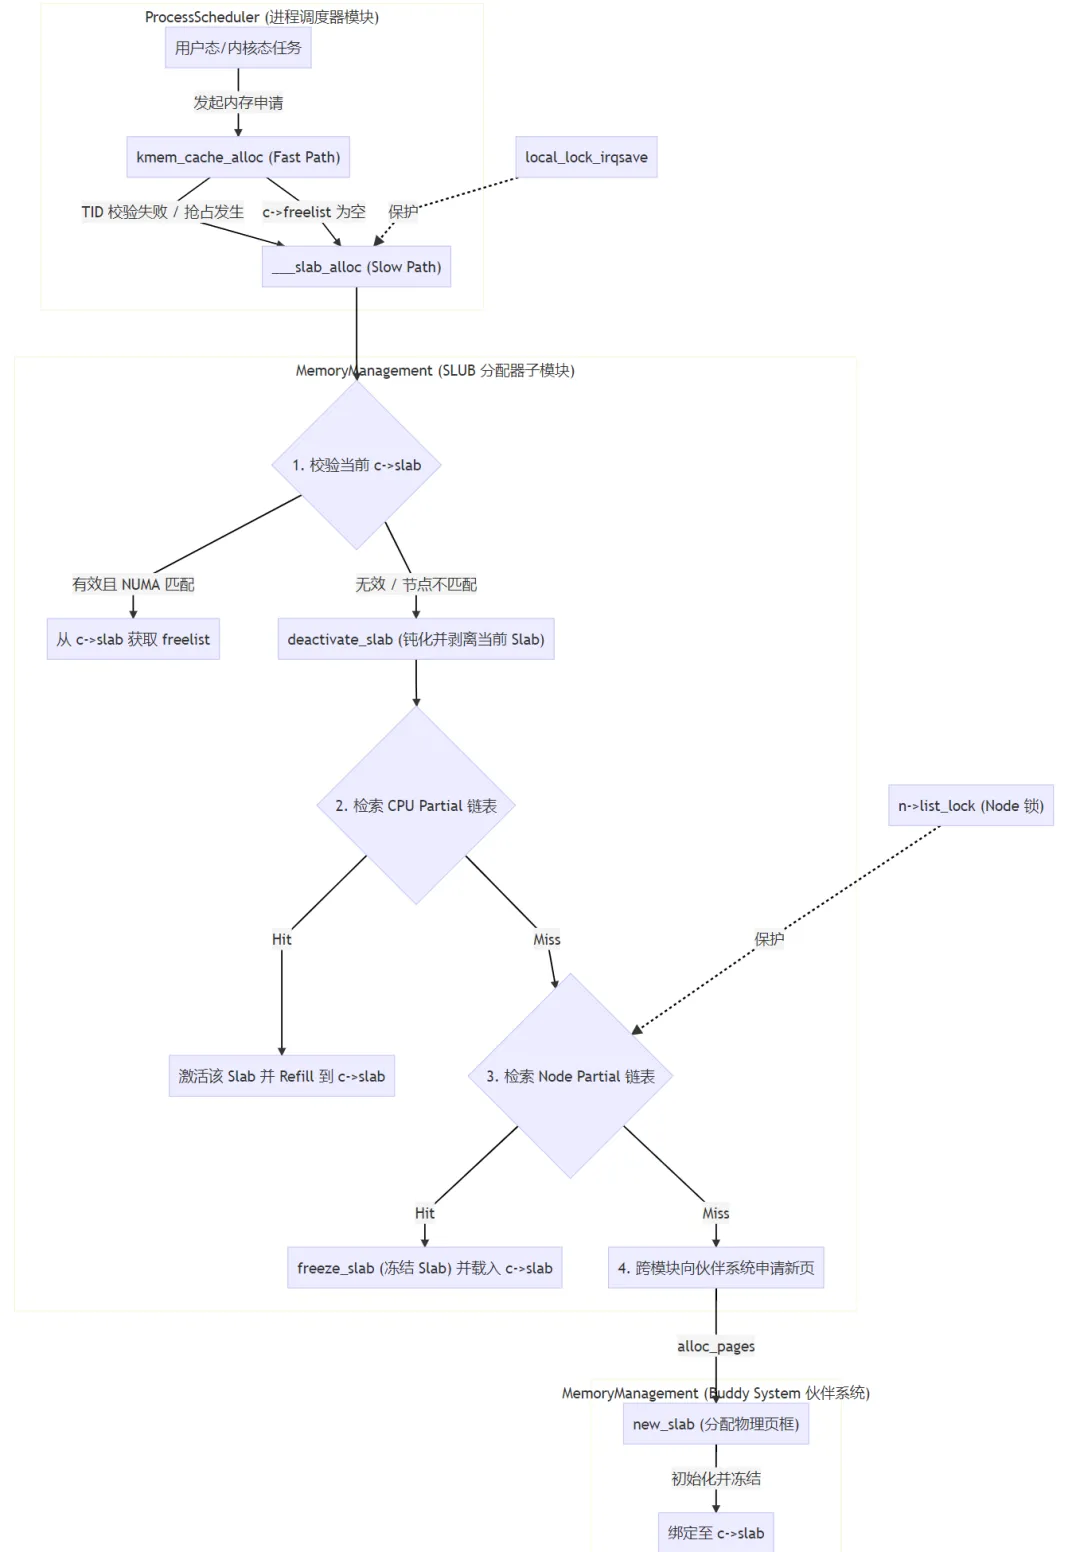
___slab_alloc 的核心职责是:在保证多核并发安全与 NUMA 亲和性的前提下,通过多级级联回溯策略(本地 CPU 局部链表 -> CPU Partial 链表 -> Node Partial 链表 -> 伙伴系统页分配器),为当前 CPU 重新填充(Refill)高可用性的 Slab 缓存,并返回可用的内存对象。
2. 🗺️ 软件功能架构图
下图展示了以 ___slab_alloc 为核心的内存分配多级回溯架构,清晰地呈现了 MemoryManagement (内存管理系统) 与 ProcessScheduler (进程调度器) 之间的跨模块协同关系。
3. 🔍 核心源码硬核解析 (基于 Linux 6.12)
在 arm64/x86_64 架构下,SLUB 分配器的核心慢速路径实现位于 mm/slub.c。以下是 ___slab_alloc 函数的关键源码解析。
/** 源码路径: mm/slub.c* 核心职责: SLUB 分配器慢速路径分配,负责多级缓存填充与 NUMA 亲和性适配*/static void *___slab_alloc(struct kmem_cache *s, gfp_t gfpflags, int node,unsigned long addr, struct kmem_cache_cpu *c, unsigned int orig_size){void *freelist;struct slab *slab;unsigned long flags;struct partial_context pc;bool try_thisnode = true;/* 增加慢速路径分配的统计计数 */stat(s, ALLOC_SLOWPATH);reread_slab:/** [步骤 1] 读取当前 CPU 绑定的 slab。* 使用 READ_ONCE 防止编译器优化,因为当前线程可能被抢占并迁移到其他 CPU*/slab = READ_ONCE(c->slab);if (!slab) {/* 如果指定的 NUMA 节点不在线,则忽略节点限制,设为 NUMA_NO_NODE */if (unlikely(node != NUMA_NO_NODE &&!node_isset(node, slab_nodes)))node = NUMA_NO_NODE;goto new_slab;}/** [步骤 2] 检查当前 Slab 是否与请求的 NUMA 节点匹配。* 如果不匹配,说明发生了跨节点访问,需要将当前 Slab 钝化(Deactivate)*/if (unlikely(!node_match(slab, node))) {if (!node_isset(node, slab_nodes)) {node = NUMA_NO_NODE;} else {stat(s, ALLOC_NODE_MISMATCH);goto deactivate_slab; /* 节点不匹配,剥离当前 Slab */}}/* 校验 pfmemalloc 标志,确保紧急内存分配安全 */if (unlikely(!pfmemalloc_match(slab, gfpflags)))goto deactivate_slab;/** [步骤 3] 获取本地 CPU 锁,防止中断和抢占干扰。* 在 Linux 6.12 中,使用 local_lock_irqsave 代替了传统的 raw_local_irqsave,* 这对 RT (Real-Time) 内核更加友好。*/local_lock_irqsave(&s->cpu_slab->lock, flags);/** 双重检查(Double Check):* 在获取锁之前,当前线程可能被中断或抢占,导致 c->slab 发生变化。* 如果变化了,必须释放锁并重新读取。*/if (unlikely(slab != c->slab)) {local_unlock_irqrestore(&s->cpu_slab->lock, flags);goto reread_slab;}freelist = c->freelist;if (freelist)goto load_freelist;/* 从当前已冻结的 slab 中获取空闲对象链表 */freelist = get_freelist(s, slab);if (!freelist) {/* 如果当前 slab 确实没有空闲对象了,将其解绑 */c->slab = NULL;c->tid = next_tid(c->tid); /* 更新 Transaction ID,防止 ABA 问题 */local_unlock_irqrestore(&s->cpu_slab->lock, flags);stat(s, DEACTIVATE_BYPASS);goto new_slab;}stat(s, ALLOC_REFILL);load_freelist:/* 确保当前 CPU 已经持有了 cpu_slab 的本地锁 */lockdep_assert_held(this_cpu_ptr(&s->cpu_slab->lock));/** 核心断言:用于 CPU 分配的 Slab 必须处于 "Frozen" (冻结) 状态。* 冻结状态意味着其他 CPU 不能向该 Slab 释放对象,所有释放的对象都会挂在临时链表上,* 从而保证了当前 CPU 对该 Slab 的独占无锁写入。*/VM_BUG_ON(!c->slab->frozen);/* 更新当前 CPU 的 freelist 指针,指向下一个空闲对象 */c->freelist = get_freepointer(s, freelist);c->tid = next_tid(c->tid); /* 递增事务 ID */local_unlock_irqrestore(&s->cpu_slab->lock, flags);return freelist;deactivate_slab:/** [步骤 4] 钝化 Slab 流程。* 当 Slab 已满或 NUMA 节点不匹配时,需要解除当前 CPU 与该 Slab 的绑定,* 并将其放回 Node 的 Partial 链表或完全释放。*/local_lock_irqsave(&s->cpu_slab->lock, flags);if (slab != c->slab) {local_unlock_irqrestore(&s->cpu_slab->lock, flags);goto reread_slab;}freelist = c->freelist;c->slab = NULL;c->freelist = NULL;c->tid = next_tid(c->tid);local_unlock_irqrestore(&s->cpu_slab->lock, flags);deactivate_slab(s, slab, freelist); /* 实际执行钝化,可能涉及解冻(Unfreeze) */new_slab:#ifdef CONFIG_SLUB_CPU_PARTIAL/** [步骤 5] 尝试从 CPU 本地 Partial 链表中获取 Slab。* 这是为了避免获取 Node 级别的全局锁 `n->list_lock`,从而提升多核并发性能。*/while (slub_percpu_partial(c)) {local_lock_irqsave(&s->cpu_slab->lock, flags);if (unlikely(c->slab)) {local_unlock_irqrestore(&s->cpu_slab->lock, flags);goto reread_slab;}if (unlikely(!slub_percpu_partial(c))) {local_unlock_irqrestore(&s->cpu_slab->lock, flags);goto new_objects;}/* 从 CPU Partial 链表中弹出一个 Slab */slab = slub_percpu_partial(c);slub_set_percpu_partial(c, slab); /* 更新 CPU Partial 链表表头 *//* 检查节点匹配性 */if (likely(node_match(slab, node) &&pfmemalloc_match(slab, gfpflags))) {c->slab = slab;freelist = get_freelist(s, slab);VM_BUG_ON(!freelist);stat(s, CPU_PARTIAL_ALLOC);goto load_freelist; /* 成功加载 */}local_unlock_irqrestore(&s->cpu_slab->lock, flags);/* 如果节点不匹配,则将该 Slab 移出 CPU Partial,放回 Node Partial */slab->next = NULL;__put_partials(s, slab);}#endifnew_objects:pc.flags = gfpflags;/** 优化策略:如果指定了特定 NUMA 节点,先尝试以 GFP_NOWAIT | __GFP_THISNODE* 快速从该节点获取,避免跨节点锁竞争。*/if (unlikely(node != NUMA_NO_NODE && !(gfpflags & __GFP_THISNODE)&& try_thisnode))pc.flags = GFP_NOWAIT | __GFP_THISNODE;pc.orig_size = orig_size;/** [步骤 6] 尝试从 Node 级别的 Partial 链表中获取 Slab。* 此过程会持有 `n->list_lock` 锁。*/slab = get_partial(s, node, &pc);if (slab) {if (kmem_cache_debug(s)) {/* 调试模式下的特殊处理 */freelist = pc.object;if (s->flags & SLAB_STORE_USER)set_track(s, freelist, TRACK_ALLOC, addr,gfpflags & ~(__GFP_DIRECT_RECLAIM));return freelist;}/** 核心操作:冻结(Freeze)获取到的 Slab。* 冻结后,该 Slab 专属于当前 CPU,其他 CPU 释放对象时不能直接操作其 freelist。*/freelist = freeze_slab(s, slab);goto retry_load_slab;}/** [步骤 7] 终极 fallback:向伙伴系统申请全新的物理页框。* 在调用 new_slab 期间,由于可能发生阻塞(取决于 gfpflags),* 必须先释放当前 CPU 的 cpu_slab 指针,避免持有引用跨越阻塞点。*/slub_put_cpu_ptr(s->cpu_slab);slab = new_slab(s, pc.flags, node); /* 跨模块调用:伙伴系统分配器 */c = slub_get_cpu_ptr(s->cpu_slab);if (unlikely(!slab)) {/* 如果带 __GFP_THISNODE 的本地分配失败,则放宽限制,允许跨节点分配 */if (node != NUMA_NO_NODE && !(gfpflags & __GFP_THISNODE)&& try_thisnode) {try_thisnode = false;goto new_objects;}slab_out_of_memory(s, gfpflags, node); /* OOM 报错 */return NULL;}stat(s, ALLOC_SLAB);if (kmem_cache_debug(s)) {freelist = alloc_single_from_new_slab(s, slab, orig_size);if (unlikely(!freelist))goto new_objects;if (s->flags & SLAB_STORE_USER)set_track(s, freelist, TRACK_ALLOC, addr,gfpflags & ~(__GFP_DIRECT_RECLAIM));return freelist;}/** 初始化新分配的 Slab。* 因为是全新分配的,没有其他 CPU 竞争,所以可以直接修改其属性,无需 cmpxchg。*/freelist = slab->freelist;slab->freelist = NULL;slab->inuse = slab->objects;slab->frozen = 1; /* 设为冻结状态 */inc_slabs_node(s, slab_nid(slab), slab->objects);if (unlikely(!pfmemalloc_match(slab, gfpflags))) {deactivate_slab(s, slab, get_freepointer(s, freelist));return freelist;}retry_load_slab:/** [步骤 8] 将新获取或新分配的 Slab 绑定到当前 CPU 的 c->slab。* 绑定前,如果发现当前 CPU 又被绑定了新的 slab(可能在释放锁期间被中断处理程序填充),* 则需要先将那个 slab 钝化。*/local_lock_irqsave(&s->cpu_slab->lock, flags);if (unlikely(c->slab)) {void *flush_freelist = c->freelist;struct slab *flush_slab = c->slab;c->slab = NULL;c->freelist = NULL;c->tid = next_tid(c->tid);local_unlock_irqrestore(&s->cpu_slab->lock, flags);deactivate_slab(s, flush_slab, flush_freelist); /* 钝化冲突的 Slab */stat(s, CPUSLAB_FLUSH);goto retry_load_slab;}/* 成功绑定 */c->slab = slab;goto load_freelist;}
💡 核心设计哲学解析:何为 "Slab 冻结 (Freeze)"?
在 ___slab_alloc 中,频繁出现 frozen 状态的操作。这是 SLUB 区别于传统 SLAB 的精妙之处:
未冻结状态(Unfrozen):Slab 处于全局共享池中(如 Node 的 Partial 链表)。任何 CPU 都可以从中分配或释放对象,但必须通过
n->list_lock自旋锁或复杂的cmpxchg_double来保证原子性。已冻结状态(Frozen):当一个 Slab 被
___slab_alloc选中并绑定到某个 CPU 的c->slab时,它会被标记为frozen = 1。此时,只有该 CPU 拥有从该 Slab 分配对象的权力。跨核释放的处理:如果 CPU-A 占有了 Slab-X(处于 Frozen 状态),而 CPU-B 此时释放了一个属于 Slab-X 的对象,CPU-B 发现该 Slab 是 Frozen 的,它不会将对象放回
slab->freelist,而是将其挂在slab->freelist的一个临时并发链表上。当 CPU-A 最终用完该 Slab 并执行deactivate_slab(解冻)时,才会统一合并这些跨核释放的对象。这种设计极大地减少了多核之间的 Cache Line 冲突和锁竞争。
4. ⚙️ 系统运行背景与上下文
___slab_alloc 绝非孤立运行,它处于 Linux 内核三大核心子系统(内存、调度、中断)的交汇处。
+-------------------------------------------------------------------+| ProcessScheduler (调度器) || - 维护进程上下文、抢占状态 || - 提供抢占/重调度感知 (TID 机制) |+-----------------------------------+-------------------------------+|| 触发慢速路径 (Preempted / TID mismatch)v+-----------------------------------+-------------------------------+| MemoryManagement (SLUB 分配器) || - ___slab_alloc 控制核心 || - 维护 CPU 本地缓存 (c->slab) 与 Node 局部链表 |+-----------------+---------------------------------+---------------+| || 物理页框申请 (new_slab) | 关中断保护 (local_lock)v v+-----------------+-----------------+ +-------------+---------------+| MemoryManagement (Buddy System) | | Interrupts (中断子系统)|| - 伙伴系统页分配器 | | - 避免中断嵌套重入导致死锁 |+-----------------------------------+ +-----------------------------+
1. 与 ProcessScheduler (进程调度器) 的协同
在快速路径中,SLUB 使用 c->tid(事务 ID)来检测抢占。tid 是一个单调递增的数值。如果一个进程在执行 this_cpu_cmpxchg 前被调度器抢占,并迁移到了另一个 CPU,当它迁回并恢复执行时,this_cpu_cmpxchg 会因为 tid 不匹配而失败,从而安全地退入 ___slab_alloc。 在 ___slab_alloc 内部,一旦需要调用 new_slab 向伙伴系统申请新页,由于该操作可能会因为内存回收而发生阻塞(Sleep),代码会显式调用 slub_put_cpu_ptr 释放当前 CPU 引用,允许调度器自由调度该线程。
2. 与 Interrupts (中断子系统) 的协同
内核申请内存可能发生在硬中断或软中断上下文中(例如网卡驱动收到数据包时调用 dev_alloc_skb)。 为了防止中断处理程序与被中断的进程并发修改同一个 CPU 的 c->slab 导致数据损坏,___slab_alloc 在修改 c->freelist 和 c->slab 时,必须调用 local_lock_irqsave。这在非 RT 内核下会直接翻译为关中断(Disable IRQ),确保了临界区绝对的排他性。
3. 与 NUMA 架构的协同
在多路服务器上,跨 NUMA 节点访问内存会带来巨大的延迟惩罚(QPI/UPI 总线瓶颈)。___slab_alloc 具有极强的 NUMA 亲和性感知:
优先校验当前 CPU 绑定的
slab是否属于当前运行的 NUMA 节点(node_match)。如果不匹配,宁可放弃当前高效的本地 Slab(将其
deactivate),也要跨越到目标节点的 Partial 链表中寻找物理距离更近的内存。
5. 💡 10年老兵避坑指南/实战案例
在超大规模高并发的生产环境中,SLUB 分配器的慢速路径往往是性能瓶颈和系统不稳定的高发区。以下整理了两个经典的实战案例及排查调优方案。
案例一:高并发下 Node Partial 锁严重自旋,导致 CPU 暴涨
1. 现象描述
在一台 128 核的双路 AMD EPYC 服务器上,运行高并发的 Nginx 或 Redis 业务时,系统响应时间(Latency)偶尔出现剧烈抖动。通过 perf top 观察,发现一个热点函数高居榜首:
92.5% [kernel] [k] _raw_spin_lock|+-- _raw_spin_lock|+-- get_partial+-- ___slab_alloc+-- kmem_cache_alloc
同时,/proc/slabinfo 显示某些小对象的 shared 数量极高。
2. 原因剖析
当本地 CPU 的 freelist 和 cpu_partial 链表全部枯竭时,多个 CPU 会同时涌入 ___slab_alloc 的 new_objects 阶段,尝试从 Node 级别的 Partial 链表中获取 Slab。 此时,它们必须争抢 Node 级别的全局自旋锁 n->list_lock。在 128 核的超高并发下,这个全局锁成为了严重的物理瓶颈,导致大量 CPU 核心在 _raw_spin_lock 上处于忙等自旋状态,造成 CPU 使用率虚高,系统吞吐量骤降。
3. 调优与排查方案
排查工具:使用
ftrace追踪get_partial的耗时。echo function_graph > /sys/kernel/debug/tracing/current_tracerecho get_partial > /sys/kernel/debug/tracing/set_ftrace_filtercat /sys/kernel/debug/tracing/trace | head -n 20
调优手段 1:增大 CPU Partial 缓存容量 通过增大每个 CPU 缓存的未满 Slab 数量,减少其向 Node 级别全局锁索取 Slab 的频率。
# 针对 kmalloc-512 提高其 cpu_partial 阈值(默认可能为 30)echo 80 > /sys/kernel/slab/kmalloc-512/cpu_partial
调优手段 2:开启 NUMA 自动平衡或绑定 CPU 使用
numactl --localalloc或将高并发线程绑定在单路 NUMA 节点内,避免跨节点的内存分配触发ALLOC_NODE_MISMATCH。
案例二:频繁触发 "Deactivate Bypass" 导致内存碎片化与 OOM
1. 现象描述
某分布式存储系统在长时间运行后,系统物理内存逐渐耗尽,最终触发 OOM Killer。然而,通过 free -m 观察,伙伴系统的 Free 内存确实很少,但通过 slabtop 观察,Slab 占用的总内存也并不算极大,存在大量“幽灵碎片”。
2. 原因剖析
在 ___slab_alloc 中,有这样一段逻辑:
freelist = get_freelist(s, slab);if (!freelist) {c->slab = NULL;...stat(s, DEACTIVATE_BYPASS);goto new_slab;}
如果一个 Slab 中的对象被频繁地“交替申请与释放”(例如:A 申请,B 释放,跨核操作),会导致该 Slab 频繁在 Frozen 和 Unfrozen 状态间切换。 当触发 DEACTIVATE_BYPASS 时,SLUB 会直接绕过当前 CPU 缓存,将该 Slab 钝化并放回 Node Partial。如果此时伴随着不合理的 gfpflags(如频繁使用 GFP_ATOMIC 且限制了内存回收),SLUB 就会不断向伙伴系统申请新页(new_slab),而老页中由于残留了极少数未释放的长生存周期对象,导致整页无法被伙伴系统回收,造成严重的内存碎片化。
3. 诊断与解决
诊断工具:监控
/proc/slabinfo中的active_objs与num_objs的比例。如果比例低于 30%,说明碎片化极其严重。使用
slabinfo工具分析: 内核源码自带了tools/mm/slabinfo工具,编译后运行:./slabinfo -v -D kmalloc-256重点关注
Deactivate Bypass和Slabs per Node的比例。
解决方案:
合并小对象:优化业务代码,避免频繁申请极小生命周期的内存对象,改用对象池(Object Pool)。
调整
slub_max_order:在内核启动参数中加入slub_max_order=0或1,限制单个 Slab 的物理页阶数,防止大块连续物理内存被碎片化蚕食。主动收缩 Slab 缓存:在系统空闲时,可以通过写入 sysfs 强制触发 SLUB 的收缩与合并:
echo 1 > /sys/kernel/slab/kmalloc-256/shrink
6. 总结
___slab_alloc 是 Linux 内核内存管理中极具工业美感的设计。它通过无锁快速路径与多级锁退化慢速路径的完美结合,既保证了单核情况下的极致分配性能,又兼顾了多核、多路 NUMA 架构下的并发安全与拓扑亲和性。理解其内部的“冻结”、“钝化”以及“多级回溯”机制,是进行内核级性能调优与高并发系统架构设计的必修课。