ARTICLE · 1111824
大模型时代智能文档 Benchmark 落地实践:从评测设计到数据合成
导读本文整理自刘青在 DataFun Agentic AI Summit 2026 上的分享。阿里巴巴企业智能算法智能团队围绕智能文档 Benchmark 的构建与落地,介绍了文档智能的核心任务与技术架构、企业场景下的评测设计、难例挖掘与场景感知文档合成,以及 CC-OCR V2、MMM-Bench、UniKIE-Bench、DocScope 四个 Benchmark 的实践与后续规划。
主要内容包括以下几个部分:
1. 文档为什么难:四大核心任务与三类生产挑战
2. Benchmark 怎么搭:真实数据、难例挖掘与文档合成
3. 四套 Benchmark 怎么测:从 OCR、分类到抽取与长文档问答
4. 评测之后:从维度扩展到平台化与开源共建
分享嘉宾|刘青 阿里巴巴 企业智能高级算法工程师
内容校对|韩珊珊
出品社区|DataFun
文档为什么难:四大核心任务与三类生产挑战
文档——可信企业流程的基石
理解文档,是自动化企业流程的第一步。企业里的文档并不是孤立文件,而是业务流程、法律合规以及身份与资质可信性的载体。采购流程里,合同、订单、对账单、发票串起交易闭环;法律场景中,主合同、补充协议、起诉状、传票、调解书承担权利义务和流程追溯;身份证、护照、学历证书、营业执照、开户许可证等,则用于证明个人或企业主体的可信性。
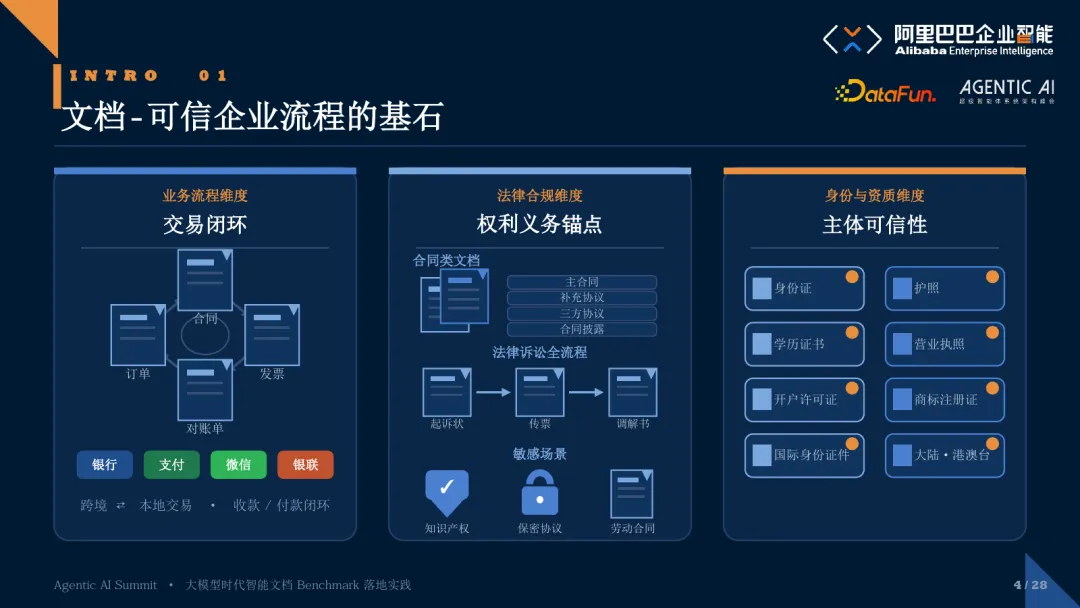
图1|文档是可信企业流程的基石:交易闭环、法律合规与主体可信性
文档智能整体技术架构
整体架构从企业业务域出发。人、财、法、事、物、场等业务不断产生文档,最终沉淀为文档湖,Benchmark 从中筛选高价值文档和高难度问题,用于评估模型能力。能力层主要包括文档解析、文档分类、要素抽取和文档问答。解析负责把原始文档转成可读、可处理的结构化内容;分类依托统一文档类目体系确定文档类型;要素抽取基于标准 Schema 获取关键实体,并通过同一实体把不同文档连接起来,形成文档网络 DocNet;上层再服务于审单、文件审查、采购风控、简历抽取、审计、文档检索和文档问答等应用。
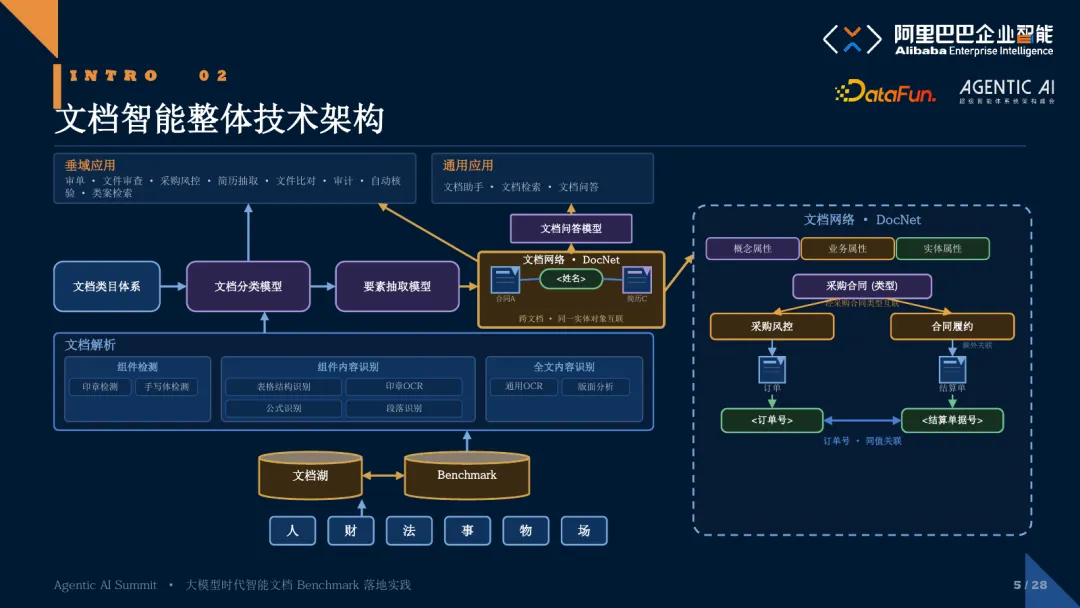
图2|文档智能整体技术架构:从业务域到文档湖、Benchmark 与应用层
四大核心任务与三大核心挑战
对应到评测,核心任务包括文档解析、文档分类、关键信息抽取和智能问答,其中信息抽取还需要 Grounding,让抽取结果能够回到原文位置,满足企业场景对可追溯性的要求。真正困难的地方,一是来源复杂,既有扫描、拍照,也有电子 PDF 和网页;二是版式多样,同为表单、合同或报告,布局可能完全不同;三是结构差异明显,同类文档的字段定义也不一致。因此,单一维度测试很难反映真实生产环境里的表现。
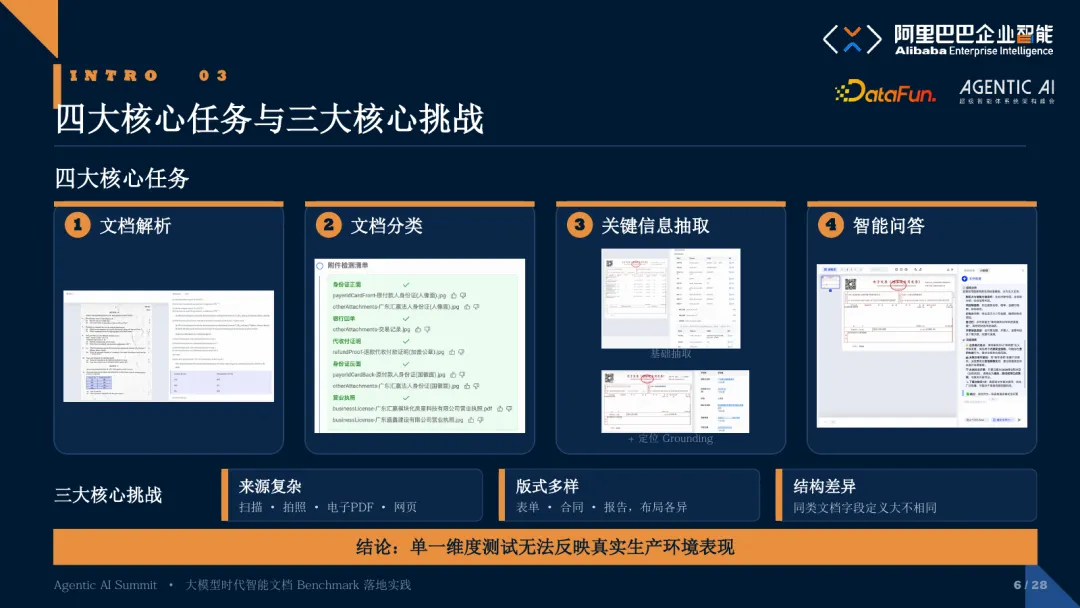
图3|四大核心任务与三大核心挑战
Benchmark 怎么搭:真实数据、难例挖掘与文档合成
设计思路与原则
Benchmark 的设计遵循三个原则:全域覆盖、全任务覆盖和分层建模。既要覆盖企业核心业务场景,也要覆盖解析、分类、抽取、问答全链路任务,还要把样本按难度拆开。简单样本上,不同模型往往拉不开差距;真正有指导意义的,是能持续暴露模型能力边界的 Hard Case 和 Corner Case。落地上则分为四步:沉淀高价值文档,统一数据与指标,建设标准化自动评测平台,再把可脱敏的数据和评测工具开放出来。
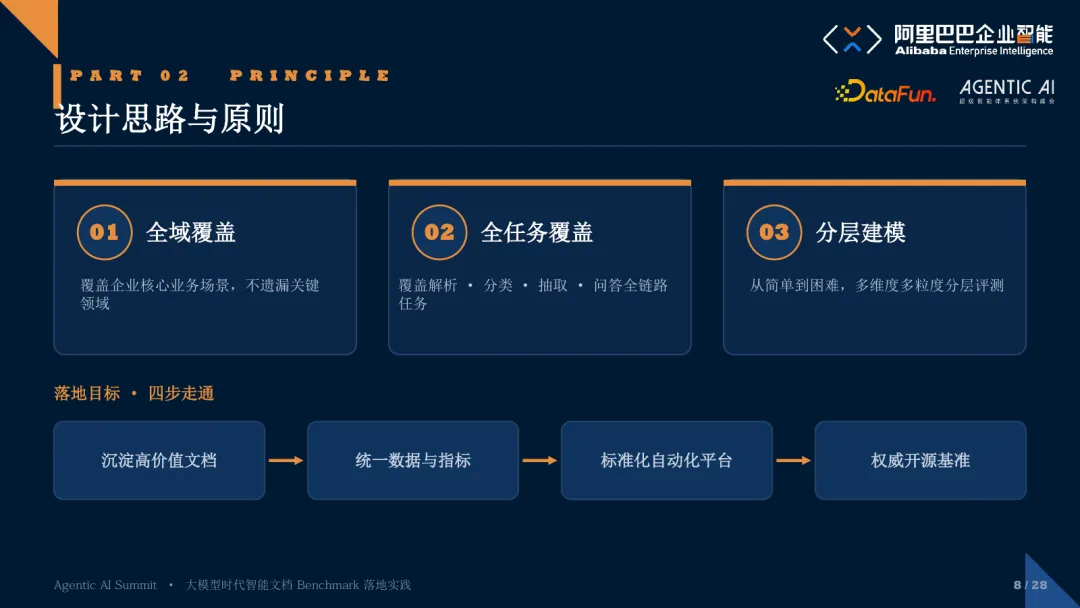
图4|Benchmark 的三条设计原则与落地四步
构建方式·数据采集三管齐下
数据主要来自三条管线。第一条是企业内部真实业务文档,覆盖阿里 60+ 个核心业务域、近百万份真实文档,脱敏后进入评测体系;第二条是公开数据集整合再标注,对已有数据中的错误和缺漏标注重新整理;第三条是生产系统错误样本回收,把真实部署中的失败用例和边界 Case 持续带回 Benchmark。第三类样本尤其重要,因为它们直接对应当前系统尚未解决的问题。
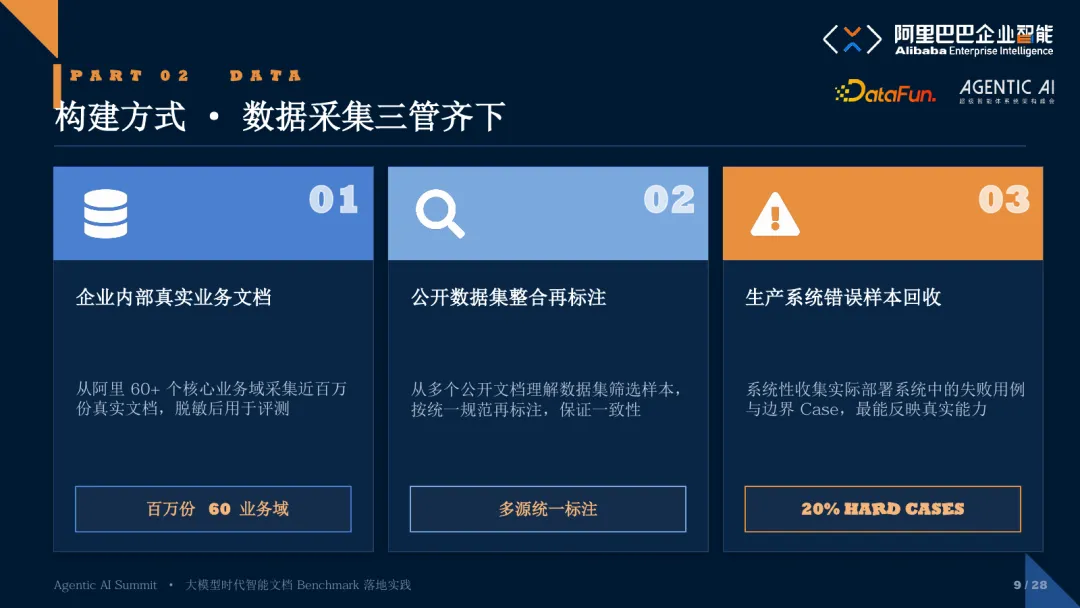
图5|数据采集三管齐下:内部真实文档、公开数据集再标注与生产错误样本回收
构建方式·错误归因驱动的难例挖掘
拿到 Bad Case 还不够,还需要知道为什么错。团队为 Recognition、Parsing、Grounding、Extraction、QA 分别维护错误归因:识别可能受低质量图像、形变字体、密集小字和手写体影响;解析会遇到表格嵌套、跨页结构和图文混排;Grounding 可能发生字段与区域错配;抽取会出现 Schema 语义混淆、隐含字段和跨语言问题;问答则涉及多跳推理、证据聚合、答案验证和长上下文遗忘。失败样本经过归因后,再定向补充 Hard Case 与 Corner Case,并回流评测集,形成“评测—归因—补样”的迭代闭环。
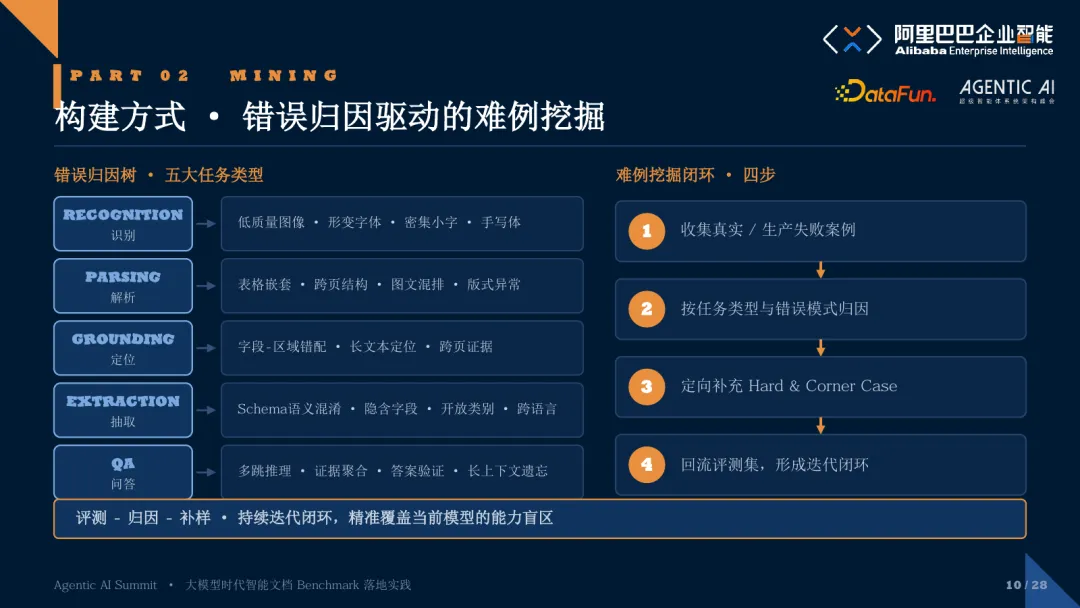
图6|错误归因驱动的难例挖掘:五类任务归因树与四步闭环
文档合成框架 SAYRE·场景感知文档合成
仅靠人工补样很难覆盖长尾,因此团队提出 SAYRE 场景感知文档合成框架。Path A 是通用生成:给定少量示例文档,由内容感知和版面感知两个 Agent 分析文档,抽取内容要素和布局结构,形成 Doc-Schema-Anno Triple,再渲染为新的文档图像。Path B 从 Failure Case 出发,先提取 HTML Template 和版式结构,再对内容进行重写并重新标注,生成与错误场景相似、但内容更丰富的困难训练样本。整个过程不依赖手工模板,能够按场景扩展并覆盖更多长尾问题。
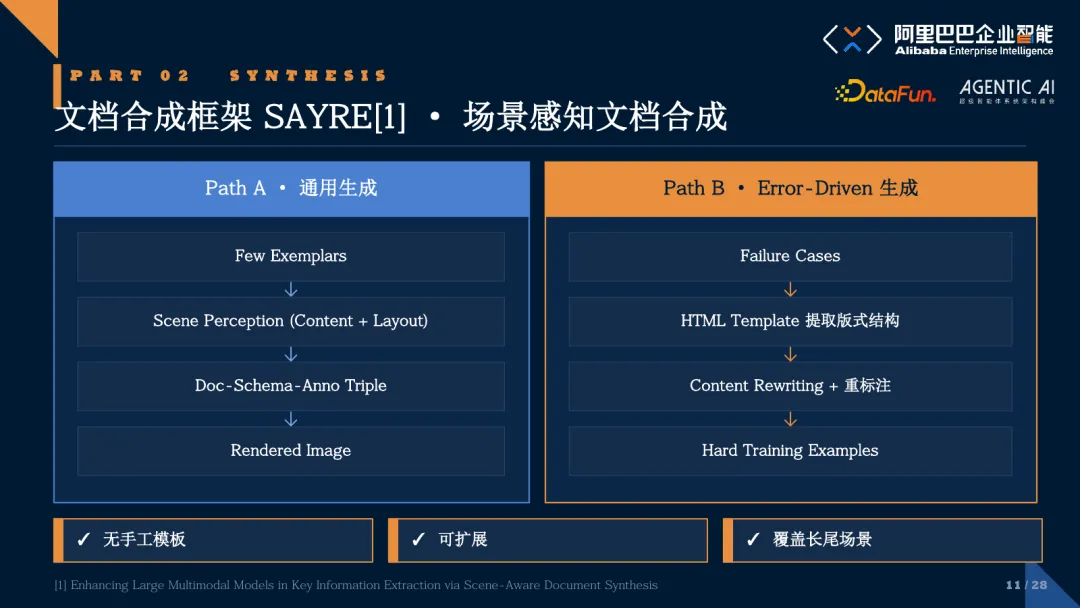
图7|SAYRE 文档合成框架:Path A 通用生成与 Path B Error-Driven 生成
SAYRE 实验效果·数据质量与模型规模
基于合成数据训练的 Sayre-2B 超过同规模开源模型,4B 模型已接近商用模型水平。随着合成数据量增加,性能仍持续上升,没有看到明显饱和;Error-Driven 链路也提高了多个关键字段的错误解决率。这里最重要的结论是:在文档模型训练里,数据质量与覆盖率和模型规模同样重要,合成数据可以成为缩小端侧模型与云端大模型差距的一条路径。
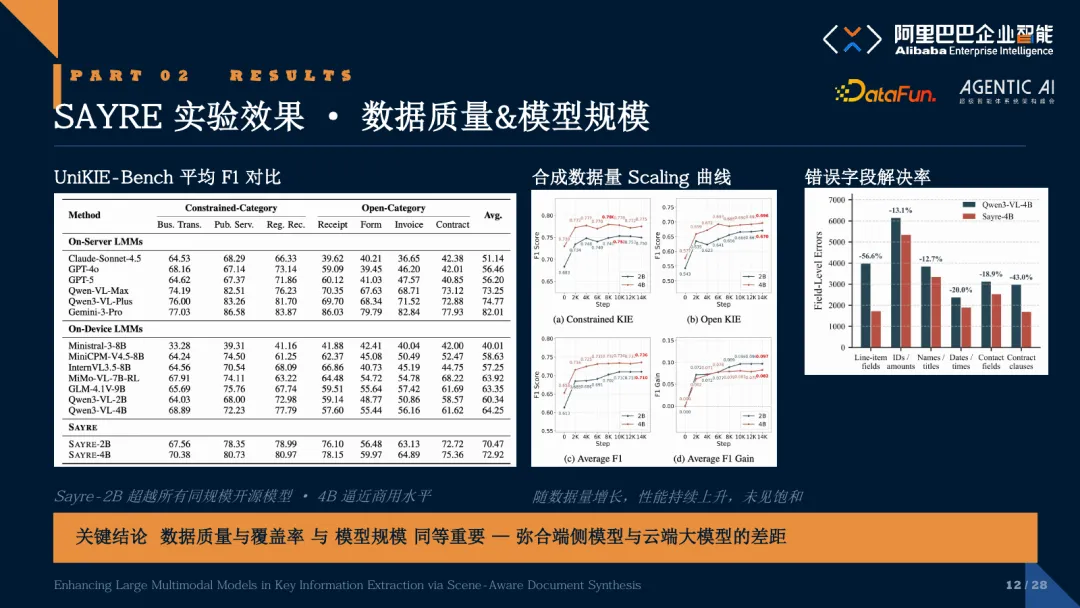
图8|SAYRE 实验效果:平均 F1 对比、数据量 Scaling 曲线与错误字段解决率
四套 Benchmark 怎么测:从 OCR、分类到抽取与长文档问答
目前已经形成四个互补的 Benchmark:CC-OCR V2 面向企业困难样本的综合文档评测,MMM-Bench 评估多模态、多层级文档分类,UniKIE-Bench 面向开放域信息抽取,DocScope 则关注长文档可验证推理问答。
CC-OCR V2·企业困难样本文档智能综合评测
CC-OCR V2 覆盖 Recognition、Parsing、Grounding、Extraction、QA 五大 Track,共 7,093 个高难度样本、74 个细分场景和 32 种语言,其中包含 20% 未公开生产困难样本,并对已有数据补充了 48% 的标注。五个任务放在同一套基准里之后,模型的强弱不再能用一个平均分概括。
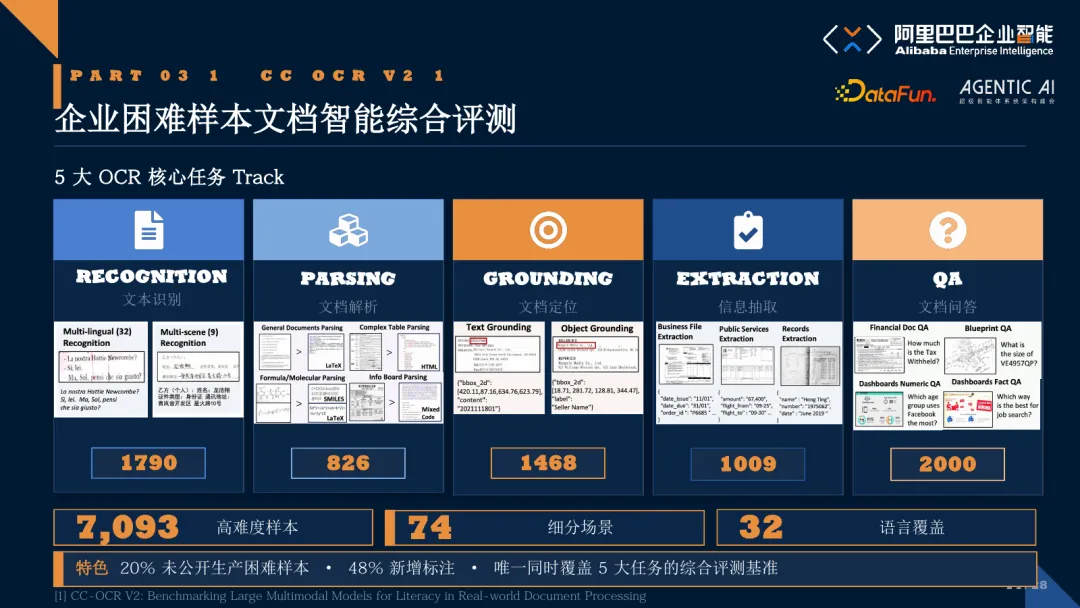
图9|CC-OCR V2:五大 Track 与 7,093 个高难度样本
评测中,Qwen3.6-Plus 综合表现最好,Gemini 3.1 Pro 在识别和提取上更强,Kimi K2.5 在解析和问答上表现更好。Grounding 是最明显的短板,SOTA 仅 65.73,多数模型低于 50;识别、问答与 Grounding、Extraction 之间也存在明显不平衡。
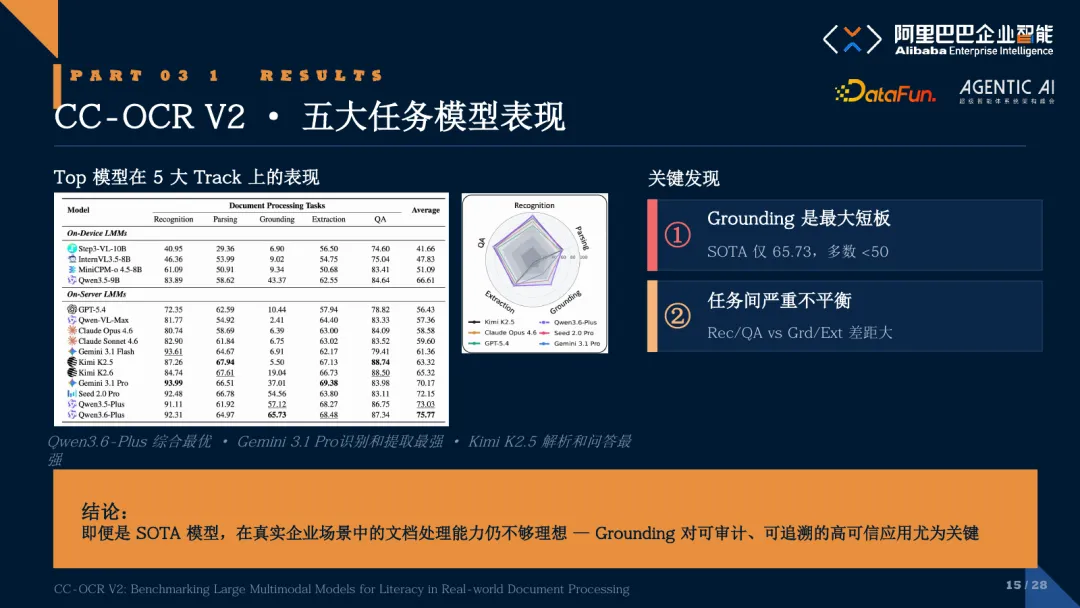
图10|CC-OCR V2 五大任务的模型表现
继续按文档类型拆分,Books、Reports 这类规则布局、文字清晰的文档更容易,而 Receipts、Handwriting 等密集布局、小字体、低质量或书写风格变化大的文档明显更难。平均分很容易把这些部署风险盖住。
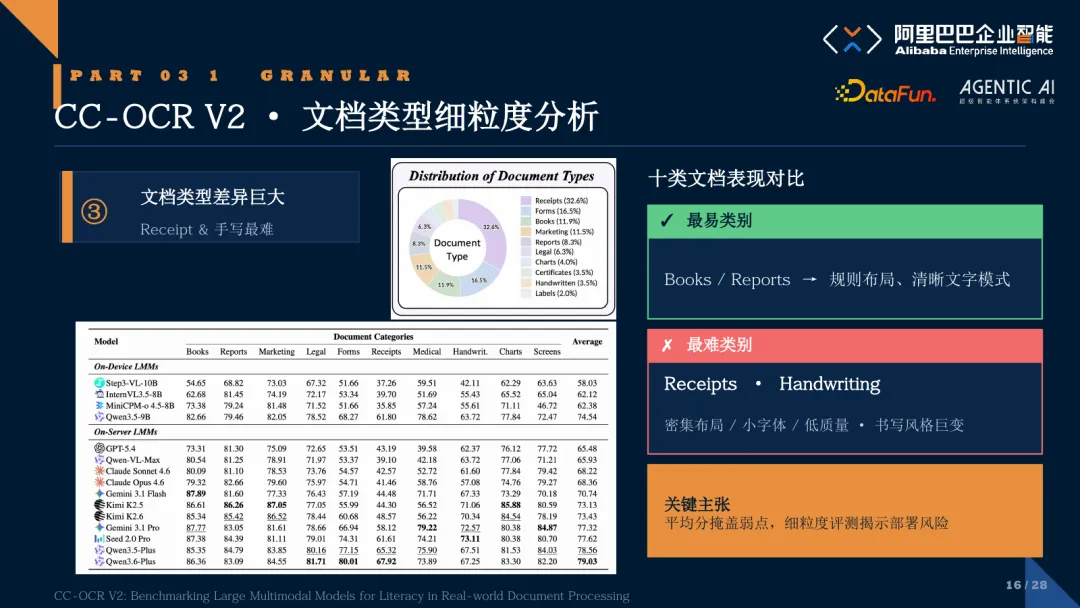
图11|CC-OCR V2 文档类型细粒度分析
MMM-Bench·多模态多层级细粒度文档分类
MMM-Bench 构建了从 Business Function、Business Object、Business Stage、Business Form 到 Document Class 的五层分类体系,包含 5,990 份真实文档和 12 个业务域。
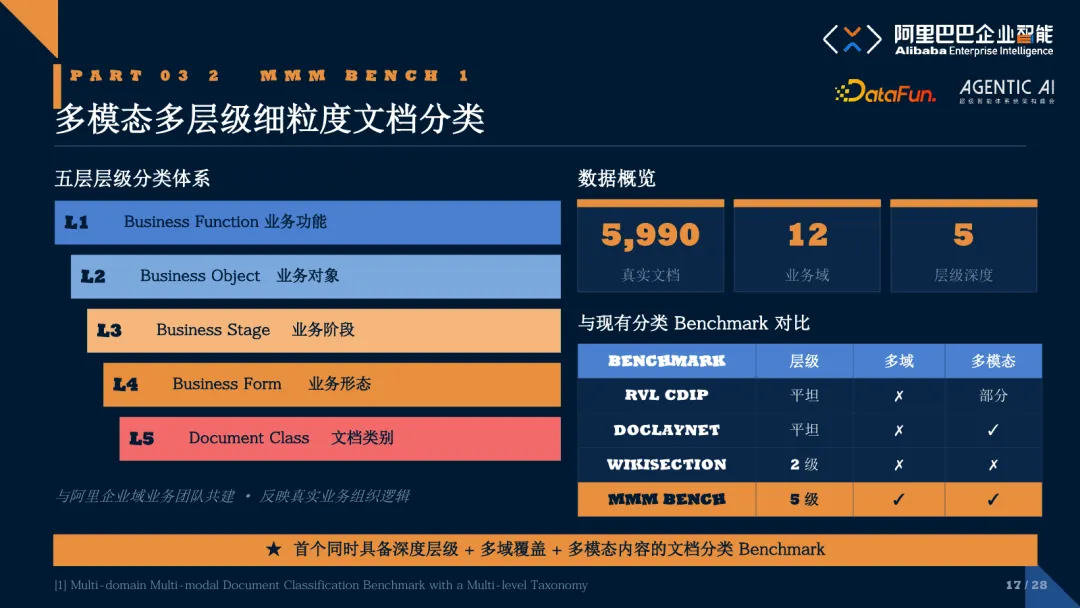
图12|MMM-Bench 的五层分类体系与数据概览
随着新业务进入,分类树也需要能够自己扩展:新文档先尝试挂载到已有树上;如果大量样本停在非叶子节点,说明现有类别还不够,需要聚类并扩展新的分支;如果某个叶子节点样本密度过高,则继续向更细粒度拆分。
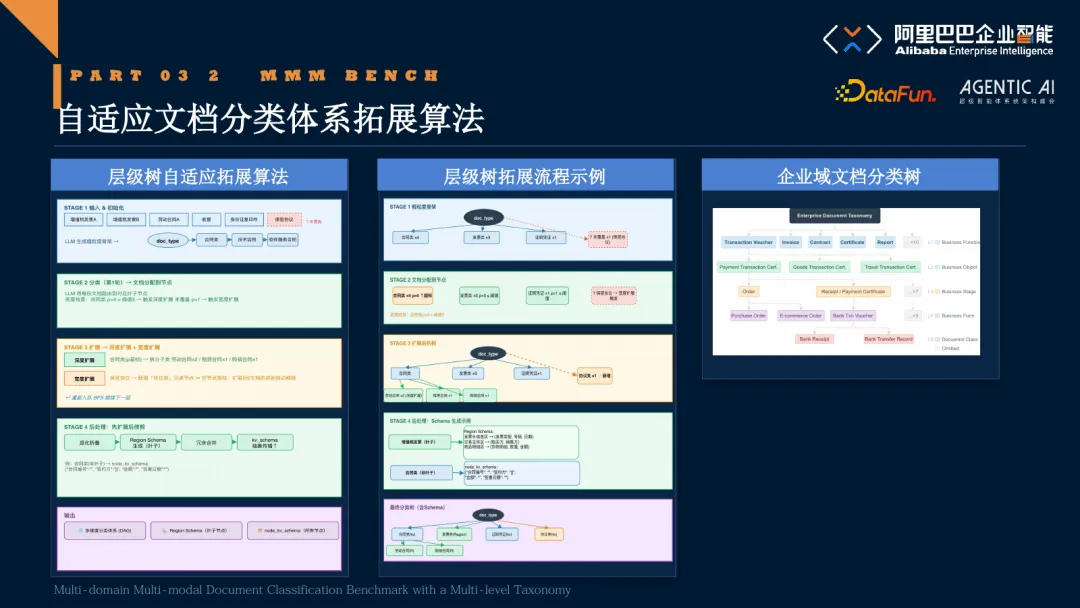
图13|自适应文档分类体系拓展算法
这套分类任务暴露出四类问题。层级越深,语义区分越细,准确率从 L1 的 95%+ 降到 L5 的 60%—70%;不同领域差异明显,结构化程度更高的 Legal 表现好于 Marketing;多模态并不天然带来提升,纯文本甚至可能优于“文本+图像+布局”,说明现有模型的模态融合仍不足;长尾样本同样拖累整体性能,头部类别与尾部类别的表现差距明显。
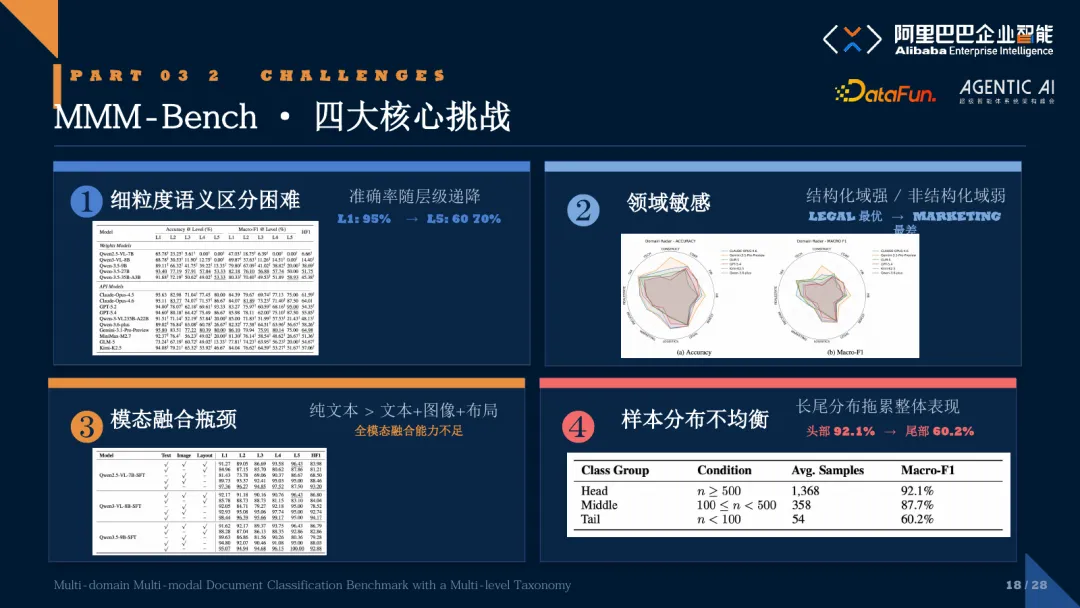
图14|MMM-Bench 的四大核心挑战
Schema-Guided 统一评测范式与 UniKIE-Bench
传统 KIE 往往按 Key 逐字段问答,每个字段独立推理,难以保留字段之间的结构关系。团队改为 Schema-Guided:输入文档图像和抽取 Schema,一次推理输出完整结构化键值对。
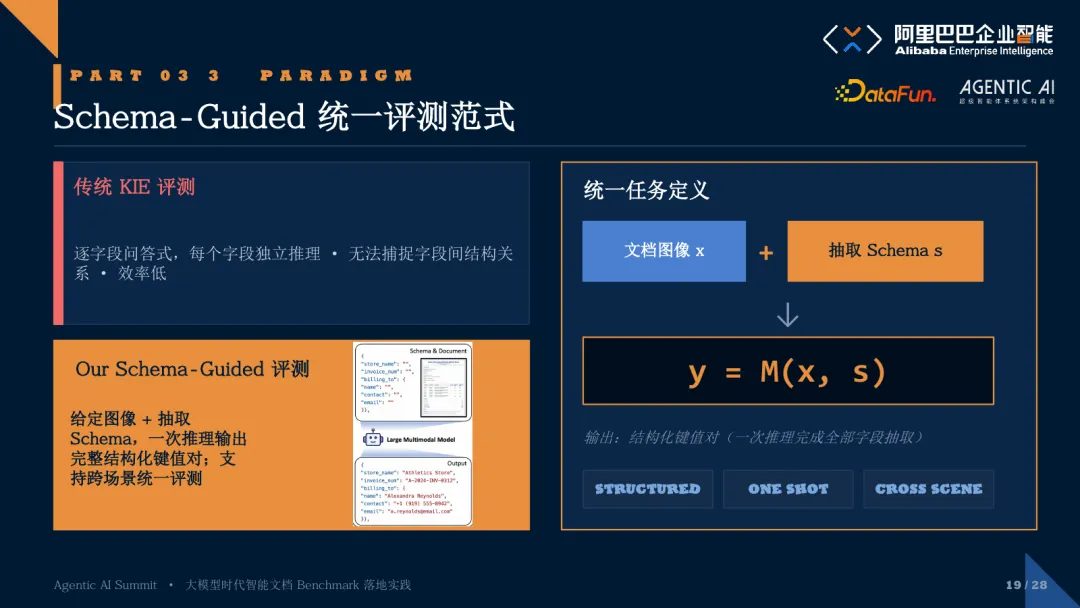
图15|Schema-Guided 统一评测范式
UniKIE-Bench 在此基础上设计两条 Track。Constrained-Category KIE 为预定义场景使用固定 Schema;Open-Category KIE 不预设场景,而是要求模型抽取文档中的显式关键信息。整个 Benchmark 覆盖 3 个领域、11 个场景、6,133 个样本。
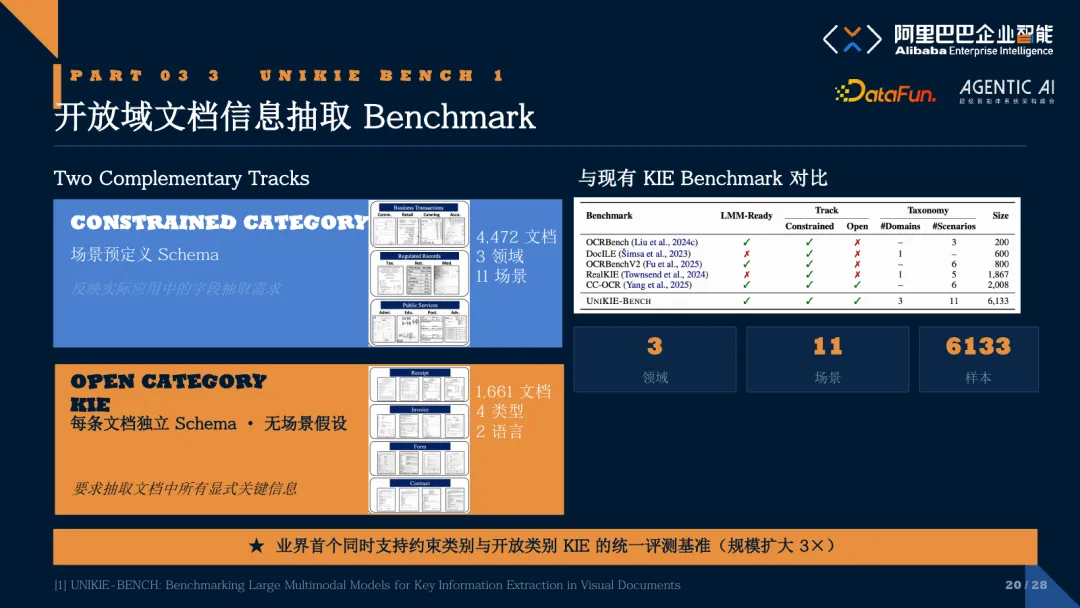
图16|UniKIE-Bench 的两条 Track 与现有 KIE Benchmark 对比
实验显示,Open-Category Track 上闭源与开源模型仍有明显差距,Gemini-3-Pro 为 81.65,Qwen3-VL-8B 为 67.36。不同文档类型也差异很大:Form 因碎片化布局和灵活字段边界最难,Receipt 因布局较规则、键值明确相对容易;几乎所有模型在英文文档上的表现也显著优于中文文档。
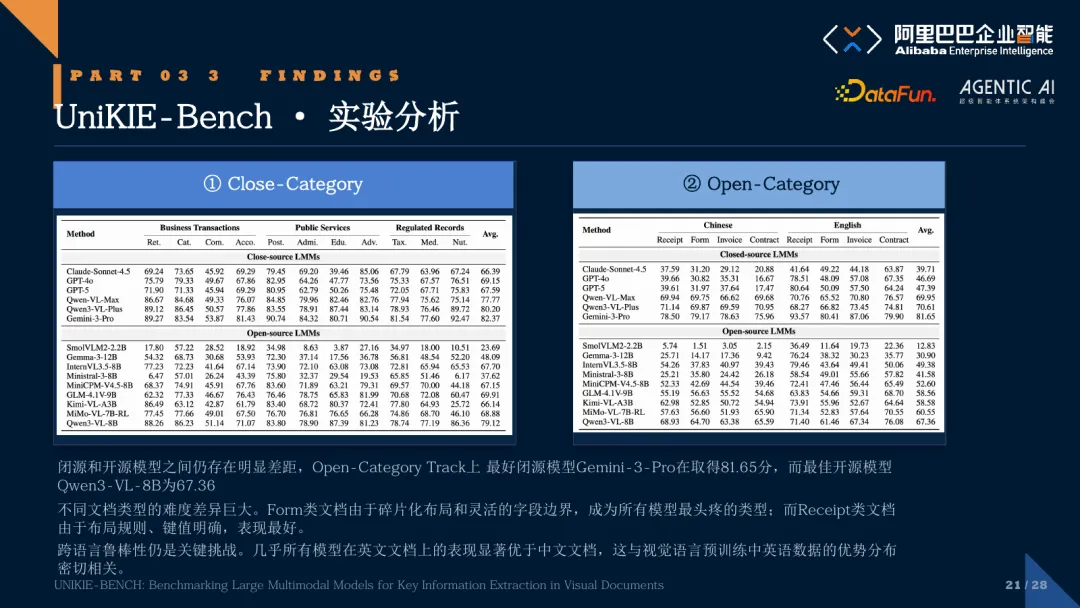
图17|UniKIE-Bench 实验分析:Close-Category 与 Open-Category
进一步看错误,可以归为视觉感知失败、布局感知失败和语义理解失败三类。信息抽取并不是“看见文字”就结束,而是感知、布局关联和语义理解共同决定最终结果。
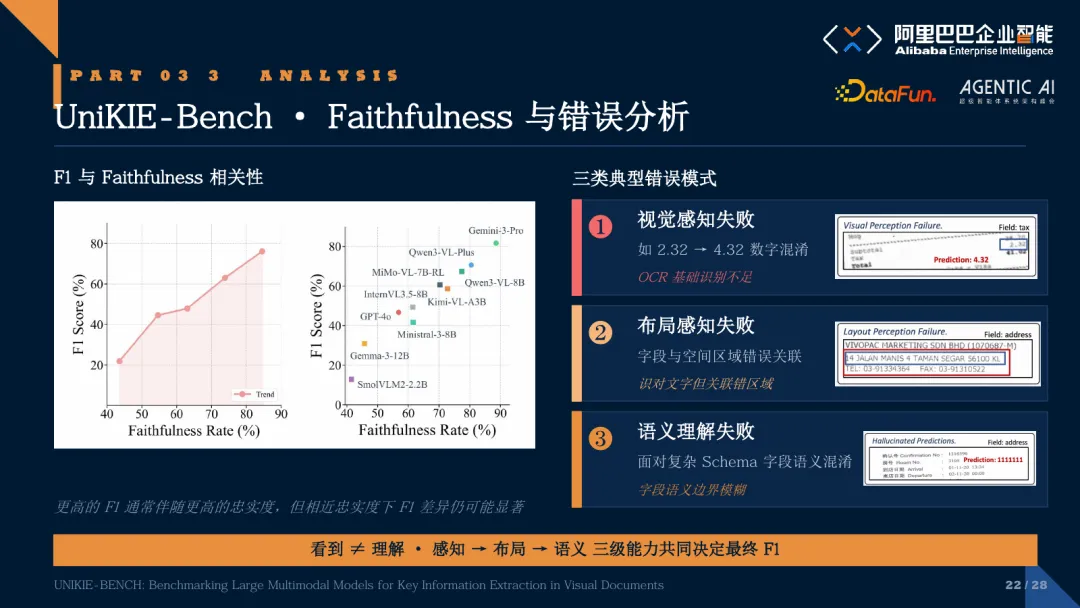
图18|UniKIE-Bench 的忠实度相关性与三类典型错误模式
DocScope·长文档可验证推理问答
DocScope 把评测从“答案对不对”推进到“证据链是否完整”。任务需要模型在长文档中依次完成 Page Location、Region Grounding、Fact Extraction 和 Answer Generation。数据集包含来自 273 份文档的 1,124 个问题,平均每份文档 51.3 页,并要求输出完整、可验证的推理轨迹。
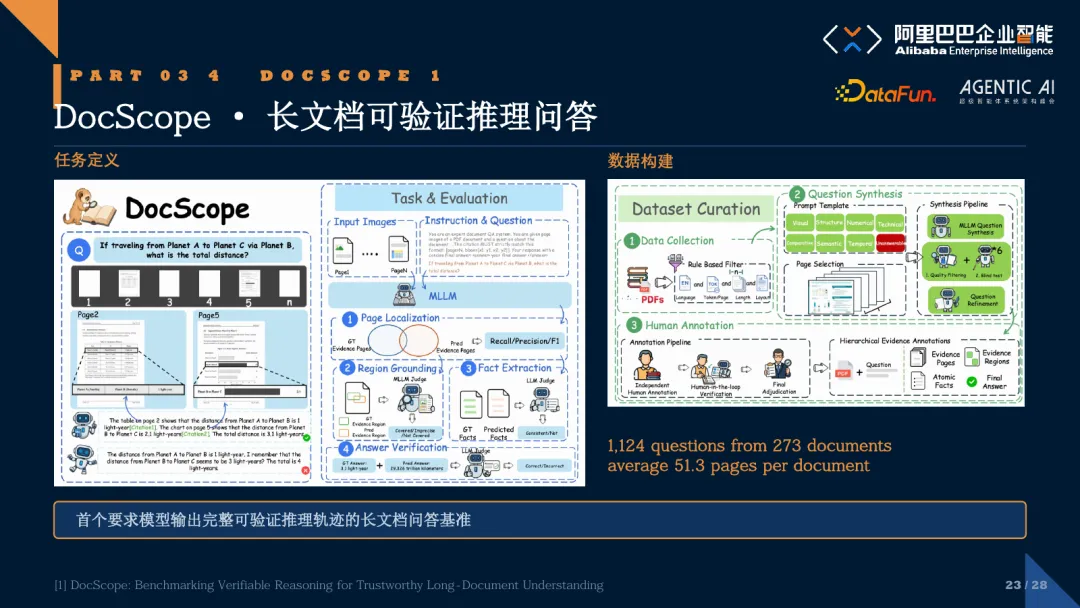
图19|DocScope 的任务定义与数据构建
最直接的结果是,答案准确率并不等于推理可信度:在答案正确的样本里,完整证据链的最高通过率只有 29%。对长文档难度继续拆分后,真正稳定拉低准确率的并不是文档长度或证据数量本身,而是证据在多页之间的跨度和散布方式。另一方面,为文档专门设计的框架也不一定优于通用大模型,基础视觉—语言能力仍然是当前长文档理解的重要上限。
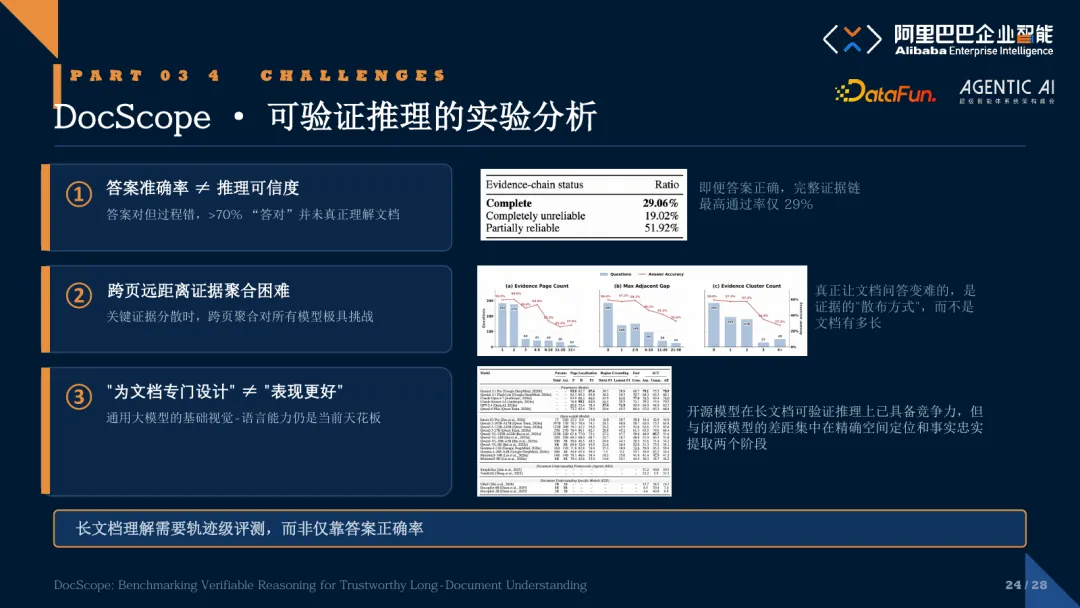
图20|DocScope 可验证推理的实验分析
评测之后:从维度扩展到平台化与开源共建
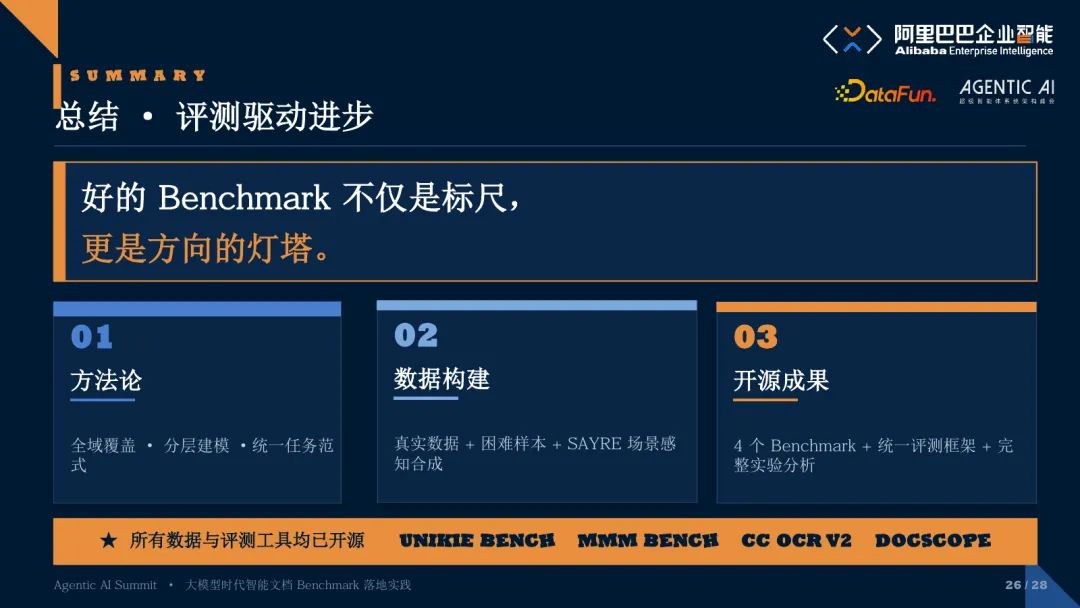
这套实践最终沉淀为一套方法:用全域覆盖、分层建模和统一任务范式设计评测;把真实数据、困难样本与 SAYRE 场景感知合成结合起来构建数据;再通过 CC-OCR V2、MMM-Bench、UniKIE-Bench、DocScope 和统一评测工具持续分析模型能力。目前四个 Benchmark 的数据与评测工具均已开源。
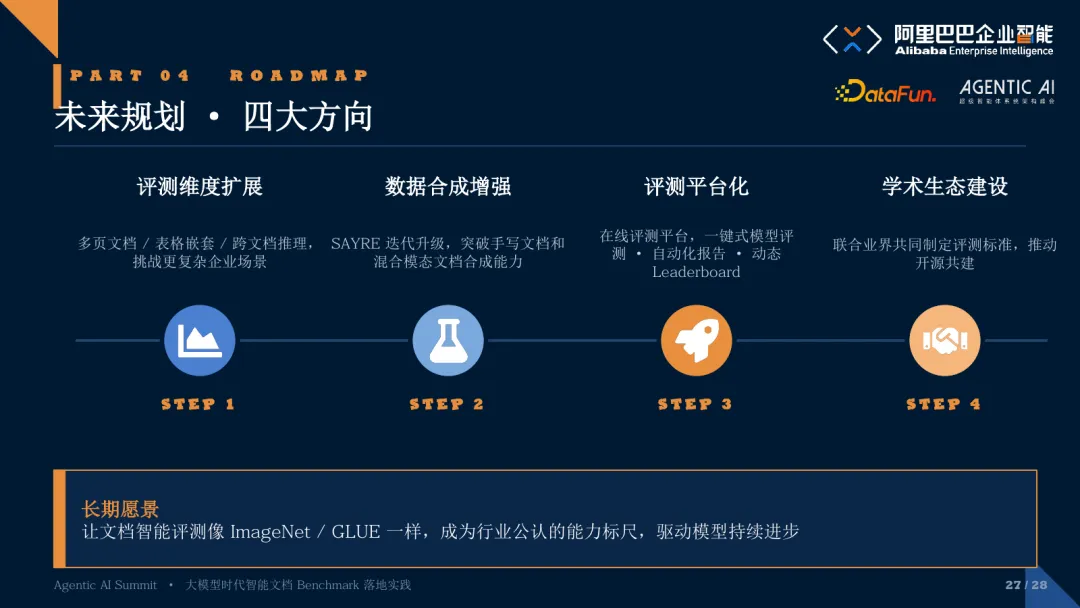
下一步有四个方向:继续扩展多页文档、表格嵌套和跨文档推理等评测维度;升级 SAYRE,补足手写文档和混合模态文档合成;推进在线评测平台,实现一键模型评测、自动化报告和动态 Leaderboard;同时与业界共同推进评测标准和开源共建。好的 Benchmark 不只是给模型一个分数,更重要的是把问题拆细,让下一步该补什么能力变得清楚。
以上就是本次分享的内容,谢谢大家。
分享嘉宾
INTRODUCTION

刘青

阿里巴巴

高级算法工程师

刘青,硕士毕业于哈尔滨工业大学(深圳)计算机科学与技术学院ICRC实验室,目前就职于阿里巴巴企业智能算法团队,主要从事多模态分类、智能文档方面工作。团队与通义实验室Qwen团队、智能引擎团队、东北大学IR实验室、清华大学NLP实验室合作,共同沉淀 UNIKIE-BENCH、MMM-BENCH、CC-OCR-V2 等多个智能文档抽取基准。
往期推荐

点个在看你最好看
