ARTICLE · 1112213
OpenAI最速模型连夜“换芯”?百亿独角兽暴跌,黄仁勋只回了一个眼神
每秒狂飙 300 个 token,代码生成快如闪电。
OpenAI 首席执行官山姆·奥特曼(Sam Altman)在社交平台上难掩兴奋,甚至留下了这样一句极具情绪煽动力的评价:“Ultrafast 实在是太快了,我这辈子都不想再用回原来的速度了。”
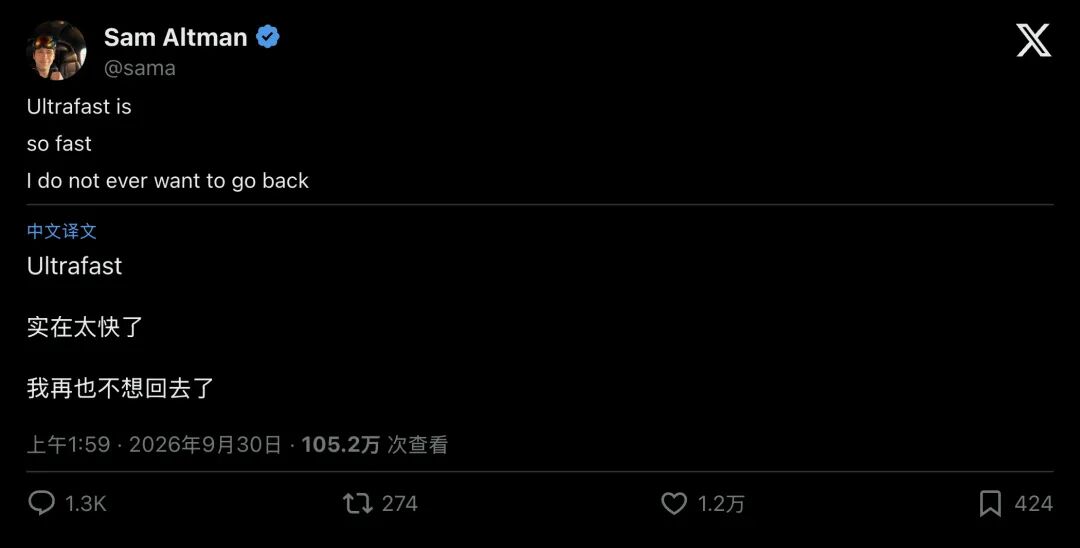
▲ 山姆·奥特曼发文盛赞 Ultrafast 的极致速度体验
这原本是 OpenAI 开发者大会(DevDay)周期里最耀眼的“极速狂欢”。
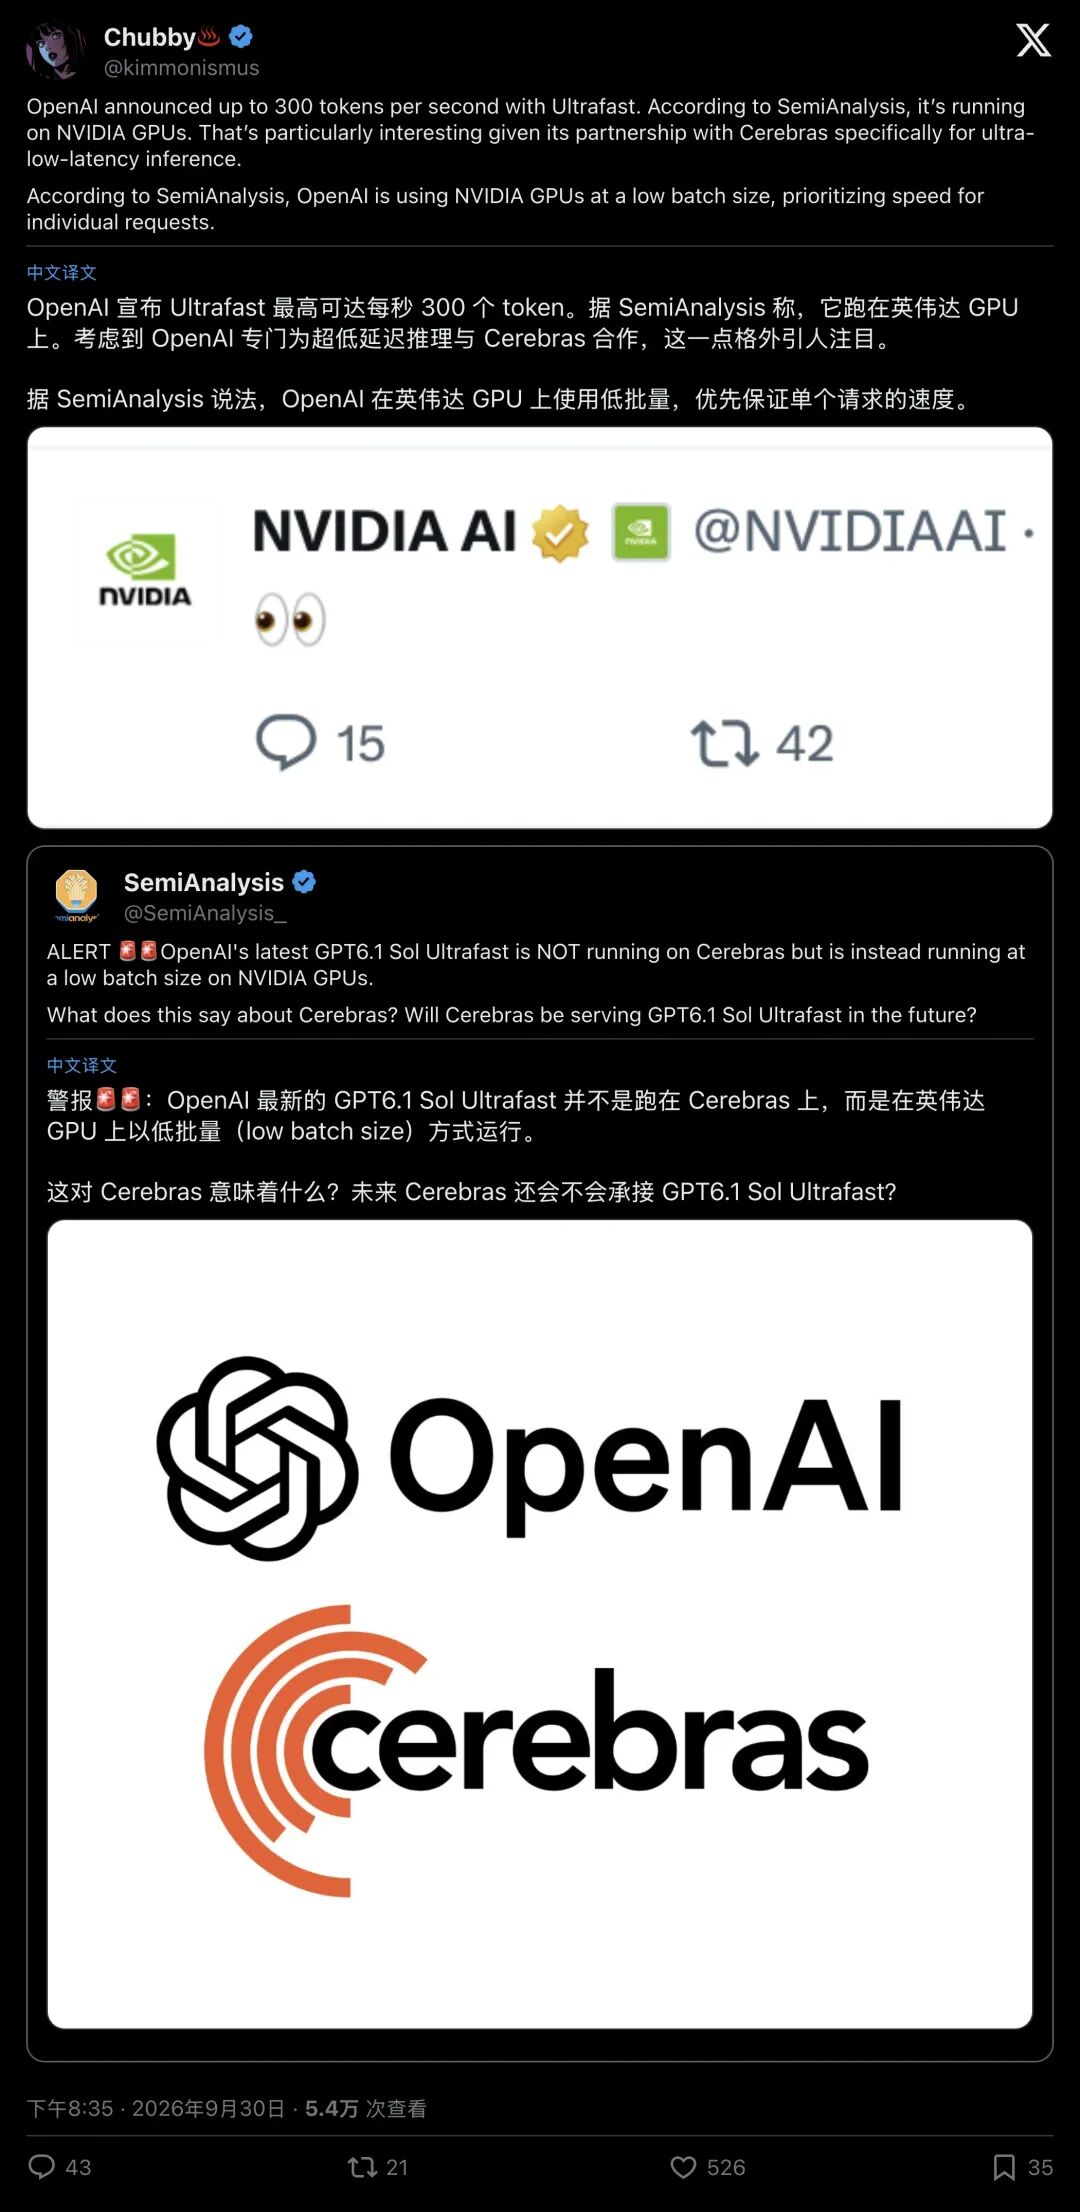
可就在所有人以为这又是一场属于专用 AI 芯片先锋 Cerebras 的重大胜利时,半导体行业智库 SemiAnalysis 突然公开发文披露:
“OpenAI 最新的 GPT-6.1 Sol Ultrafast 实际运行在英伟达(NVIDIA)的 GPU 上,并未采用 Cerebras,他们只是把批量(Batch Size)调到了极低!”
消息一出,硅谷与华尔街随之震动
曾经凭借“晶圆级超级芯片”拿下 OpenAI 订单的芯片独角兽 Cerebras 股价应声暴跌超 7%;而面对这场轩然大波,英伟达官方 AI 账号在爆料帖下方,只回复了一个表情符号:
“👀”
▲ 英伟达官方的一记“暗中观察”,迅速引发技术圈与资本市场热议
英伟达未做过多长篇辩解,只留下这双眼睛。
这一记眼神,揭开了大模型极速推理背后的商业与物理现实:所谓的“极致速度”,究竟源于芯片架构的突破,还是昂贵算力堆砌出的奢侈游戏?
01300字/秒!OpenAI把“极速”卖成奢侈品
先来看看 OpenAI 官方到底发布了什么。
在官方公布的技术演示中,Ultrafast 被定义为一种专门针对极低延迟场景打造的“高阶速度档位”。
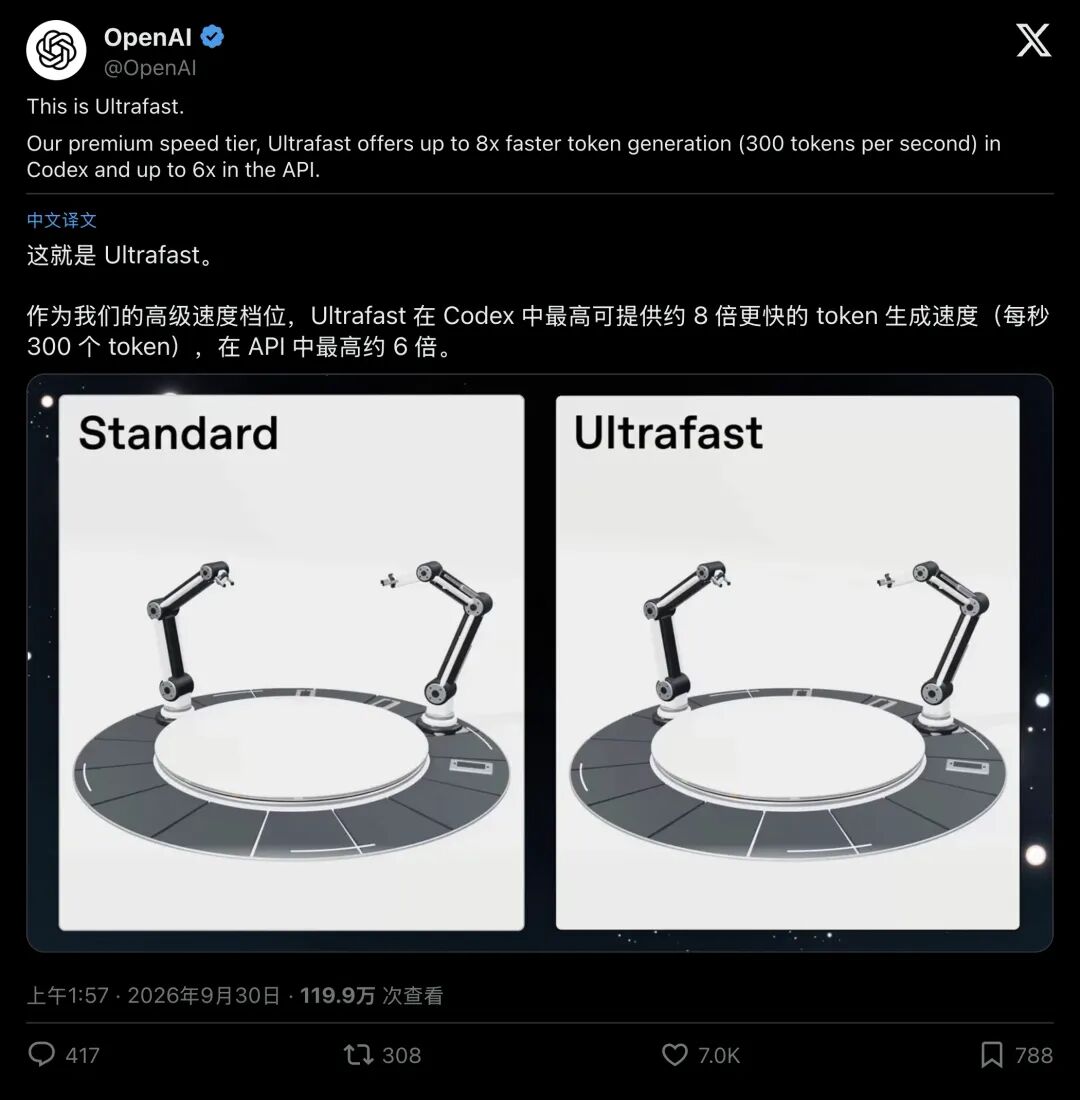
▲ OpenAI 官方宣布 Ultrafast 档位:Codex 提速最高 8 倍,API 提速最高 6 倍
它的核心数据极其惊人:
在 Codex 编程环境中,吐字速度最高可达标准速度的 8 倍,达到惊人的 每秒 300 个 token; 在 开发者 API 中,提速最高约为 6 倍; 首发支持旗舰模型 GPT-6 Astra,同时面向开发者的性价比主力 GPT-6.1 Sol 的 Ultrafast 版本也“即将上线”。
为了配合这一档位,OpenAI 还推出了专属的 Pro 500 订阅计划,提供相当于普通 Plus 会员 25 倍的高额度上限。
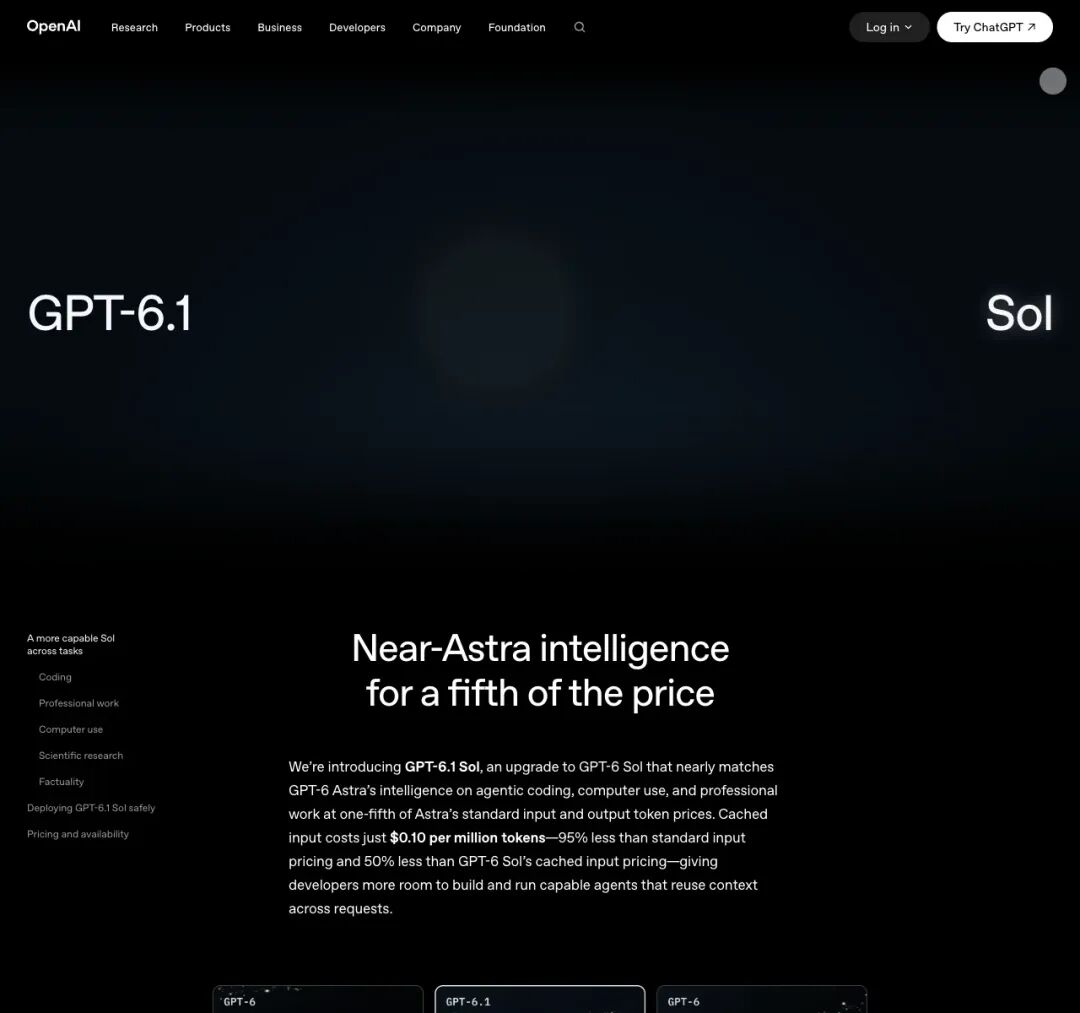
▲ 全新亮相的 GPT-6.1 Sol,号称拥有接近旗舰 Astra 的能力,价格却仅为其五分之一
每秒 300 个 token 是什么概念?
普通人看屏幕的速度大约是每秒 5 到 10 个词。每秒 300 个 token 意味着,当你刚刚按下回车键,一整屏上百行的复杂代码、架构设计图或者函数逻辑,已经在一秒钟之内全部刷屏喷涌而出。
对于需要高频调用的 Agent(智能体)、人机实时编程交互而言,这种延迟的消失是颠覆性的。
但随之而来的,是一张令人咋舌的账单:Ultrafast 档位的 API 价格直接拉到了标准价格的整整 6 倍!
02惊天反转:曾经的 750 字/秒与被遗忘的功臣
为什么 SemiAnalysis 的爆料会引发资本市场如此剧烈的震荡?
因为就在短短一个多月前(2026年8月中旬),OpenAI 曾在官方博客中大张旗鼓地预览过第一代 Ultrafast 模式。
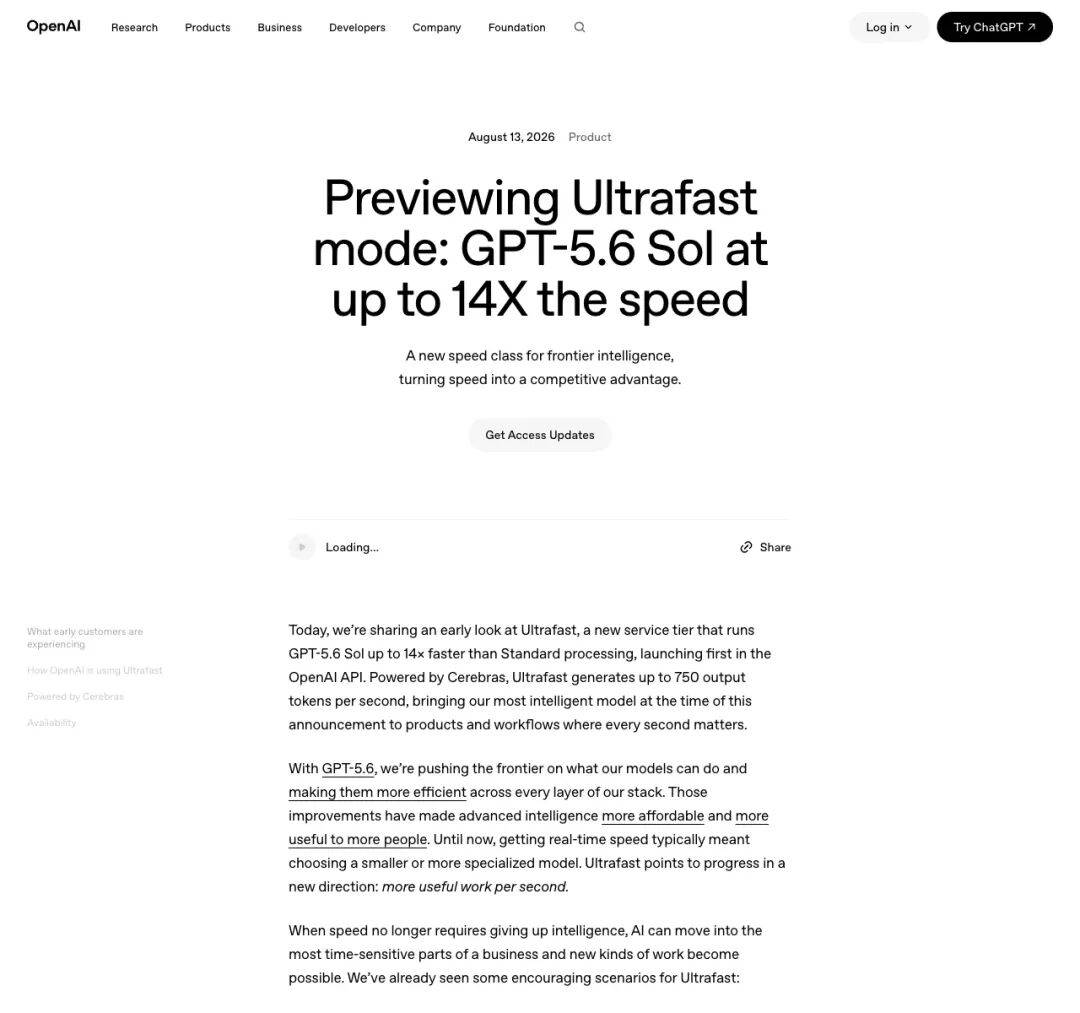
▲ 2026年8月 OpenAI 官方曾白纸黑字写明:由 Cerebras 驱动,速度高达 750 token/秒
在那篇官方文章里,OpenAI 白纸黑字地写着大标题:“Powered by Cerebras”。
那时的演示版本跑在 GPT-5.6 Sol 上,峰值速度达到了难以置信的 每秒 750 个 token(提速 14 倍)。Cerebras 靠着将整片晶圆做成一颗芯片(WSE-3)、把 44 GB 超高速 SRAM 直接平铺在计算核心上的激进设计,彻底消灭了外部显存总线的延迟,一战成神。
几乎所有人都笃定:未来 OpenAI 的极速推理服务,必然会被 Cerebras 等专用 ASIC 芯片牢牢垄断。
然而,仅仅过了 40 天,当 GPT-6.1 正式登场、Ultrafast 走向商业化落地时:
官方宣传的速度数字从 750 token/秒 骤降到了 300 token/秒; 官方文档里,“Powered by Cerebras” 的字样神秘消失; SemiAnalysis 更是直接揭开了底牌:它已经换回了英伟达的 GPU 集群!
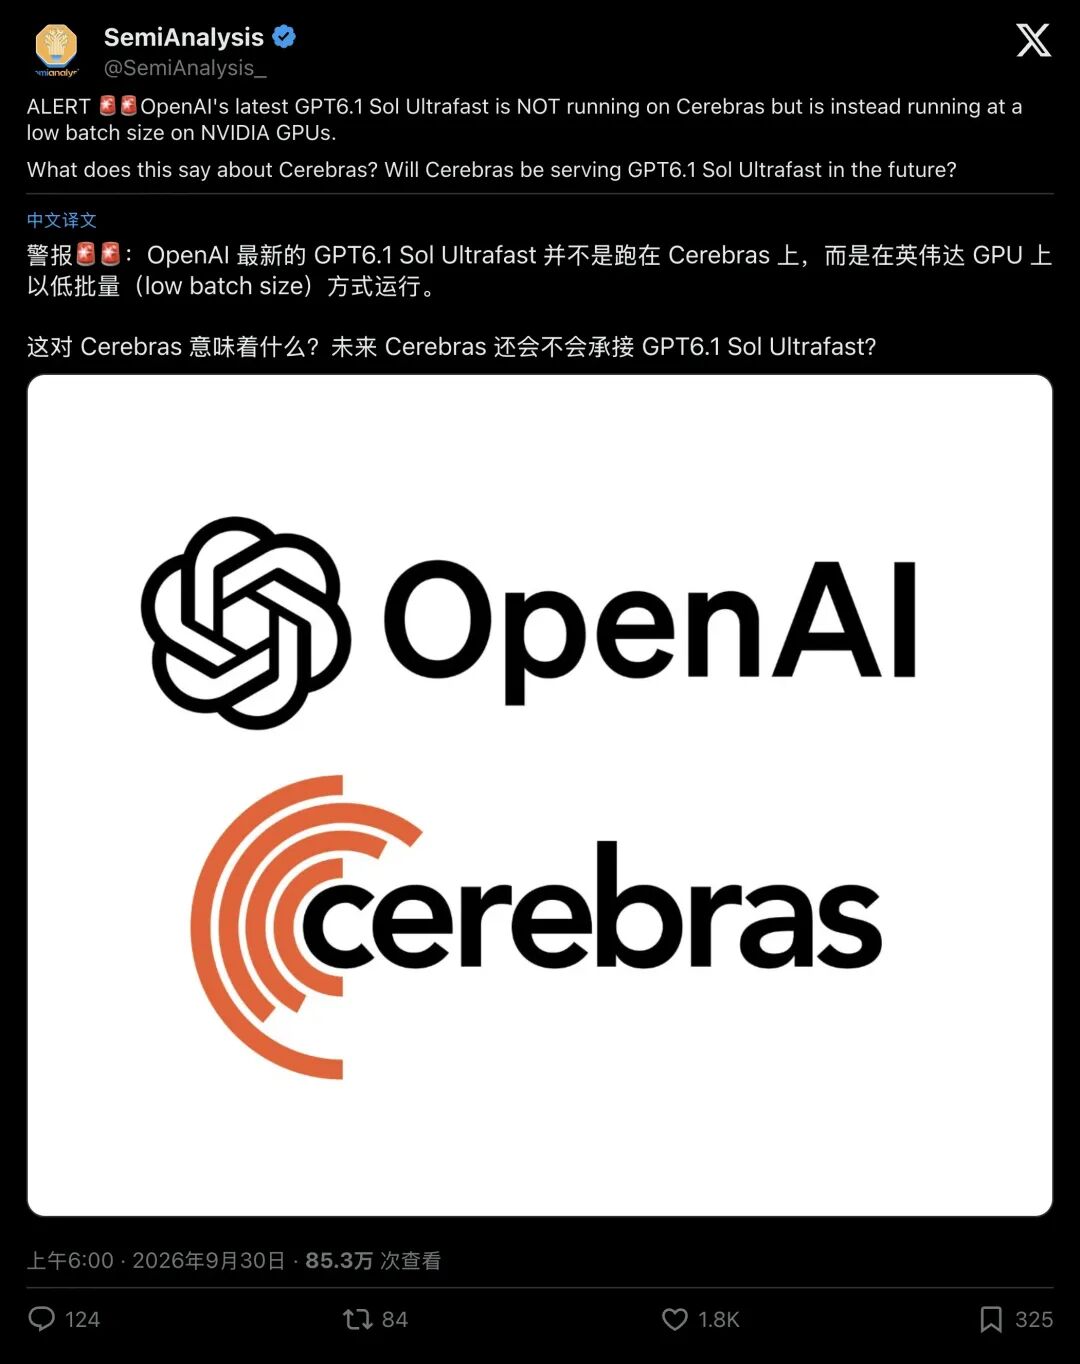
▲ SemiAnalysis 爆料:GPT-6.1 Sol Ultrafast 实际运行在英伟达 GPU 上,未采用 Cerebras 方案
随后,华尔街投资账号 Wall St Engine 甚至进一步分析指出:OpenAI 很可能正在使用英伟达最新一代 Blackwell 架构的 GB300 NVL72 机架来暴力扛起这套极速服务。
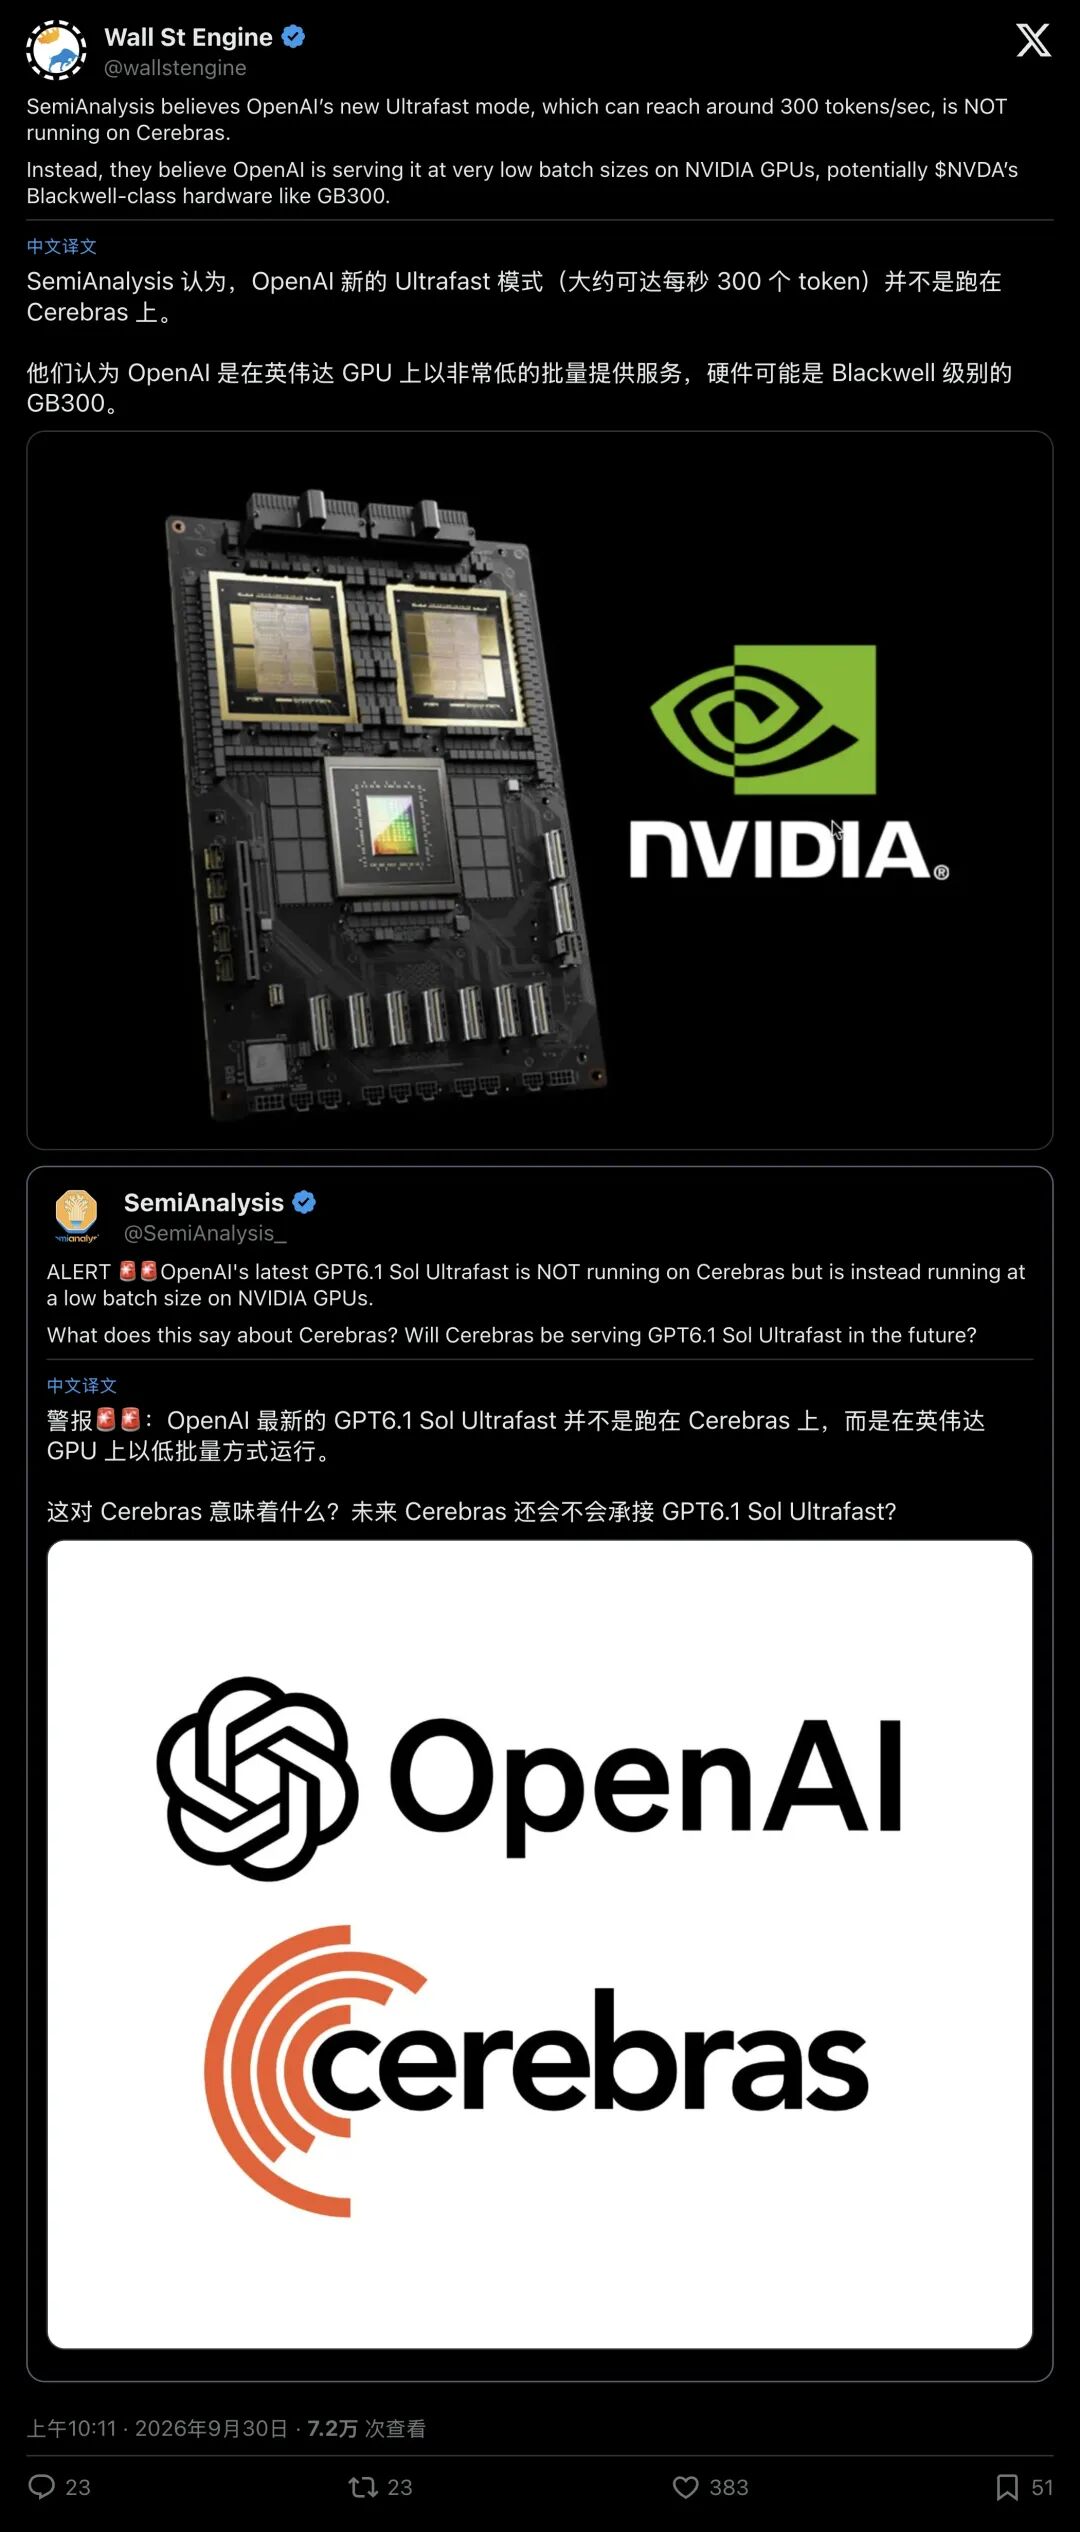
▲ 华尔街机构迅速解读:英伟达 Blackwell 级硬件与低批量调度正在重新接管战场
从 750 到 300,从专用芯片到通用 GPU,这中间到底发生了什么?
03什么是“低批量”?一场昂贵的包场游戏
要看懂这场技术暗战,必须先搞懂一个核心概念:Batch Size(批量大小)。
我们可以把 AI 推理服务想象成一家开在市中心的超级餐厅:
- 大批量(High Batch Size),相当于“大锅包桌菜”
:后厨大厨(GPU 计算核心)一次性把 64 桌或者 128 桌客人的同一道菜下锅一起炒。 - 优点
:炉灶利用率拉满,单位时间内出菜总量极大,平均到每道菜的成本极其便宜; - 缺点
:每一桌客人都得在座位上干等,必须等服务员凑齐这一大锅的订单才能开火(单请求延迟变长)。 - 低批量(Low Batch Size = 1 或极小),相当于“米其林私人专属定制”
:整个后厨、几万块钱的大灶台、十几个厨师,现在只为你这一个客人服务。你刚点完单,大厨瞬间开火炒菜,一秒钟把盘子端到你面前。 - 优点
:你体验到了极致的速度(单用户延迟极低,吐字如飞); - 缺点
:大厨 90% 的算力都处于空转摸鱼状态,每张 GPU 的整体产出吞吐量(Throughput)断崖式塌缩。
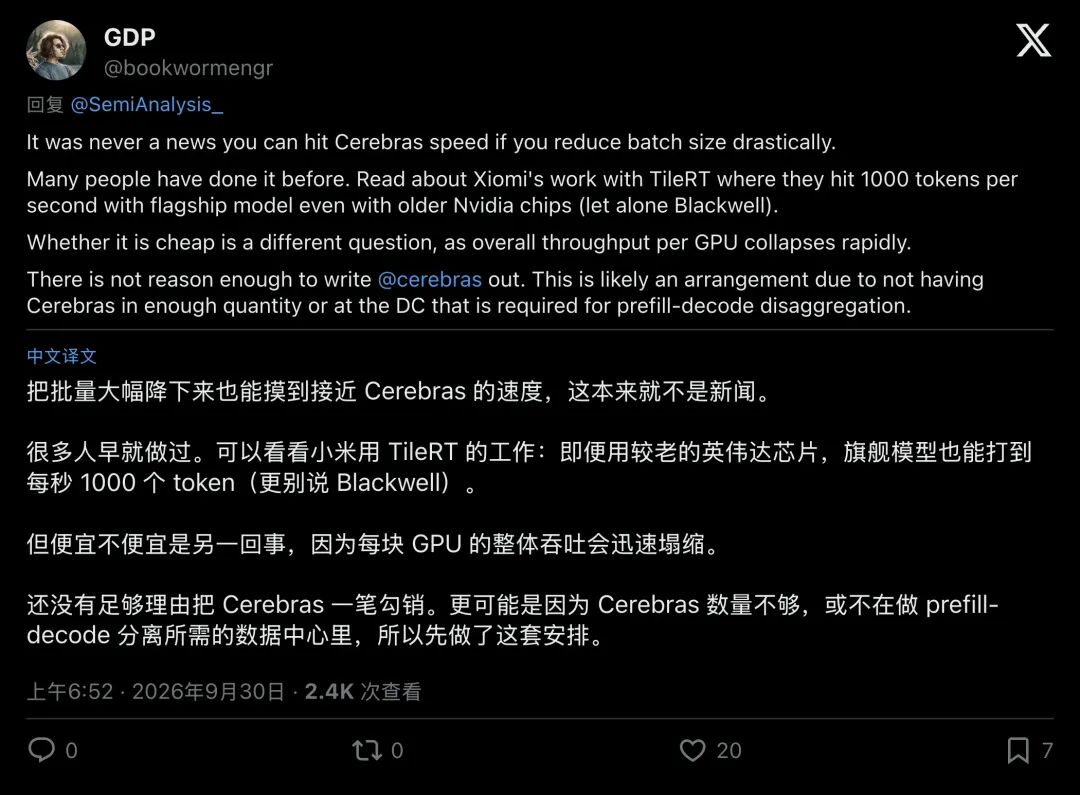
▲ 技术评论员 GDP 犀利指出:大幅压低批量换取单流速度业内早有先例,关键在于单位成本与吞吐量会急剧崩溃
正如资深工程师 GDP 在社区中所指出的:“只要你敢把 Batch Size 压到极致,哪怕是用老一代的英伟达芯片,大家早就证明过可以把旗舰模型推到上千 token 每秒。”
OpenAI 并没有发明什么颠覆物理规律的魔法。
所谓 300 token/秒的 Ultrafast,本质上就是:OpenAI 在云端开辟了一个专享 VIP 泳道,故意让英伟达 GPU 不去拼单、不去并发,用极低的算力利用率,换取单个用户的极致吐字速度。
这也是 OpenAI 敢收 6 倍价格的底气所在:用户付费购买的核心,正是整块芯片为单人独享待命而承担的昂贵溢价。
04专用芯片的三大死穴:为何 Cerebras 没能守住王座?
既然专用芯片(Cerebras、Groq、SambaNova)能在实验室里跑出 750 甚至 1000 token/秒的狂暴性能,为什么在 OpenAI 最核心的生产环境里,依然被英伟达的“低批量战术”给截击了?
专用加速器在商业落地中,撞上了三堵物理与工程的高墙:
物理死穴一:SRAM 的“物理微缩停滞”与成本高墙
专用芯片之所以奇快无比,是因为它们抛弃了外部显存(HBM/DRAM),把所有的模型权重和计算都塞进芯片内部的 SRAM(静态随机存储器) 里。
SRAM 就像是你伸手就能拿到的办公桌抽屉,速度极快;而外部显存就像是走廊尽头的仓库,再快也得跑几步。
但 SRAM 有一个致命的物理缺陷:它几乎无法再微缩了。
随着半导体工艺挺进 3nm 及更先进节点,晶体管越来越小,但一个 6T SRAM 存储单元的面积几乎不再缩小。
英伟达采用的 HBM 显存,可以通过 3D 堆叠(像盖摩天大楼一样叠 8 层到 12 层),用极低的成本堆出 144GB 甚至几百 GB 的海量容量; 而 Cerebras 哪怕把整整一整片 12 英寸晶圆全部做成芯片,里面能塞进去的片上 SRAM 也仅仅只有 44 GB!
要想放下更大的新一代前沿大模型,专用芯片必须使用多颗甚至数十颗晶圆级芯片互联,其硅片成本和良率代价呈指数级暴增。
工程死穴二:膨胀的上下文与 KV Cache 危机
当今的大模型已全面进入动辄 128k、1M 上下文的多轮复杂 Agent 时代。
在大模型推理过程中,除了模型自身的权重外,对话历史所产生的 KV Cache(键值缓存) 会随着文本长度的暴涨而疯狂吞噬显存。一段长达 10 万字的多轮代码排障,光是存放 KV Cache 就需要数十 GB 的存储空间。
此时,专用芯片那宝贵的几十 GB SRAM 瞬间被撑爆。它们不得不退化为“片外内存换页”或者跨节点网络传输,原本的片上无延迟神话在庞大的上下文面前被瞬间打回原形。
生态死穴三:模型架构变动太快,编译器追不上
这是最让专用芯片团队痛苦的一点
专用的数据流架构极其依赖定制编译器对模型算子的静态编排。可当今大模型的发展速度如同脱缰野马:从密集型 Transformer,到 MoE(混合专家架构)、MLA(多头潜在注意力)、滑动窗口注意力、投机采样预测头……
每一次前沿模型架构的突变,英伟达的 CUDA 生态 和 PyTorch 框架在第一天就能无缝兼容跑通;而专用芯片的编译器团队往往需要闭关重写数月才能勉强适配。
在分秒必争的商业战场上,OpenAI 不可能为了等专用硬件适配,而推迟 GPT-6.1 的上线节奏。
05黄仁勋的降维打击:机架级巨兽与云端存量
当专用芯片在 SRAM 成本与架构变动中苦苦挣扎时,英伟达则亮出了自己的终极防御工程体系。
▲ 技术社区迅速捕捉到:英伟达不仅拥有绝对的生态支配力,更能用系统级工程化解延迟劣势
根据英伟达 Blackwell 架构与 NVL72 的技术全解,英伟达依靠的是整套系统级集群工程:
- NVLink 机架互联打造“虚拟超大芯片”
:英伟达的 GB300 NVL72 机架通过整整 5000 根铜缆直连,将 72 颗 GPU 融合成一个拥有 130 TB/s 双向互联带宽的庞大共享显存池。它既拥有 HBM 带来的海量 TB 级容量,又无限拉近了多卡通信的延迟差距。 - 存量基础设施的极致复用
:微软 Azure、亚马逊 AWS、谷歌云等全球所有数据中心,早就铺满了标准化的英伟达机柜与液冷网络。 如果云厂商要大规模部署 Cerebras,必须重新定制超高功率供电、特种液冷管道与全新机房; 而如果使用英伟达集群,OpenAI 的工程师只需要在软件调度层敲下一行代码:把现有的这 1000 块 GPU 标记为“低 Batch Size 专享池”。
几秒钟之内,全球现成的数据中心就能瞬间变身,为全球开发者提供稳定的 Ultrafast 服务。
这就是通用生态与工业规模带来的绝对统治力。
06谁在为“极速”买单?算一笔现实的商业账
在这场技术狂欢的背后,最直观的依然是普通用户和开发者手里的那张账单。
在社区讨论中,一位开发者一针见血地给所有人算了一笔账:
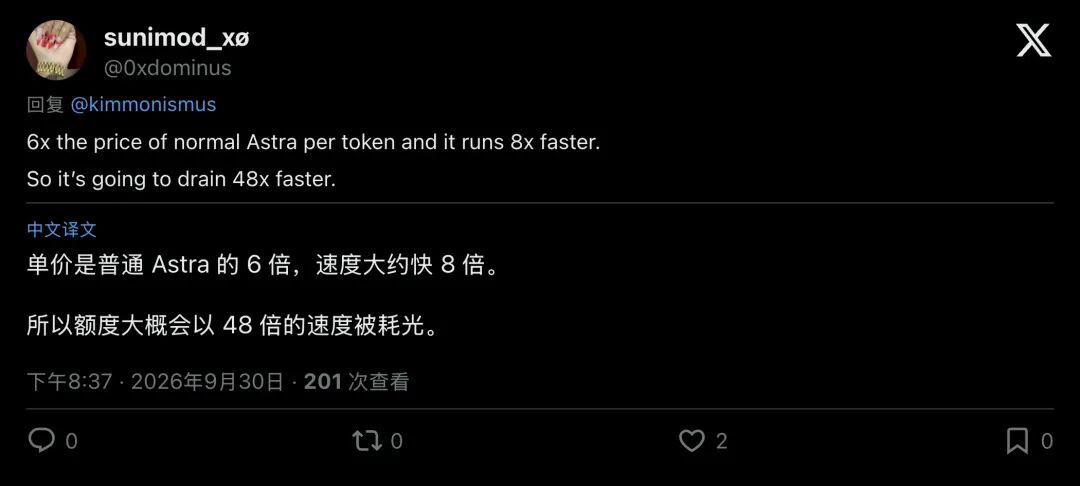
▲ 开发者调侃:6 倍价格乘以 8 倍速度,你的 API 额度可能正在以 48 倍的速度被烧光!
虽然 48 倍只是一个玩笑式的乘法,但它揭示了一个非常现实的业务逻辑:
- 后台异步任务(文档总结、离线批处理、流水线提取)
:这类业务对单次响应快慢并不敏感,核心诉求在于单位 Token 成本力求最优。因此,大批量、低单价的标准模式占据绝对主流。 - 人机交互前台(实时 Copilot、客服对话、线上故障排查)
:人类工程师坐在屏幕前等待的每一秒钟,都对应着切实的工时消耗。唯有在“人等机器”的高交互场景中,6 倍的 Ultrafast 溢价才能体现出商业经济价值。
极速向来伴随着高昂成本,也是一条经过精密计算的商业价格歧视曲线。
07终局思考:物理极致 vs 商业现实
回看整场风波,SemiAnalysis 的爆料与英伟达那一记简洁有力的“👀”,共同写下了 AI 硬件进化史上引人瞩目的一章。
Cerebras、Groq 这样的专用硬件先锋,用近乎艺术品的晶圆级架构证明了人类单流推理的物理极限(750+ token/秒);
但英伟达则凭借坚不可摧的 CUDA 生态、NVL72 机架工程,以及在通用集群上“灵活牺牲部分利用率做低批量”的商业弹性,在 300 token/秒的实用区间构筑起了一座让对手绝望的工程堡垒。
在这场关乎算力未来的博弈里,决定终局走向的,不仅在于实验室里的理论峰值,更在于商业落地的综合考量,谁能将算力、成本、模型迭代与全球数据中心,编织成一张稳健高效的工业化网络。
正如那句流传在硅谷半导体圈的名言:
“在实验室里,速度取决于物理定律;但在商业世界里,速度最终取决于生态与账单。”