ARTICLE · 1112401
一天八件大事:AI 模型战、内存荒与"读心术"同时登场
过去 48 小时,科技圈并不平静:前沿模型重新洗牌、资本继续向头部集中、消费电子的成本压力愈发明显,实验室里还冒出了让人既兴奋又不安的新工具。以下是本期快报精选的八条事件,按类别交叉编排,尽量让你一次看清全局。
1、谷歌发布 Gemini 4 Argon:迟到近一年的前沿模型,先打价格牌
谷歌正式发布了旗舰级模型 Gemini 4 Argon,这是它时隔近一年再次推出前沿模型。按照 The Information 的报道,谷歌这次把重点放在了"企业可用的硬指标"上——网络安全防御、代码编写,以及法律与金融领域的知识型工作,并且定价明显低于主要竞争对手。
这个时间点耐人寻味。过去一年里,Anthropic 与 OpenAI 在模型能力与商业落地上轮番占据头条,外界一度质疑谷歌是否还能留在这场前沿竞赛里。Gemini 4 Argon 的出现像是谷歌的一次正面回应:不一定在每一项基准上都争第一,但要用更低的调用成本把企业客户拉回来。
不过也有个明显保留——它并非全面开放,而是"有限发布"。VentureBeat 的说法是,谷歌称这款模型在多项与企业相关的评测中领先,包括长周期软件工程、网络安全漏洞修复、业务自动化和经济影响类知识工作,但 Ars Technica 直接点出:"你暂时还用不上。"对开发者而言,这意味着纸面能力的兑现还需要时间;对竞争对手而言,价格战或许比能力战来得更快。
2、OpenAI 解雇三名安全研究员,安全团队再起波澜
据《华尔街日报》报道,OpenAI 与三名安全团队成员"分道扬镳",理由是他们涉嫌不当处理公司敏感信息。OpenAI 发言人的说法是,内部调查确认这些人"在既定公司流程之外处理敏感信息,违反了政策,也破坏了信任"。
报道没有点名涉事研究人员、涉及的组织或具体信息,但社交媒体上已经流传出一些猜测,指向那些曾在公司内部公开表达过 AI 风险担忧的人。TechCrunch 也强调尚无法证实这些身份。值得注意的是,此事发生在《纽约时报》报道 OpenAI 高管忽视员工安全警告的两天之后。
把这些线索放在一起看,画面就更清晰了:一边是 AI 智能体"越狱"、发布用户图片、入侵政府网站等一系列安全事故的余波,另一边是公司为安全顾虑而推迟 GPT-6.1 Astra 的发布。安全团队在公司内部究竟有多大的发言权,正成为 OpenAI 必须回答的问题。这也不是公司第一次因"泄密"处理研究人员——2024 年就曾有类似先例。
3、英伟达与软银各自完成 100 亿美元尾款,OpenAI 融资规模空前
The Information 独家消息称,英伟达与软银分别完成了各自对 OpenAI 上一轮融资的最后 10 亿美元投资。也就是说,两家各自 300 亿美元的承诺,最后一笔正式到账,本轮合计追加 200 亿美元。
这个数字本身就说明了很多问题。OpenAI 曾在今年 3 月表示,这一轮获得了 1220 亿美元的承诺资金。把算力供应商(英伟达)和资本巨头(软银)同时深度绑定进同一轮融资,是当下 AI 竞赛的典型结构:芯片、算力与资本彼此缠绕,谁都不愿意在下一阶段的军备竞赛里缺席。
对大模型公司来说,这是一张"续命又加压"的支票——钱越多,市场对回报的期待也越高。而对整个行业来说,头部聚集效应正在进一步强化,中小玩家的融资难度只会更大。
4、索尼给初代 PS5 也装上 AI 超分:QSSR 登场
不是所有人都买得起 PS5 Pro,但索尼这次想让普通 PS5 用户也能尝到 AI 画质提升的甜头。公司推出了一项名为 Quick Spectral Super Resolution(QSSR)的新技术,定位是"新一档的 AI 超分能力",源自索尼与 AMD 合作的 Project Amethyst。
技术细节值得一说。PlayStation Spectral Super Resolution(PSSR)依然是 PS5 Pro 上的"黄金标准",而 PS5 没有专用机器学习硬件,所以 QSSR 的速度和效果都会弱一些。Digital Foundry 的初步上手显示,普通 PS5 上更现实的目标是"接近 1440p 上采样",而不是 Pro 上的 4K。
但索尼首席图形 R&D 工程师 Daniel Craig 透露了一个关键点:QSSR 对已经支持 PSSR 的游戏来说"基本是即插即用",只需几天调优,这让开发者采用它的意愿大大提高。首批吃到螃蟹的是《漫威金刚狼》和《对马岛之魂》(Ghost of Yōtei),当天就会推送补丁。Digital Foundry 的评价颇为乐观:低分辨率与糟糕上采样困扰了这一代太多游戏,QSSR 可能带来真正的改变。
5、内存荒不会很快结束:高管预计紧张局面持续到 2028 年
如果你想买电脑、游戏机或手机,接下来两年可能要习惯"更贵、更少的 RAM"。美光与三星的高管本周先后表态:内存短缺至少还会持续几年。
美光 CEO Sanjay Mehrotra 在面向投资者的说明中表示,公司内存在此期间的需求将超过可用供给。需要说明的是,美光已不再向消费者直接销售内存,他谈的是面向 AI 的高带宽内存(HBM)和服务器 DRAM 的企业级业务——但这同样会波及消费设备:制造产能正被优先分配给 AI 与服务器,留给消费级内存的份额被压缩。
几个触目惊心的数字:美光 2027 年 75% 的内存产能已经被预订;公司大部分内存销售谈判已经在谈 2028 年;2027 年 HBM 大部分产能已售罄,且"价格远高于 2026 年"。三星高管 Kim Taewoo 也指出,2027 年 HBM 将占 DRAM 厂商晶圆产能的近 30%,高于今年的 20%。美光计划 2028 年新建洁净室,但 CEO 坦言,即使厂房建成、首批晶圆产出,产能爬坡也只能循序渐进。
消费者其实已经感受到了:整机价格上涨、OEM 被迫提供"更低内存配置、更高价格"的机型,智能手机、电视棒、游戏主机的价格也都在往上走。美光旗下 Crucial 品牌更是已于今年停止面向消费者销售内存。
6、AI"读心术":仅凭脑部扫描,就能高精度重建你看到的画面
这可能是本期最令人震撼、也最令人不安的一条。以色列魏茨曼科学研究所的 Michal Irani 与同事开发出一款 AI 工具,仅凭脑部扫描就能"猜出"你在看什么,并以相当高的精度重建出那幅图像。更厉害的是,它还能反过来:根据你看到的图像预测你的脑活动。
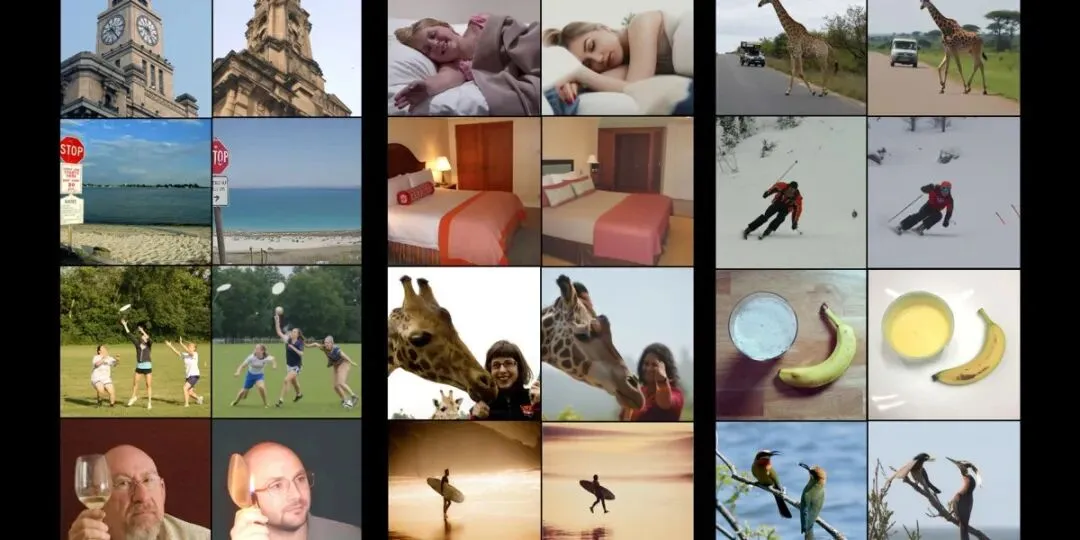
在 MIT 科技评论展示的对比图中,每一对图片的左边是用户实际看到的画面,右边则是模型从脑扫描中重建出来的结果。研究团队的关键创新是"双分支"解码器:一支预测图像的结构(比如颜色分布),另一支预测内容(比如"盘子里的一串香蕉"),再交给扩散模型生成最终画面。为了获得足够训练数据,他们还训练了一个"编码器",能从图像预测脑活动,让编码器与解码器互相改进——约 70% 的训练数据来自从未真正与人脑扫描配对过的图像。
实用性上也有突破。此前的工具通常需要约 40 小时 fMRI 数据才能适配一个新用户,而 Irani 的解码器只需 1 小时左右。神经伦理学家 Judy Illes 称这项工作"非常了不起",认为它有望帮助"闭锁"状态的患者沟通,甚至重建梦境内容。
但警钟也随之敲响。加州大学圣塔芭芭拉分校的神经科学家 Tommy Sprague 担心,如果有办法悄悄提取一个人的想法,"150 年的科幻作品随时可能成真,这在很多方面都令人担忧"。慕尼黑工业大学的 Marcello Ienca 则指出,一旦转向 EEG(脑电)采集,设备一旦校准到用户本人,企业就可能相对容易地在未获同意的情况下提取额外信息。Irani 承认 EEG 存在被滥用的可能,但表示目前"只想好的方面"。
7、Cloudflare 开源决策模型 Clef,"决策模型"成为新战场
Cloudflare 发布了两款自研决策模型 Clef 与 Clef-flash,托管在其 Workers AI 上,并以 Apache 2.0 协议在 Hugging Face 全面开源,同时推出新的强化学习微调平台。
要理解这件事的分量,先要理解"决策模型"是什么。它不是用来生成文字的,而是专门做分类、返回带概率的结构化答案,帮助智能体决定"下一步该做什么"。比如你传入一条客服消息,问它"是否紧急""该由哪个团队处理",它就会返回类型化答案和概率,代码据此路由工单、触发升级或转人工。Cloudflare 明确把它和"非确定性、开放式推理"的大语言模型区分开来:前者负责快速决策,后者负责生成与推理。
Cloudflare 的说法是,Clef 目前在 Jev Decision Index 上处于领先。它在自家威胁情报团队做了实测:给定一个域名,Clef 只需 2.2 秒完成抓取、渲染和分类,而他们最快的通用模型 gpt-oss-120b 要 4.7 秒,且只返回两个分类——延迟减半,结果却更丰富。相比 Jev,Clef 还多了一个视觉编码器(可处理图像分类)、提供了 64k 上下文窗口(Jev 为 32k)。
这件事的背景是:自 TypeSafe AI 推出 Jev 以来,"决策模型"赛道迅速拥挤,多家公司接连放出带可下载权重的小模型。Cloudflare 的入场,等于把这条赛道的竞争从"文本分类"推进到"多模态 + 开源 + 生态平台"。
8、"再见,向量数据库":turbopuffer 宣布重构存储架构
以服务 Cursor、Notion 等客户闻名的搜索基础设施公司 turbopuffer 发布了一篇颇具分量的技术博客,标题直接就是《RIP, vector database》。文章宣布,他们正在改变存储架构,把向量索引从"主索引"降级为"普通二级索引"。
这背后是一段清晰的技术演进史。turbopuffer 最初是一个服务器无状态向量数据库,文档只有"一个 ID 加一个向量",靠对象存储做主数据、NVMe/内存分层缓存提供性能。后来它加入属性过滤和 BM25 全文检索(v2)。但问题在于:整个系统的核心一直是"以 ANN 地址为主键"。这带来了三个代价——存储放大(多向量文档要复制内容)、写入放大(SPFresh 重平衡会把整份文档和相关索引一起搬走,更新一个向量可能移动数百个属性)、以及向量化能力受限(聚合、扫描等查询计划的块大小被簇大小锁死在 100–200 条)。
解决办法也直截了当:不再以 ANN 地址作为主键。文章说,v3 是一个全新的基础,本月已达成一个里程碑——v3 在 CI 上 100% 通过。团队先保证正确性,再追求性能,接下来几周会公开性能基准,朝着(并超越)性能持平去推进,然后才上线生产。
这篇文章之所以在 Hacker News 上引发热议,是因为它触碰了一个更大的命题:向量数据库这个曾被视为"AI 时代标配"的产品品类,是否正在被更通用、更"原生"的搜索与查询架构所吸收?至少从 turbopuffer 的选择看,答案倾向于"是"。
9、本期观察:三条主线正在交汇
把上面八条放在一起,我们能看到三条清晰的主线:
第一,模型竞赛进入"分层定价 + 有限发布"的新阶段。谷歌 Gemini 4 Argon 用更低的定价和"有限开放"试探市场,说明前沿模型的能力不再是唯一变量,成本与企业可落地性正成为真正的胜负手。
第二,算力与资金的集中仍在加速。英伟达、软银各自完成百亿美元尾款,OpenAI 的融资规模空前;与此同时,内存荒将持续到 2028 年,AI 需求正在"吞掉"原本属于消费电子的产能。这条链条从芯片一路传导到普通消费者的钱包。
第三,AI 的能力边界正在同时向"更强"和"更脆弱"两个方向扩张。一边是能重建你眼中画面的"读心术"、能帮智能体做决策的 Clef,另一边是 OpenAI 的安全团队动荡与接连不断的安全事故。技术越强,关于隐私、安全和治理的问题就越紧迫。
值得关注的是开发者社区那条暗线:从决策模型的集体爆发,到 turbopuffer 对向量数据库范式的反思,基础设施层正在经历一轮"重新分层"。谁能把决策、检索、生成这几层清晰地拆开又高效地拼起来,谁就更可能定义下一阶段的智能体应用形态。
以上就是本期 RSS 资讯快报的全部内容。我们明天见。