ARTICLE · 1113028
一个安全人的 AI 落地笔记 · 第 1篇 我用一条内网日志, 试出了大模型最大的破绽
前阵子,我给几个主流大模型出了一道题。
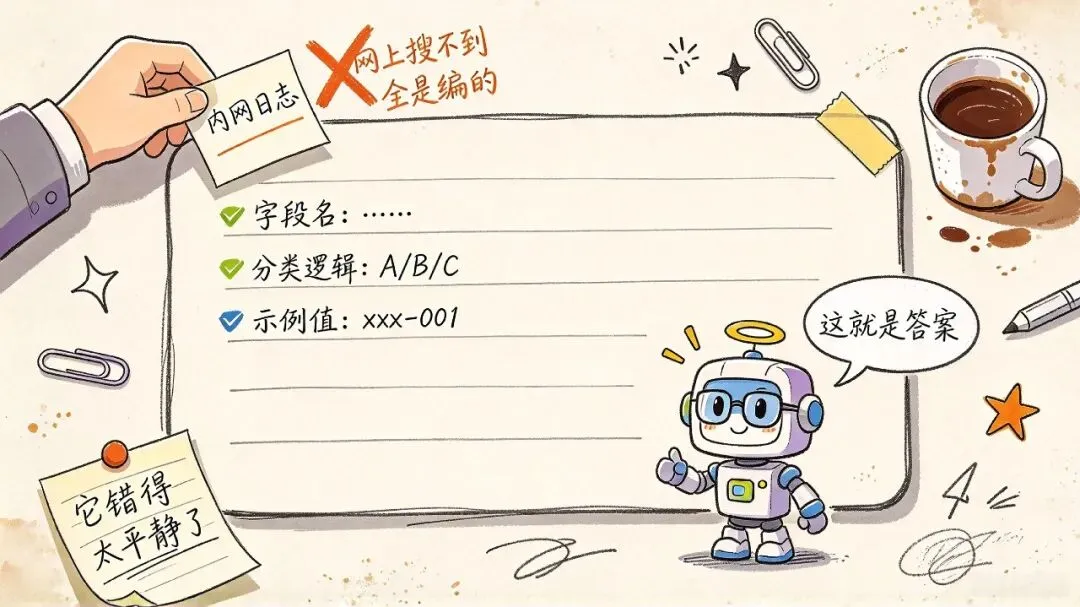
题目不难,就是问它:我们内部那套资产管理系统,某个字段的取值规则是什么。
这题有个特点——答案只存在于我们内网,公开互联网上搜不到、也没有任何文档流出过。
结果很有意思。
它没有说「我不知道」。
它给了我一个结构完整、语气笃定、格式漂亮的答案。字段名对得上、分类逻辑很合理、甚至连示例值都编得有模有样——如果不是我天天在跟这套系统打交道,我差点就信了。
全是编的。
我当时愣了一下。不是因为它答错了——这很正常——而是因为它错得太平静了。没有一个字的犹豫,没有一点「我不确定」的痕迹。
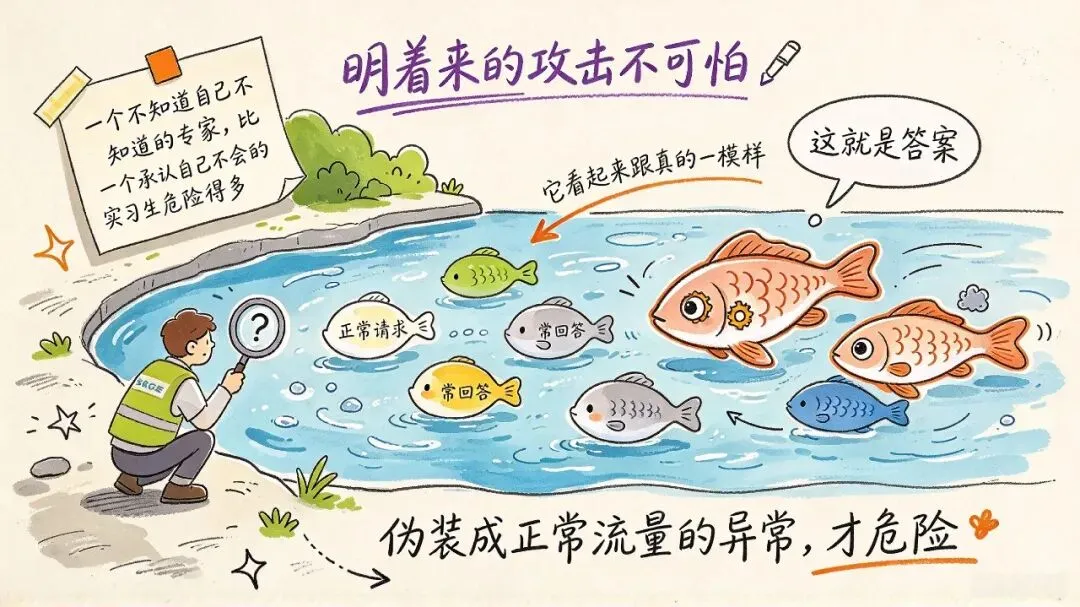
干安全的人对这个场景应该很熟——我们怕的从来不是明着来的攻击,是伪装成正常流量的异常。大模型的这个毛病,本质上是同一类东西。
事后我一直在琢磨这件事。
我们平时遇到 AI 答错,第一反应往往是「这个模型不行」「换个更贵的试试」。我一开始也这么想。直到我把这几年被 AI 坑过的场景翻出来,一条条复盘,才发现根本不是这么回事。
大模型的工作原理,说白了就一句话:它在根据已有的上下文,预测下一个最可能的词。
注意——是「最可能」,不是「最正确」。
这就解释了上面那个实验:它没见过我们内网的数据,但它的任务是「接着往下写」。于是它就用所有看起来最像答案的词,给你拼出了一个最通顺的答案。
它不是在回答你,它是在续写你。
把这个机制想透,三个平时最容易踩的坑,其实指向同一个根因——
幻觉——它没见过,就照着最像的编。知识截止——它只学到某一天为止,之后发生的事一概不知。个性化盲区——它没看过你单位的任何一份内部资料。
你发现没有,这三个坑,看起来是三种毛病,实际上是同一件事:它在自己看得到的范围内,挑了一个最像的答案。
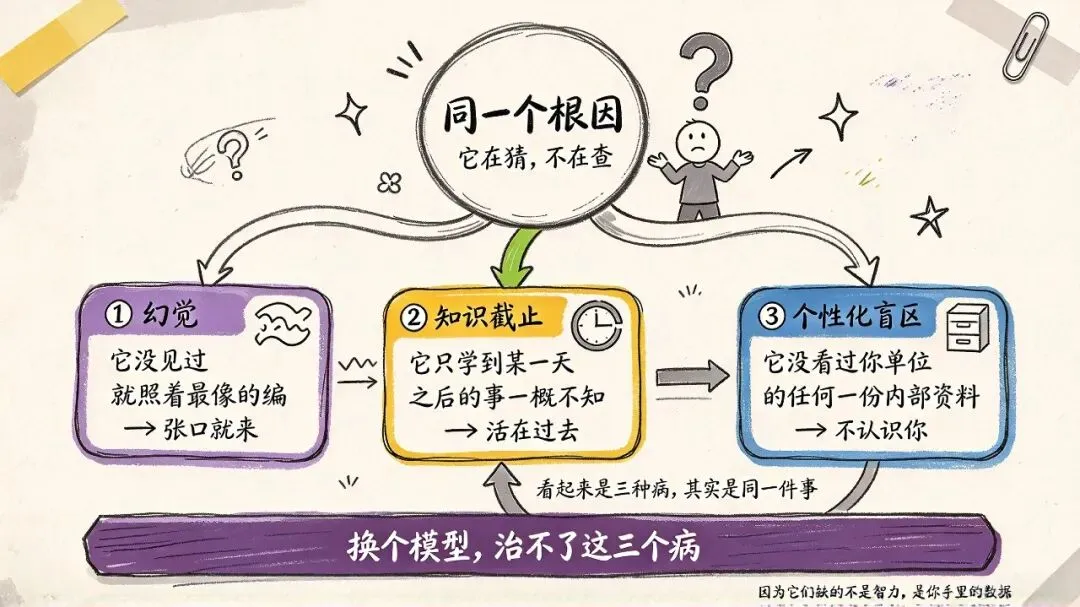
所以你看,很多人一遇到 AI 答错就换模型——换到最后会发现,问题一点没解决。因为你换的是一张更会说话的嘴,而不是给它补上它缺的那块信息。
吐槽归吐槽,日子还得过。我们真正需要的,不是「别用 AI」,而是当它答错的时候,你能快速判断它错在哪、该怎么补救。
我自己总结了一个特别土的办法,就三句话。每次 AI 给我的答案不太对劲,我就挨个问一遍:
这三问的逻辑很简单:它在猜,是因为它没看到。那你就得先搞清楚——它是「不知道该去哪看」,还是「你根本没给它看」。
前者要给它工具,后者要给它数据。这两件事,后面几篇我都会展开讲。
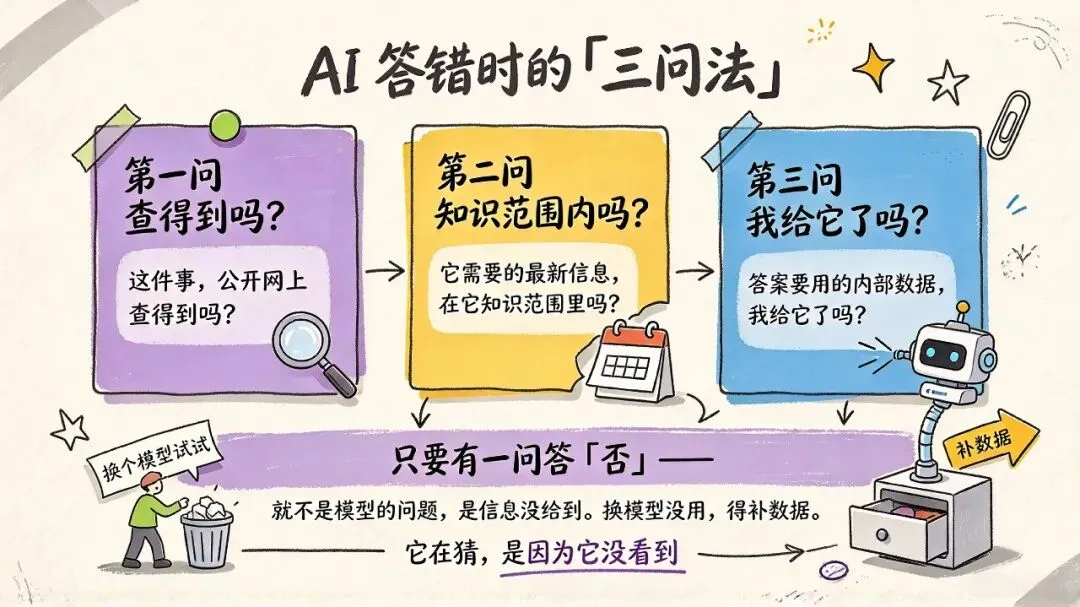
但今天你只要能记住一点就够了:下次再想说「换个模型试试」的时候,先停三秒,把这三句话问一遍。大概率你会发现,问题根本不在模型。
这句话,是我做了这么久 AI 和安全结合之后,最想告诉同事的一句话。它也是这个系列后面五篇的总起点——
因为接下来的每一件事,说白了都围绕着「怎么把数据接上、又怎么把边界管住」。
写到这里,我得坦白一个私心。
上面这些,很多人会总结成「大模型有幻觉,用的时候注意」。但对干安全的人来说,真正该警惕的不是幻觉本身,是幻觉背后那条线。
你想想:当我们为了治幻觉,一股脑把内部数据喂给 AI 的时候——谁在喂?喂的是什么?喂进去以后谁能看到?
这条线,才是安全人真正要守住的东西。补数据决定 AI 的上限,但边界决定这件事能不能干得下去。第 3 篇我会专门讲这个——那是我最有话可说的一篇。
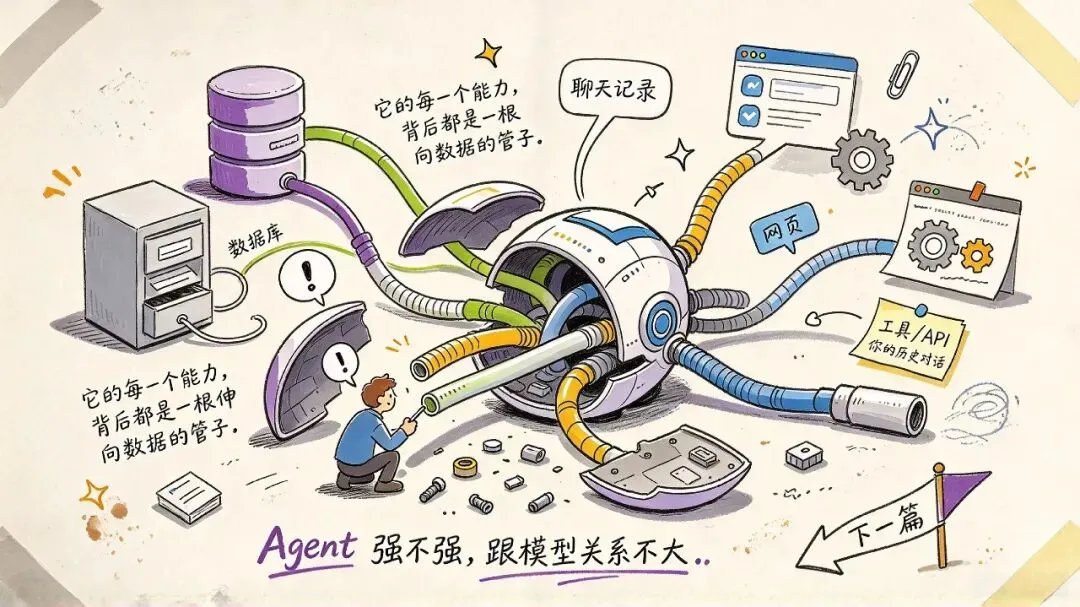
既然问题出在「它看不到」,那下一步就得让它自己会看、会动手——这就是 AI Agent。
可我拆开一个 Agent 之后才发现:它的每一个能力,背后都是一根伸向数据的管子。
下一篇,我们聊聊:为什么说 Agent 强不强,跟模型关系不大。