ARTICLE · 1114060
给女儿写个英语学习App(二):跟读打分,从打个星到真的评分
上一篇写到这个 App 一个家长,给孩子做了一个英语学习 App是怎么起来的,关于跟读打分部分,最后落在:自动评分在国内网络环境基本不可用,我退回了「录音回放 + 家长手动打星」。
那句话我其实写得不甘心。孩子点完录音,等的是一句「你读得怎么样」,等来的是让我去点星星。
最近我把跟读这块整个重做了一遍。这篇只讲这一件事——跟读。
01 之前那个「打分」,根本没在打分
最开始那版是这么干的:孩子录音,同时浏览器把这段录音转成文字,然后把转出来的文字和标准句子做比对,命中几个词就算几分。
听着挺合理,对吧?我一开始也这么觉得。
但它评的根本不是发音。它评的是「你说了哪些词」。
Nina 读 cow,声音又轻又含在嘴里,语音识别照样给你转成 cow,那这一项就满分。她要是读成「考拉」,音一样,只要识别能兜住,还是满分。反过来,她发音标准、语速流利,但因为停顿被切碎了没识别出来,那个词就算没读到。
更要命的是这玩意儿在国内网络环境下时灵时不灵,Safari 干脆直接没有这个接口。而 Nina 用的是 iPad。
所以从她第一次用开始,「自动打分」这三个字就一直是假的,实际跑的一直是「家长打星」。
02 现在的链路:把录音真的送去评测
现在的做法是把录音原样送出去,让专门做这件事的服务评。
中间有几步没预想到的,摔了几跤的。
浏览器录出来的音频,跟评测服务要的格式不是一回事,中间得转一道。这一步听着简单,但 iPad Safari 上它会间歇性地失败,表现就是:我这边一直转圈,孩子那边早就读完了。
还有一整套协议细节。我一开始凭直觉把要送的那句英文做了编码,按文档写的东西越多错得越离谱,最后报出来一个莫名其妙的错误。对照着官方给的示例一行行看,才知道那句话要原样传、不能编码;签名怎么算、数据长什么样,里头也各有各的规矩。这种地方前后一共五个,改完,服务器才终于吐出一个真分数。
现在孩子点「录音」,读一句,服务器回一个分——总分、每个词各自的分,都能拿到。
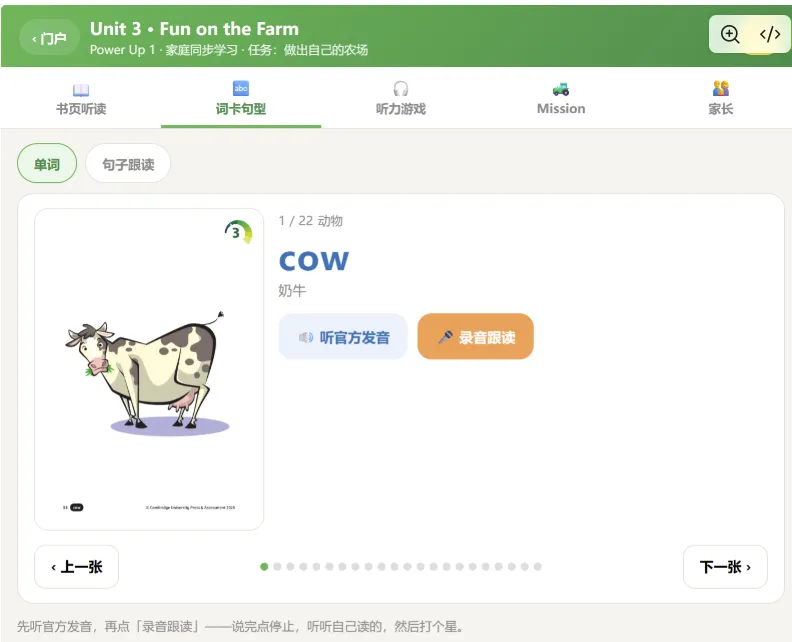
单词跟读和句子跟读走的是同一条链路。单词其实更简单:屏幕上就一个词,官方闪卡上的图,词卡自带教材原音,喂给评测的文本也只有这一个词。U3 二十二个词,猫啊狗啊马啊牛啊,一个一个过。目标文本越短越干净,评分也就越准。
不过光有分数还不够意思,还得提供点情绪价值。我加了个小东西:80 分以上开始有语音夸她,一路到 98 分,中间七档,语气也跟着往上走——刚够线是最温和的一句,分越高我让电脑夸得越夸张。
二年级的小孩,分数她未必真懂,但语气她听得出来。
03 但打分要准,句子本身得先准
这里有个我一开始没想到的坑。
评测服务评的不是音频,是「音频 + 你给的那句标准文本」。它会拿孩子读的音,去和这句话一个音素一个音素地对。
也就是说,我喂给它的那句话如果有错——多了词、少了词、跟音频里唱的压根不是同一句——它评得再准也是白搭,分数评的是一个不存在的东西。
而我喂给它的,是教材录音的原文。
问题就出在这儿。
04 之前点一下,放的是整段对话
先说个更朴素的毛病。
之前句子跟读只有「整段原音」这一个按钮。点一下 Farm 对话 3.02,放出来是整段的完整对话,两个人你一言我一语。Nina 盯着屏幕等她自己要读的那句,等到播完了也不知道该跟哪句。
得先把一句一句切开,每句单独一个音频,点哪句听哪句。
这个活儿本身不算难:拿语音识别把整段录音的每个词的时间点标出来,按句子去切,前后各留一点余音。
05 切完了,一审计,傻眼了
难的是切得准不准。
我的第一版切法挺自然:按顺序找,找到这句的词就在那附近切,前后固定留白——前面留 0.25 秒,后面留 0.45 秒,不然切得干巴巴的,开头结尾的音都削掉了。
切完一看,286 段,一段不缺。挺圆满的。
然后我写了个审计脚本,把这 286 段每一段都单独再送一次语音识别,把转出来的词和这句台词的词逐个对。判定标准只有一条:切片里的词,和台词的词必须完全一致——不许多一个,也不得少一个。
结果 286 段里只有 94 段干净。
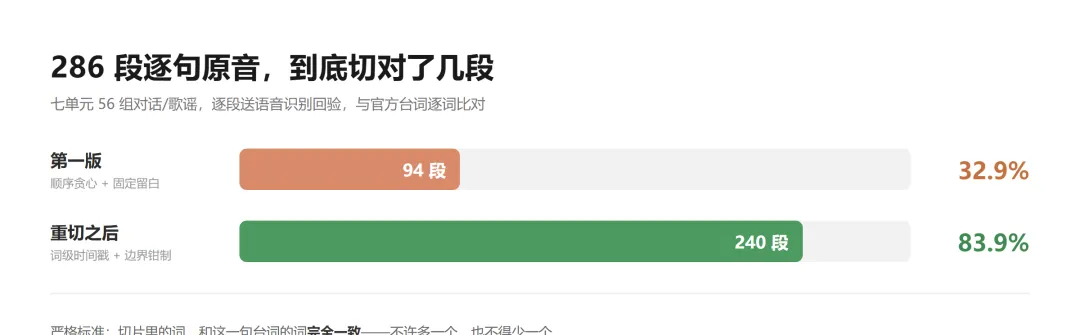
两百来段是脏的,多数是多吃了词——歌谣里两句挨得近,后面那 0.45 秒的余音,直接把下一句的头吞进来了。
回头看第一版,毛病在两个地方,都很典型:
一是判断「这句找到了没」的时候,只看台词里的词在窗口里出现了几个,不看顺序,也不看有没有多吃。所以只要凑够一半的词,就算找到了——窗口可以往前伸、往后伸,伸到隔壁句子上也照收不误。
二是那个固定的 0.45 秒。句子和句子之间的距离不是恒定的,有的紧、有的松,固定值注定有一半是错的。
06 重切:先承认自己可能错,再一刀一刀收
重做的思路很朴素:第一,别猜;第二,错了要知道。
先审计。切完不直接用,每一段都回验一遍,拿一张明确的清单告诉我哪几段脏、脏成什么样——多了哪个词、少了哪个词。
然后按这张清单重切。原则就一条:找到就必须整句咬死——首尾的词对上了、中间大体都在,才算数;宁可承认找不到,也不许多吃隔壁句子的词。
切点也不再拍脑袋留固定余量了:跟着每个词实际发音的起止走,往前多留一点、往后多留一点,但绝不压到邻居身上。
这个过程前后调了四轮。最后 286 段里 240 段完全干净,83.9%。
剩下 46 段我没有糊弄过去:22 段是语音识别把同音词转写了(比如一个词被听成拼写差一两个字母的另一个词),这类算识别误差,不算我切错;另外 24 段边界仍然有点越界,我列成一张清单一条条自己听。
到现在那 24 段我还没听完。所以我不能说这个功能是完美的,它就是做到了 84 分。
07 顺带修掉的两个「不出分」
跟读这块还有个老毛病:有时候点完录音,等半天,什么都没有。
我查了一次服务器日志,28 条超时记录。原因是 iPad Safari 有时候把录音转码转成了空的,空音频送去评测,服务端那边就一直等着,等到 15 秒超时。
现在前端发现转出来是空的,直接就不发了,立刻告诉孩子「这次没录到声音,看看是不是离麦太远」。服务端也加了一道:先看这段音频里有没有声音,纯静音的当场拦下来,还顺手提醒是不是连着蓝牙耳机、麦克风权限有没有开。
还有一个是等。麦克风第一次打开要授权、要走一圈初始化,跟读一次要等三四秒,孩子站那儿干等容易烦。我改成第一次开了之后不关,一直留着,后面每次跟读都是瞬间开始。快到几乎察觉不到。
iPad 上我没敢这么干——Safari 在那儿复用麦克风有过产出空数据的记录,宁可多等一会儿也不能出空录音。
08 现在的样子
句子跟读现在长这样。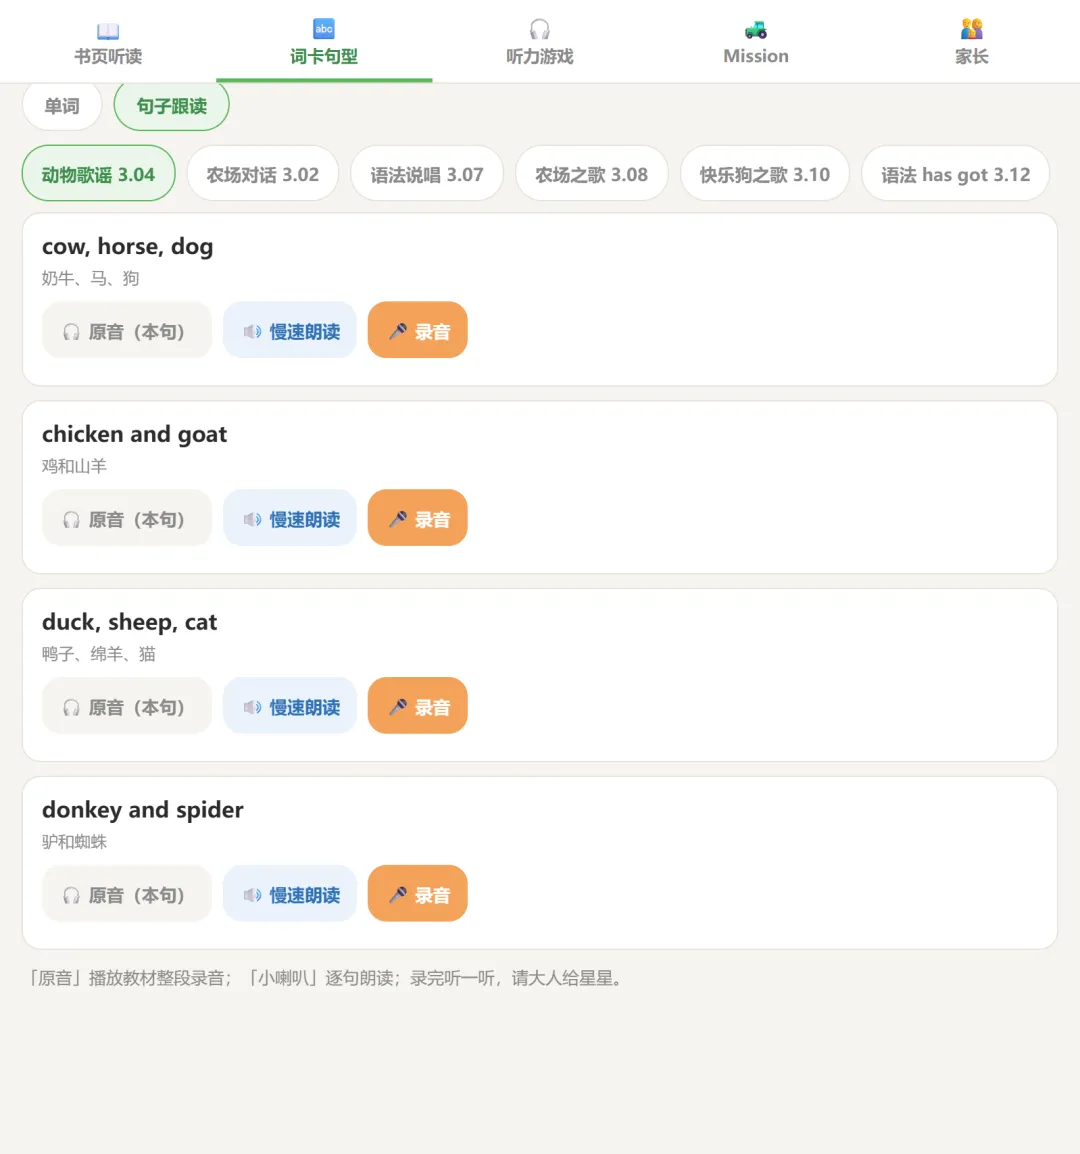 每句话三个按钮:左边是这句自己的原音(不是整段,是精确切出来的这一句),中间是慢速朗读——降到 0.6 倍速,孩子能跟得上,右边才是录音。读完这行会多出两个按钮,听听自己读的,和给自己打星。
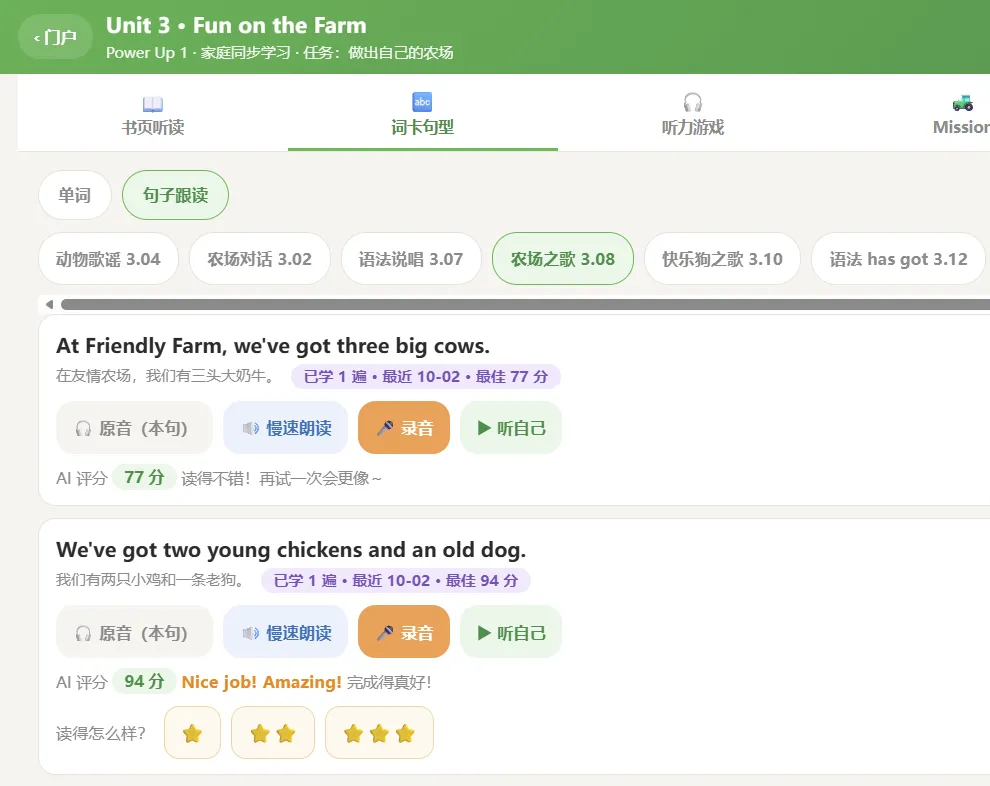
这个顺序是刻意的:先听这一句,慢速再听一遍,然后才轮到她。她不需要在两句对话里猜哪句是自己的。
写在最后
我给自己定了几条线,贴在这儿提醒自己:
分数不进任何考核。它是给孩子的反馈,不是给我看的成绩单。71 分也好,88 分也好,她读得好我就说读得好,我不会再补一句「怎么才 71」。
这里我想说清楚一件事:这个分数是拿一段测试音频在服务器上跑出来的,验证链路通不通,跟她真实读得多好没关系。真正让我高兴的不是那个数字,是从今往后她读完之后,有台机器会认真听她读英语了。
技术上的事 AI 基本都能兜住,真正难兜的是我自己的「我以为」。这一篇尤其明显——我以为切完了就等于切对了,结果 286 段里错了三分之二,而我最初压根没打算去验。
孩子不会告诉你她跟读的那句原音里混进了下一句的头。她只会跟着读,然后莫名其妙地读错。
下一篇我打算写磨耳朵——那个每天早晨要陪她听二十分钟的栏目。它跟跟读一样,也是我自己做着做着才发现,一开始就想错了地方。