ARTICLE · 1116081
视觉AI不再只拼大模型:6篇新论文拆解循环、分流与少步生成
龙哥导读
视觉模型的进步常被概括成“参数更多、数据更多、步骤更多”。这六篇近两天公开的新论文却从不同位置做减法:有的反复使用同一组参数,有的把几十步生成压到一至四步,有的在切屏时主动少用历史,有的完全不重训主模型。把它们放在一起,重点不是选出一个总冠军,而是看清训练、推理和评测的成本还能怎样重新分配。
这次汇总覆盖文生图、视频生成、屏幕内容视频增强、镜头眩光去除与三维重建、语义分割以及高光谱遥感。六项工作没有共享数据集,也不能用一个分数排序;它们的共同问题是:当模型已经足够大,下一单位算力究竟应该花在增加参数、增加步骤、改造数据流,还是改善评测上。
文章采用横向对比与互补组合两种方式。横向部分比较干预位置、训练需求、数据规模、计算口径、关键指标和失败条件;组合部分进一步提出动态预算假设,让同一系统根据场景难度选择循环次数、生成步数、时间信息和后处理强度。
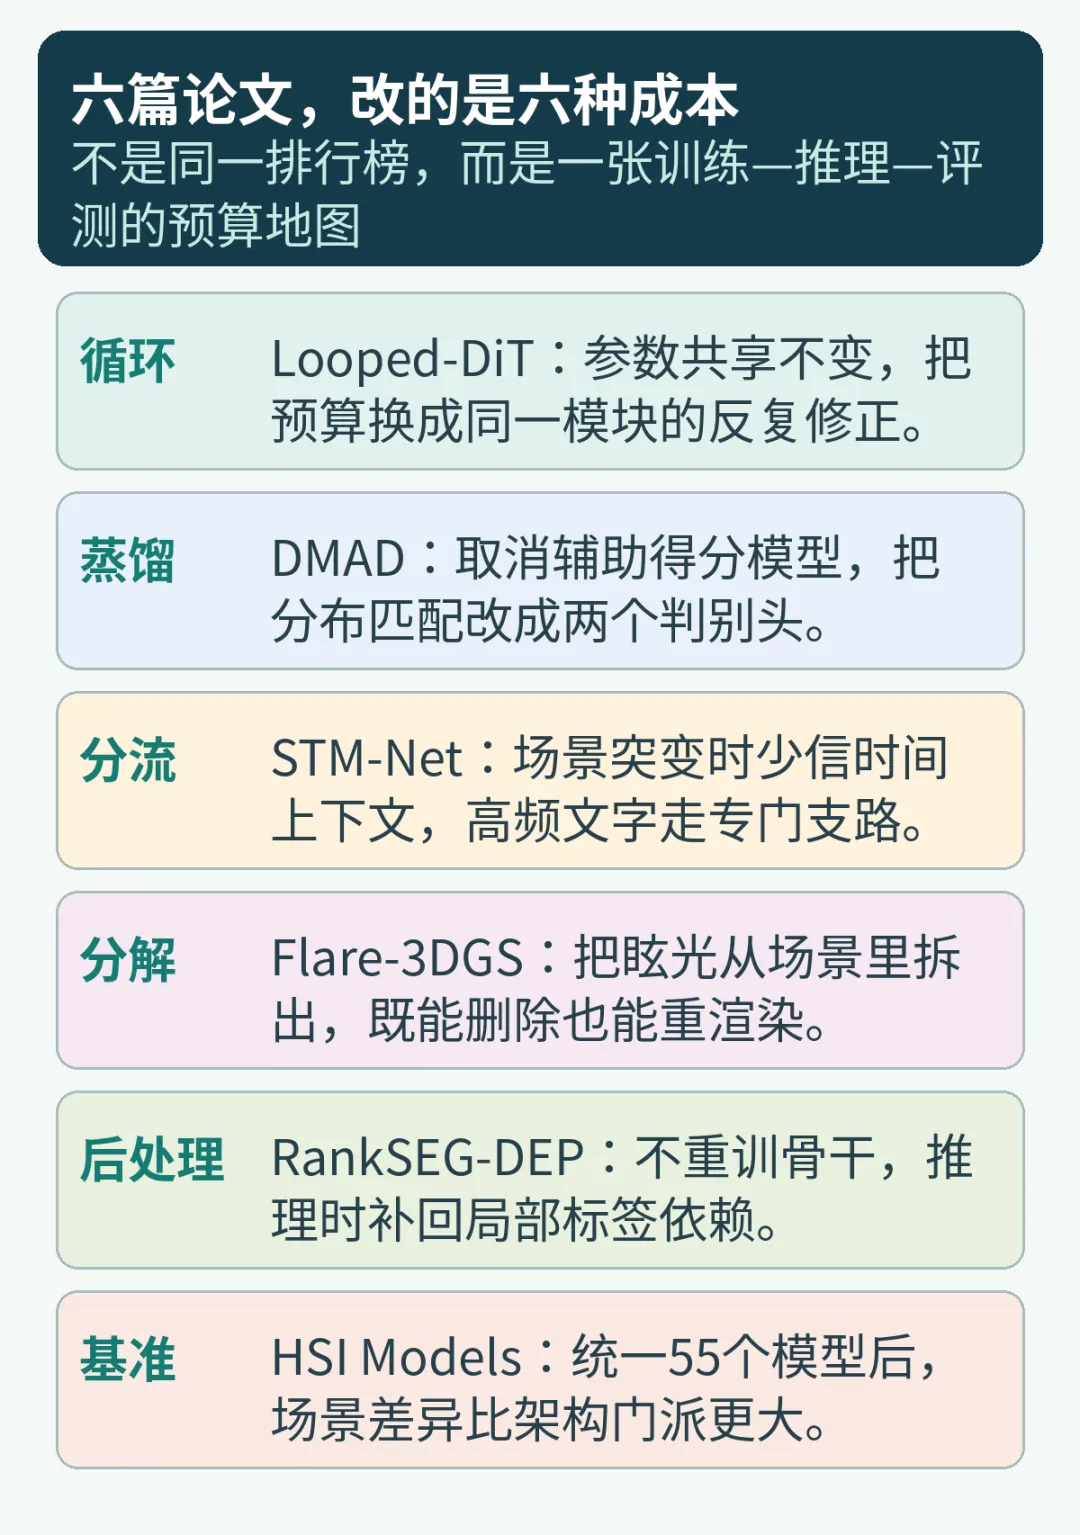
原创整理图:六项工作分别改变循环、蒸馏、分流、分解、后处理和基准,角色明确,不是依靠相似关键词凑数。
一、共同趋势:视觉AI开始争夺“计算位置”
过去几年,扩大视觉模型通常有三条直路:增加参数,让每次前向更强;增加训练数据,让模型覆盖更多分布;增加推理步骤,让生成过程慢慢修正。三条路都有效,却把成本固定在“所有样本都付同样价格”的结构里。简单图像和复杂图像跑同样深度,稳定视频和突然切屏的视频读取同样多的历史,容易场景和困难场景也用同一模型验收。
六篇论文展示了更细的成本控制。第一篇让同一组模块循环使用,把参数成本变成迭代成本;第二篇在训练期投入蒸馏,把部署期几十步改成一至四步;第三篇不再默认相邻帧都可靠,而是把当前帧、前向上下文和后向上下文分开处理。
另外三篇把预算放到模型之外。眩光研究先区分场景与相机成像伪影,再决定该删什么、该保留什么;分割研究不改训练,只在输出决策时加入局部标签依赖;高光谱基准统一55个模型后发现,场景难度造成的变化大于架构范式造成的平均变化。换言之,昂贵的不一定是模型太小,也可能是算力用错位置、数据划分太宽松或任务难度没有被单独记录。
这种变化并不是“越小越好”。循环次数、判别蒸馏、三维联合优化和局部依赖都要付成本。更准确的表述是:模型开始把固定预算拆成可选择的预算,并要求每一部分都能解释自己解决了哪类错误。
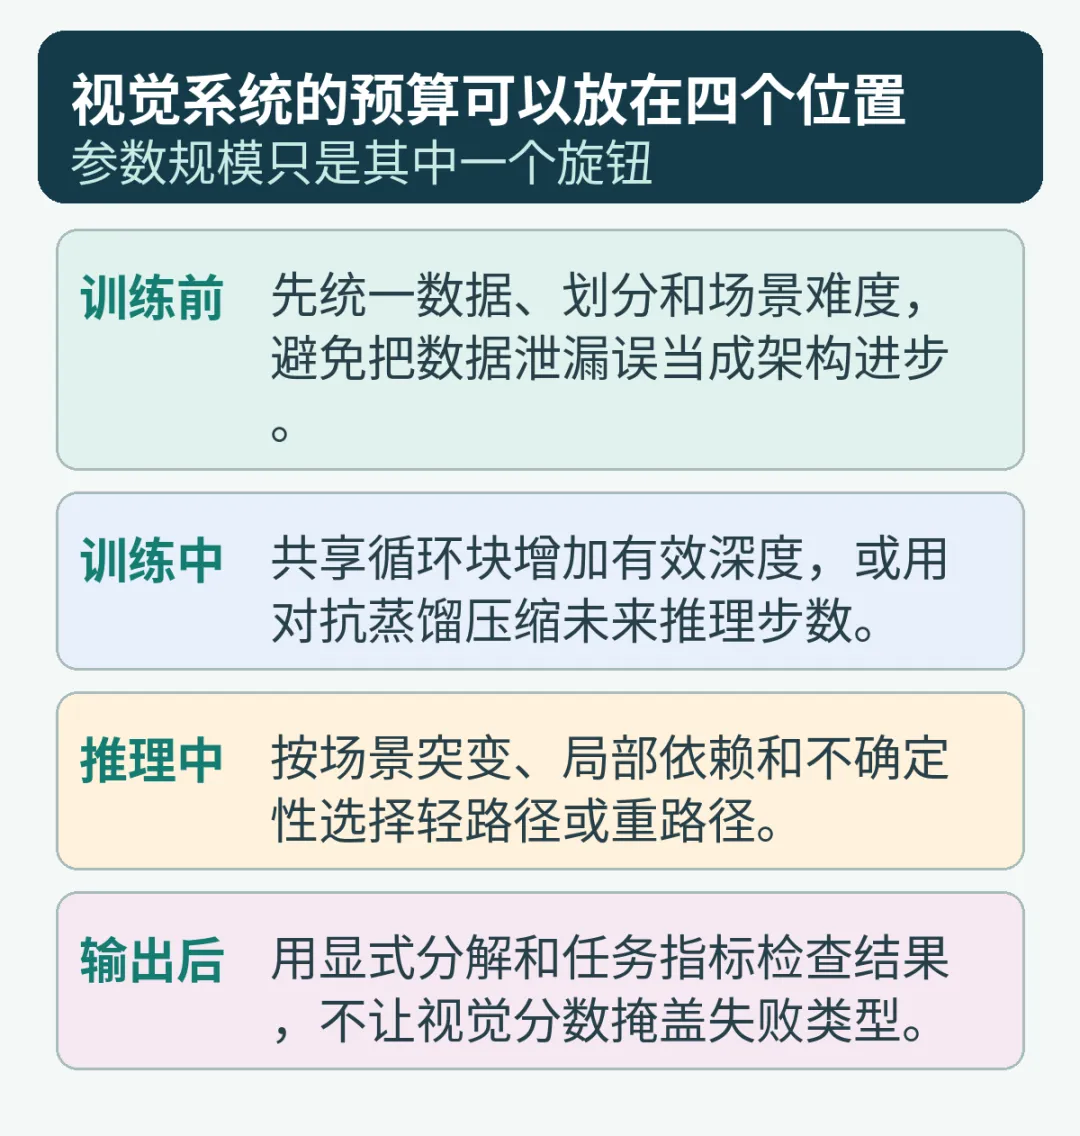
原创整理图:预算可以放在训练前的数据治理、训练中的表示学习、推理中的动态路由,以及输出后的任务验收。
二、循环扩散变换器(Looped-DiT):参数不变,也能增加有效深度
Looped-DiT|Looped Diffusion Transformer
作者:Yong Xien Chng、Tianyi Chen、Wenwen Tong 等单位:商汤研究院、清华大学相关实验室、南洋理工大学首次公开:2026-09-30原论文:https://arxiv.org/abs/2609.40305项目 / 代码:https://github.com/OpenSenseNova/Looped-DiT
Looped-DiT针对文本生成图像中的一个常见选择:如果结果还不够好,是继续扩大模型,还是增加去噪步数?论文提出第三条路线,在每一个去噪步骤内部,重复执行一组共享的 Transformer 模块。权重只保存一份,因此参数量不随循环次数增长;中间表示却可以被多次读取和修正,相当于把网络的有效深度拉长。
论文主结构把17个模块分为6、5、6三段,中间5个模块循环四次。这个设计不是把整个网络机械复制四遍,而是保留输入和输出阶段,只让负责深层语义加工的中段反复工作。共享权重让每次循环面对不同状态,同一模块逐步修正构图、属性绑定和空间关系。
朴素循环并不会自动成功。消融中,普通非循环基线平均分为55.2,直接循环只有56.2。作者发现两个问题:中间循环缺少直接监督,早期错误很难得到及时纠正;注意力在反复写入时会逐渐侵蚀局部空间信息。为此,论文把最终损失与各循环输出的平均损失结合,并用自调制注意力限制更新。完整组合的平均分达到59.1,说明真正有效的是“循环加稳定机制”,不是循环本身。
官方摘要给出的对比更直观:2.60亿参数模型在多项文生图基准上超过参数大约6.5倍的模型,推理计算量低4.9倍。这里的“低4.9倍”应理解为论文对应比较设定下的计算量,并不表示循环没有开销。它证明共享参数的多次使用可能比一次性堆大网络更划算。
工程上最值得延伸的是动态循环。当前实验多使用固定循环次数,但不同提示词的难度差异很大。单物体、干净背景也许两次就稳定,多物体关系、文字和复杂空间约束可能需要更多修正。若中间表示的变化量或不确定性可以作为停止条件,就能让容易样本提前退出。风险是停止判断本身可能误判,尤其在视觉上看似稳定、语义关系却仍错误的样本上。
三、分布匹配蒸馏方法(DMAD):把几十步扩散压到一至四步
DMAD|DMAD: Distribution Matching as Adversarial Distillation for Fast Visual Generation
作者:Zhengming Yu、Junkun Yuan、Haotian Yang 等单位:得克萨斯农工大学、字节跳动首次公开:2026-10-01原论文:https://arxiv.org/abs/2610.02188项目 / 代码:https://yzmblog.github.io/projects/DMAD
Looped-DiT讨论每个去噪步骤内部怎样加深,DMAD则直接减少去噪步骤。它研究的是分布匹配蒸馏:教师模型可以用很多步生成高质量样本,学生模型要在一至四步内逼近同一分布。常见方法需要一个额外扩散模型不断拟合学生当前分布,再由教师得分与学生得分之差指导更新。学生持续变化,辅助模型也必须持续追赶,显存和计算随之增加。
DMAD把这个问题改写为分类。共享特征骨干上有两个判别头:一个区分真实数据与学生样本,一个区分教师样本与学生样本。判别器的输出分数在最优条件下对应对数密度比,因此学生可以直接沿判别分数的线性目标更新,不再训练一个完整辅助得分模型。论文给出了这一目标与传统分布匹配梯度之间的对应关系。
第二个关键是按噪声级调整教师监督。教师在某些噪声范围很接近真实分布,在另一些范围仍有明显差距。DMAD用真实数据判别头观察真实样本与教师样本之间的经验分数差,再据此重加权,让学生少继承教师在特定噪声级的偏差。这个设计把“教师永远正确”的假设改成可测量的相对可靠性。
结果覆盖三种尺度。图像分类训练(ImageNet)中的64×64一步生成,其生成质量指标(FID)为1.04;该指标衡量生成图像分布与真实图像分布的差异,数值越低通常越好。
通用图像评测框架(COCO-10K)上,四步图像生成模型(SDXL)的 FID 为14.47。这个结果说明,方法不仅在小尺寸分类图像上有效,也能迁移到更复杂的文本生成图像任务。
四步 Wan2.1 视频生成模型的视频评测框架(VBench)总分为85.15。该框架从画面质量、运动和语义一致性等角度评价视频生成,不能与图像指标直接比较。
联合音视频模型(MiniMax-H3-33B)上,四步学生在人类偏好测试中分别以79.1%和84.6%胜过两种少步基线,平局不计。
这些数字不能串成一个统一冠军。图像 FID、视频 VBench 和音视频人类偏好评估的对象不同,教师规模、分辨率、硬件和生成时长也不同。论文最稳妥的贡献是证明同一种判别式密度比估计可以跨图像、视频和音视频蒸馏复用;产品是否更快,还需要在统一设备上把模型加载、文本编码、解码器和视频后处理都计入端到端延迟。
四、时空网络(Spatial-Temporal)与时空掩码网络(STM-Net):场景一切换,历史就可能从帮助变成污染
STM-Net|Spatial-Temporal Multi-scale Network for Screen Content Video Quality Enhancement
作者:Ziyin Huang、Tsang、Xinyuan Qin 等单位:深圳职业技术大学、香港理工大学、香港珠海学院等首次公开:2026-09-30原论文:https://arxiv.org/abs/2609.39894项目 / 代码:https://github.com/HUANGZiyin1/STM-Net
普通视频增强依赖时间连续性:相邻帧里同一物体通常只移动一点,模型可以借前后帧恢复当前帧被压缩损坏的纹理。但屏幕内容视频并不服从这个假设。演示文稿突然翻页、窗口瞬间弹出、游戏界面高速切换,文字和图标又包含大量锐利边缘。上一帧的高质量信息可能在下一帧完全失效。
STM-Net首先用先验引导的时空分流器把输入拆成三路,避免当前帧与不可靠历史过早混在一起。双向时间特征模块比较前向和后向残差变化,在没有显式切屏标签的情况下抑制突变处的历史特征。级联多尺度特征蒸馏再用1×1、3×3和5×5分支捕捉不同尺寸结构,并用通道注意力保留文字笔画和图形边缘。
论文数据集包含41段屏幕内容视频,28段训练、13段测试,并在四个量化等级下编码。最困难的压缩量化指标(QP)为37时,完整模型平均提升0.875 dB,比去掉多尺度、去掉高频分支和缩浅网络都更好;平均码率节省7.12%,更大版本为7.46%。这些结果说明,针对屏幕内容的结构化分流比直接套用自然视频增强更合适。
但这项工作的部署账还不完整。论文详细报告了压缩质量和码率收益,训练30万次迭代,却没有把统一硬件上的端到端帧率、峰值显存和功耗放在主结论中。对于云游戏、远程桌面和视频会议,0.3 dB左右的额外收益是否值得更大模型,取决于每帧延迟和服务器并发,而不只是离线峰值信噪比(PSNR)。
这篇论文与 Looped-DiT 的连接点是“按状态决定计算”。前者可以根据中间修正是否稳定决定是否继续循环,后者可以根据时间上下文是否可靠决定使用哪条支路。两者都反对把同一深度、同一历史和同一预算机械应用到所有输入。
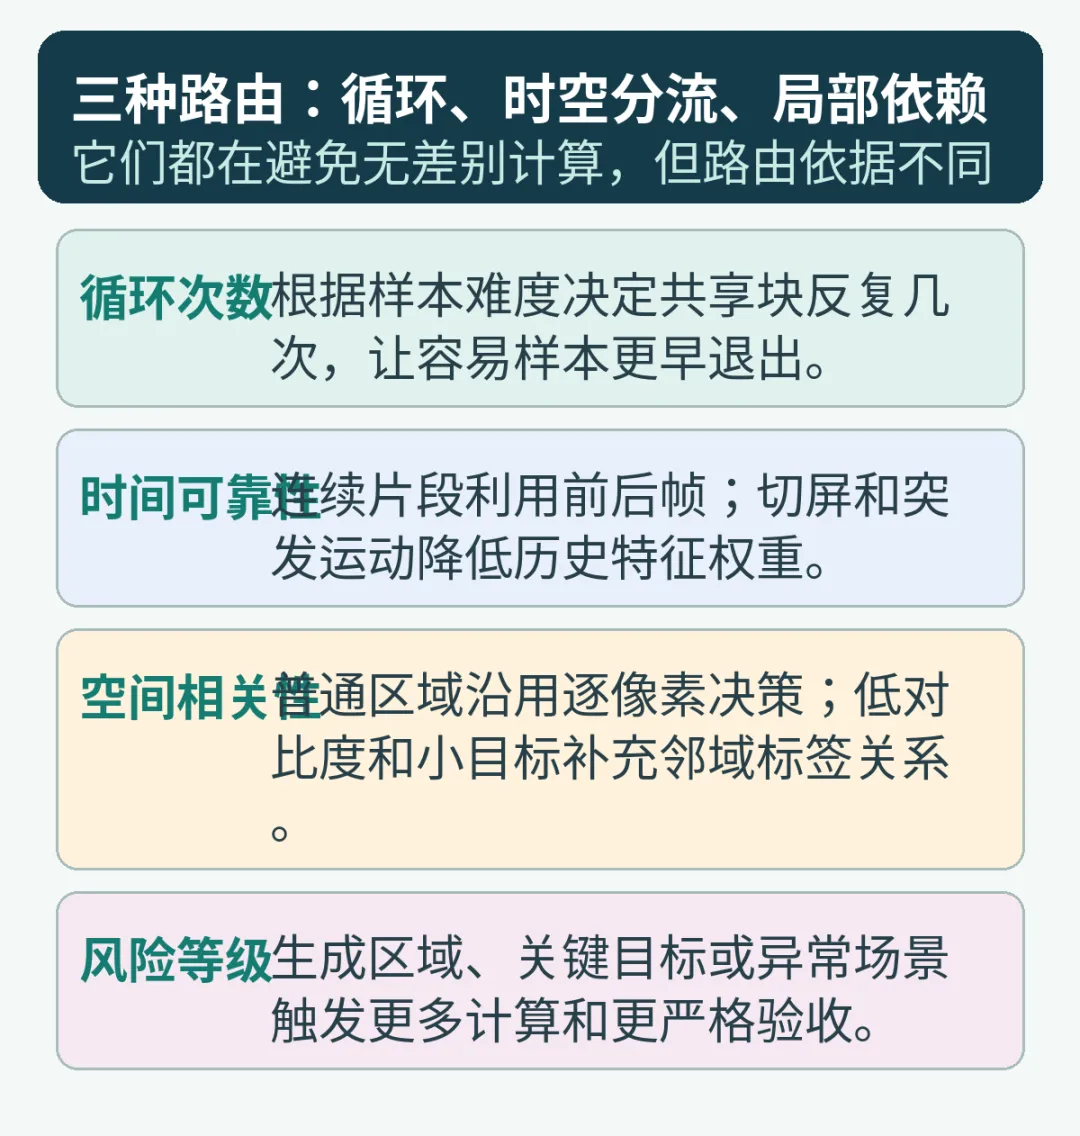
原创整理图:循环次数、时间可靠性和空间局部依赖分别对应生成、视频增强和分割中的动态预算入口。
五、眩光三维高斯方法(Flare-3DGS):瑕疵也可以成为显式场景成分
Flare-3DGS|Lens Flare Removal and Reconstruction
作者:Tarun Yenamandra、Jonathon Luiten、Daniel Cremers、Nathan Matsuda单位:官方 arXiv 摘要元数据未列单位首次公开:2026-09-30原论文:https://arxiv.org/abs/2609.39527项目 / 代码:https://lensflare-3dgs.pages.dev
镜头眩光不是场景本身,而是光线经过镜头和传感器后形成的成像现象。小范围光源周围的光晕已有很多处理方法,但大面积反射眩光可能覆盖整幅图像,并在不同视角下移动。如果直接把带眩光照片用于三维重建,三维高斯会把相机伪影当成真实物体,最终在空间里留下漂浮纹理。
论文把问题拆成二维去除与三维重建两部分。去除模型从预训练单步潜扩散图像模型出发,用真实大眩光与程序合成数据微调。训练集包含90段视觉特效素材的1,866张图,另留18段测试;论文还在128张实拍图上合成评测。数据分析显示,大范围眩光覆盖能量的中位面积约78.0%,而常用小眩光数据中的反射眩光只有0.39%,两者不是同一难度。
三维部分利用眩光相对相机主点的对称性,把眩光高斯约束在光源与主点决定的对称线上,再与场景三维高斯共同渲染。去眩光模型监督干净场景分支,原始输入监督场景与眩光的组合分支。这样得到的眩光不只是被抹掉,还可以重新渲染、编辑或迁移到新场景。
二维基准上,论文方法在大眩光测试集达到27.06 dB、结构相似度0.9409和感知距离指标(LPIPS)0.0659。五个多视角场景中,平均三维重建由18.68 dB、0.741、0.318改善为23.93 dB、0.837、0.220。三个指标分别反映像素误差、结构相似和感知距离,不能只挑一个最好值。
成本方面,单卡微调约20小时,而论文对比的一个基线训练超过4天;但联合三维优化仍需逐场景拟合,并非一次前向完成。对称先验也可能遇到未知镜头、复杂鬼影和错误光源定位。它最有价值的启示不是“扩散能修所有眩光”,而是把相机效应显式建模后,系统可以分别给场景真实性和艺术效果分配预算。
六、依赖增强分割方法(RankSEG-DEP):不重训模型,也能改变推理决策
RankSEG-DEP|On the Relaxation of Conditional Independence Assumption for Image Segmentation
作者:Zixun Wang、Ben Dai单位:香港中文大学统计与数据科学系首次公开:2026-09-30原论文:https://arxiv.org/abs/2609.38930项目 / 代码:https://github.com/ZixunWang/RankSEG-DEP
语义分割网络通常对每个像素输出类别概率,再逐像素取最大概率类别。旧版分割方法(RankSEG)会在推理时直接优化 Dice 或交并比,让最终掩码更贴近评测目标,却常假设给定图像后,各像素标签彼此独立。低对比度器官、小目标和模糊边界恰好违反这个假设:一个像素的判断往往要参考附近标签是否形成连贯区域。
如果完整建模所有像素之间的依赖,时间复杂度会达到 O(d³),其中 d 是预测维度,实际图像难以承受。新方法只保留空间局部依赖,并让相关性随距离衰减;随后用倒数矩近似估计每个候选体积的贡献,再用固定点迭代替代穷举,把复杂度降到 O(d log d)。
方法先在肝脏、肾脏和卫星图像三个数据集上测试,随后加入两个复杂自然场景数据集,检查这套后处理能否从医学和遥感图像扩展到日常街景。
骨干网络覆盖三种经典卷积结构,也补充了两种更现代的视觉变换器,说明作者没有只挑一种网络展示结果。
以其中一个通用分割骨干为例,在肾脏和肝脏数据集上,相对普通逐像素取最大值的做法,Dice 分别提高2.91和2.49点。
与基于条件独立假设的 RankSEG 相比,这两个数据集又提高0.51和0.37点;其中,最困难20%肾脏样本的增益更明显。
它展示了一种成本很低的产品路线:已有分割模型不必重新收集数据和训练,只需在输出端增加可解释后处理,就可能改善小目标和低对比度区域。但这不是免费的普遍增益。后处理仍有协方差结构和迭代成本,也依赖输入概率具有基本校准;如果骨干根本没有识别目标,局部标签依赖无法凭空制造正确语义。
它与 STM-Net 的共同点是局部可靠性。STM-Net判断时间邻居还能不能信,RankSEG-DEP判断空间邻居能不能补充证据。未来的视觉路由器可以把时间突变、空间模糊和任务风险统一成难度信号,再决定是否启用额外模块。
七、高光谱图像模型(HSI):场景差异可能比架构门派更重要
HSI Models|Hyperspectral Image Models: Technical Report
作者:Tanishq Rachamalla、Aryan Das、Srishti Kaushik、Swalpa Kumar Roy单位:Siddhartha Academy、韦洛尔理工学院、英迪拉·甘地国立开放大学、Tezpur University首次公开:2026-09-30原论文:https://arxiv.org/abs/2609.39871项目 / 代码:https://github.com/Tanishq251/Hyperspectral-Image-Models
前五篇都提出新方法,最后一篇首先修评测基础设施。高光谱图像的每个像素包含许多连续波段,模型横跨光谱—空间卷积、视觉 Transformer、Mamba、图神经网络、Kolmogorov-Arnold 网络和自监督掩码编码器。不同仓库使用不同张量顺序、补丁大小、标签映射和数据划分,模型差异常与实现差异混在一起。
该框架统一55个模型、六类范式和24个场景,自动适配4D或5D输入,并集中管理缓存、主成分分析、波段选择、补丁提取和随机种子。更关键的是,它同时提供类别平衡随机划分和空间不相交划分。后者在训练与测试区域之间加入隔离带,避免相邻补丁共享同一批像素而把准确率抬高。
总计1,320个模型—场景组合和6,600次带种子运行显示:Botswana 场景平均总体准确率为96.40%,Houston 2018 为56.70%,场景跨度约39.7个百分点;六类架构范式的均值跨度约15个百分点。没有一种范式在所有场景上占优,小于100万参数的模型还能匹配参数量大两个数量级的模型。
这组结果改变了“选模型”的顺序。团队不应先问 Transformer、Mamba 还是卷积谁最好,而应先识别传感器、空间分辨率、类别混淆和标注稀缺造成的场景难度,再在对应预算里选择架构。若训练测试窗口存在重叠,再大的平均分也可能只是在记住附近像素。
统一框架仍不等于最终裁判。模型超参数是否充分调优、每个场景的标签质量、不同范式的最佳训练配方,都可能影响排名。但它至少把代码接口、数据处理和随机种子变成同一把尺,为动态预算提供了可用的场景标签。
八、横向比较:六篇论文的数字为什么不能直接排榜
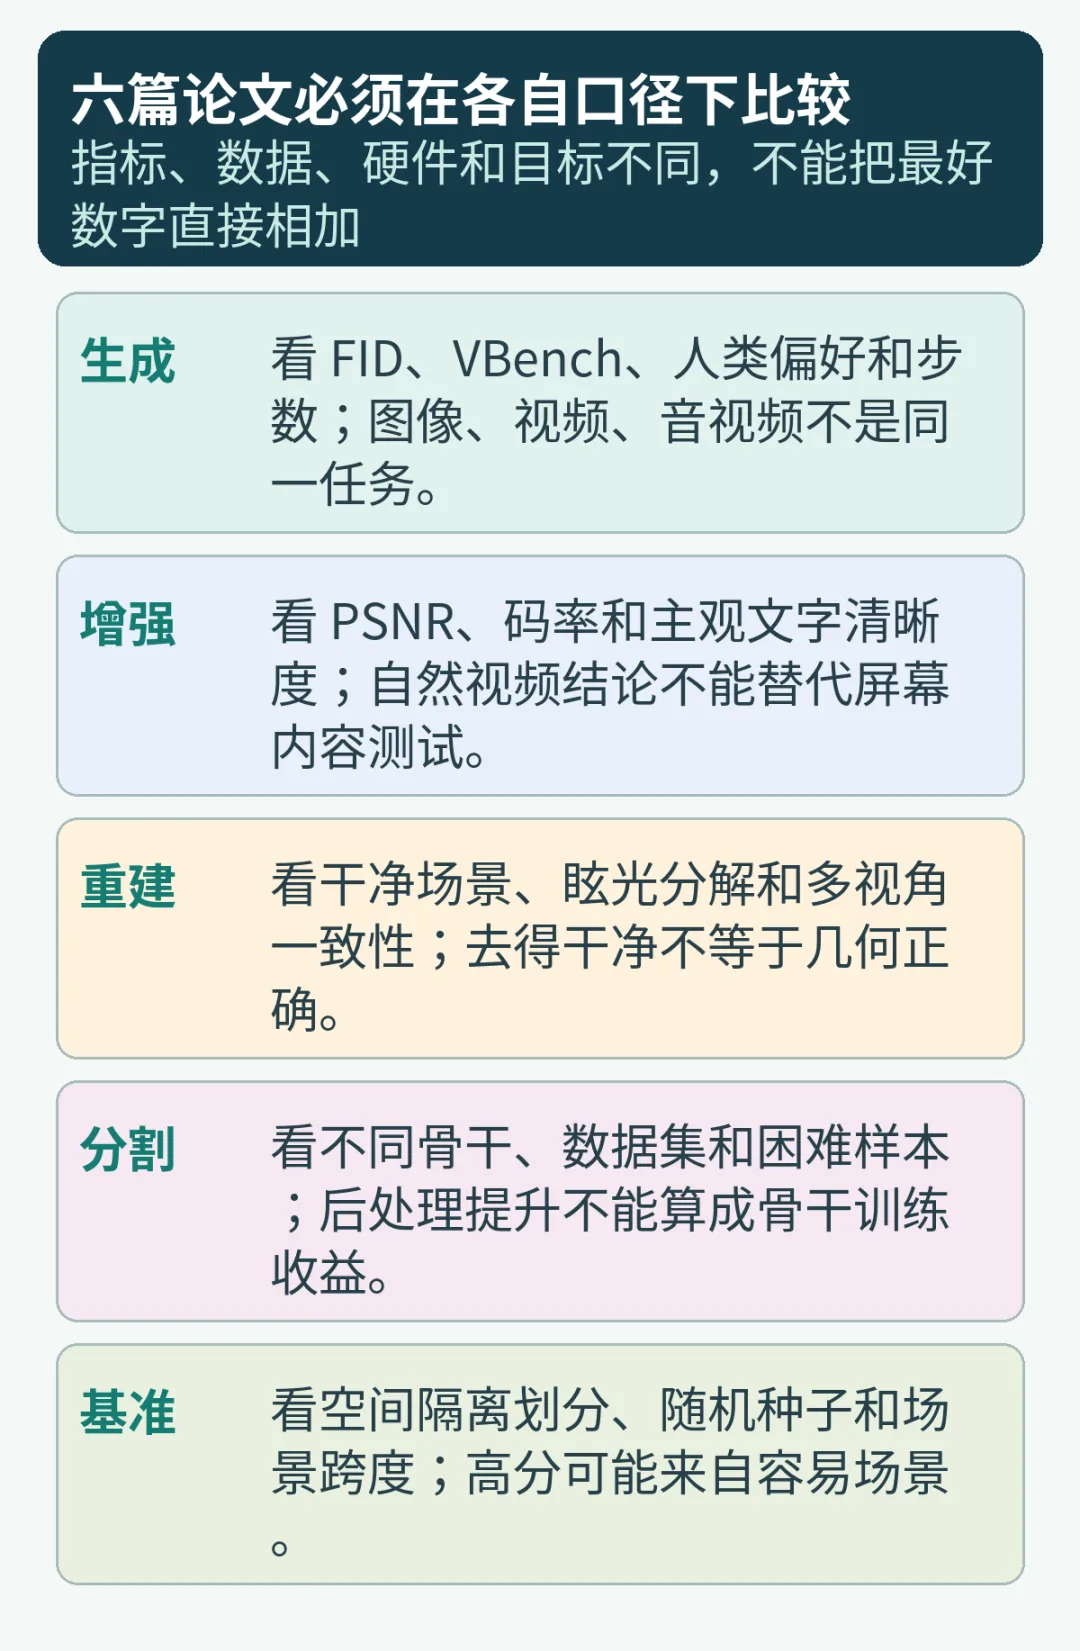
原创比较图:生成、增强、重建、分割和高光谱基准回答的问题不同,必须在各自条件下读取数字。
Looped-DiT 的核心比较是匹配参数或匹配计算下的生成能力;DMAD比较少步学生与多步教师;STM-Net比较压缩屏幕视频的像素质量和码率。
另外三篇也有各自口径:眩光论文同时比较二维去除与三维场景重建;RankSEG-DEP比较分割决策;高光谱报告比较模型与场景。六类分数没有共同分母。
训练需求也形成明显分层。RankSEG-DEP可以直接接在已有模型后,高光谱框架主要统一训练与评测;Looped-DiT和STM-Net需要训练专门网络。
DMAD依赖强教师和判别式蒸馏,眩光系统还要对每个多视角场景联合优化。不能因为最终推理快,就忽略训练和数据准备的成本。
数据规模更不能省略。STM-Net只有41段屏幕视频,眩光二维训练集是1,866张视觉特效图,高光谱覆盖24个场景和6,600次运行。前两者针对特定问题深入,后者覆盖架构广;它们分别回答“一个专门机制是否有效”和“跨场景规律是否稳定”,证据强项不同。
硬件口径目前并不统一。Looped-DiT报告相对推理计算,眩光论文报告单卡微调时间,STM-Net主结果强调码率,高光谱重点是参数量与重复运行。若要判断部署价值,必须在同一设备上补齐墙钟延迟、峰值显存、吞吐、能耗和预处理。参数少只是一个代理,不是成本本身。
失败边界也决定谁该被采用。循环可能反复放大错误,少步学生可能继承教师偏差,时间增强可能被切屏污染,眩光分解可能把真实亮物体误删,分割后处理可能过度平滑小结构,统一基准可能让默认超参数偏向某类模型。一个完整比较表必须把这些失败类型和平均分放在一起。
九、互补组合:让场景难度决定计算预算
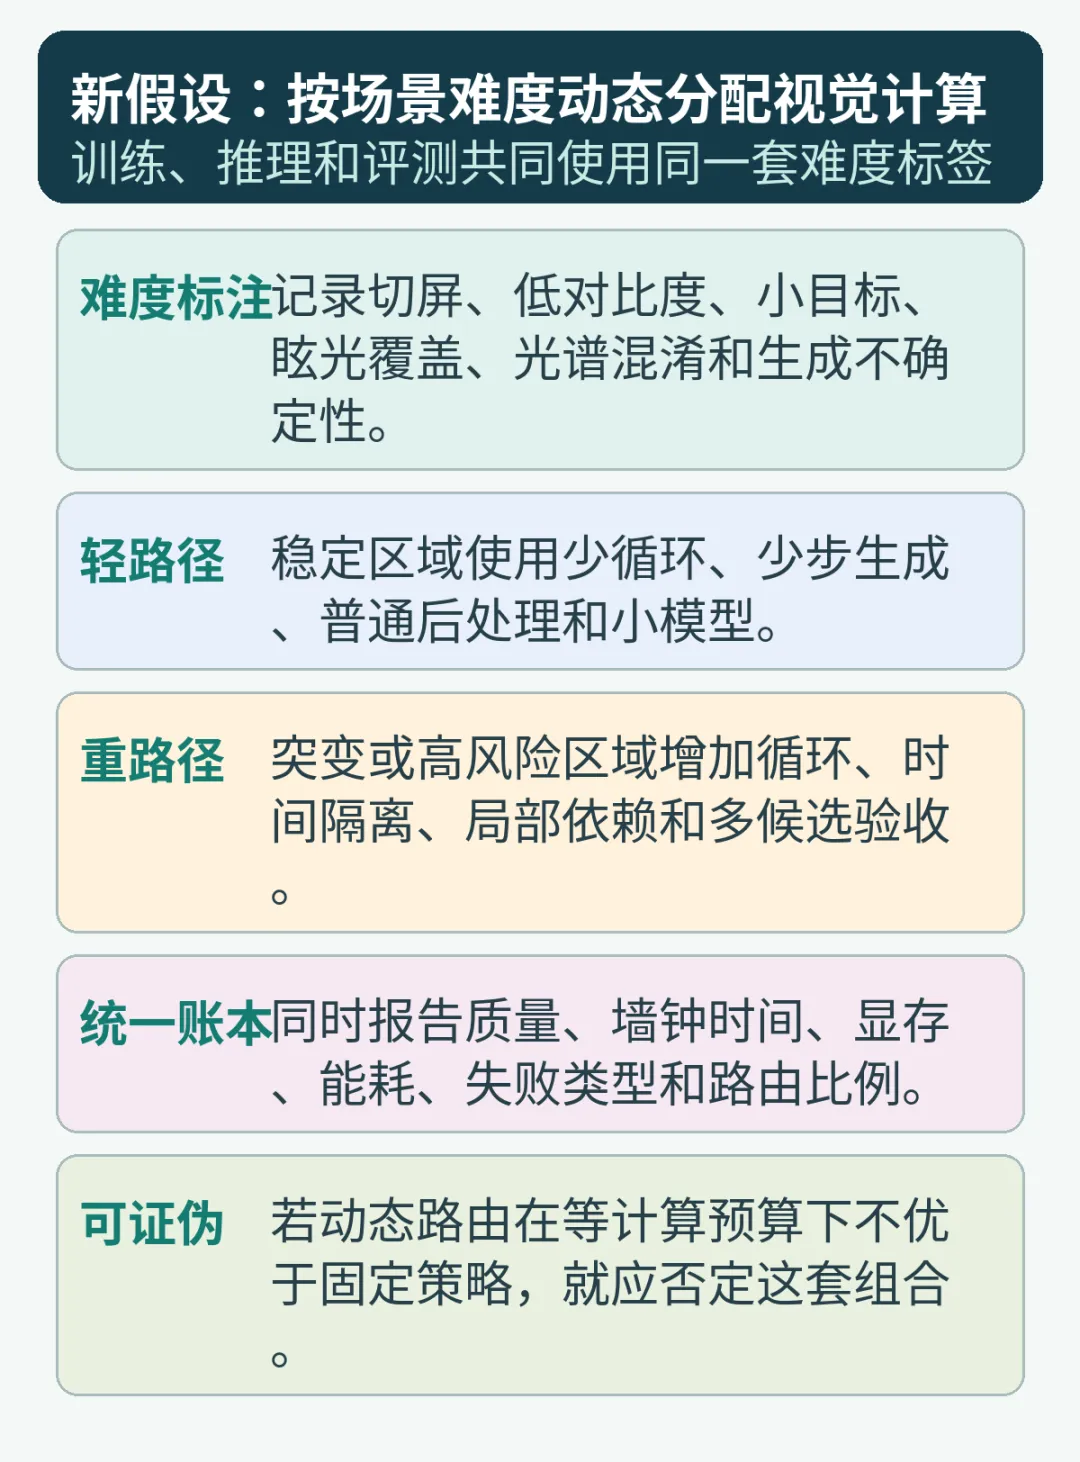
原创研究假设:把时间突变、空间模糊、眩光覆盖、光谱混淆和生成不确定性变成统一路由信号。
把六项工作连接起来,可以提出一个可验证的系统假设:视觉模型不再只选择一个固定架构,而是先估计场景难度,再分配计算。难度标签包括切屏与突发运动、低对比度与小目标、眩光覆盖比例、光谱类别混淆、生成中间状态变化量,以及输出对安全或业务结果的影响。
容易样本走轻路径。文生图在中间表示稳定时减少循环,生成模型使用一至四步学生,连续视频充分复用时间上下文,分割沿用普通逐像素决策,高光谱优先调用小于100万参数但在该场景验证过的模型。轻路径不是降低所有质量,而是避免给已经稳定的区域重复付费。
困难样本走重路径。复杂提示增加循环;切屏处隔离历史,避免旧画面污染;低对比度和小目标启用局部标签依赖;大面积眩光同时运行去除和显式分解;高光谱混淆区域调用更强模型或更多波段。若关键区域来自生成或分解结果,系统还应增加候选、回读检查或人工复核。
训练、推理和评测需要共用同一难度账本。若训练只记录平均损失、推理只记录平均延迟、评测只记录平均准确率,路由器很容易把最困难的少数样本隐藏在均值里。更合理的报告应包含各难度桶的质量、墙钟时间、显存、能耗、路由比例和失败类型。
这套组合并不是六篇论文已经完成的系统。循环早退、跨任务难度标注和等预算路由都需要新实验。它的价值在于给出明确可证伪条件:若动态路由在等墙钟或等能耗下不优于固定路径,或者困难样本的漏检抵消了节省,就应放弃组合,而不是继续靠更复杂的叙述解释失败。
十、三组实验,把组合从想法变成证据
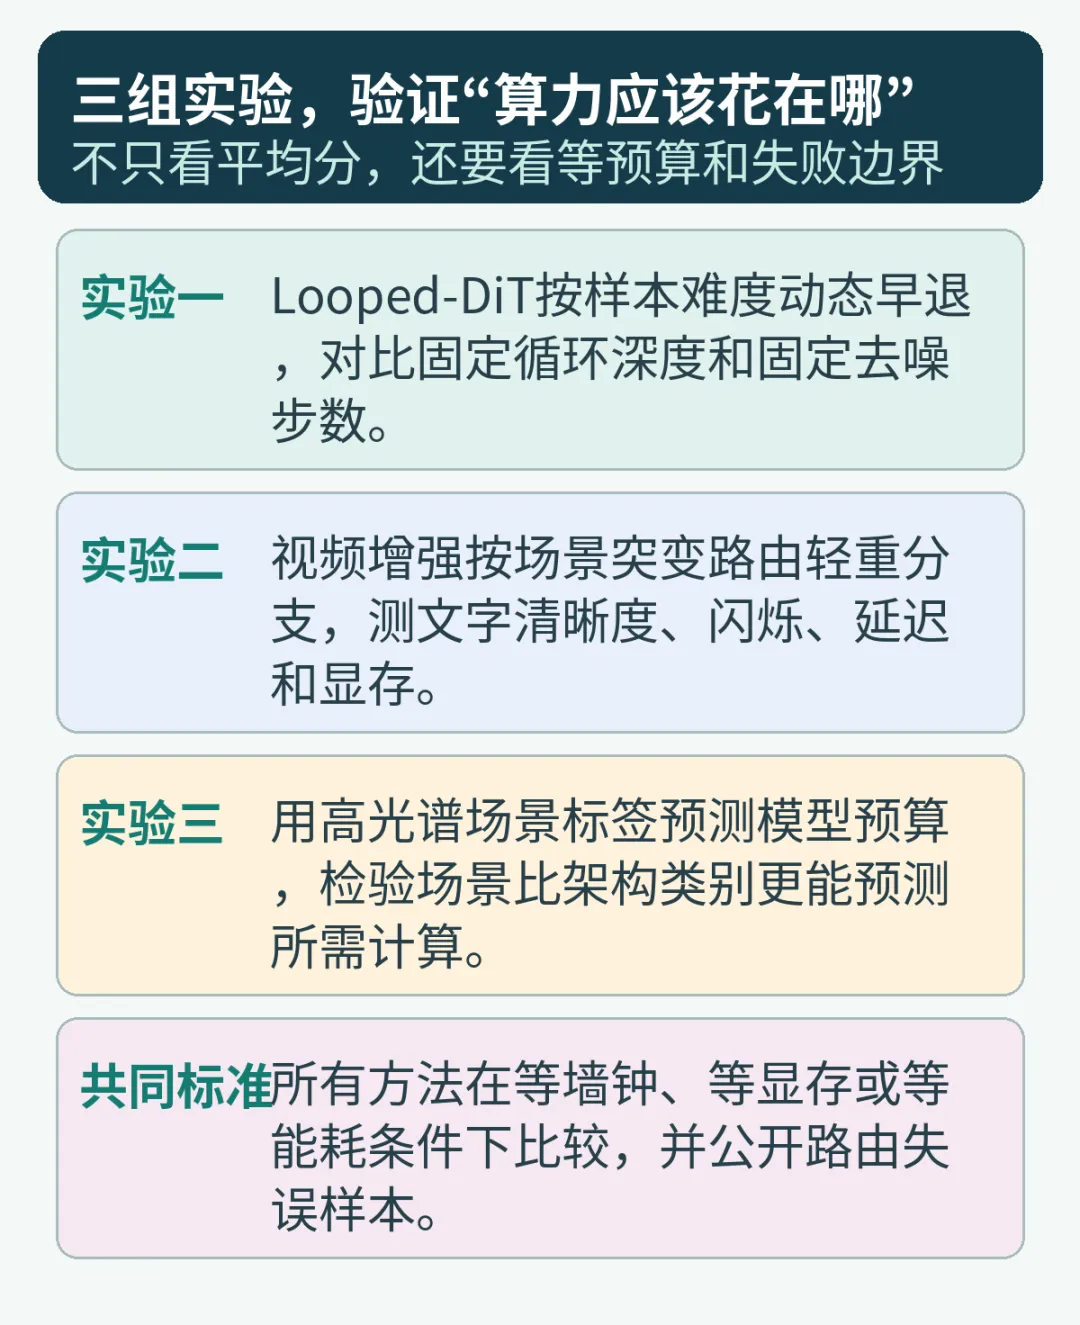
原创实验设计:分别验证动态循环、时空分流和场景预算预测,并要求公开等预算结果。
实验一:动态循环能否替代固定深度
在同一 Looped-DiT 骨干上训练一个轻量停止头,输入每轮特征变化量、跨注意力稳定性和中间图像不确定性。比较固定两次、固定四次、动态一至六次循环,以及增加去噪步数四种策略。评测不仅看生成分数,还要报告平均循环数、最慢百分之一延迟、复杂关系错误和过早退出比例。
关键控制是等计算比较。动态方案若平均使用三次循环,就应与固定三次或等总浮点计算的基线比较。若只让困难样本多算、容易样本少算后平均质量提高,才能说明路由有效;若收益主要来自总计算增加,就只是换了一种扩大预算的方法。
实验二:场景突变路由是否能兼顾清晰度与速度
把屏幕内容视频按稳定滚动、局部弹窗、全屏切换和高速游戏分桶。轻路径只使用当前帧与短时上下文,重路径启用完整双向时间模块和多尺度高频蒸馏。对比固定轻模型、固定重模型和动态路由,报告文字识别率、PSNR、时间闪烁、码率、显存与每帧延迟。
路由器最危险的错误是把切屏识别成连续运动。实验应单列误路由片段,并测量旧文字残影持续多少帧,而不是只汇报整库平均值。若重路径节省有限,却增加明显切换延迟,产品上可能更适合直接在切屏处重置历史,而不是引入复杂路由。
实验三:场景标签能否预测所需模型预算
利用高光谱统一基准的24个场景,提取空间分辨率、类别数、光谱相似度、训练样本密度和区域混淆等标签。让路由器在看不到测试标签的前提下,为每个场景选择小模型、中模型或大模型,并与固定选择同一模型比较。目标是在准确率下降不超过预设阈值时,最小化训练与推理成本。
进一步可以把眩光覆盖率、分割边界模糊度和生成中间不确定性映射到同一预算预测任务。若“场景条件比架构类别更能预测所需计算”在多个任务成立,视觉系统就有理由先建设难度识别和成本路由,而不是每次出现新架构都整套替换。
十一、工程落地:四条比“直接换大模型”更具体的建议
第一,建立样本级成本日志。每次训练和推理都记录输入难度、实际循环数、生成步数、启用的支路、后处理次数、显存和墙钟时间。没有样本级日志,团队只能知道模型平均很快,却不知道最困难请求是否在高峰期拖垮服务。
第二,把路由器当成独立模型验收。动态计算系统的主模型分数再高,如果路由器漏掉切屏、小目标或大眩光,重路径就不会启动。路由召回率、误触发率和失效保护必须单独报告;高风险场景宁可多算,也不能只追求平均节省。
第三,区分训练成本、部署成本和评测成本。DMAD把成本前移到蒸馏,RankSEG-DEP把成本后移到决策,高光谱框架把成本投入可复现评测。三者服务的阶段不同。预算表应按一次性训练、每次请求、每个场景适配和持续评测分栏,而不是只放一个参数量。
第四,先检查场景,再选架构。屏幕内容视频不能直接照搬自然视频增强,高光谱场景不能只按模型门派排名,眩光也不能当成普通噪声。数据特性、错误来源和验收目标明确以后,循环、蒸馏、分流或后处理才有选择依据。
十二、龙哥点评:下一轮竞争是“谁更会分配算力”
这组六篇论文最值得关注的不是某个新模块名称,而是研究问题正在变化。过去常问“同样数据下谁的模型更大更强”,现在更值得问“同样预算下,谁知道什么时候继续算、什么时候停止、什么时候换一条路”。
Looped-DiT与DMAD分别从深度和步数改写推理过程。
STM-Net和RankSEG-DEP从时间与空间改写信息使用方式;眩光与高光谱工作则提醒系统先分清错误来源和场景难度。
其中最有潜力的组合是“场景难度路由加共享计算块”。共享参数降低模型切换成本,难度路由决定同一块运行几次、读取哪些上下文、是否启用后处理。相比维护多个完全独立的大模型,这条路线更容易控制版本、一致性和显存,也更适合边缘设备与云端弹性服务。
最需要警惕的是把动态计算写成新的免费午餐。路由判断、判别蒸馏、候选验收和三维分解都消耗资源,且最慢请求通常来自最困难样本。未来论文应少报“平均少几步”,多报尾部延迟、失败路由和等能耗结果;少报跨任务最好数字,多报统一硬件和完整服务链。
综合来看,视觉AI的下一轮效率竞争不会只是把模型做小,而是让模型知道算力应该花在哪里。如果场景难度能被稳定识别,固定模型就可以变成可伸缩系统;如果难度识别不可靠,再聪明的动态路由也只会把错误藏得更深。
主要论文与公开入口
Looped-DiT:Looped Diffusion Transformerhttps://arxiv.org/abs/2609.40305https://github.com/OpenSenseNova/Looped-DiT
DMAD:DMAD: Distribution Matching as Adversarial Distillation for Fast Visual Generationhttps://arxiv.org/abs/2610.02188https://yzmblog.github.io/projects/DMAD
STM-Net:Spatial-Temporal Multi-scale Network for Screen Content Video Quality Enhancementhttps://arxiv.org/abs/2609.39894https://github.com/HUANGZiyin1/STM-Net
Flare-3DGS:Lens Flare Removal and Reconstructionhttps://arxiv.org/abs/2609.39527https://lensflare-3dgs.pages.dev
RankSEG-DEP:On the Relaxation of Conditional Independence Assumption for Image Segmentationhttps://arxiv.org/abs/2609.38930https://github.com/ZixunWang/RankSEG-DEP
HSI Models:Hyperspectral Image Models: Technical Reporthttps://arxiv.org/abs/2609.39871https://github.com/Tanishq251/Hyperspectral-Image-Models
本文基于龙哥读论文PaperDaily数据库及PaperMiner的MCP进行汇总整理。本文为论文解读与个人学习笔记,不构成任何论文审核意见,及对产品能力、安全性或商业可用性的保证。不同论文的任务、数据、硬件和评测协议不同,不作跨论文总排名;正文研究图卡均为依据已核验信息重新绘制的原创示意。