ARTICLE · 1118769
诛(朱)AI,清自来?
连经典的《荷塘月色》都证明不了是作者本人写的,你的 AI 稿还敢说归你?
— 图:当算法开始替我们判定「谁是人」
在 AI 时代,权利的新门槛,正从「你生出了什么」挪到「你怎么生出来的」。
—— 沛学策·企业创新保护观察
本文看点
01
只拿提示词打官司,长沙这案怎么就输了
02
把「过程」存成证,贵州北京怎么就赢了
03
美国把 AI 改名 SI,动了你的确权门槛
1927 年 7 月,朱自清在清华园写下《荷塘月色》。九十九年后,几款 AI 检测工具把它标注成了「高 AI 率」。新华智见等媒体 2026 年 9 月集中报道过这事儿,连《流浪地球》的剧本片段、一些经典论文,都被同一类检测工具判了「疑似机器生成」。
我第一次看到这个新闻,发呆了很久。
我的天啦,一位去世的散文家,他也没法跳出来对着现在的算法喊:「这真是我写的啊~」。他没有「自证清白」的机会,因为「我是人」这事儿,从来不用活人去证明,直到机器开始替我们判定,呵呵……
过去认「这是你的」,看看你交付的结果长什么样就行。现在的结果,恐怕分不出是人还是机器做的。你拿不出过程证明,估计压根说不清。
现在全网都在问:用 AI 画的图到底算不算我的?我的判断是,这个问法本身存在方向偏差,真正该较真的不是「它归谁」,而是「你怎么证明它是你生的」。
这里我想重点提示一下:AI 时代,权利的新门槛,正从「你生出了什么」挪到「你怎么生出来的」。
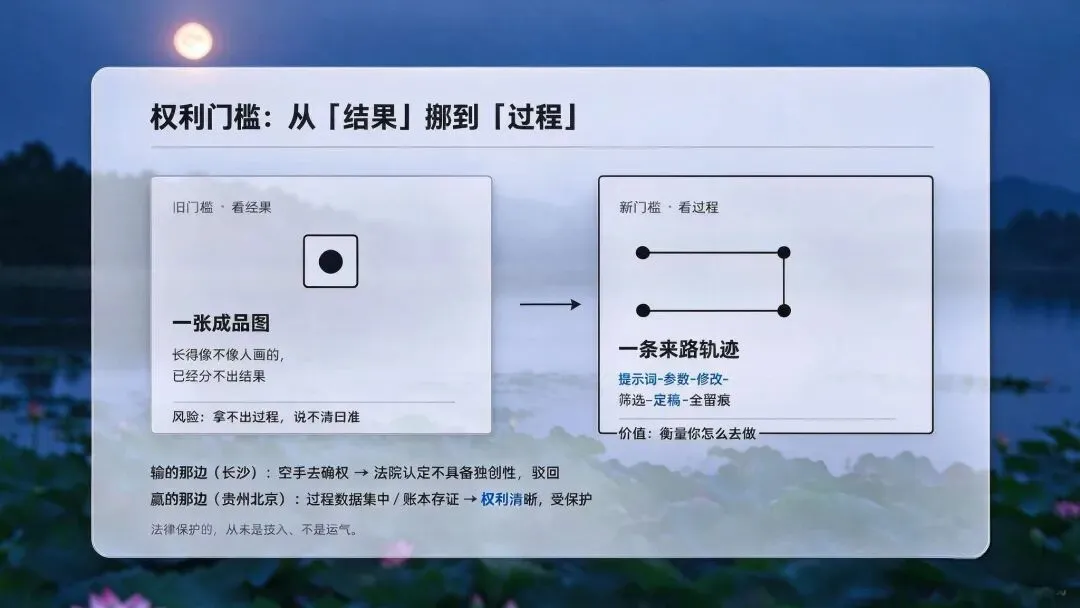
— 图:权利门槛,正从「结果」挪到「过程」
01
THE LOSS
输的那边:只拿提示词去打官司,输了
长沙市开福区人民法院审过的一个案子,本篇适合当反面教材。原告马某林从他人手里受让了一张 AI 生成的端午节香囊图,发现被长沙某幼儿园的公众号用了,就把幼儿园告了,要著作权,索赔一万元。
证据很单薄,基本就是那句提示词,加上最后那张图。原图怎么来的?案外人用即梦 AI输入「端午节香囊,五颜六色,中式风格」这类概括词生成的,事后只拿修图软件删了重复的字。
法院没支持。我看了裁判要点,法院用的是「三层次审查」:先把 AI 生成过程拆成前端构思、生成控制、后端加工三层,再看每一层有没有人的独创性投入。这位原告的图只过了生成控制和后端加工两层,而且都不够:提示词只是题材和风格的笼统要求,没对造型、构图、光影做个性化选择;后期只是删了个错字。法院认定:不具备独创性,不是著作权法保护的作品。
我个人理解,不是说 AI 出的图一概没著作权,是他给出的证据,撑不起「这是我的创作」。
「输在哪?输在没留痕。提示词一键生成,几秒钟的过程。法律保护不了你,因为它看不见你。」
你也可能会杠:我就随便玩玩,谁跟我抢?先别急,往下看企业那段。
02
THE WIN
赢的样板:把「过程」存成证,权利就稳了
同样的 AI 内容,贵州却走了另一条路,而且走成了全国首例。
2026 年 9 月,贵州天阅科技有限公司把 AI 漫剧《摄政王的心尖宠重生了》的「创作过程数据集」(从剧本推演、提示词打磨、分镜制作到画面重绘、参数多轮调试的全流程轨迹)在贵州省知识产权局做了数据知识产权登记,拿下了全国首张 AI 漫剧过程数据确权证书。证书保护的不是最后那帧画面,是你生产这帧画面的方法链。
我得说,这思路对普通人太友好了。
北京也有对照样本,而且更「出圈」。北京互联网法院 2023 年判的李昀锴诉刘某案(案号 (2023)京0491民初11279号),原告用 Stable Diffusion 输入几十个提示词、反复调参数,生成了《春风送来了温柔》,被被告盗去当文章配图还去了水印。法院认定这张图体现了人的独创性智力投入,是受保护的美术作品,判赔 500 元。钱虽不多,定性清楚:人对生成过程投入越多、控制越具体,产出越容易被认定「有著作权的作品」。
大家看出差别了吗?长沙那位是「我让机器出了张图」,贵州和北京这两位是「我有一整套怎么出这张图的记录」。前者是空手去确权,后者揣着账本去确权。
「法律保护的,从来是投入,不是运气。」
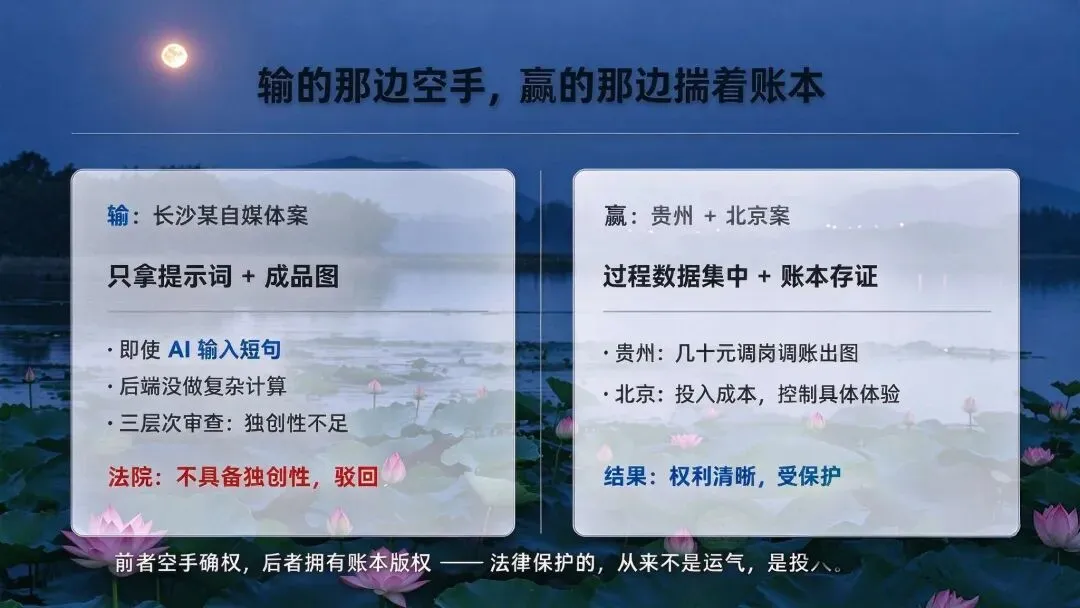
— 图:输的那边空手,赢的那边揣着账本
03
THE RENAME
美国把 AI 叫成「超级智能」,没那么简单
美国把 AI 改名叫 SI,Super Intelligence,超级智能。网友玩梗说 AI 变 SI(死),是个谐音笑话。我得坦白,一开始我也觉得就是个翻译梗,直到把几份材料连起来看。
版权法有个默认前提:作品得有「人类作者」。AI 叫「人工智能」时,它还是工具,工具产出那得归用工具的人吧,这逻辑该没毛病。可 AI 一旦被重新定义成「智能」、甚至往「主体」靠,归属的默认假设就开始摇晃。
更阴狠的还在另一头。黄仁勋讲「SI Factory」,把 AI 产出说成「工厂产品」,悄悄把创作者的「作者人格」稀释成「按了启动键的产线工人」。
这些人,一边把 AI 往上抬成智能主体,一边把人的贡献往下压成产线操作,两头挤,中间原创者的位置就悬空了,这算啥事?
在这里我得停一下:不是说明天中国的法律就得改了,没那么快的。是说命名本身它是一种权力。当「AI 是工具」的共识被动摇,你手里的确权证据,得比现在厚。
图之外还有声音,这个案子我得单独夸。上海一中院 2026 年 9 月 29 日二审维持了上海首例 AI 合成语音侵权案:配音演员王女士发现自己的声音被 A 公司,拿去训练、合成后作商用,起诉索赔 30 万,一审判赔 5 万,双方上诉后二审维持。重点不在那 5 万上,而是在一条规则里:权利人只要证明「声音有被获取的公开渠道」且「合成声和她高度相似(鉴定显示相似度约 90%)」,初步举证就完成;之后举证责任倒过来,由掌控训练数据的平台证明「我没用你的声音」。
「你被冒用声音,平台和控制方先担起来。」
04
THE LEDGER
老板的账本:企业端也开始算细账了
企业端的判例,也开始把账算细。武汉市江岸区人民法院刚判了湖北首例 AI 短剧著作权案:A 公司用 AI 辅助做出 47 集微短剧,上线一天就被 B 公司整部改名搬走、插播广告。法院认定这部剧是受保护的视听作品,判赔 2 万,数额不大,但法官把「生成调用了多少词元(Token)、花了多少算力」算进了赔偿考量。
信号很明确:法院开始认 AI 内容背后的真实投入,你没留记录,就等于放弃这部分举证权。
海外对控制方更不客气。Strike 3 Holdings 诉 Meta 案(案号 5:25-cv-06213-EKL,加州北区法院),原告指控 Meta 用 BitTorrent 下载上千部盗版片训练 Meta Movie Gen 等模型,最高索赔约3.59 亿美元。2026 年 6 月 11 日,Eumi K. Lee 法官驳回了 Meta 想直接掐掉诉讼的动议,案子进入证据开示。还没判,但方向清楚:你控制数据源,你就得证明数据来得干净。
韩国音乐著作权协会(KOMCA)已在帮创作者跟平台谈训练数据授权和分成。番茄小说是反面例子,有作者曝光被要求签协议,默认授权平台拿自己的书去训练 AI。
我遇过不止一回这类咨询。变种很多,内核就一个:你的产出被拿去喂模型了,签合同时你根本没注意到那行小字。等你想主张「这是我写的」,对方拿出你签过的授权,你才发现自己早把钥匙交了出去。
05
THE LOOP
请教个有意思的问题:这个闭环里,卷子归谁?
作为一名初中生家长,评论区有句话我印象尤为深刻:学生用 AI 答题,老师用 AI 批卷,这个闭环里卷子到底归谁?
有人答得清么,哈哈~
不过我们可以先自问一个更 practical 的:你公司那些用 AI 做的图、文案、设计稿,如果明天被哪家供应商挪去用了,你还拿得出「这是我一点点调出来的」证据吗?
「这道题我没答案,想听听你们的。」
最后,回到那片荷塘。朱自清不用自证,因为他的过程是这漫长的时间。我们这代人没这份奢侈,过程得自己留。AI 把「结果」搅成一锅粥,能把你捞出来的,只有你亲手写下的那条来时路。
清白不会自己来的。它得我们一点一点的,留出来。
最后说句可能得罪人的话:别再光喊「AI 让我失业了」,先搞清楚「AI 出的东西归不归我」吧。这两件事儿,后者才是真刀真枪的账。
我是沛学策,专注企业创新保护与知识产权经营。把热闹背后的门道,掰开揉碎讲给您听。
如果今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见。