ARTICLE · 1119536
OpenClaw 2.0:本地记忆检索老是超时,workspace使用单一SQLite是个很蠢的设计
最近,本地记忆检索又开始频繁超时。
memory_search 有时正好卡到 15 秒,随后进入 60 秒冷却。索引状态显示正常,identity valid,向量也完整;冷查询和 Memory + Wiki 混合检索却能跑到 14 秒左右,只差一点就碰到工具层的硬上限。
我最先怀疑全量索引。它确实制造过一次严重事故,但继续排查以后,问题比“重建太慢”更宽。增量同步与全量同步共用 reindex lease,前台搜索只有固定的 15 秒预算,高频会话写入、可重建的向量索引和 Embedding cache 还挤在同一个 Agent SQLite 里。数据库接近 2 GB 时,即使没有正在运行的 full reindex,冷检索也已经逼近超时线。
全量索引只是排查过程中发现的一条故障链。它最容易复现,也最能暴露这套设计的问题。OpenClaw 2026.9.2 的一次 Memory full reindex 让 memory_search 频繁超过 15 秒,Session 增量同步拿不到锁,Gateway 心跳延迟几十秒,飞书 WebSocket 重连。进程还活着,聊天、搜索和后台维护却开始互相掐脖子。
SQLite 和 Embedding 服务都正常。OpenClaw 把延迟要求、写入频率和可重建属性完全不同的数据放进同一个故障域,再用固定超时把慢查询、锁竞争和全量维护压成同一句“记忆检索超时”。
10 月 2 日晚,这套故障又完整演了一遍。
22 时 19 分起,Gateway 日志开始密集出现 slow SQLite transaction hold。心跳连续晚到两三秒,随后越来越慢。22 时 27 分,系统尝试优雅重启。按设计,它会先等正在执行的任务收尾;当时队列里只剩两个任务、一个待回复和一个 Cron,数量并不夸张。
它等了 315 秒,还是没等完。
22 时 32 分,Gateway 记录 active-work drain timeout reached,写出一份 255 KB 的稳定性现场包,然后强制结束旧进程。到这里还可以把问题解释成某个任务不肯退出。新进程起来以后,解释不通了。
22 时 41 分,启动同步报错,Memory reindex lease 仍被占用。SQLite 的 transaction hold 与 lock wait 接着刷屏。22 时 43 分,事件循环单次停顿 21.1 秒,心跳一次隔了 64.7 秒才回来。进程列表里 Gateway 仍然活着,飞书和搜索却已经接近不可用。
22 时 48 分,一次 memory_search 开始执行。随后事件循环停了 58.7 秒,心跳晚了 47.9 秒。这个工具原本有 15 秒搜索上限,外层又有 90 秒 watchdog,最终直到 22 时 53 分才被 watchdog 终止。那一刻,心跳计时已经拖到 239.5 秒。
22 时 59 分,事件循环又停了 101 秒。日志里的 CPU core ratio 只有 0.113,不像算力被吃满;系统大量时间耗在同步数据库工作和等待上。一个声明 15 秒超时的工具,连负责超时的 JavaScript 定时器都不能按时醒来。
我把 22 时 15 分到 23 时 05 分的日志单独数了一遍。短短 50 分钟里,有 84 次 slow SQLite transaction hold、10 次 slow SQLite transaction lock wait、8 次 Memory reindex lock is held。事故发生时,phxpersonal 的 Agent SQLite 已经长到 2,461,954,048 字节,约 2.46 GB。
旧事故发生在一次 full reindex 期间;昨晚的新事故在重启前后都持续出现,普通 Session 更新和一次前台记忆搜索就能重新撞上同一条共享写入通道。重启清掉了进程,没有拆开故障域。
用户看到的是一句“记忆检索超时”。机器内部发生的是另一回事。Session 更新拿不到 reindex lease,SQLite 长事务占着事件循环,心跳和飞书请求一起晚到,连关闭进程都要等五分多钟。把这些工作塞进一个库以后,任何一项变慢,整个 Agent 都得陪它排队。
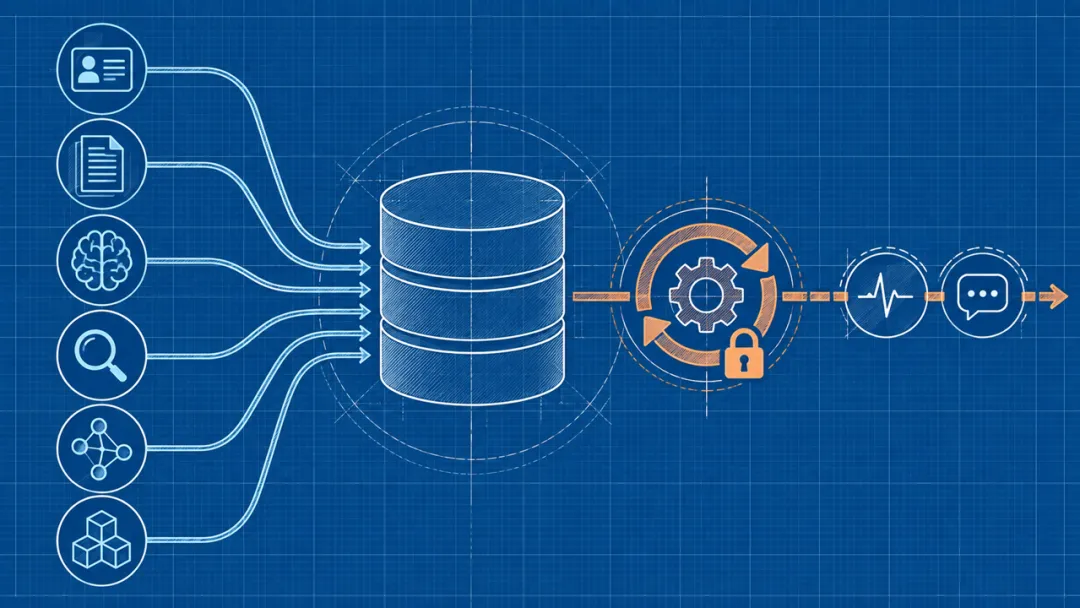
事故时,这个 Agent 数据库里已有下面这些数据。
1,020 个索引文件; 17,395 个 chunks; 1,536 维 Embedding; 467 MB chunk 数据; 523 MB Embedding cache; 1.66 GB Agent SQLite; 65 MB WAL; 主机已使用约 5.4 GB Swap。
Memory 最终发布需要触碰超过 1 GB 数据。日志中的 SQLite 长事务单次达到 55 至 66 秒;Gateway 心跳延迟 44 至 59 秒,飞书连接随之重连。
索引没有损坏,Embedding probe 正常,Memory 源文件也没坏。系统只是把一次可以慢慢做、失败后可以重来的索引维护,安排在了会话和聊天记录共用的唯一写入通道上。
这颗雷是怎么埋进去的
2026 年 7 月 11 日,OpenClaw 合并 PR #98236[1],把 Session metadata 和 Transcript events 正式切换到 SQLite,旧的 sessions.json 与 active transcript JSONL 不再作为运行时 fallback。
这个决定解决了文件之间可能漂移的问题,也创造了更大的问题。Session、Transcript、Memory、FTS、Vector 和 Embedding cache 开始争用同一个 SQLite Writer 和 WAL。
这些数据的负载特征完全不同。
Session 状态是核心数据,需要低延迟、小事务和强恢复; Transcript 是持续追加的事件流; Memory source 与 chunks 是派生数据,可以重建; FTS 与 Vector 是索引,应当按 generation 发布; Embedding cache 是缓存,应该可以随时删除。
OpenClaw 却用“统一数据模型”把它们变成“一处维护,全局等待”。事务一致性做到了,故障隔离被删掉了。
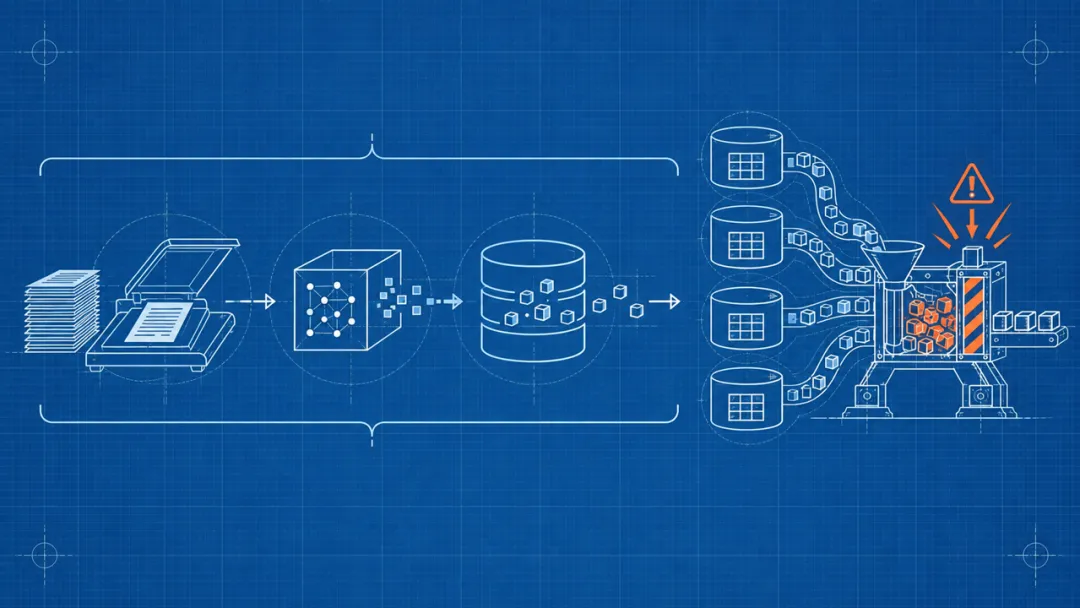
第一处代码,一把锁包住整个重建生命周期
事故版本 v2026.9.2 的 manager.ts 有下面这段代码。
const lock = awaitwaitForMemoryReindexLock(databasePath);try {awaitrunSync(params);} finally { lock.release();}这把 lease 覆盖了整个重建过程。runSync() 里面包含文件扫描、Provider 初始化、Embedding 生成、shadow DB 构建、失败重试、最终发布和清理。
full reindex 一开始,其他增量同步面对的就是被占用的整个重建生命周期。
其他任务只等两秒。manager-reindex-lock.ts 直接写死了等待时间。
constREINDEX_LOCK_WAIT_TIMEOUT_MS = 2_000;重建可以跑几十秒甚至更久,增量同步只等两秒,然后报出下面的错误。
Memory reindex lock is held ... another reindex is active.它没有可靠排队,也没有在 full reindex 完成后自动追赶。一个低频重任务拿着长 lease,高频任务两秒后自己滚蛋。这套调度实际在驱逐前台任务。
第二处代码,所谓“短事务”实际重写整套索引
OpenClaw 会先在 shadow DB 里完成大部分构建,这一步没问题。事故发生在最后发布。
manager-db.ts 用 runSqliteImmediateTransactionSync 开启一个 IMMEDIATE 事务,然后在同一个事务里完成下面这些动作。
DELETE + COPY sourcesDELETE + COPY chunksDELETE + COPY recall metadataDELETE + COPY provenanceDELETE + COPY embedding cacheDELETE + REBUILD chunk FTSDELETE + REBUILD path FTSDELETE + REBUILD vec0COMMIT源码注释把它称为 “one short transaction”。生产数据不同意。
Issue #143640[2] 对完整表集做了拆分测量。14,138 个 chunks 的发布总耗时约 43.47 秒,其中 memory_index_chunks_vec 单表约 33.44 秒,占事务主体约 81%。
问题还不能靠常见的 _next → rename 轻松解决。该 Issue 验证了 sqlite-vec v0.1.9 的 vec0 表在 ALTER TABLE ... RENAME 后会出现父表改名、内部辅助表不跟随的情况。命令表面成功,下一次查询才报错。于是普通表可以做原子换代,vec0 仍需要单独路线,或者干脆放进独立 generation 文件。
OpenClaw 没有拆文件,vec0 重建继续占用 Session 和 Transcript 也要使用的 Writer。
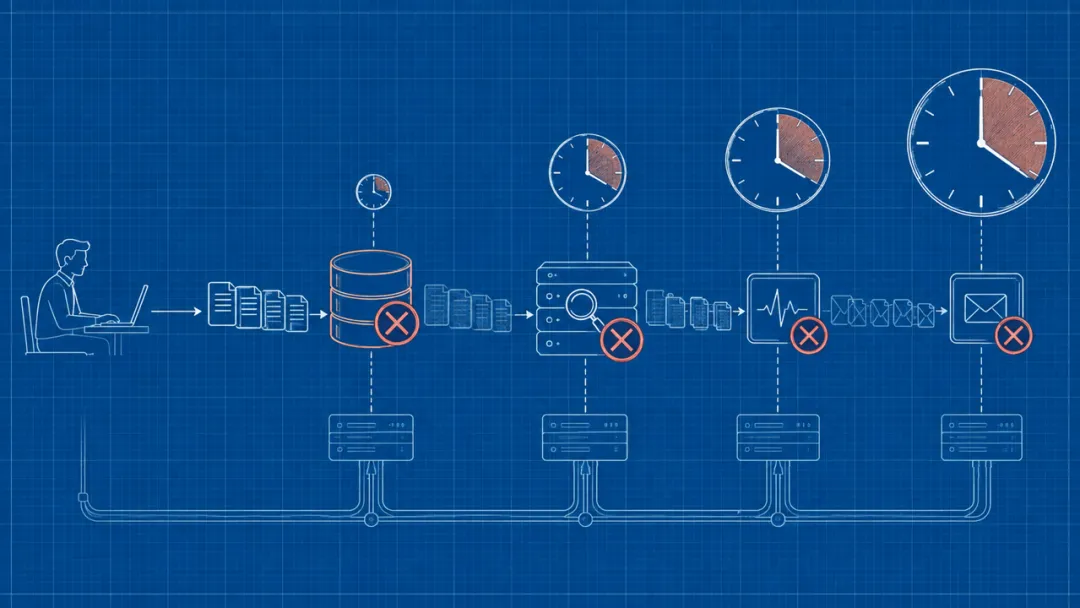
第三处代码,前台写入只有五秒活路
同一个 Agent DB 的普通写入依赖固定 busy timeout。Issue #143640 展示了下面这个典型错误。
operation=agent.writestep=begintotalMs≈5400SQLiteError: database is lockedstep=begin 说明写入甚至没有进入事务。它在门口等满五秒,直接失败。
发布事务会随索引规模增长,前台写入预算却固定为五秒。于是规模小时一切正常,规模大到某个阈值后突然坠崖。
Issue #148307[3] 又给出另一条同类路径。Session reclamation 可以运行 9 至 47 秒,而 Writer 仍只有五秒。到 2026.9.6,仍有人报告锁错误后 turn claim 没有释放,后续消息连续失败,只能重启 Gateway。
同类故障已经扩散到 Session maintenance。“大维护任务 + 固定超时 + 单 Writer”才是共同结构。
第四处代码,搜索十五秒超时,失败还要再罚一分钟
memory_search 的默认截止时间也写死在代码里。
constDEFAULT_MEMORY_SEARCH_TIMEOUT_MS = 15_000;工具层超时后还有 60 秒 cooldown。
constMEMORY_SEARCH_TOOL_COOLDOWN_MS = 60_000;于是用户会经历下面这条失败链。
第一次冷查询或锁等待超过 15 秒; 工具返回超时; Agent 立刻重试; 第二次并没有真正查询,只是把上次的超时结果再播一遍; Agent 误以为搜索连续失败两次。
Issue #128140[4] 至今仍是 Open 状态。独立安装在 315 次调用中记录到 38 次固定预算超时,失败率 12.1%。把 deadline 从 15 秒改成 30 秒,也只能让同一条冷路径晚一点超时。
提高 timeout 是止痛片。数据库仍在争锁,冷 manager/index 生命周期仍在耗时,Agent 仍然把“现在比较慢”误判成“记忆不可用”。
一次重建,为什么能拖死整台 Agent
把上面的代码串起来,故障链就很清楚了。
identity、chunking、Provider 或失败恢复条件触发 full reindex; reindex lease 包住整个 runSync();shadow build 完成后,发布进入单个 BEGIN IMMEDIATE;chunks、FTS、vec0、Embedding cache 在同一事务中重写; Session、Transcript、审批回调、Cron 状态都在等待同一个 Writer; 五秒后,前台写入开始报 database is locked;十五秒后, memory_search超时;心跳、WebSocket 和群消息处理继续排队; 失败可能留下 retry-dirty,下一次普通同步再次升级为 full reindex。
OpenClaw 2.0 把统一存储当成了统一可靠性,最后得到的是统一爆炸半径。
GitHub 上的 Issue 已经把问题拼完整了
截至 2026 年 9 月 26 日,下面这些 Issue 全部仍然开放。
#143640[5],full index publish 在单个 IMMEDIATE事务中重写索引,耗尽并发写入的五秒预算;#128140[6], memory_search固定 15 秒超时,60 秒 cooldown 会重放旧错误;#145403[7], sessions.history.read曾把外部 visitor callback 包在 SQLite 事务里,最长冻结 Gateway 465 秒;#119720[8],同步 Agent persistence 与 Transcript maintenance 在规模上升后阻塞 Gateway event loop; #148307[9],Session reclamation 超过 busy timeout,前台写入失败; #112423[10],大型 Transcript cleanup 阻塞 Gateway; #114612[11],Memory chunks 与 Embedding cache 长期膨胀; #138326[12],busy timeout、WAL autocheckpoint 和 Embedding concurrency 仍缺乏可配置入口。
这八个 Issue 拼出同一套架构的不同故障路径。一个越来越大的共享 SQLite,承载越来越多同步工作,再用固定超时掩盖无法保证的延迟。
上游修了很多,但还没有拆掉炸弹
上游已经合并了多项修复。
PR #131121[13] 已进入事故版本 2026.9.2,给 Embedding cache 设置 50,000 条上限。它能阻止 cache 无限增长,但不能立即缩小已经膨胀的数据库,也不改变 full publish 的事务边界。
PR #149901[14] 进入 2026.9.5,把 Memory publication 放进 SQLite Worker broker 和 writer queue。Gateway 在大规模发布期间明显更能响应。PR 明确说明,竞争写入仍会串行等待,它不承诺缩短 SQLite lock tenure。
2026.9.6 又加入三类改进。
PR #148630[15],自动 Session maintenance 移到 Worker; PR #153818[16],Transcript payload 在取得 Writer lock 前准备,测试中的 median writer hold 从 7.821 ms 降到 1.864 ms; PR #153683[17],压缩 Transcript 与 Embedding 存储,增加 FTS ownership 索引。
这些修复都值得升级和回归。它们减少主线程卡死、缩短普通写入临界区、控制数据体积。
它们仍然没有做下面几件事。
没有把 Session/Transcript 与 Memory Index 拆成不同数据库; 没有把 Vector/FTS 做成独立 generation 文件; 没有把 Embedding cache 从核心状态库移出去; 没有消除单 SQLite Writer 的共享故障域; 没有让 full reindex 与聊天写入彻底隔离。
2026.9.6 缓解了症状,没有翻修架构。它让龙虾卡死时更有礼貌,没有让龙虾停止卡死。
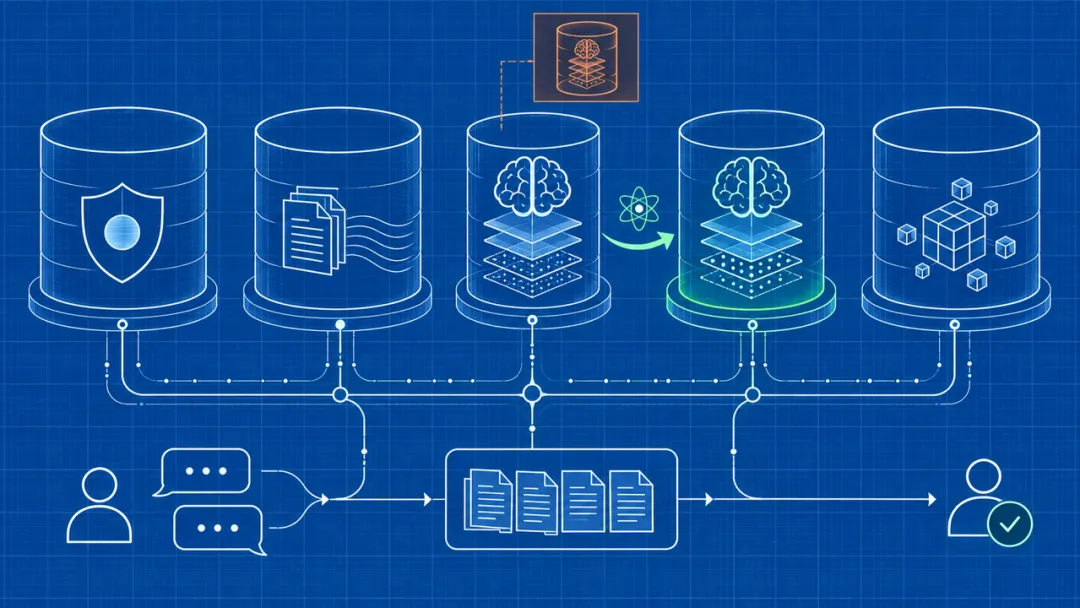
正确的设计并不神秘
合理边界至少应该拆成四层。
Core state DB
只存 Session metadata、授权、审批状态和低频核心数据。它必须小、稳定、易备份,任何索引重建都不应该碰它。
Transcript DB 或 append-only log
持续追加聊天事件,独立维护 FTS。它可以很大,但不能和 Memory 向量发布争同一个 Writer。
Memory generation DB
每次 full reindex 在新文件中完整构建 sources、chunks、FTS 和 Vector。验证通过后,只切换一个很小的 generation pointer 或 manifest。旧 generation 等读者退出后异步删除。
Embedding cache DB
缓存就是缓存。单独限容、单独清理、必要时整个删除重建。它不应该扩大 Session 数据库,更不应该参与核心状态的事务。
在这个结构里,full reindex 运行十分钟也没关系。聊天照常写,审批照常落账,Gateway 心跳照常响应。Memory search 可以明确告诉用户“新 generation 构建中,继续使用上一代索引”,无需直接失忆。
OpenClaw 2.0把什么放错了地方
OpenClaw 2.0 试图一次解决持久化、搜索、恢复、治理和多 Agent 协作。它选择了最容易获得局部一致性的方案。所有数据进入同一个数据库,所有写入排同一条队。
这套方案在测试库里很漂亮。数据量上来以后,每一次维护都要穿过核心写路径,每一个固定 timeout 都会变成规模阈值。所谓偶发卡顿还会扩散成消息丢失、心跳延迟和 Gateway 重启。
SQLite 没有背叛 OpenClaw。OpenClaw 让可重建索引和不可丢核心状态共享一个 Writer,才是这次事故里最傻逼的设计。
如果稳定性优先,现阶段至少应该升级到包含 Worker 缓解的版本,并用真实大库、真实 Swap 和活跃会话压测 full reindex。长期方案只有一个。拆分故障域,让 Memory 重建只影响 Memory。
核验口径
本文基于一台 OpenClaw 2026.9.2 生产实例的日志、实时 SQLite 状态、对应版本源码,以及截至 2026 年 10 月 2 日的 GitHub Issue、PR 和 release ancestry 核验。新增案例来自 10 月 2 日 22 时 15 分至 23 时 05 分的 Gateway journal、shutdown-timeout 稳定性包和当时的数据库文件尺寸。现场数据只用于解释故障机制,没有把单机现象扩写成所有安装必现。2026.9.5 与 2026.9.6 的改进已单独标注,避免拿已经缓解的问题冒充当前版本现状。
架构迁移
PR #98236,Session 与 Transcript 切换为 SQLite canonical storage[18]
核心 Issue
Issue #143640,full index publish 单个 IMMEDIATE 长事务[19] Issue #128140,memory_search 固定 15 秒超时[20] Issue #145403,sessions.history.read 长事务冻结 Gateway[21] Issue #119720,同步持久化阻塞 Gateway[22] Issue #148307,Session reclamation 超过 busy timeout[23] Issue #112423,大型 Transcript cleanup 阻塞 Gateway[24] Issue #114612,Memory SQLite 无界增长[25] Issue #138326,开放 SQLite/WAL 调参[26]
已合并修复
PR #131121,限制 Embedding cache[27] PR #149901,把 Memory publication 移入 Worker[28] PR #148630,自动 Session maintenance 移入 Worker[29] PR #153818,Transcript payload 在锁外准备[30] PR #153683,压缩 Agent storage 与索引维护[31]
引用链接
[1]PR #98236: https://github.com/openclaw/openclaw/pull/98236
[2]Issue #143640: https://github.com/openclaw/openclaw/issues/143640
[3]Issue #148307: https://github.com/openclaw/openclaw/issues/148307
[4]Issue #128140: https://github.com/openclaw/openclaw/issues/128140
[5]#143640: https://github.com/openclaw/openclaw/issues/143640
[6]#128140: https://github.com/openclaw/openclaw/issues/128140
[7]#145403: https://github.com/openclaw/openclaw/issues/145403
[8]#119720: https://github.com/openclaw/openclaw/issues/119720
[9]#148307: https://github.com/openclaw/openclaw/issues/148307
[10]#112423: https://github.com/openclaw/openclaw/issues/112423
[11]#114612: https://github.com/openclaw/openclaw/issues/114612
[12]#138326: https://github.com/openclaw/openclaw/issues/138326
[13]PR #131121: https://github.com/openclaw/openclaw/pull/131121
[14]PR #149901: https://github.com/openclaw/openclaw/pull/149901
[15]PR #148630: https://github.com/openclaw/openclaw/pull/148630
[16]PR #153818: https://github.com/openclaw/openclaw/pull/153818
[17]PR #153683: https://github.com/openclaw/openclaw/pull/153683
[18]PR #98236,Session 与 Transcript 切换为 SQLite canonical storage: https://github.com/openclaw/openclaw/pull/98236
[19]Issue #143640,full index publish 单个 IMMEDIATE 长事务: https://github.com/openclaw/openclaw/issues/143640
[20]Issue #128140,memory_search 固定 15 秒超时: https://github.com/openclaw/openclaw/issues/128140
[21]Issue #145403,sessions.history.read 长事务冻结 Gateway: https://github.com/openclaw/openclaw/issues/145403
[22]Issue #119720,同步持久化阻塞 Gateway: https://github.com/openclaw/openclaw/issues/119720
[23]Issue #148307,Session reclamation 超过 busy timeout: https://github.com/openclaw/openclaw/issues/148307
[24]Issue #112423,大型 Transcript cleanup 阻塞 Gateway: https://github.com/openclaw/openclaw/issues/112423
[25]Issue #114612,Memory SQLite 无界增长: https://github.com/openclaw/openclaw/issues/114612
[26]Issue #138326,开放 SQLite/WAL 调参: https://github.com/openclaw/openclaw/issues/138326
[27]PR #131121,限制 Embedding cache: https://github.com/openclaw/openclaw/pull/131121
[28]PR #149901,把 Memory publication 移入 Worker: https://github.com/openclaw/openclaw/pull/149901
[29]PR #148630,自动 Session maintenance 移入 Worker: https://github.com/openclaw/openclaw/pull/148630
[30]PR #153818,Transcript payload 在锁外准备: https://github.com/openclaw/openclaw/pull/153818
[31]PR #153683,压缩 Agent storage 与索引维护: https://github.com/openclaw/openclaw/pull/153683