ARTICLE · 1125596
【AI制药】人工智能简化了药物 - 靶点相互作用的科学发现过程
本文是发表于British Journal of Pharmacology 2026 年专题刊《Network Medicine and Systems Pharmacology》的综述论文,作者 Yuxin Yang、Feixiong Cheng,系统梳理人工智能(AI)在药物 - 靶点相互作用(DTI)预测领域的完整技术体系、数据资源、应用落地、现存瓶颈与未来发展方向,核心目标是阐释 AI 如何解决传统药物研发成本高、周期长、成功率低的痛点。
一、研究背景与写作动机
1.传统 DTI 研发的痛点药物发现核心环节是识别药物与靶蛋白的结合作用(DTI),传统手段高度依赖体外、体内实验,实验成本高昂、研发周期漫长、临床转化成功率极低。
2.AI 技术的变革价值计算方法尤其是 AI 可大幅缩短研发周期、降低实验开销、提升预测准确率,成为 DTI 挖掘的核心工具。
3.现有综述的局限性过往综述仅聚焦单一技术路线(如仅深度学习、仅分子指纹、仅网络模型),缺少覆盖传统机器学习、深度学习、网络模型全流派的整合梳理;本文填补该空白,构建完整的 AI-DTI 技术全景。
4.文章整体框架依次介绍:DTI 所需数据库与工具、模型评价指标、六大类主流 AI 预测模型、AI 在复杂人类疾病药物重定位的案例、领域现存挑战与未来发展路线。
二、DTI 研究基础数据资源与工具(第 2 章节)
2.1 三大类开源数据库
论文将数据库分为药物库、靶点蛋白库、结合亲和力数据库三类,并列举主流资源:
1.药物专属数据库
○DrugBank 5.1.12:收录 17085 种药物,含获批小分子、生物药及临床候选分子;
○ChEMBL34:超 240 万活性类药分子,存储 2D 结构、生物活性;
○ZINC20、PubChem、DrugCentral、SIDER(药物副作用数据库)。
2.靶点蛋白专属数据库
○UniProt:2.45 亿蛋白序列,仅 60 万条人工注释;
○PDB:20 万 + 实验解析蛋白 3D 晶体结构;
○AlphaFold 数据库:2.14 亿 AI 预测蛋白 3D 结构,弥补实验结构稀缺难题。
3.药物 - 靶点结合数据库BindingDB(290 万结合活性数据)、PDBbind(实验测定分子 - 蛋白亲和力数据集),为模型训练提供标签数据。
2.2 分子表征工具包(三类)
1.特征向量计算工具:PaDEL(分子描述符 / 指纹)、ProtDCal(蛋白序列 + 3D 结构特征)、ProtParam(基础蛋白理化特征)、PubChemPy(Python 化学指纹工具);
2.分子相似度计算工具:SIMCOMP(基于分子图最大公共子结构)、Rcpi(R 语言,同时支持化合物、蛋白序列相似度);
3.分子结构生成工具:Open Babel、RDKit(行业主流,支持 SMILES 转 2D/3D 结构、特征提取、相似度计算,Python 生态友好)。
2.3 AI 模型评价指标
区分 \\分类任务(是否存在 DTI 相互作用)与回归任务(预测结合亲和力数值)\\两套评价体系:
1.分类任务指标基础指标:Accuracy、Precision、Recall、F1-score;曲线指标:AUROC。适用场景说明:均衡数据集可用 Accuracy/AUROC;正负样本不均衡时,F1-score 评估更客观。
2.回归任务指标MAE(对异常值不敏感)、RMSE(放大误差,适合关注大幅偏差场景)、MSLE、MAPE、Pearson 相关系数 R(衡量预测值与真实亲和力线性相关性)。
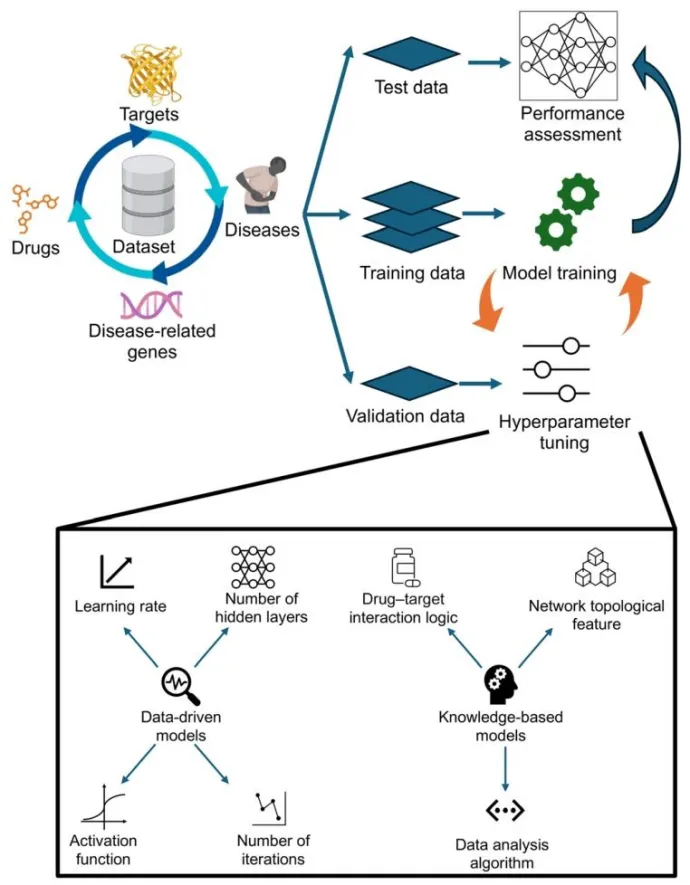
3.数据集划分标准流程数据预处理后分为训练集(模型学习)、验证集(超参调优)、测试集(泛化能力评估);区分热启动(已知药物 / 靶点预测)、冷启动(全新药物 / 靶点,更考验模型泛化性)两种测试范式。
三、六大主流 AI DTI 预测模型体系(第 3 章节,全文核心)
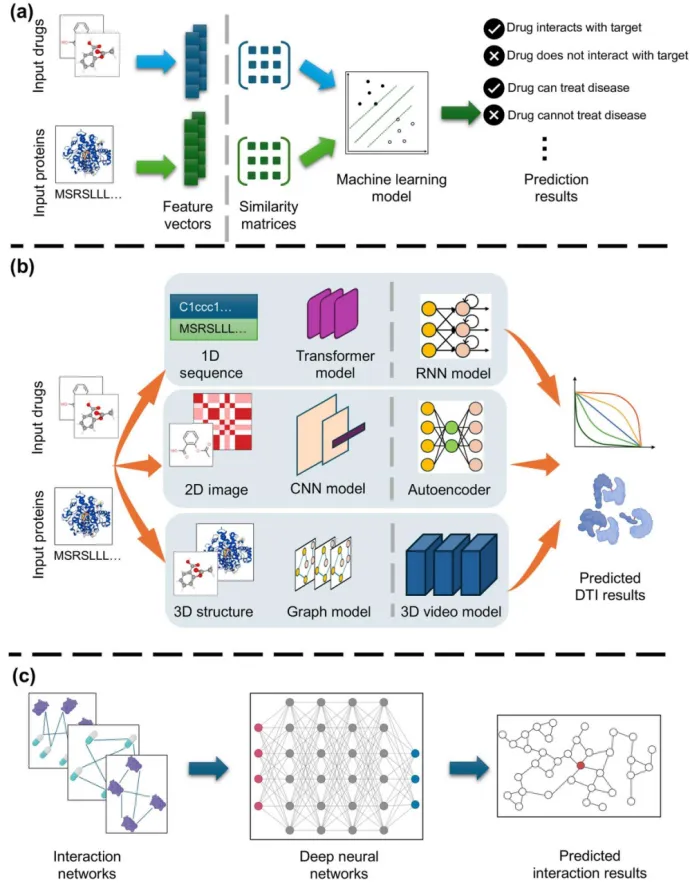
论文将现有 AI 模型划分为 6 大类,逐一阐述原理、代表模型、优缺点,配套对比表(Table 2)与流程示意图(Figure 2):
3.1 指纹 / 特征向量经典机器学习模型
1.原理:先人工提取药物分子指纹(MACCS、环形指纹)、蛋白理化特征,可搭配 PCA、UMAP、t-SNE 降维,再输入传统机器学习模型;
2.代表模型:SVM、随机森林 RF、Logistic 回归、集成模型 NegStacking、LASSO+RF 融合模型;
3.优势:小数据集、结构化特征下计算高效;
4.缺陷:人工特征存在冗余 / 缺失,易过拟合 / 欠拟合,泛化能力受限;近年多采用集成学习缓解单一模型缺陷。
3.2 相似度基模型
1.核心假设:结构 / 副作用相似的药物结合同类靶点,序列 / 功能相似蛋白结合同类药物;先构建药物相似度矩阵、靶点相似度矩阵,再完成预测;
2.代表算法:BLM 二分局部模型、DrugE-Rank、核贝叶斯矩阵分解;
3.优势:无需复杂人工特征工程,计算开销低;
4.缺陷:假设存在局限性,对于结构差异大但靶点相同的分子预测效果差。
3.3 序列基深度学习模型(借鉴 NLP)
1.原理:药物用 SMILES 字符串、蛋白用氨基酸序列作为一维输入;先后经历 RNN/LSTM、Transformer 两大技术阶段;
2.代表模型
○RNN 系:WideDTA、SMILES2Vec;
○Transformer/BERT 预训练系:SMILES-BERT、CHEM-BERT、AttentionDTA、MT-DTI;
3.优势:数据预处理简单,无需 3D 结构,算力消耗低;Transformer 注意力机制解决长序列依赖问题;
4.缺陷:仅捕捉一维序列信息,丢失分子 3D 立体构型、手性等关键结合特征。
3.4 图像基深度学习模型(借鉴计算机视觉)
1.原理:将分子 2D 结构图作为图像输入 CNN 提取空间特征;衍生预训练框架 ImageMol;
2.代表模型:Chemception、DEEPScreen、ImageMol;
3.优势:自动捕获键角、原子空间排布等 2D 结构信息,优于一维序列模型;可结合 AlphaFold 蛋白图像实现多模态融合;
4.缺陷:无法获取分子三维动态构象信息。
3.5 3D 结构基图神经网络(GNN)模型
1.原理:将药物、蛋白转化为原子 / 氨基酸节点图,化学键 / 肽键为边,使用 GCN、GAT、GTN 建模三维结构关联;最新 VideoMol 捕捉分子动态构象视频数据;
2.代表模型:MolCLR、MGCN、DGraphDTA、DTI-GAT、DTI-GTN;
3.优势:精准建模原子空间相互作用,贴合药物 - 靶点结合真实机制;
4.缺陷:依赖蛋白 3D 结构数据,完整 3D 数据获取成本高。
3.6 网络基图深度学习模型(网络医学核心)
1.原理:构建多异质生物网络,节点为药物、靶点、疾病、基因,边为相互作用关系;用 GCN/GAT 挖掘跨实体隐藏关联;
2.代表模型:deepDR、deepDTnet、DTI-HETA、AI-Bind;
3.核心优势:擅长药物重定位(老药新用),整合多组学、疾病、副作用全局信息,适合复杂疾病挖掘候选药物;
4.缺陷:生物网络规模膨胀后计算复杂度急剧升高。
四、AI 在复杂人类疾病药物研发的落地案例(第 4 章节)
以 4 类典型复杂疾病为例,验证 AI-DTI 预测的实际转化价值:
1.阿尔茨海默病 AD网络机器学习框架挖掘单细胞风险基因、多组学蛋白互作网络,筛选可重定位药物;搭建机器学习模型解析肠道菌群代谢物与 GPCR 靶点的关联,识别新型 AD 靶点,且全部经过体外小胶质细胞实验验证。
2.多发性硬化症 MSCNN 用于 MRI 影像病灶诊断;网络模型挖掘疾病通路实现药物重定位;深度学习预测单抗类药物(抗 CD20)长期治疗获益,辅助个体化治疗方案设计。
3.心血管疾病 CVD网络模型预测药物对冠心病的风险 / 保护作用;整合副作用数据筛选低不良反应的重定位药物;AI 解读心电图,预测患者药物治疗响应,支撑精准心血管用药。
4.COVID-19网络知识图谱快速筛选老药:褪黑素、托瑞米芬(抑制 S 蛋白);区分分类模型(判断药物是否抗病毒)、回归模型(量化抑制活性),疫情期间快速完成候选药物筛选,大幅缩短实验周期。
五、领域现存核心挑战(第 5 章结论部分)
1.数据质量与规模瓶颈生物数据存在噪声、缺失、标注成本极高;标注数据稀缺,标记 / 未标记数据鸿沟大;半监督学习是短期缓解方案。
2.单模态模型局限当前多数模型仅使用序列 / 图像 / 分子图单一数据,无法融合药物、蛋白、多组学、临床、影像多维度信息;多模态融合(早 / 中 / 晚期融合策略)是重要发展方向。
3.模型泛化能力不足冷启动场景(全新药物 / 全新靶点)预测性能大幅下滑;常规随机划分数据集会高估模型效果,支架拆分更贴合真实研发场景,但对模型要求更高;缺少统一公平的数据集划分标准。
4.模型验证链条断裂纯计算预测结果可信度有限,必须配套体外细胞实验、体内动物实验、临床试验三级验证;现有研究大量缺少湿实验佐证。
5.大模型与量子计算附加问题LLM 易产生幻觉、生物偏见;量子计算算力强大,但极易受环境噪声干扰,硬件落地难度高。
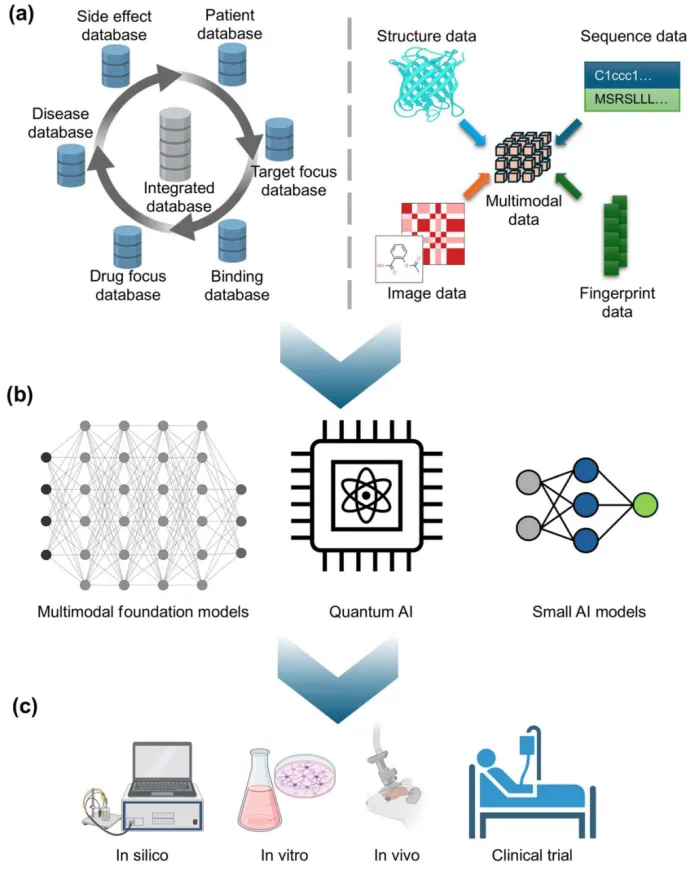
六、未来发展方向(Figure 3 可视化规划)
6.1 数据层:一体化多模态数据库建设
整合药物库、靶点库、结合数据库、疾病、患者、副作用数据库,构建统一集成平台;搭建融合序列、3D 结构、分子图像、指纹的多模态标准数据集。
6.2 AI 技术层三大前沿路线
1.生物多模态基础大模型:融合分子图像、SMILES、蛋白序列、蛋白 3D、多组学数据,统一表征药物与靶点,打破单模态限制;
2.轻量化小型专用 AI 模型:针对细分药物研发任务定制小模型,算力需求低,适配中小型实验室;
3.量子 AI:利用量子计算解决经典计算机无法处理的大分子相互作用复杂计算难题。
6.3 验证层:完整干湿结合验证体系
建立标准化 in silico(计算)→in vitro(细胞)→in vivo(动物)→临床转化的全流程验证规范,提升 AI 预测结果可靠性。
6.4 其他前沿趋势
1.自监督预训练模型(ImageMol、MolCLR 等)提升小样本任务性能;
2.动态分子表征(VideoMol)捕捉分子构象变化,弥补静态图模型缺陷;
3.网络医学持续深耕药物重定位,应对罕见病、退行性疾病无新药困境。
七、文章整体价值总结
1.综述价值:首次完整整合六大类 AI-DTI 预测技术,梳理配套数据库、工具、评价指标,形成标准化研究流程;
2.应用价值:通过 4 类重大疾病实例证明 AI 可加速药物重定位、新药靶点挖掘,解决传统制药周期长、成本高的行业痛点;
3.指导意义:清晰指出数据、模型、验证三大核心瓶颈,给出多模态大模型、轻量化 AI、量子计算、干湿实验结合的完整未来发展路线,为计算药理学、系统医学领域后续研究提供框架参考。
生物智能:在生物先进产业场景中构建“状态感知-实时认知-自主决策-精准执行-学习提升”的生物科学智能(NeuroAI);实现生物产业转型升级、DT驱动业务、价值创新创造的产业互联生态链。
生物产业+物理AI=生物智能
产业智能官:NeuroAI
加入知识星球“生物智能研究院”:自动化生物铸造厂OT技术(自动化+机器人+工艺+精益)和新一代IT技术(云计算+物联网+区块链+大数据+人工智能)深度融合,在场景中构建“状态感知-实时认知-自主决策-精准执行-学习提升”的生物科学智能(NeuroAI);实现产业转型升级、DT驱动业务、价值创新创造的产业互联生态链。
版权声明:产业智能官(ID:NeuroAI)发表的文章,除非确实无法确认,我们都会注明作者和来源,涉权请联系协商解决,联系、投稿邮箱:wolongzy@qq.com