ARTICLE · 1134801
我的 AI 助手,会把我踩过的坑写成规矩
我的 AI 助手,会把我踩过的坑写成规矩
一次「它会自己改自己」的观察记录
大多数 AI 助手,第二天就不记得你昨天教过它什么。
这一个不太一样。它会把我踩过的坑,写进自己的一份文件里;下次遇到同类任务,我什么都不用说,它上来就按新规矩办。
这篇文章记的,就是它怎么把我的一次次返工,变成一条条规矩。
一、先说一个很小的坑
我在做一条讲历史人物的小片子。其中一张画面上印着一串字——是 AI 画出来的「伪汉字」:看着像汉字,一个也不对。
得把它洗掉,重新写上真的。
第一次,它做完了。我一看不行,纸上还留着字的灰影。
第二次,它换了参数。这回更糟——纸的边缘多出一圈亮边。
第三次,我说了一句话:底色从低频层取,别从原图取。
它照做了。成了。
到这里都是很正常的故事——用户提需求,工具改,改到对为止。不正常的是接下来发生的事。
我随口说了一句:把刚才这几个坑记下来。
它写了一份文件。里面是四条:
一、蒙版要盖满整张纸,不能只盖住字二、底色从低频层取,不要从原图取三、细节层只做负向限幅四、不要用亮度判断代替手描轮廓——背景的光斑会骗过阈值
然后呢?
然后是第二天,我又遇到一张需要洗字的图。我什么都没说。它上来就按这四条走,一次过。
二、「记下来」到底记在哪
如果它只是「记住了」,那没什么稀奇——很多 AI 都能在一段对话里记住你前面说过的话。
关键在于它记在哪里。
对话里的记忆,会话一关就蒸发,下次你得从头教一遍。它写的那份文件,是硬盘上的一个文件。
WorkBuddy 里管这个叫技能(skill):一个文件夹,加一份说明文件。你下次不说,它也照做。
而且这些文件是分层的,这一点我觉得比技能本身还重要:
为什么要分层?因为经验的性质本来就不一样:洗字的手艺是通用的,账号的规格是这一摊事的,而「文件放 D 盘」是我这个人的习惯。混在一起,早晚互相打架。
三、有些规矩不是我定的,是它用误判换来的
上面那个还算顺利。下面这个,是它自己打自己的脸。
我发了条片子出去。一小时,35 个播放。
我说:这也太低了吧。
它先说了一句让我意外的话:
「这个数我们其实没有基准。你手上所有的历史数据都是早间发的,这是第一次晚间发——拿早上的尺子量晚上,量不出来。所以现在不能判:4 小时前不下结论。」
我不太服气,又追了一轮。
它于是去算:第 1 小时 35,第 2 小时 68——第二个小时比第一个小时快了 66%。
「看着像死了,其实在加速。」
然后它错了。而且错了两次。
早上,它拿第 1 小时的速率去乘总时长,预测能到一千五上下——实际早早停了。下午,它看了谷底那一段,改口说「大概停在五百到七百」——实际又冲上去了。
那天晚上真实数字出来了。一千出头。
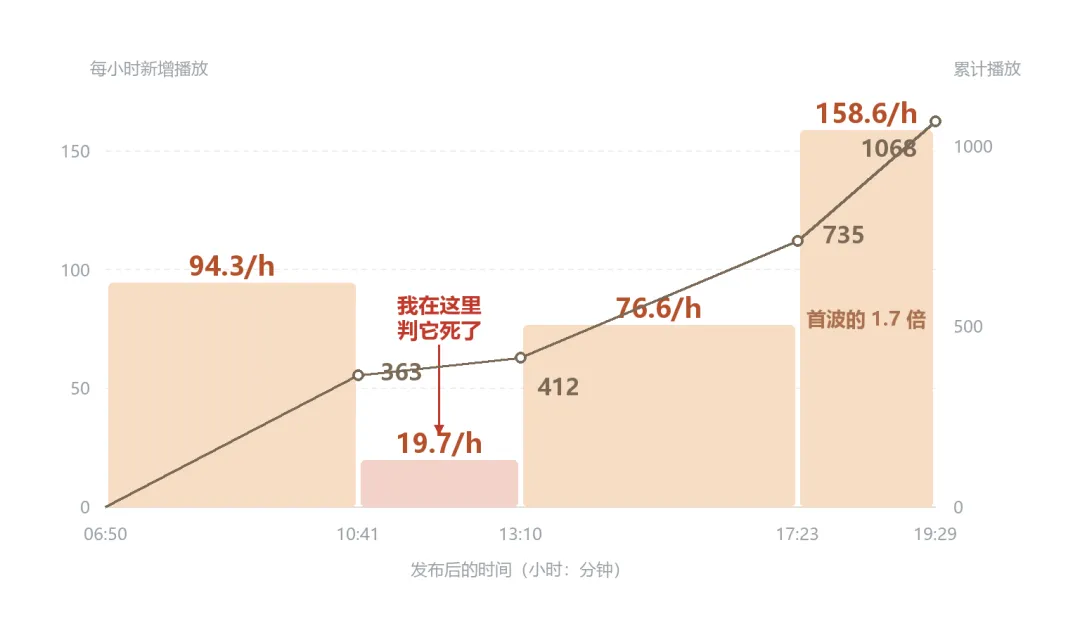
那天之后,三条规矩被改掉了:
这三条不是我想出来的,是它自己用两次误判换来的。
更关键的是——它们已经写进技能文件了。之后每做一条片,它自动按这三段式报进度,我不用再提醒一次。
↑ 判死判据的演进链路。每一步都不是我规定的,是数据反过来逼它改的。
四、它甚至推翻过自己的结论
有一次,它给了我一个封面公式:真人脸、脸大、暖光。这是它从数据里总结出来的。
我没有直接反驳,只问了一句:
「有个人物的脸,大众都不熟,配个画出来的,大家是不是觉得还虚啊?可另一个人大家都熟,稍微勾勒一下,大家就认出来了。」
它回去把数据重算了一遍,然后告诉我:它错了。
那个公式是从三条样本里总结的,而那三条样本恰好是同一个人。于是它把「辨识度」误记成了「写实度」——这两件事在它手上的数据里是缠在一起的,不拆开就分不清。
新公式是:
一张脸在封面上的价值 = 辨识度 × 情绪
还补了一条操作规矩:大家都认不出的人物,大字里必须把名字点出来,而且名字要单独成行。
它还多做了一步——自己做了三版摆在一起给我挑:名字嵌进长行,整块字号被拖小了;名字独立成行,字号才守得住。连反面案例都专门留了档。
五、但它也会「学歪」
说到这儿容易觉得这套机制挺聪明,所以得说个反例。
还是那个封面公式。后来我翻更早的记录,发现这个账号播放最高的一条,封面上根本没有脸——是一整块扎眼的红色,加一句巨大的字幕。
有意思的是,它当初总结的原话是写对了的:
「账号跑量的封面,要么是一块强色,要么是一张人脸,再加巨型字幕。」
可它后来整理的时候,只把「人脸」这一半留下了。
这就是过拟合:样本不够、又急着归纳,就会把偶然当成必然。它写了那么多条规矩,里面一定还有别的,是在同一个毛病上栽的。
所以现在的活儿是这么分的:
六、所以我的活儿变了
刚开始用的时候,我在教它干活——一遍遍告诉它这个不行、那个不对。
现在我在做的,是审它给自己写的规矩。
这个变化比听起来大。因为它意味着:那些坑不用我记了。坑是它记的,我只要在它归纳出一条规矩的时候,说一句「这条不对」或者「这条可以」。
有点像从带实习生,变成了审稿。
七、最后
这半个月里,我们做的事几乎全是新的,很多我自己也没做过。犯的错不比谁少。
但真正的区别在这儿:
第一次犯错是成本。第二次犯同样的错,才是选择。
工具会自己写说明书的时代,值得留意的可能不是它今天能干多少活——而是它明天还会不会犯今天的错。