ARTICLE · 1138079
AI Coding 的本质:项目管理与软件工程
上一篇说,程序员该学的是 AI Coding,不是跟风去搞 AI 副业。这篇说它到底难在哪。
一份跟了 50 多万名开发者的 NBER(美国国家经济研究局)工作论文给过一组数:自主编码 Agent 把代码提交量推高了 240%,项目数只涨 80%,发布只涨 30%, 论文管这叫 弱环节假说 ——上游再快,卡在下游那一环,多写的代码就变不成交付。
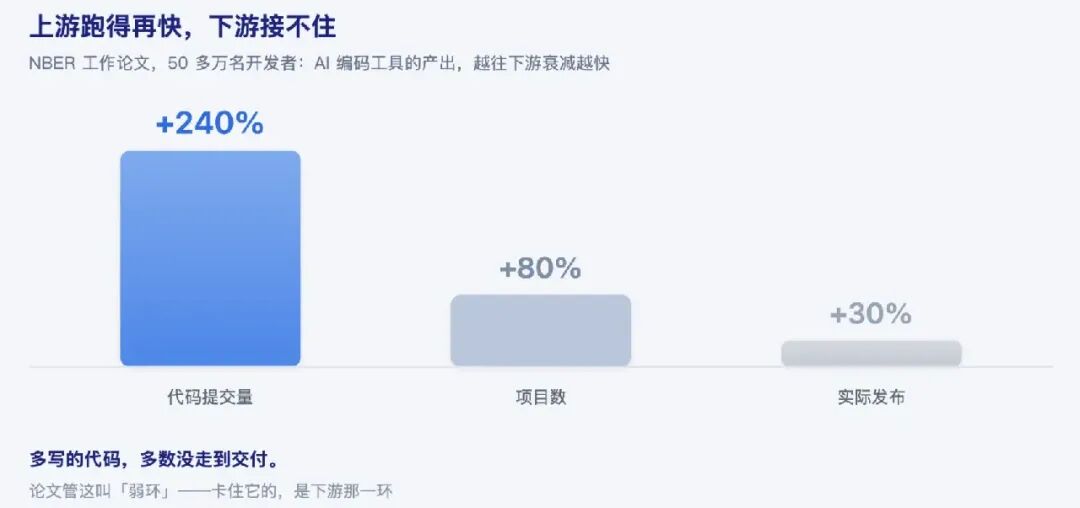
下游卡的是什么?不是模型不够聪明,卡住的是另外两样东西:一个是软件工程,一个是项目管理。
这篇说的就是这两件事,总结只有一句:AI 编程没有改掉软件工程和项目管理的范式,它只是让违反范式的代价来得更快。
总的来说就两件事。
代码写得快,烂得也快 活一个人干,盲区没人补位
软件工程:让它写出来的东西是对的
AI 有个绕不开的毛病:它只接收你给它的那些信息。
所以它每个决定,都是在你给它的信息里找最优解。有些人往往会遇到,AI 修复单个补丁挑不出毛病,攒上几个月就是一堆互相不认识的东西:甚至还出现同一个概念三个名字、同一个判断在五个调用点各写一遍、类型定义在源头没人管、调用方一个个加兜底。
最后出现代码能跑,但没人敢改的现象。
以前这些事靠人处理——老人记得住哪几个文件互相牵着,改的时候绕开坑走。AI 没有这z种能力。它每次从零开始读你的代码库,而且只会抄:库里有一个烂模式,它就复制十遍。AI 是软件熵的加速器——熵是系统自发变乱,代码变乱的速度前所未有。
抑制它的办法只有一条:让它当场知道自己错,别等你 Review 才发现。有三种解决办法。
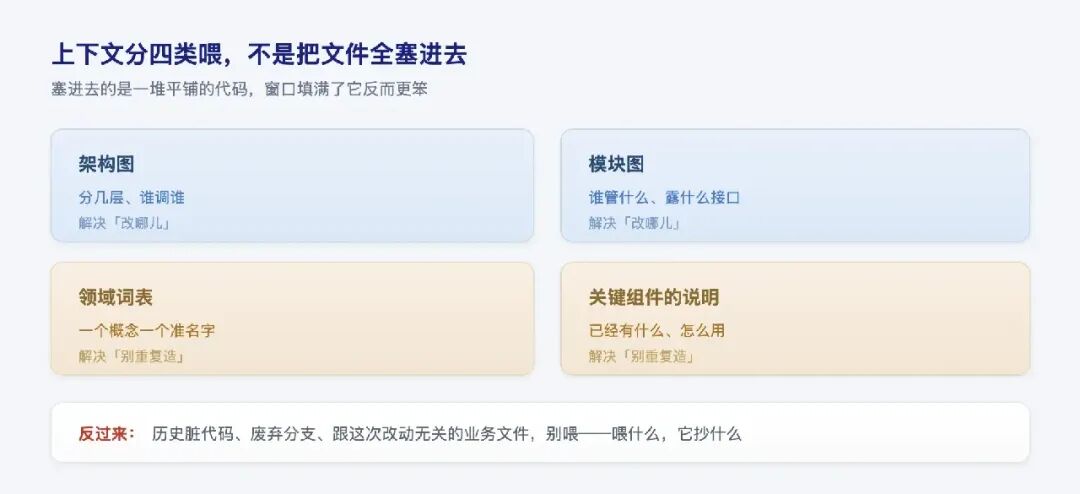
1.上下文给全。 把相关文件全塞进去不算给全——那是一堆平铺的代码,窗口填满了它反而更笨。按用途分几类才管用:架构图(分几层、谁调谁)、模块图(谁管什么、露什么接口)、领域词表(一个概念一个准名字)、关键组件的说明(已经有什么、怎么用)。前两类解决「改哪儿」,后两类解决「别重复造」,其实就是类似 cursor rules。
反过来,历史脏代码、废弃分支、跟这次改动无关的业务文件,别喂——喂什么,它抄什么。
2.立几条宪法级的基准。 真正值得反复交代的,是不带场景、架构级别、项目级一致的设计原则——例如:
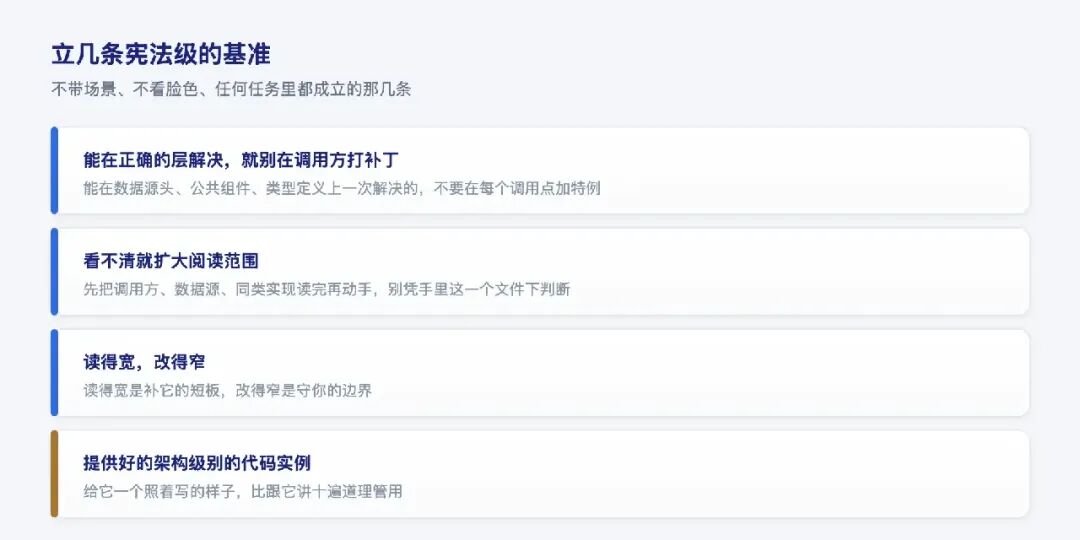
能在正确的层解决,就别在调用方打补丁。 能在数据源头、公共组件、类型定义上一次解决,就不要在调用方一个个加特例、加兜底。 看不清就扩大阅读范围。 先把调用方、数据源、同类实现读完再动手,别凭手里这一个文件下判断。 读得宽,改得窄。 读得宽是补它的短板,改得窄是守你的边界。 提供好的架构级别的代码实例
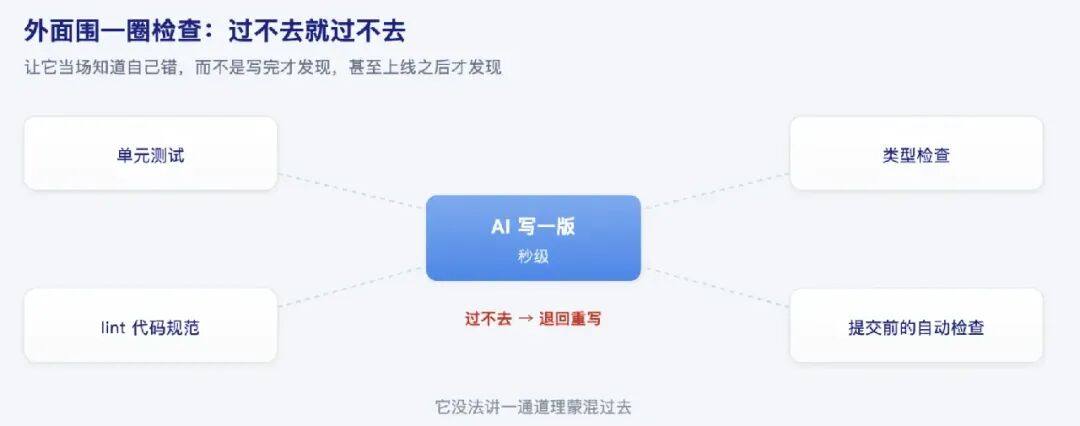
3.harness 需要加上单元测试、类型检查、lint(代码规范检查)、提交前的自动检查——共同点是过不去就过不去,让AI 快速意识到自己这么写不对,而不是写完才发现错误,甚至上线之后才发现。
项目管理:工种之间的分工合作
软件工程解决的是一个人开发能保证较高质量的输出,但企业往往是多人协作,就需要项目管理了。
项目管理说到底解决的,就是多个工种之间怎么分工、怎么合作。
先来看看没有 AI 之前是怎么做的
一个需求从提出到上线,本来要过产品、设计、前端、后端、测试五道手。每过一道手都是一次交接,接手的人按自己的标准再查一遍——有人追着你问边界,有人把你漏掉的条件翻出来,有人看你有没有为图省事塞个补丁进去。
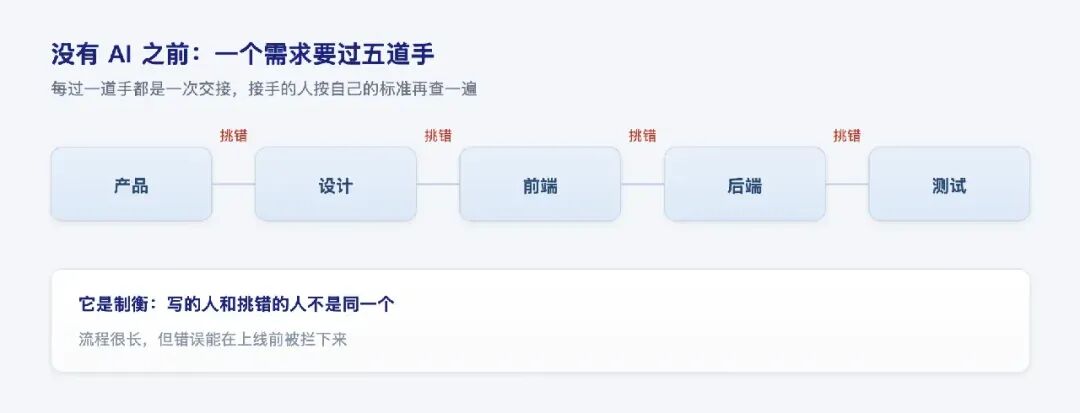
这些东西流程很长,但它是制衡:让错误在这个流程里面尽早的暴露,把错误拦截在上线前。
拦下来的错各种各样——有你不知道的业务问题,有你粗心忽略的细节,有你完全不 care 但业务方关心的等等。把同一个需求摊到桌上,每个工种看到的点都不一样:
产品问:退款中的订单,还能不能再申请一次? 前端问:这个状态跟已完成,在列表里怎么区分开? 后端问:退款状态跟支付流水对不上时,以哪边为准? 测试问:退款中途失败了,订单回到哪个状态? 架构师问:并发退款有考虑吗? 业务方问:这条订单记录能留几年?
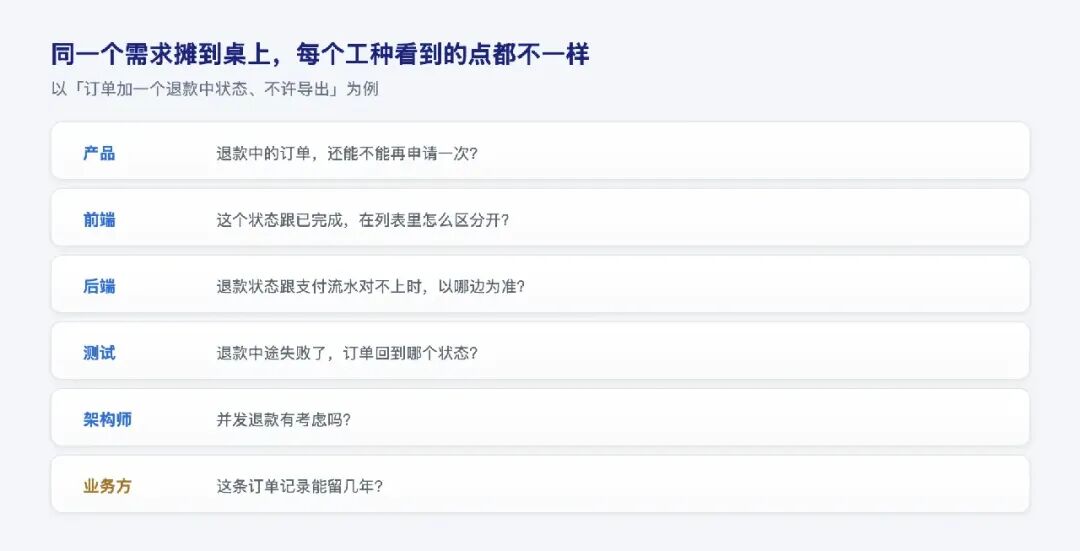
这些问题你一个人想不全。工种分工的价值就在这儿:全局视野
再看看有了 AI 之后是怎么做的
一个人用 AI 写代码,这套东西失效了:AI 一个人把前端后端都写了,你一个人把产品和测试、甚至架构师都当了。没有第二双眼睛替你兜底。
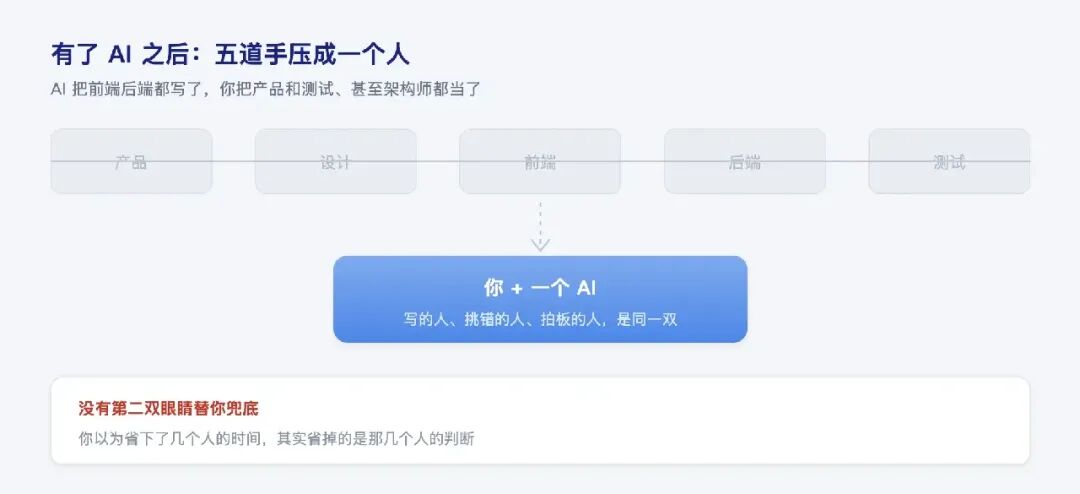
拿同一个需求看:AI 不会追问你「详情页还显示金额吗」,也不会提醒你「退款中的订单不能进导出」——你怎么说,它就怎么写。你以为省下了几个人的时间,其实省掉的是那几个人的判断。
因为省了很多其他视角的判断,所以你写出来的代码可能就会多一些漏洞,AI 只是提高了写代码的速度,但提高不了做判断的能力
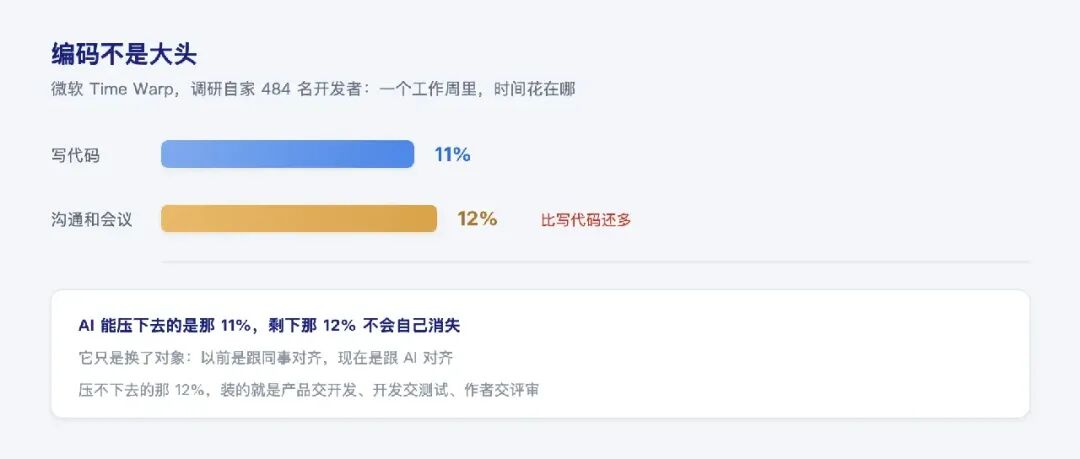
编码不是大头,这一点有数据。微软 Time Warp 调研了自家 484 名开发者:写代码只占实际工作周的 11%,沟通和会议占 12%——比写代码还多。AI 能压下去的是那 11%,剩下那 12% 不会自己消失,它只是换了对象:以前是跟同事对齐,现在是跟 AI 对齐。
我列了一张表:对比了原来的协作模式和 AI 的协作模式。
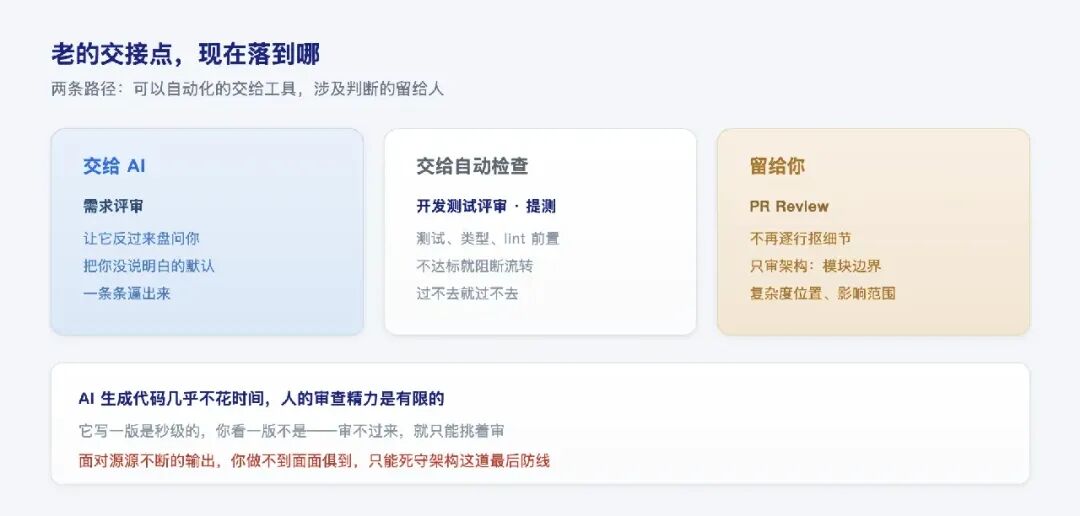
这张表格背后本质是两条路径:可以自动化的交给工具,涉及判断的留给人。
需求评审无法完全自动化,我们把它变成人跟 AI 的对谈:驱动 AI 主动向你追问,把那些藏在你脑海、没有写进文档里的隐性假设,全部逼到台面上。
而开发测试评审、提测准入,就彻底交给自动检查:测试、类型、Lint 前置校验,不达标就阻断流转。
最后落到人工手上的,就只剩 PR 评审。但人工评审要换一套思路:不再逐行抠细节,只审核架构。重点看三件事:模块边界是否合理、复杂度藏匿位置、改动的影响辐射范围。
AI 生成代码几乎不花时间,但人的审查精力是有限的。面对源源不断的输出,你做不到面面俱到,只能抓大放小,死守架构这道最后防线。
收尾
软件工程三件约束、项目管理一条准则,可以浓缩成一套工作逻辑:给足材料让它看得懂,确立规矩让它知道发力方向,自动化检查让它当场感知错误,而人只负责最终验收决策。
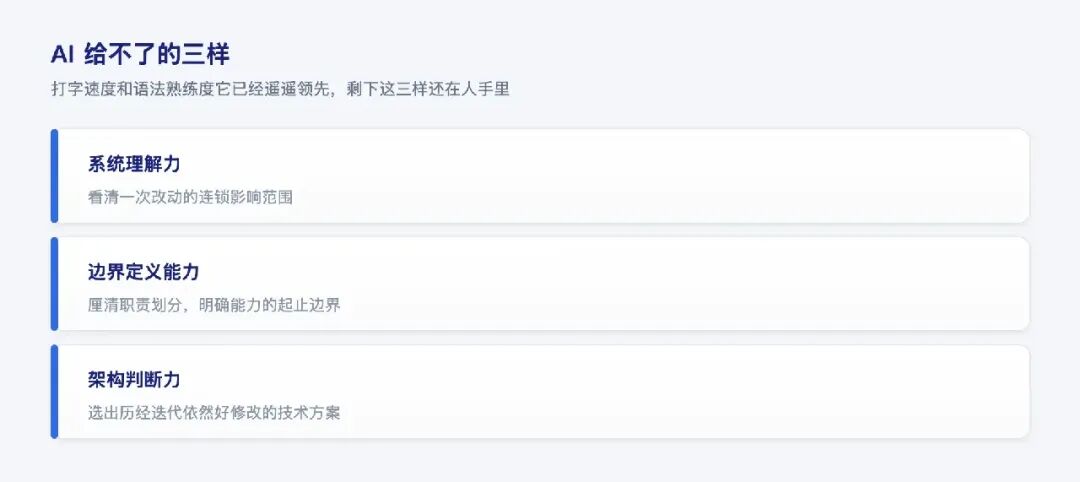
程序员的护城河正在重构。从前比拼敲码速度、语法熟练程度,这些 AI 已经遥遥领先。
真正属于人的核心能力有三样:
系统理解力:看清一次改动的连锁影响范围; 边界定义能力:厘清职责划分,明确能力的起止边界; 架构判断力:选出历经迭代依然好修改的技术方案。
模型会持续变得更强,但它永远只能看见你交付给它的那一部分上下文。该给到什么信息,决定权始终在人。