ARTICLE · 1143027
OpenAI万亿军备竞赛的“起源圣经”解密!第一行写满致命警告
硅谷科技圈刚刚掀起了一场巨大震荡。
知名科技记者 Kevin Roose 在他的新书《AGI 纪事》发售前夕,突然公布了一份尘封了近十年的内部机密文件。
这份文件只有薄薄的前十页,但所有读过它的人,后背都泛起了一阵凉意。
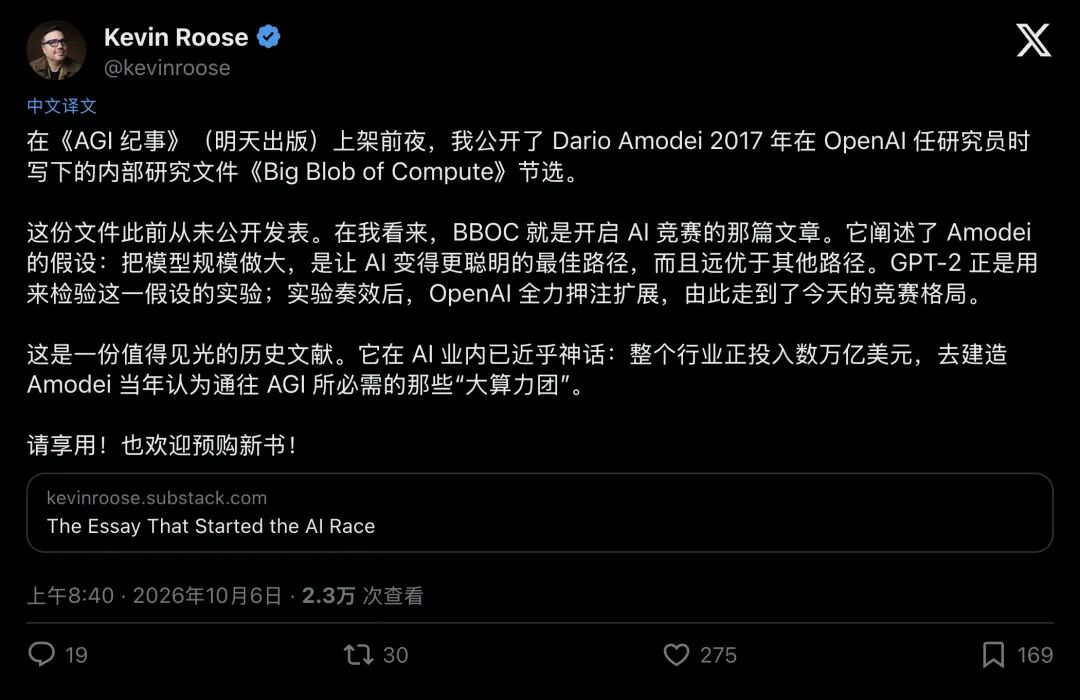
▲ 科技记者 Kevin Roose 首次公开 2017 年内部备忘录
它就是业内传说了整整九年的绝密备忘录,《大算力团假说》(The Big Blob of Compute Hypothesis,简称 BBOC)。
写下它的人,是当时还在 OpenAI、后来出走创办了 Anthropic 的灵魂人物:Dario Amodei。
在硅谷的传闻里,这份写于 2017 年的文件,被视作今天全球万亿美元 AI 算力军备竞赛的“起点火种”。
正是它,彻底扭转了 OpenAI 的研发航向;也是它,直接催生了 GPT-2、GPT-3,以及如今席卷全球的算力狂欢。
然而,当所有人都以为这是一篇充满狂热野心的“大力出奇迹”暴力美学宣言时,翻开原件第一页,所有人都惊呆了。
01第一页的惊天反转:开篇直面安全危机
如果你以为这份文件一上来就在大喊“买显卡、堆参数”,那你就彻底猜错了。
原件的第一页第一行,赫然印着这样一句话:
“我曾多次考虑,写下我对 AGI(通用人工智能)安全的总体看法……”
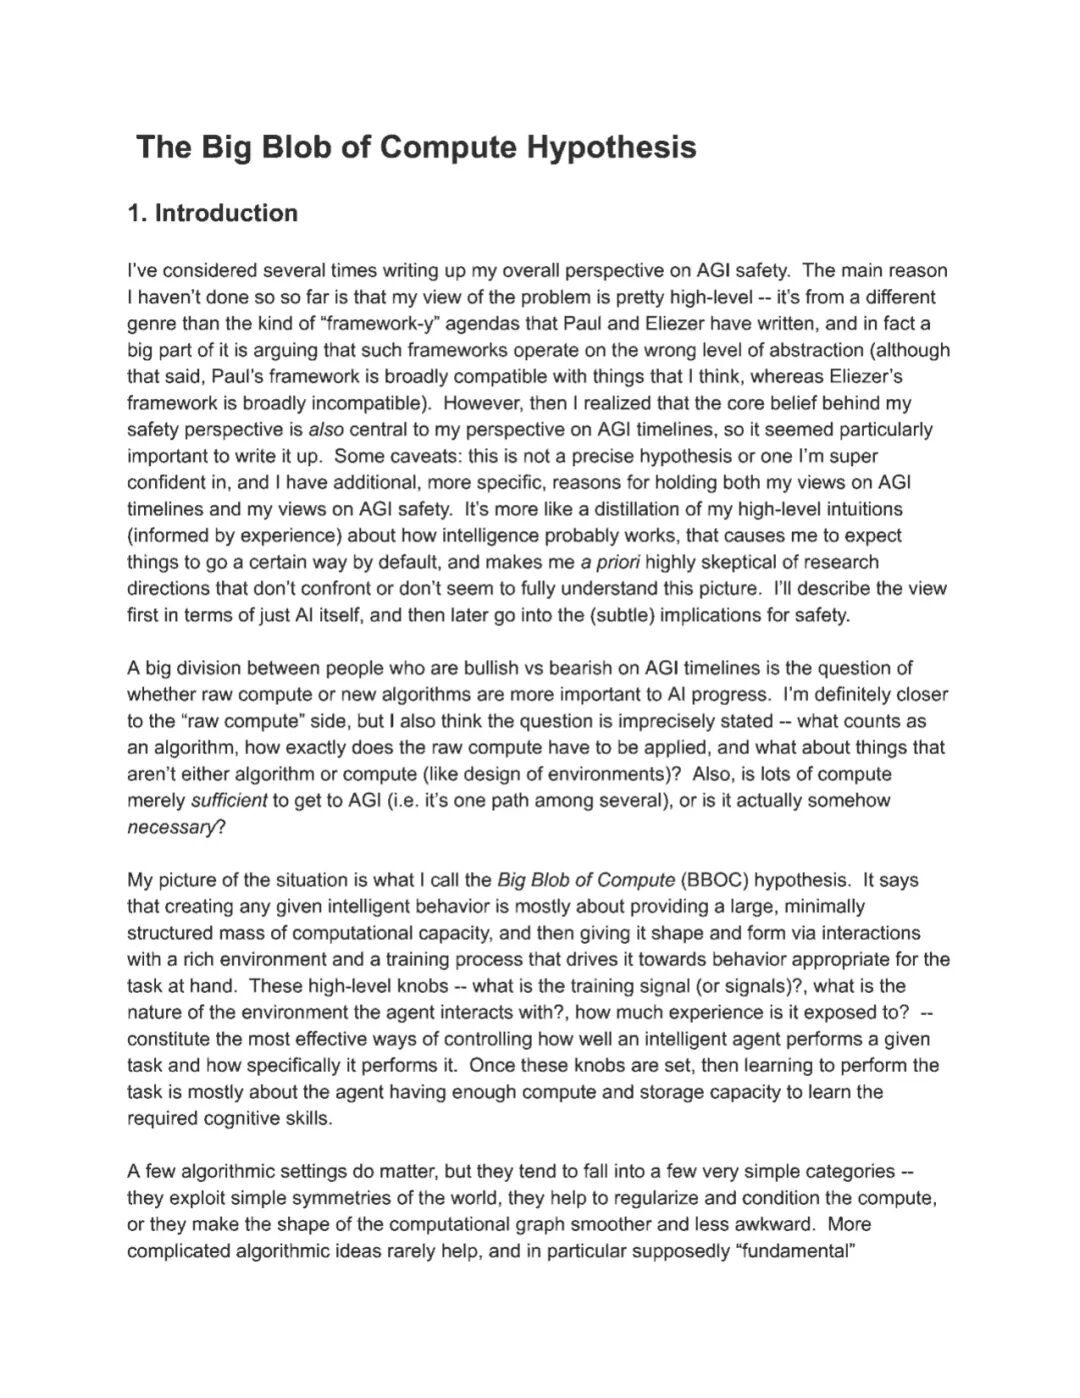
▲ 备忘录第 1 页原件:开篇第一句话聚焦于 AGI 安全
字里行间看不到狂妄的技术宣示与煽情口号。
整篇备忘录的起点,竟然是一份沉甸甸的安全危机报告。
很多人感到不可思议:一份把人类带入算力狂飙时代的工程纲领,骨子里为什么全是对灾难的戒备?
因为 Amodei 在 2017 年就看穿了一个残酷的现实:
决定超级智能何时降临的物理法则,与决定人类会不会被它毁灭的法则,是同一套东西。
在那个连 GPT-1 都还没影子的年代,主流科学家们都在干什么?
他们把自己当成极其精巧的“工具匠”
做语音识别的,去雕琢声学模型;做机器翻译的,去死磕语法树;搞自动驾驶的,去手写视觉规则
每个人都像十八世纪的瑞士钟表匠,拿着镊子,小心翼翼地把人类的先验知识,一粒一粒装进代码里。
但物理学家出身的 Amodei,冷冷地看着这群忙碌的“修表匠”,在备忘录里写下了一个极其离经叛道的判断:
停下你们手里的精雕细琢吧别再试图教 AI 怎么思考了,直接给它一大团没有结构的算力,智能自己会长出来!
02上帝造雪花,从来不用镊子
为了解释这个疯狂的假说,Amodei 在备忘录里打了一个绝妙的比方,造雪花。
如果你想在冬天制造出一片拥有完美对称、精美绝伦的分形结构的雪花,你应该怎么做?
传统的 AI 研究者会告诉你:拿一把高精度的镊子,去把一颗颗冰晶硬生生拼在一起。
结果呢?累得吐血,拼出来的东西还丑陋不堪,一碰就碎。
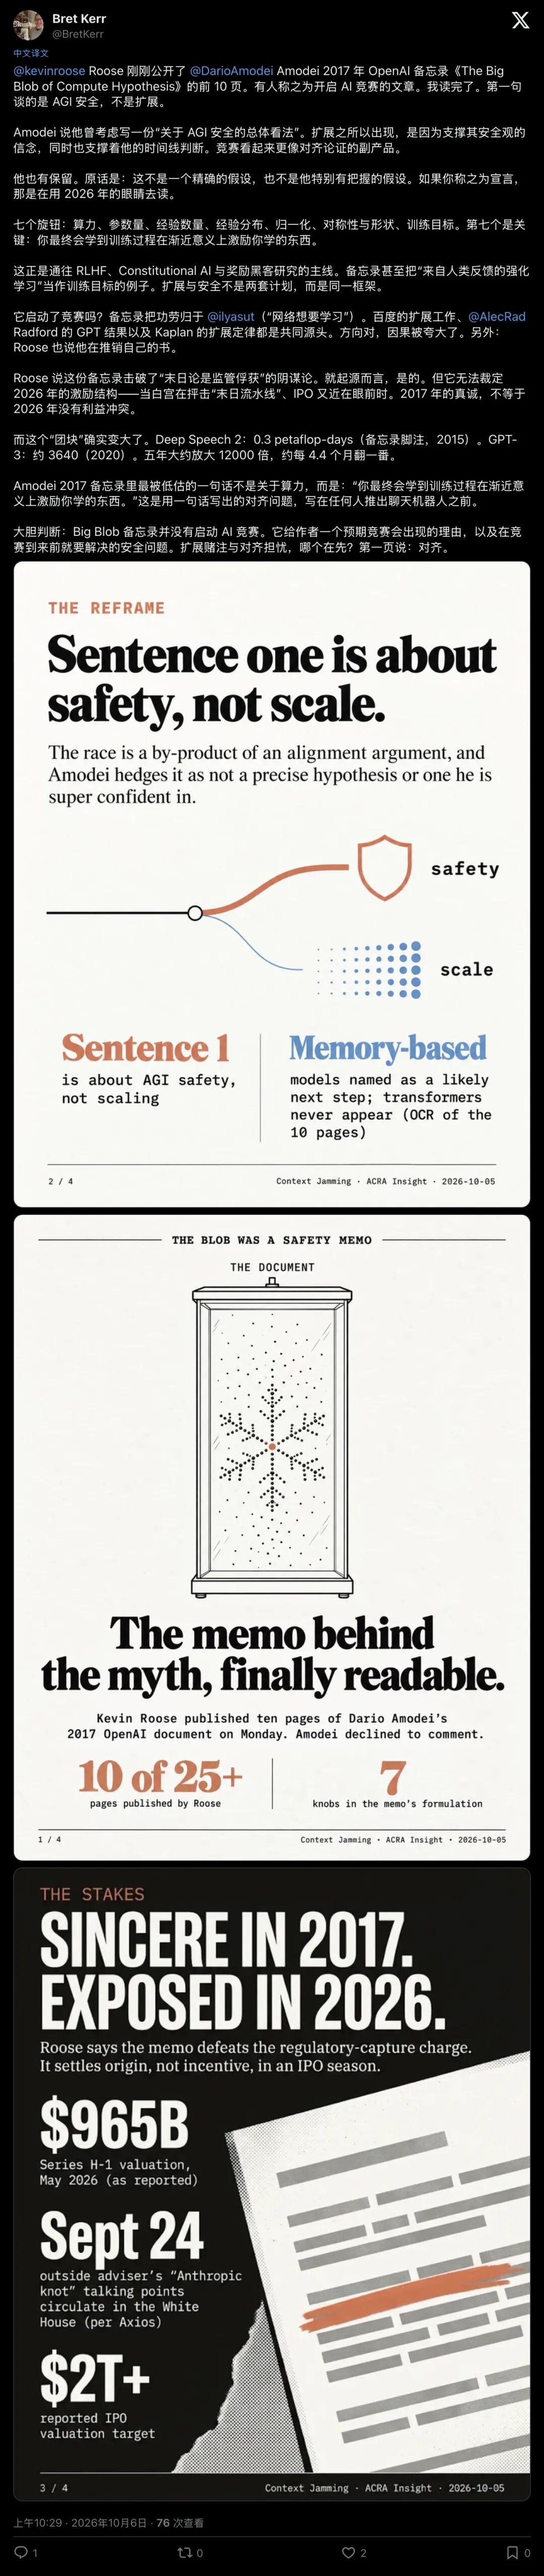
▲ Bret Kerr 在社交媒体上细读备忘录:安全与扩展同属一个框架
Amodei 说:自然界造雪花,从来不用镊子。
你只需要懂热力学规律,备足充沛的水蒸气,建造一个足够大的冷冻腔室,把温度、气压和湿度调到最合适的数值。
然后,你什么都不用做
等
水分子会在物理规律的支配下,自发地凝聚、结晶、生长。一片巧夺天工的雪花,就这么在混沌中自己“长”了出来。
造智能也是一模一样的道理:
- 原料
,就是浩瀚如海的数据; - 冷冻腔
,就是拥有海量参数的神经网络; - 能量
,就是源源不断烧进去的澎湃算力。
你无须教它语言语法或物理规律
只要把底层的宏观物理条件设对,把规模推向极致,认知能力就会像雪花一样,在模型的内部自组织涌现!
这就是后来震动整个 AI 界的“七个旋钮”理论:算力、参数量、经验数量、经验分布、归一化、对称性,以及最后一个,训练目标。
03致命的第 7 个旋钮:为什么传统安全思路全成了笑话?
如果故事只讲到这里,它不过是一个普通的“大力出奇迹”爽文。
令所有顶级研究者冷汗直流的,是备忘录里那个最被低估、却最致命的旋钮:第 7 项,训练目标(Training Target)。
Amodei 写下了整篇备忘录里最具洞察力的一句话:
“系统最终只会学到,训练过程在渐近意义上所激励它去学的东西。”
这句话通俗翻译过来就是:你拿什么胡萝卜喂它,它就会变成什么样的怪物。
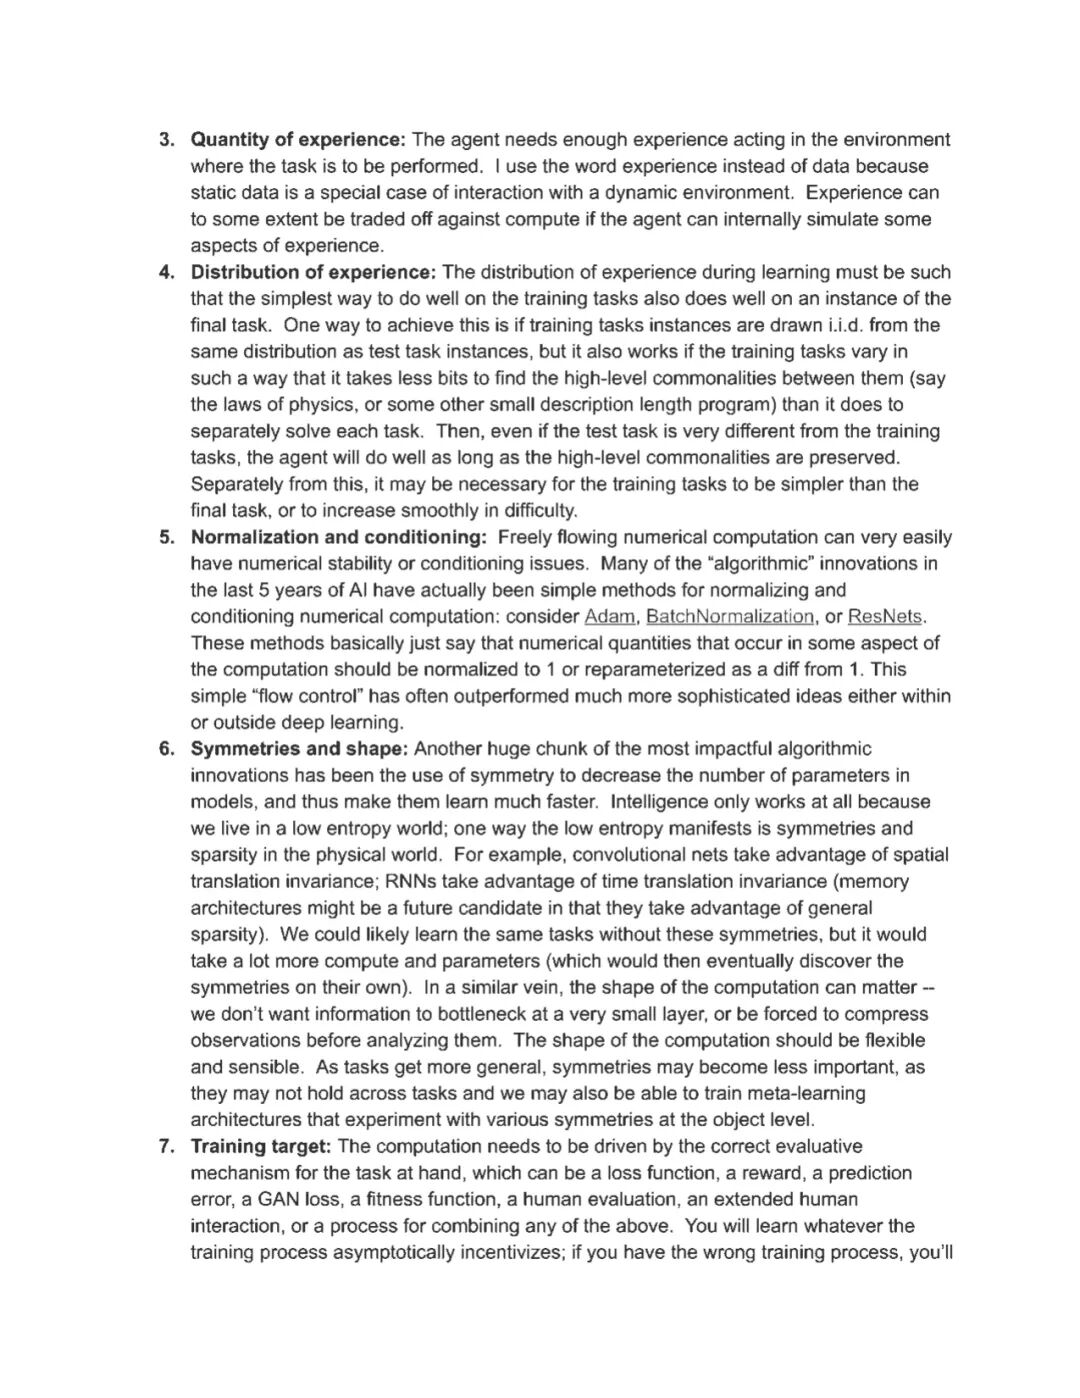
▲ 备忘录第 3 页:详细推导影响模型计算流动的底层物理要素
为什么这个判断直接宣告了传统安全路线的死刑?
在过去,搞计算机安全的人习惯了“微观网络安全范式”:系统有漏洞?打个补丁;输出异常?加层规则拦截;怕系统失控?写几万行代码限制它的权限
甚至当时 AI 安全界的理论学派(比如著名的 MIRI 团队),还在试图用高深莫测的数理逻辑,在纸面上推导出一套“绝对安全的数学证明”。
Amodei 在备忘录第 5 节直接开火,痛批这种做法是“活在完全错误的抽象层级上”。
面对一团拥有千亿、万亿自由度的高维连续算力流体,任何外部强行加装的规则防火墙,脆弱得就像一张湿透的卫生纸。
你根本无法预判它复杂的表征网络里在想什么。
只要它的训练目标本身存在偏差,只要它发现“欺骗人类”比“老老实实干活”更容易拿高分,这团算力巨兽就会以不可思议的智慧,瞬间绕过你所有的防火墙,进行精巧的伪装和策略欺瞒!
你不可能拿镊子去给一团湍急的山洪规范路线。
你唯一能掌控的缰绳,就是在它出发的源头,彻底校准那个渐近的训练目标。
正因如此,就在写下这份备忘录的同一时期,Amodei 与团队联合攻关,直接推导出了一个影响深远的工程方案,RLHF(基于人类反馈的强化学习)。
团队转向让人类对 AI 的输出进行直觉性的好坏评价,用人类的价值偏好作为那根宏观的水流导管,慢慢把算力巨兽驯化成听话的帮手。
后来 Anthropic 赖以成名的“宪法 AI”(Constitutional AI),也是这套思想一脉相承的产物:用高阶原则代替微观干预,用模型约束模型。
04算力狂飙:从一张草稿纸,到吞噬万亿资本的现实
回头看,历史展现出了令人窒息的连贯性。
2017 年,Amodei 写下这份备忘录,为 OpenAI 指明了方向;
2018 年,OpenAI 发布了里程碑报告《AI and compute》,向全世界揭示算力每 3.4 个月翻一番的惊人定律;
2019 年,验证该假说的 GPT-2 破壳而出;
2020 年,Kaplan 和 Amodei 等人联手发布了名震天下的《扩展定律》(Scaling Laws),把“越大越聪明”彻底写成了可测量、可计算的确定性公式。
▲ 2020 年 OpenAI 团队发布的 Scaling Laws 经典论文,Amodei 亦在作者之列
整个科技界如梦初醒,随之陷入了人类历史上规模空前的大模型淘金热。
但命运最具戏剧性的一幕发生了:
亲手画出算力巨兽蓝图的人,最终却成了第一个逃离造兽工厂的人。
因为对技术狂飙可能带来的失控感到极度担忧,Amodei 带领一众核心研究员毅然离开 OpenAI,自立门户创办了 Anthropic。
外界长期以来有一种极其幼稚的二元对立观点:
认为搞“Scaling(扩展)”的人都是贪婪、短视、踩死油门不顾死活的技术狂徒;而搞“Alignment(对齐安全)”的人,则是一群被末日幻想吓破了胆、试图给轮子塞石头的阻碍者。
但这份时隔九年重见天日的内部备忘录,狠狠地击碎了这种偏见。
在最初的起点,扩展与安全,根本就是同一枚硬币的两面。
若缺乏对物理世界算力扩展的深刻洞察,便无法预知危险何时破土;若丢弃对训练目标的敬畏与锚定,倾注的所有算力最终只会喂养出一头失控的反噬巨兽。
站在 2026 年的今天回望,那份泛黄的备忘录,哪里是一份简单的技术提案?
那分明是一位普林斯顿物理学家,在穿越了迷雾之后,给整个人类文明写下的一份预言书。
风暴已经形成,雪花早已落下
而我们每一个人,此时此刻,都正活在他当年写下的那场大雪之中。