ARTICLE · 1143358
AI Agent 常见报错与调试方法:三层排查表,遇到问题不再靠猜
本文是《AI Agent 实战》系列第 4 篇。前三篇我们从概念讲到 LangGraph、再到 Dify,每篇末尾都有"常见报错"小节,评论区问得最多的反而是:"报错太长了,能不能给一张能直接照着查的表?"这篇就是那张表。建议收藏,报错时按层定位,别再盲改代码反复试错。
写在前面:先建立一个"分层"心智模型
Agent 报错最让人崩溃的不是错误本身,而是你不知道该去查哪一层。一个 Agent 请求的完整链路是:
你的业务代码 / Dify 应用↓编排框架层(LangGraph 状态图 / Dify 工作流)↓模型 API 层(DeepSeek / 通义 / Kimi / OpenAI 兼容端点)↓工具层(搜索 API、数据库、本地文件、内部服务)
四层里任何一层出错,最后都可能表现为"程序崩了/没结果/答非所问"。排查的第一原则是先分层定位:用一句最简单的固定输入测试——能跑通就一层层往下加,哪一步炸了就是哪一层的问题。
本篇按层给你三张排查表,最后给一套通用的四步调试方法论。所有口径基于 2026 年的 LangGraph 1.x / Dify 1.x / 主流国产模型 API。
一、模型 API 层:最常见的四类报错
这一层的报错有明确的 HTTP 状态码,定位最快。
表 1:模型 API 报错速查
401 Unauthorized | Authorization: Bearer vs 自定义头) | |
403 Forbidden | ||
429 Too Many Requests | retry-after,按其等待;重试必须用"指数退避 + 随机抖动",见下文代码 | |
400 context length exceededmaximum context length is X tokens | ||
402 | ||
5xx | ||
两个新手最常犯的错:
把 429 当网络问题无限快速重试。429 是配额维度超了(RPM/TPM 是多维度的,任一超了都报 429),快速重试只会加重限流。正确姿势:
import random, timedef call_with_backoff(fn, max_retries=4):for i in range(max_retries):try:return fn()except Exception as e:status = getattr(e, "status_code", None)if status == 429: # 优先尊重服务端指示wait = float(getattr(e, "retry_after", 2 ** i))elif status and 500 <= status < 600: # 服务端抖动可重试wait = 2 ** ielse:raise # 400/401 这类重试没用,直接抛time.sleep(wait + random.uniform(0, 1)) # 随机抖动,防重试风暴raise RuntimeError("重试次数耗尽")
上下文超限不预检 多轮对话把每轮消息无脑 append,Token 近似线性增长,迟早撞墙——而且撞墙前"越聊越笨"(早期无关信息干扰模型)。对策:滑动窗口保最近 N 轮 + 更早内容做摘要,代码里调用前用 tiktoken 或平台计费接口预估 token。
二、LangGraph 层:状态图的六类典型报错
框架层的报错信息通常更"哲学",直接看字面很难懂。逐个拆:
表 2:LangGraph 报错速查
GraphRecursionError: Recursion limit of 25 reached | {"recursion_limit": 50};Agent 任务务必在业务层加最大步数兜底 | |
InvalidUpdateError: Must write to at least one of [...] | {},别返回无关字段 | |
INVALID_CONCURRENT_GRAPH_UPDATE | Annotated[list, operator.add] 或自定义合并函数;这是设计哲学不是 bug | |
update_state 后它仍从旧位置继续 | thread_id 的检查点数据,或换新 thread_id,再重新 invoke | |
另外三个"不报错但结果不对"的隐性问题:
- Agent 无限循环不结束
:模型反复调同一个工具。查提示词里是否缺少"够了就停止"的判断依据;查工具返回是否每次都一样(死板的工具会让模型以为没执行成功);业务层强制最大迭代次数。 - 工具从没被调用过
( tool_calls为空):模型或端点不支持 function calling,或工具 docstring 写得太含糊模型不知道何时调用。确认模型的兼容模式,把 docstring 改成"当用户问 X 时使用本工具"这类触发式描述。 - 中断恢复后行为诡异
:interrupt 之后传 Command(resume=...)的值类型要和中断前抛出的期望一致;用错 thread_id 会串到别的会话状态——生产环境 thread_id 必须和业务会话一一对应。
三、Dify 层:知识库问答的七个高频坑
低代码平台不报"错",它报"效果不对"。对照第 3 篇的实战,把高频问题做成表:
表 3:Dify 排错速查
Dify 排查的核心手段就是召回测试:它能直接告诉你"检索层"和"生成层"谁在背锅。这一步跳过,后面全是玄学调参。
四、工具层的两类经典故障
- 工具执行成功但模型不认账
:工具返回了大段 JSON/HTML 原文,模型消化不了。解法:工具返回值先做裁剪和结构化(只回结论字段、限制长度),别让工具把整个网页塞回上下文——这也是 Token 爆炸的隐形来源。 - 工具报错把整个图拖崩
:外部 API 5xx、超时、参数错误都会从节点里往外抛。解法(LangGraph 1.x 有原生支持):给节点配重试策略( RetryPolicy)和超时,图侧配error_handler做降级分支——网络抖动不该让整条流程崩掉。注意error_handler别配成静默吞错,吞掉的错误是最难查的错误。
五、通用调试方法论:四步定位法
比记错误消息更有价值的是固定流程:
- 稳定复现
:用最小固定输入在本地重现,固定框架版本、模型、温度参数。复现不了的问题先别改代码。 - 读执行轨迹
: LangGraph:先看拓扑 graph.get_graph().draw_mermaid()是否和设计一致;用stream模式逐节点打印状态;再深入就上 LangSmith(官方配套,节点顺序、每次状态变更、工具调用、token 消耗全程可视化)或 LangGraph Studio;Dify:应用"日志与标注"里看每次对话的召回片段和节点执行记录; 模型 API:打印原始请求体和响应体——90% 的"框架 bug"最后查出来是请求参数错了。 - 收缩边界
:把出错的图切成最小子图,逐个去掉工具、外部依赖、并行节点。问题跟着哪个组件走,就是谁的锅。 - 修改 + 回归
:改完必须用一组固定问题(金标集,哪怕只有 10 条)重跑,确认修复没把别的行为改坏。Agent 系统没有单元测试思维,改一个提示词坏三个场景是常态。
六、一张总图 + 应急顺序
【图 1:三层排查决策图——插入文件 图1-Agent报错三层排查决策图.png】
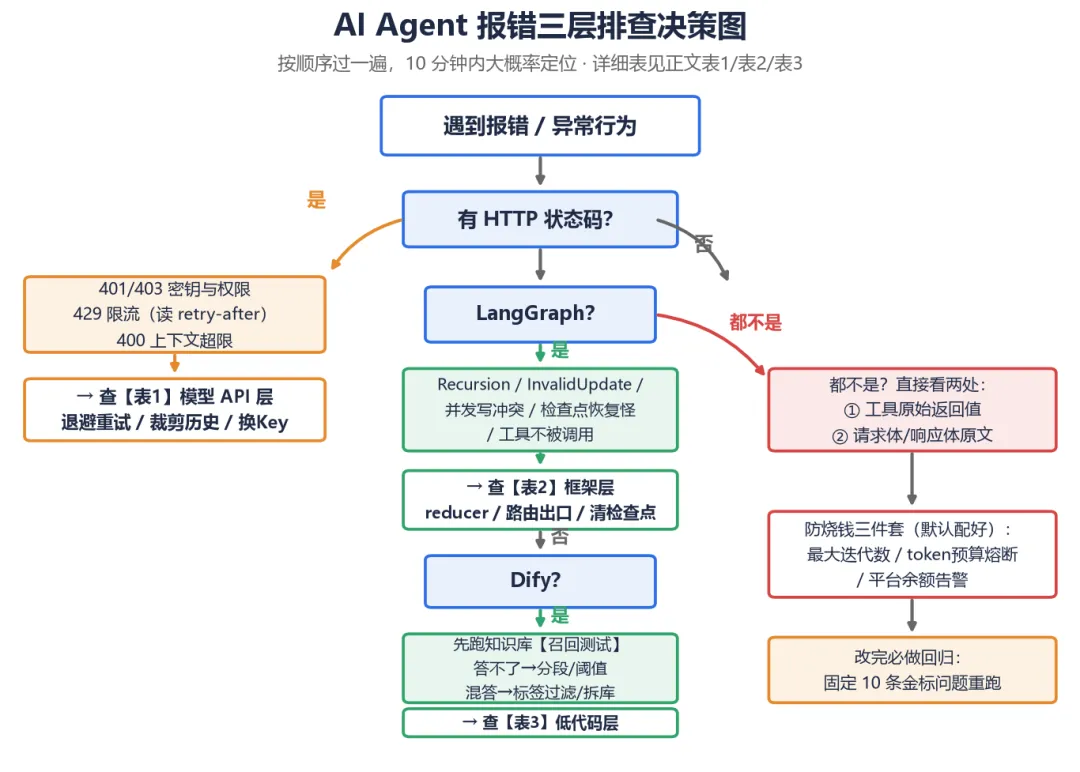
遇到任何报错,按这个顺序过一遍,10 分钟内大概率定位:
有 HTTP 状态码? → 是 → 查表 1(API 层)→ 否 ↓用的 LangGraph? → 是 → 异常类型对表 2(状态/reducer/递归/检查点)→ 否 ↓用的 Dify? → 是 → 先跑召回测试,再对表 3→ 否 → 直接看工具返回值和原始请求体(第四节)
七、成本与预防:别让报错白烧钱
说个容易被忽略的点:死循环类故障是烧钱大户。一个没有最大步数兜底的循环 Agent,一晚上能把账号余额跑光(社区里真实发生过)。三件套必须默认配:
业务层最大迭代次数 / 最大子任务数; 每次调用的 token 预算检查(超限熔断,返回部分结果); 平台侧余额/用量告警(多数模型平台支持,开!)。
这些机制本身不贵,配置各几行代码,但能把"事故"降级成"日志里一行警告"。
总结
本篇给了你三张分层排查表(API 层看状态码、LangGraph 层看异常类型、Dify 层先跑召回测试)、一套四步调试方法论、一个防烧钱三件套。把它当字典用:出问题时顺着"分层"往下查,不要凭感觉改代码。
下一篇预告:《如何把 Agent 接入微信 / 飞书 / 企业微信》——Agent 搭好了,怎么让它真正被用户用起来,消息回调、鉴权、限流一次讲清。
评论区回复"排查"领取本篇三张表的高清打印版(A4 单页)。也欢迎贴你遇到的报错原文,我会挑典型的在下一篇统一解答。