ARTICLE · 1148840
AI 预测车辆故障:别被大模型忽悠!车企真实落地分两步走
AI 预测车辆故障:别被大模型忽悠!车企真实落地分两步走AI 提前预判车辆故障,不等坏了再维修”,听起来非常美好。很多宣传给人的印象:把大模型装到域控制器,车辆就能预知所有故障。 但在车企实际项目中,车载 AI 故障预测很少一步到位直接上车。真实落地分为两大阶段,先在云端验证效果,模型裁剪稳定后,再逐步下沉到车端域控制器。 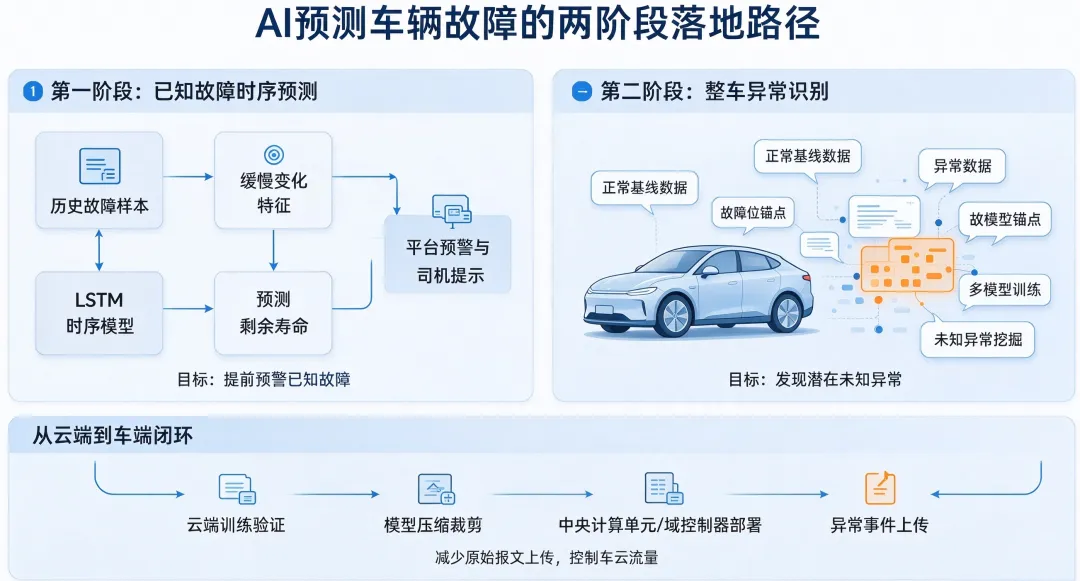
很多零部件损坏不是一瞬间发生的,如电池衰减、轴承磨损、密封件老化,会存在缓慢漂移的特征:电压、温度、阻抗、振动慢慢发生变化。 阶段一:明确某一类故障伴随的缓慢漂移、逐步劣化的时序特征量(电压漂移、温度缓慢偏移、阻抗、间隙逐步变大等) ✅优势: ⚠️局限: 当阶段一跑通后,企业会推进第二阶段:不局限某一类已知故障,对比整车海量正常行驶基线数据,识别整车各类异常行为。 一个可落地且简易方案: 以整车 CAN 应用报文中的故障位作为锚点:当 ECU 已经报出故障位,AI 模型反向回溯,查看故障发生前后哪些信号已经提前偏离正常基线,挖掘潜在的早期异常特征。 ✅优势: 挖掘还没有触发 DTC 故障位的潜在异常,发现新型未知故障,补充阶段一模型覆盖不到的场景。 ⚠️痛点: 阶段二需要消费整车海量的传感器、报文数据,如果全部原始数据持续上传云端,会带来巨大的车‑云流量压力。
💡不少人会疑惑:既然域控制器算力越来越强,为什么不直接把 AI 模型部署在车上? 现实受 4 个硬约束限制: 时序LSTM网络、多模型组合参数量大,会挤占域控原本留给自动驾驶、底盘控制的内存资源; AI 推理会拉高 CPU/GPU 负载,带来发热升高,车载硬件散热设计余量有限; 域控新增 AI 推理任务,属于软件重大变更,需要重新做零部件认证、整车公告,变更周期很长; 模型训练需要几万、几十万台车的数据,车端不可能集齐这么多样本。 所以行业通行路径不是一步到位上车,行业成熟路径: 海量车队数据训练模型;完成阶段一已知故障预测、阶段二异常挖掘;持续调优,把误报、漏报压到可接受水平。 精简模型、缩小输入特征,剔除冗余信号,生成适合车载硬件的轻量化推理模型。 轻量化模型运行在域控,实时监测车辆状态;出现风险,本地给驾驶员、仪表输出预警;仅告警信息回传云端。 车端新故障样本回传云端,迭代模型;通过 OTA 完成车端推理模型版本更新。 ❌坑 1:直接把云端完整大模型原封不动部署到域控,无视内存、功耗、散热、整车公告认证要求。 ❌坑 2:跳过阶段一,直接上马第二阶段整车全量异常挖掘,缺少故障标签锚点,结果是告警满天飞,运维直接放弃使用。 ❌坑 3:过度神化 AI 预测,把 AI 预警当做功能安全硬保护逻辑。 ❌坑 4:模型下沉之后依旧持续上传全部原始报文,没有实现流量节约的目标。 ❌坑 5:只做算法模型,缺少完整业务闭环:算出风险,但没有仪表提示、司机提示、车队工单流程,算法能力无法转化成业务价值。 ❌坑 6:追求 100% 预测所有故障,现实中 AI 预测存在误报漏报,要设置合理的业务容忍指标。 车载 AI 故障预测,不是部署个大模型就万事大吉:
传统车辆故障处理大多属于事后维修:故障发生、DTC 故障位置 1 之后,才通过诊断仪读取故障码。
一、阶段一:针对已知故障,做劣化时序预判(最容易落地)
典型模型:LSTM 时序神经网络,处理随时间慢慢变化的数据,基于历史退化趋势,预估故障大致的发生时间。
完整业务流程
车端 TBOX 持续采集相关车端数据,上传大数据云端平台; 云端 LSTM 模型持续学习特征变化趋势,评估部件劣化程度,预测距离故障发生的剩余时间; 风险升高,双向输出预警:
车队后台生成工单,提示运维提前准备备件; 下发车端提示:提醒驾驶员降低车速、平缓行驶,避免重载暴力操作,防止部件直接彻底损毁,尽快进站检修更换零部件。
目标明确:基于已知故障样本训练,业务逻辑清晰,容易落地产生业务价值; 可以做到故障发生之前提前预警,而不是等故障已经触发 DTC 才报警。
只能针对已经知道、有大量历史样本的故障;
对于从未出现过的新型未知故障,第一阶段模型无法识别。
二、阶段二:整车全量数据挖掘,识别未知异常(难度陡增)
👉两个阶段简单对比表
三、痛点:为什么 AI 故障预测大多先跑在云端,不能直接装在车上?
1、模型体积大、内存开销高
2、算力、散热、功耗压力
3、整车公告与零部件认证约束
4、训练需要海量数据
云端完成训练、验证、调优,确认漏报、误报指标达标; 再对模型做裁剪,缩减输入特征,生成轻量化推理版本,再下沉部署到中央计算单元 / 域控制器。
下沉到车端之后的收益:车端本地完成异常判断,只把告警事件 + 少量关键特征向量上传云端,不再持续上送全部原始报文,大幅降低车‑云流量,弱网环境也可以实现本地预警。
四、完整云‑端协同闭环流程
1、云端:训练与验证
2、模型轻量化裁剪
3、车端域控:本地推理预警
4、数据闭环迭代
五、工程落地高频踩坑清单
💡重要边界:AI 输出仅为风险预警建议,不能替代 ECU 原生 DEM/DTC 故障诊断。整车功能安全相关故障处置,依然由原有电控系统完成。
写在最后
优先把已知故障的时序预测做扎实,拿到真实业务收益; 再去挑战整车未知异常挖掘: 遵循「云端训练验证→模型轻量化→车端下沉推理」的路径,平衡算力、内存、流量、认证多重约束,AI 预测才能真正从实验室走向量产车队。