ARTICLE · 1161363
接手一个没有源码的旧系统时,我开始把 Agent 当调查员用
上个月接手一个旧项目。文档简陋,构建环境丢失,原开发同事早已离职。我手头的"资料"只有 Windows 安装包、零散的日志、一份五年前的接口截图。和很多团队踩过的坑一样,这套系统的源码已经拿不回来了。
GitHub Trending 10 月 8 日出现的 rea 项目,正好是来解决这种困境的工具。不到一周时间,单日新增 7,744 星,累计 19,367 星。它的官方说法很克制:把应用行为、原生二进制、JavaScript/Electron、.NET、网站和网络抓包统一接入 Agent,输出伪代码、汇编、字符串、符号、调用关系、模块、路由、IPC 和运行记录。本机分析、返回时附证据和限制。
真正打动我的,是 rea 把原本依赖个人经验的逆向工程,拆成了 Agent 能追问、开发者能复核、CI 能执行的工程步骤。下面把我们这一周的真实工作流整理成一份实践笔记。
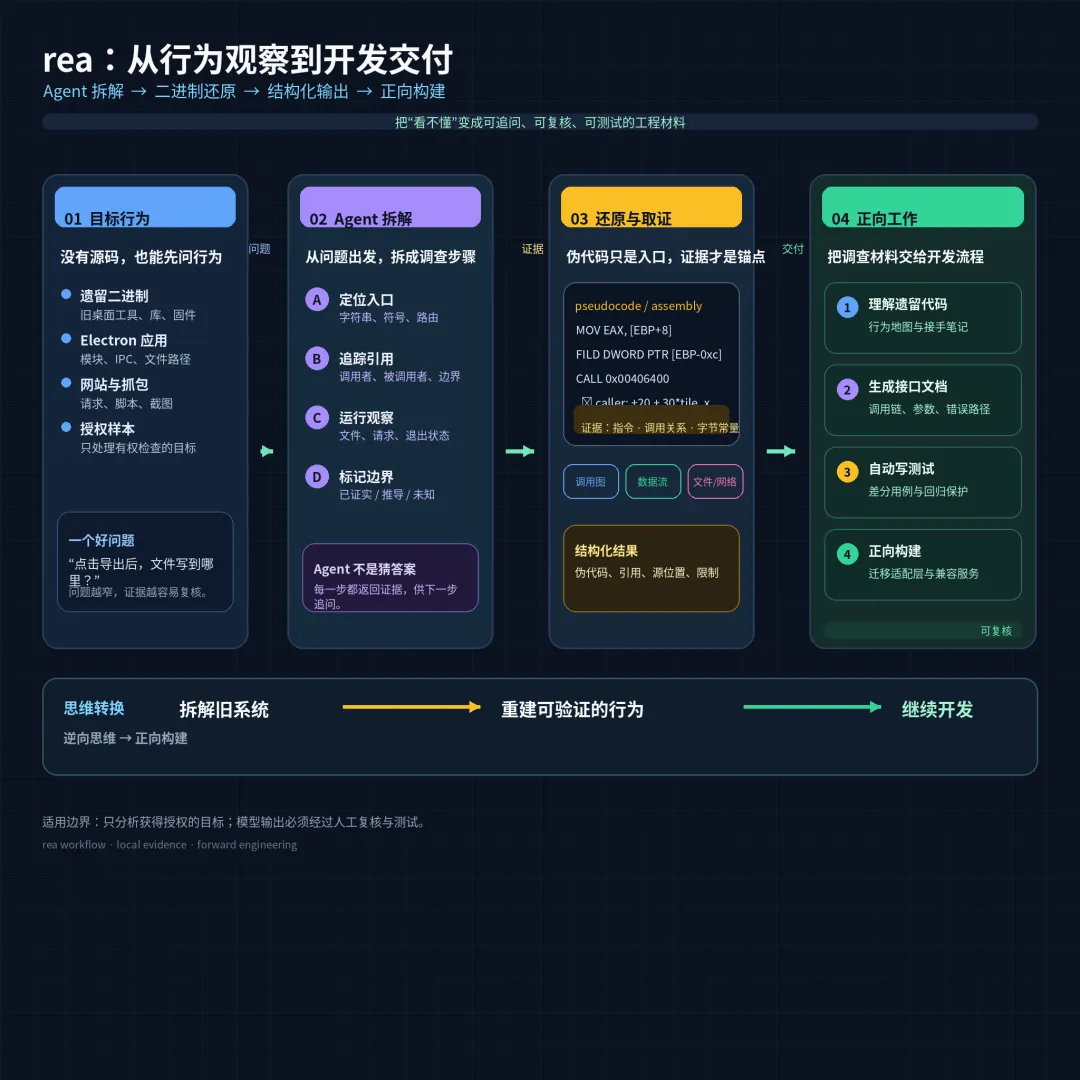
图:从目标程序到调查材料,再到文档、测试和适配层。
从一个问题开始:导出 CSV 到底走哪条路
安装命令只有一行:npx rea-agents setup。安装完,进项目目录,配置后端选 Hopper、Ghidra 还是 IDA。我选了 Ghidra,原因是它免费、社区资料也多。
JavaScript 静态分析不需要原生引擎,这一步给 Electron 项目省下不少事。我让 rea 顺着用户点"导出 CSV"到文件出现在 Downloads 这个过程,给我一份带源位置的调用链路:
入口(渲染进程):notes.exportCsv(),src/renderer/notes.js:42IPC 通道(preload):notes:export,src/preload/index.js:18主进程(handler):src/main/ipc/notes.js:7落盘位置:~/Downloads/notes.csv(via Downloads 渠道)失败分支:取消目录时返 { ok: false, code: 'E_CANCEL' }未解分支:未观察到 timeout 退出码
这就是一份行为地图:谁调用谁、数据在哪拐弯、文件在何时产生。按入口一层层查权限、编码、失败路径,比从零读二进制快得多。把这份地图交给团队里另一位同事,能从一个入口开始阅读,逐层核对。
把结果写成接口卡片,而不是让 Agent 凭印象写文档
接着我跟 Agent 说:"把目标行为整理成接口卡片,区分'已观察到'、'由代码推导'、'仍未知'三类标注。"Agent 给我返了一份 Markdown:
card:name: notes.exporttype: ipc-maincaller: src/renderer/notes.js:42handler: src/main/ipc/notes.js:7input: {ids: string[],format: 'csv' | 'json'}output: {ok: boolean, path?: string, code?: string}side_effects: [file_write: ~/Downloads/notes.csv]errors: [E_CANCEL (source: notes.js:23),E_TIMEOUT (source: unverified)]
每张卡片区分三类标注。版本更新时重新跑调查,文档跟着更新 :: 这一点比起让 Agent"凭印象"写 API 文档靠谱得多。
旧程序当 oracle:差分测试是这套方法的关键
差分测试是这套方法的关键。我们准备了一组正常输入、边界输入、错误输入,让 rea 记录返回值、文件差异、网络请求、退出状态,再让 Agent 生成回归用例、属性测试、差分测试。断言落在可观察行为上,不能绑死内部函数名。
官方的 DX-Ball 案例给了一个可核对的尺度:3,205 个原始 x86 用例,重放出完整函数的 63 个编译字节。对普通团队来说,不必追求这个数字。能拿到稳定输入、明确输出、可在 CI 重跑的差分结果,就足以支撑模块重构。
测试生成后还要做一次人工筛选:删掉只依赖环境噪声的断言,给时间戳、随机数、文件路径设容差,把未能确认的分支标成待验证。旧程序只能当行为参考,规格仍要由团队确认。
调查的终点是适配层,不是发布
调查的终点常常是适配层。旧程序只剩可执行文件时,按这个顺序推进:
确认命令行参数、输入格式、输出结构 在新项目写适配器 把旧引擎包成服务或 CLI 为新旧版本做功能对照表
每一步都保留授权边界:只分析有权检查的目标,不把逆向结果当成可发布代码。逆向回答旧程序做了什么,正向工程回答新程序怎样保持同样的结果。两段工作拼起来,迁移才走得稳。
别忘了 LLM 会幻觉这件事
2025 年的两项研究先后指出:
Frontiers in Computer Science 比较研究把 LLM 方法与传统形式化逆向并列评估。结论是模型方法在语义正确性上与传统方法有差距,结果能否支撑后续正向工程要看证据链。 arXiv 报告,LLM Agent 用在二进制可视化场景,小程序生成的调用图质量差异很大。
我们这一周也撞到过模型"虚构接口"的偏差。每条结论都要求 Agent 同时返回源位置、调用路径、最小复现步骤,三件事缺一就只能当草稿。证据链恰恰是抵消这些偏差的工具。
得出的几条经验
第一,授权边界要前置。逆向任何目标前,先把"我能分析什么、不能分析什么"写在 README 顶部。
第二,证据链是底线。每条结论都要有源位置、调用路径、最小复现步骤,缺一不可。
第三,差分测试要落在可观察行为上,不能绑死内部实现。第四,调查走完之后必然走到适配层 :: 适配层才是迁移真正能交付的产物。
把逆向放回开发流程,它承担的是调查和取证。新程序能否继续维护,要看这些材料有没有变成文档、测试和适配层。我们建议从一个授权的旧模块开始:找出入口,列出证据,跑一组差分测试。只要结果能复现,文档和测试就能留下;工具会换,证据链才是能带进下一个版本的资产。