ARTICLE · 1165963
AI时代的认知漏斗:5000人与80亿人看到的是两个世界
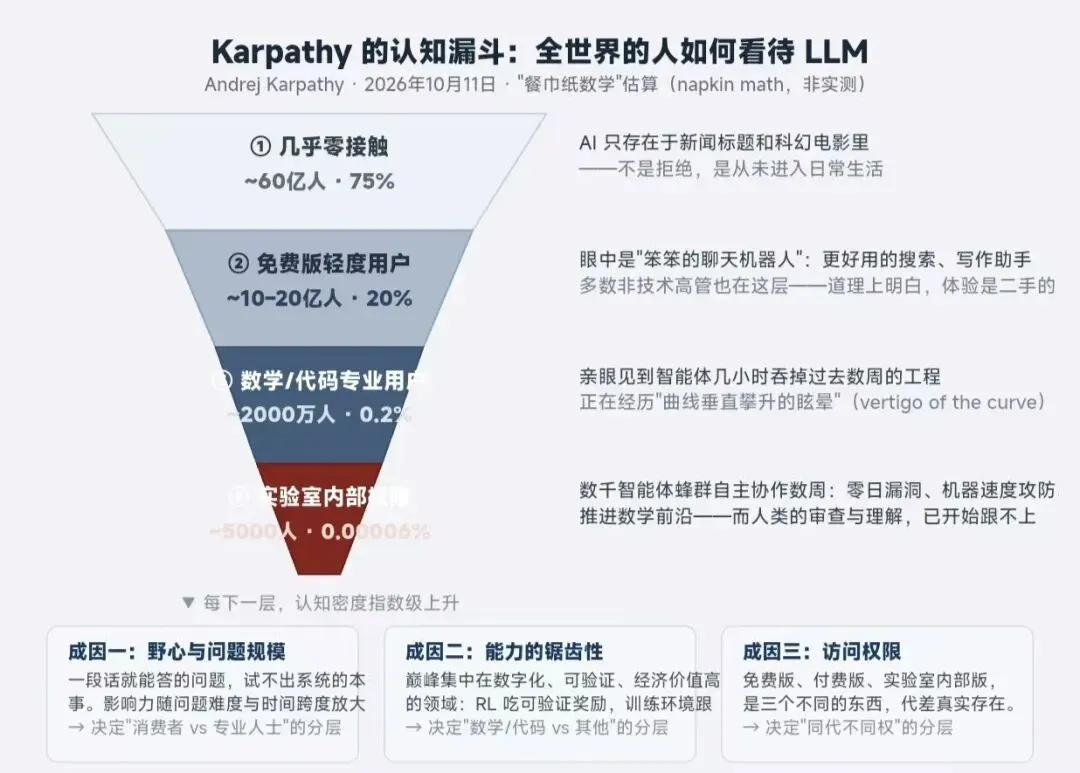
OpenAI创始成员、前特斯拉AI总监Karpathy,10月11日在X上扔下一颗深水炸弹。
他说:人类对AI的认知,已经裂开成一个漏斗。最上面站着60亿人,最下面站着5000人。
中间隔着的不是贫富差距,是两个世界。
60亿人 · 几乎零接触
↓
20亿人 · 免费版轻度用户
↓
2000万人 · 专业使用者
↓
5000人 · 实验室内部
每下一层,认知密度指数级上升
一个漏斗,四层人生
第一层 · 60亿人,AI不存在
约占全球人口75%的人,几乎从未与大模型有过任何接触。
AI对他们来说,是新闻标题里的词,是科幻电影里的幻影。不是拒绝,是从未进入生活。
第二层 · 20亿人,AI是个笨机器人
10到20亿人,偶尔用用免费版ChatGPT,把它当成更好用的谷歌搜索、写作助手。
他们眼中的AI,是个会犯低级错误的“笨笨的聊天机器人”:问它一个问题,它胡言乱语;让它订个机票,手忙脚乱。
注意:多数非技术行业的高管,也都在这一层。每天的时间花在开会、协调、打交道上,理智上知道AI在翻天覆地,体验却是二手的、抽象的。
第三层 · 2000万人,眩晕
在数学和代码领域专业使用前沿模型的约2000万人。
他们亲眼看到:过去需要顶级工程师干几周甚至几个月的项目,现在一段提示词,智能体几小时就吞掉。
Karpathy自己说:不到一年前,他还在编辑器里一个字符一个字符地手敲代码。
这群人正在经历一种叫“曲线垂直攀升的眩晕”的症状——他们比任何人都清楚,这条曲线的斜率有多恐怖。
第四层 · 5000人,超出想象
全球只有约5000人,能接触到实验室内部的前沿系统。外界看到的只是预告片,而他们看到的是:
数千个智能体像蜂群一样,无人干预地自主协作数周,铸造零日漏洞,以机器的速度进行网络攻防,推进数学前沿——这些事,过去需要顶级专家耗尽数年。
最可怕的是:人类的审查和理解,已经开始跟不上。OpenAI-HF事件的机器日志,人类至今还在“考古”;AI产出的722篇数学手稿,数学家要消化很久。
同一个AI,为什么活出四种模样
原因一 · 问题太小,试不出本事
一段话就能回答的问题,系统连热身都算不上。就像用一辆跑车在停车场里挪车,然后得出结论:这车没什么了不起。
影响力,随你的野心和问题规模放大。
原因二 · AI的能力是“锯齿状”的
它的巅峰,集中在数字化、可验证、经济价值高的领域。因为大模型的能力来自“可验证奖励”上的强化学习——代码对错分明,数学一验便知,训练信号清晰,商业回报确定。
所以数学和代码率先“开挂”,而开放式的创作与思考,好坏没有统一标准,只能慢慢来。
原因三 · 权限是真实存在的代差
免费版、付费版、内部版,是三个不同的东西。
最扎心的一幕
这个时刻的怪异之处在于:以上四种体验,正在同一秒钟里同时发生。
大众没碰过AI;碰过的人看到笨机器人;多数专业人士只感到小幅提升;极少数人正在经历眩晕。
而大多数人的AI世界观,是被去年那个免费版旧模型,和社交媒体上疯传的“AI翻车集锦”塑造的。
用过期样品,给整个时代下判决书——这是这个时代最隐蔽的认知陷阱。
写在最后
判断AI能力时,最危险的动作,就是拿你见过的那个免费版笨机器人,去推断前沿正在发生什么。
样本过期,加上权限不足,是双重失真。
你看到的AI是假的。但更大概率是——看到假AI的你,正是被蒙在鼓里的大多数。