ARTICLE · 1168225
Long-WAM 源码精读:先想后动的世界-动作模型,如何让 19.2 秒视觉记忆不拖慢实时控制?
传送带加速到 7.5 cm/s 时,π0.5 的抓取成功率从 15% 掉到 0%,Fast-WAM 从 75% 掉到 0%,而 NVIDIA、MIT、HKU、UCSD 合作的 Long-WAM 保持在 90%。同一个物理场景,差距来自模型看得见多久的过去、以及看见了会不会用。这篇精读对照论文与 NVlabs/LongLive 仓库里的 Long-WAM 代码,把这套「世界-动作模型」的实现拆开看一遍。
01 先看结论
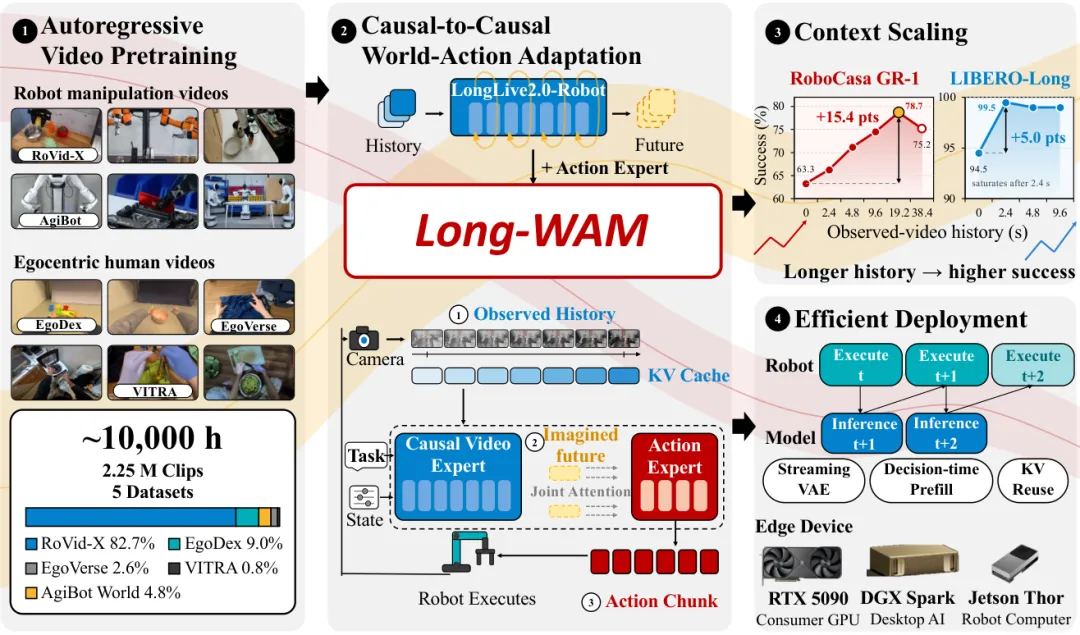
Long-WAM 解决的是一对矛盾:实时机器人控制需要足够长的视觉历史来判断运动和任务进度,但历史越长,注意力、KV 缓存和预填充的计算越重,动作出手就越慢。它的答案是三件事叠加:先用自回归(AR)方式在约一万窗时的机器人与第一视角视频上预训练一个视频生成基座(LongLive2.0-Robot),让模型在预训练阶段就学会「从历史推未来」;再把视频专家和动作专家做因果到因果的适配,动作去噪以视频专家预演的未来隐变量为条件;最后用异步执行、流式 VAE 编码和 NVFP4 量化把整套推理压进端侧延迟预算,在 RTX 5090 上一个动作块(含未来视频隐变量预测)只要 107.4 ms。
改动停在哪:论文里每个上下文长度都是一个单独训练的模型(RoboCasa GR-1 上五档,0 到 19.2 秒),不是单一模型动态调窗;38.4 秒一档成功率回落到 75.2%。仓库自己声明完整基准复现尚未重跑,原始结果包不随代码发布。
只看一处的话,先看 configs/denoising/idm.yaml——三行参数(sigma: 0.9、video_steps: 4、joint: false)就是这套「先想后动」的全部开关,再去 src/longwam/models/wan22/longwam_base.py 里的 _imagine_future_latents 看它怎么被执行。
02 问题背景
抓一个传送带上的杯子,单帧图像给不出运动方向和速度,策略只能盲猜时机。现有视觉-语言-动作模型(VLA)大多把条件压在当前一帧或极短历史上,动态任务上吃亏明显。直接加长历史有两个代价:一是预填充和注意力的序列变长,推理延迟随之上去了;二是直觉上的「多看总没坏处」在实验里并不成立——论文用 Wan2.2 双向预训练的基座做了对照,历史从 2.4 秒加到 19.2 秒,成功率从 61.7% 到 61.6%,基本没动。能访问历史和会用历史是两回事,差别出在预训练方式上。
部署侧还有一道坎。为了不让推理阻塞机器人,主流做法是异步执行:模型算下一块动作时机器人继续走当前块。但两个动作块在重叠区如果不连续,轨迹会抖。论文的对照里,Fast-WAM 异步执行掉 15.4 个点,LingBot-VA 掉 45.5 个点。想让长历史真正用在实时控制上,模型和执行系统得一起改。
03 方法拆解
主线是两阶段。第一阶段 LongLive2.0-Robot:从 LongLive-2.0 的 16 秒 AR 检查点继续训练,数据约一万窗时(2,294,889 个样本,来自 RoVid-X、AgiBot World、EgoDex、EgoVerse、VITRA),只用视频、没有动作标签,序列最长 30 秒,教师强制加块因果注意力监督每个噪声块。第二阶段因果到因果适配:视频专家保持因果时序,动作专家通过非对称注意力读历史、部分去噪的未来和整段噪声动作块。
设计一:先想后动(论文称 IDM,逆动力学建模)。动作生成前,视频专家先从纯噪声把未来隐变量滚到 σ⋆=0.9 的噪声水平就停——四步(V4)只把未来擦到一成干净,动作专家读的是这张「未来草图」的逐层 KV 缓存,全程不解码回像素。训练分两趟:视频通路在干净历史上做流匹配,动作通路在历史加前向加噪的真实未来(同样到 σ⋆=0.9)上做流匹配,第二趟的视觉缓存整个 detach,动作损失只更新动作专家和本体感知适配器。
设计二:执行系统。异步调度只允许 R/2 ≤ S < R ≤ H(H 为块长、R 为可执行步数、S 为触发步长),交接时丢弃已过时的前缀、迟到的块就在边界等;流式 VAE 在观测帧到达时就分组编码,把就绪时限压到 T_ready ≤ O·Δt(O=R−S);再叠 NVFP4 权重激活量化(只作用于视频专家线性层,动作计算和 KV 存储保持 BF16)、CUDA Graph、去噪不变量 KV 复用,三档设备总加速 3.2 到 4.1 倍。
一个必要公式,流路径写成 x_σ = (1−σ)·x + σ·ε,速度目标 u = ε − x,总损失 L = λv·Lvideo + λa·Laction,配置里两个 λ 都取 1.0。
04 源码对照
调用链从脚本到算子:scripts/libero/eval.sh 转发到 scripts/eval.sh → longwam.cli eval → src/longwam/evaluation.py 组装设置 → src/longwam/runtime/policy.py 建策略,里面一行决定走哪条推理:
infer_fn = model.infer_joint_ar ifgetattr(model, "num_imagine_frames", 0) > 0else model.infer_action有未来隐帧(k>0)就走 longwam_base.py 的 infer_joint_ar:先 _imagine_future_latents 部分去噪,再 mot.prefill_video_cache 预填充,动作去噪全程经 forward_action_with_video_cache 复用这份缓存。
对照一:σ⋆=0.9 的四步预演、未来不解码。论文 §3.2 末段写明「四个视频步停在 σ⋆=0.9 而不是干净视频,未来隐变量从不解码回像素」。代码入口在 configs/denoising/idm.yaml(joint: false、sigma: 0.9、video_steps: 4),经 configs/model/long_wam.yaml 的 longwam_imagine_sigma、longwam_imagine_infer_steps、longwam_num_imagine_frames: 2 传入,src/longwam/models/wan22/long_wam.py 换算成调度器时间步:
self.imagine_timestep = float(imagine_sigma) * nttlongwam_base.py 的 _imagine_future_latents 执行部分去噪,文档串写着「Latent-only (NO VAE decode)」:
ntt = float(self.train_video_scheduler.num_train_timesteps)sigma_target = float(self.imagine_timestep) / nttsteps = max(1, int(self.imagine_infer_steps if num_inference_steps isNoneelse num_inference_steps))u_steps = torch.linspace(1.0, 0.0, steps + 1, device=self.device, dtype=torch.float32)sigma_full = self.infer_video_scheduler._phi(u_steps, shift) # 1.0 -> 0.0对应关系:论文的 σ⋆ 落在配置 sigma、imagine_timestep 和 sigma_target 三处同一数值 0.9;V4 对应 video_steps=4;重标定那行保证终点正好落在 0.9,起点保持纯噪声。
对照二:训练第二趟的视觉缓存 stop-gradient。论文 §3.2 说「第二趟 detach 视觉缓存,动作损失只更新动作专家和本体感知适配器」。实现在 longwam_base.py 训练损失的 PASS B 段(注释自称 P4 joint imagination),timestep_imagine 固定为 imagine_timestep,缓存构建整个包在 no_grad 里:
with torch.no_grad(): noise_video_hi = torch.randn_like(input_latents) latents_hi = self.train_video_scheduler.add_noise(input_latents, noise_video_hi, timestep_imagine) latents_hi[:, :, 0:self.num_clean_frames] = inputs["first_frame_latents"] video_kv_cache_hi = self.mot.prefill_video_cache(...) # 省略命名参数video_kv_cache_hi = [ {"k": layer["k"].detach(), "v": layer["v"].detach()} for layer in video_kv_cache_hi]对应关系:干净历史帧保持干净、未来用独立新采样的噪声、缓存显式 detach 后再供带梯度的动作分支读取,四点与论文附录 B.2 的训练代理描述逐条吻合。
再看异步约束。论文 §4.1 的 R/2 ≤ S < R ≤ H 在 src/longwam/runtime/execution.py 是一行硬校验:
ifnot0 < self.stride < self.execute <= self.horizon or2 * self.stride < self.execute:raise ValueError("Async scheduling requires R/2 <= S < R <= H")runtime/settings.py 里 trigger_stride 缺省取 (execute+1)//2,execute_steps=24 时 S=12,正是论文表 7 用的设置。
区分三种情形:默认行为是 configs/train.yaml 的 defaults 里 denoising: idm、部署配置 execution: sync、streaming_vae: false;异步加流式 VAE 和 rtx5090 硬件档是论文实验设置,infra/README.md 给了完整命令(H=32、R=24、S=16 的例子);其他分支包括 CoD 联合去噪(configs/denoising/codenoise.yaml 的 joint: true,走 longwam_joint.py)和无未来预测的 w/o V(k=0 时退化为 infer_action)。还有一个容易混淆的点:longwam_idm.py 里的 LongWAMInverseDynamics 是从 FastWAM 仓库改来的另一支实现,文件头注明了来源,主配置 _target_: longwam.runtime.create_longwam 构建的是 long_wam.py 的 LongWAM,两者不是同一个类。
05 实验配置
预训练:64 张 H100、约 30,720 GPU 时,从 LongLive-2.0 的 16 秒 AR 检查点继续训练;数据 2,294,889 个样本,按 16 秒一个窗口折合约 10,004.5 窗时,其中 RoVid-X 占 1,898,562、EgoDex 207,044、AgiBot World 两个子集合计 110,331、EgoVerse 59,742、VITRA 19,210;训练/验证/测试切分为 2,251,021 / 21,931 / 21,937。stage1 配置(stage1/configs/train_s.yaml)里 causal: true、teacher_forcing: true、序列并行 size 2、学习率 5e-6。
下游适配:16 张 GB200。优化对象是视频专家加动作专家(视频损失照常更新视频专家),但动作通路的视觉缓存 detach,等价于该通路冻结视频专家;本体感知适配器随动作通路更新。configs/train.yaml 与论文 §5.1 对上:AdamW、峰值学习率 1e-4、cosine 衰减、5% warmup、BF16、梯度裁剪 1.0。LIBERO 任务配置(configs/task/libero.yaml)10 个 epoch、期望全局批 128;数据配置(configs/data/libero.yaml)四个 no_noops 子集、past_obs_size 48、action_chunk 32、分辨率 224×448。
主配置是 configs/model/long_wam.yaml:视频专家 30 层、隐藏 3072,动作专家 30 层、隐藏 1024,基座 Wan2.2-TI2V-5B,两个 λ 均为 1.0。RoboCasa GR-1 全部档位 20 Hz 控制、16 步动作块(README 表格),上下文五档对应 configs/context/p0.yaml 到 p384.yaml(past_obs_size 0/48/96/192/384,即 0 到 19.2 秒),38.4 秒一档在 p768。LIBERO 评测配置:每任务 50 个 episode、action_horizon 80、replan_steps 10。软件栈 Python ≥3.10、PyTorch 2.7.x,仓库要求部署、训练、stage1 三套环境隔离(数据集库版本冲突)。
最影响可比性的条件:每个上下文长度单独训练并在各自训练长度上评测;DOMINO 的数字是动态数据微调之后的;RoboCasa365 用 Human300 训练的检查点;延迟对比里各基线在各自原生部署配置下去测。
06 结果怎么看
数字全部取自论文表格,按设置分开列,仓库没有重跑,也不当实测。
LIBERO(表 2):IDM 模式平均 99.5%,LIBERO-Long 99.5%,比 LingBot-VA 高 1.0、比 Fast-WAM 高 4.3;同表里 w/o V(不预测未来)94.5%、CoD(联合去噪)97.8%,先想后动的增益集中在最长任务的子集上。RoboTwin 2.0(表 2):IDM 平均 94.4%,Clean 94.7%,Randomized 94.2% 与最好成绩打平。
DOMINO(表 3,动态数据微调后):成功率 34.9%、操作分 45.1,比该表最强基线分别高 15.0(对 Fast-WAM)和 10.1(对 PUMA)。RoboCasa GR-1(表 4 与 §5.3):历史 0 到 19.2 秒,成功率 63.3% 升到 78.7%,超过该基准最强基线 Cosmos Policy(67.1)11.6 个点;2.4 到 19.2 秒区间内两个 AR 基座分别涨 12.4 和 11.0 个点,双向基座只从 61.7% 摸到 9.6 秒的 64.1% 又回落到 61.6%;AR 领先幅度从无历史的 3.3 个点扩大到 19.2 秒的 17.1 个点。38.4 秒回落到 75.2%,作者归因于训练轨迹平均只有 12.1 秒、该档 80.4% 的历史帧是填充。
真机(图 7、图 8,每条件 20 次):Unitree G1 在传送带 3.0 到 7.5 cm/s 四档速度下抓取成功率 100%、100%、95%、90%;动杯叠杯 19/20,π0.5 和 Fast-WAM 都是 0/20。YAM 双臂长程任务(平均超 40 秒)分色码砖、饺子入锅、摞碗三件,成功率 80%、80%、85%,平均 81.7%。
效率(表 6、表 8):RTX 5090 上 V4/A4 端到端 107.4 ms(RoboTwin 2.0 成功率 93.5),V2/A2 81.8 ms(92.5,多降 1 个点换 24% 延迟),BF16 无优化基线 356.0 ms(94.4);比 Fast-WAM 的 244.1 ms 快 2.3 倍,且多做了未来视频预测。DGX Spark 328.2 ms、Jetson AGX Thor 378.7 ms,总加速 3.3、4.1、3.2 倍。代价也直说:历史 8 倍,延迟 3.2 倍(107.4 到 341.0 ms)。
异步(表 7):S=12、R=24 下 IDM 从 94.4% 到 94.2%,CoD 从 93.6% 到 93.2%;Fast-WAM 从 91.8% 掉到 76.4%,LingBot-VA 从 92.2% 掉到 46.7%。重叠区 RMSE 和 jerk 约为 Fast-WAM 的三分之一。
组合任务(表 5,RoboCasa365 五十个任务):Long-WAM 单独总分 31.4%(原子已见 67.9%),加 GPT-6 Astra 做高层规划后 54.4%(组合未见 35.0%);π0.5 加同一规划器是 30.5%。
07 论文与代码
已对上的:σ⋆、V4、λ 权重、学习率与调度、五档上下文、异步约束,前面各节都给了位置。仓库比论文多出的工程内容:稀疏克隆只拉 Long-WAM 子目录、--dry-run 不碰 GPU 只查配置、checkpoint 带 SHA256SUMS、部署默认只读推理(deploy.py 里 driver.connect(read_only=True),动作下发要走单独的 arm 调用)、87 项 CPU 回归测试加 41 项 CLI 检查。只是配置选择、不是缺陷的:部署默认 sync 与流式 VAE 关闭(论文实验再显式打开)、各基准推理步数不同(LIBERO 评测 20 步、部署档 10 步)、longwam_idm.py 保留 FastWAM 血统的另一支 IDM 实现并在其训练里用 0.5 概率给条件视频加噪。仓库在 docs/BENCHMARKS.md 里明说:完整原始结果包不随仓库发布,不主张迁移后的入口已经复现论文数字——这是诚实但需要注意的边界。
08 复现路线
环境:Python ≥3.10、CUDA 版 PyTorch 2.7.x,先 pip install -e '.[infra]' 做推理评测,训练用 .[train] 另起一套(datasets 库版本 4.x 与 3.6.0 冲突)。最小样例不必碰真机:稀疏克隆后 python scripts/download_checkpoint.py robocasa365 拉公开检查点(Hugging Face Efficient-Large-Model 组织,修订号钉在 configs/checkpoints.yaml),再跑 bash scripts/robocasa365/eval.sh,装好模拟器即可。不装 GPU 先验证链路可以用 --dry-run。成功标志:eval 脚本输出各任务成功率;下载后 sha256sum -c SHA256SUMS 通过。容易看错的三处:σ⋆=0.9 是「停在九成噪声」而不是去噪完成了九成,未来草图只含一成信号;past_obs_size 单位是控制步/隐帧不是秒,GR-1 上 20 Hz 换算 48 步才是 2.4 秒;longwam_num_imagine_frames: 2 是未来隐帧数,别当成动作块长或视频帧数。
09 判断
有证据的价值:同一套因果适配、只换视频基座,AR 基座在 19.2 秒涨 12 个点而双向基座不动,这组对照把「历史有没有用」和「预训练会不会用历史」拆开了,比单点刷榜更有说服力;真机传送带上与两个基线的差距(90% 对 0%)和异步几乎不掉点(0.2 对 15.4、45.5)都有 20 次试验和表格支撑;工程侧每档优化在表 8 里逐行可查,不是一句「优化了」带过。
限制也摆在纸面上:每个上下文长度单独训一个模型,GR-1 一档就是一次完整训练,长上下文的算力门槛没有消失;38.4 秒掉点的原因(历史覆盖稀疏、八成是填充)是作者的假设,论文自己用了 hypothesize 的措辞;DOMINO 的 34.9% 依赖动态数据微调,未微调的数字论文没有给出;预训练三万 GPU 时的成本决定了这条路线对多数团队是「下载检查点」而不是「从头训」。我的推测(论文未做此实验):从表 8 的逐档加速看,训练与推理共享的 KV 复用和量化路径对更长上下文的收益还会放大,但缓存失效语义(本体状态更新、旧上下文逐出)是仓库注释里自己点名的坑,先想后动这条路要走到 38.4 秒以外,瓶颈大概率在数据密度而不是模型结构。想自己验证的人,五档 GR-1 检查点都是公开的,直接对齐同一评测协议跑一遍,比看任何转述都可靠。
参考资料
论文:Long-WAM: Scaling the Context of World-Action Models,arXiv 2610.10528:https://arxiv.org/abs/2610.10528[1] (PDF:https://arxiv.org/pdf/2610.10528[2] ) 代码仓库:NVlabs/LongLive 的 Long-WAM 子目录,固定 commit 290be9be6e380e52511b9a0322bd7d69e4295e0e(2026-10-12):https://github.com/NVlabs/LongLive/tree/290be9be6e380e52511b9a0322bd7d69e4295e0e/Long-WAM[3]主要配置(同 commit 下 Long-WAM/内):configs/denoising/idm.yaml(σ⋆=0.9、V4)、configs/model/long_wam.yaml(双专家结构与 λ 权重)、configs/context/p0.yaml至p768.yaml(0–38.4 秒五档加 38.4 秒档)、configs/train.yaml(学习率与调度)、configs/data/libero.yaml(数据与批配置)主要源码(同 commit 下 Long-WAM/内):src/longwam/models/wan22/longwam_base.py(_imagine_future_latents部分去噪、PASS B 训练)、src/longwam/models/wan22/long_wam.py(imagine_timestep 换算)、src/longwam/models/wan22/mot.py(prefill_video_cache/forward_action_with_video_cache)、src/longwam/runtime/execution.py(R/2≤S<R≤H 校验与 AsyncPolicy)、src/longwam/runtime/streaming_vae.py、src/longwam/runtime/policy.py(infer_joint_ar 分派)文档与检查点: docs/BENCHMARKS.md、docs/VERIFICATION.md;公开检查点在 https://huggingface.co/Efficient-Large-Model[4] (含 Long-WAM-RoboCasa-GR1-0s/2.4s/4.8s/9.6s/19.2s 五档)
引用链接
[1]https://arxiv.org/abs/2610.10528
[2]https://arxiv.org/pdf/2610.10528
[3]https://github.com/NVlabs/LongLive/tree/290be9be6e380e52511b9a0322bd7d69e4295e0e/Long-WAM
[4]https://huggingface.co/Efficient-Large-Model