ARTICLE · 1183242
AI 配置期货:打平等权,差在换手
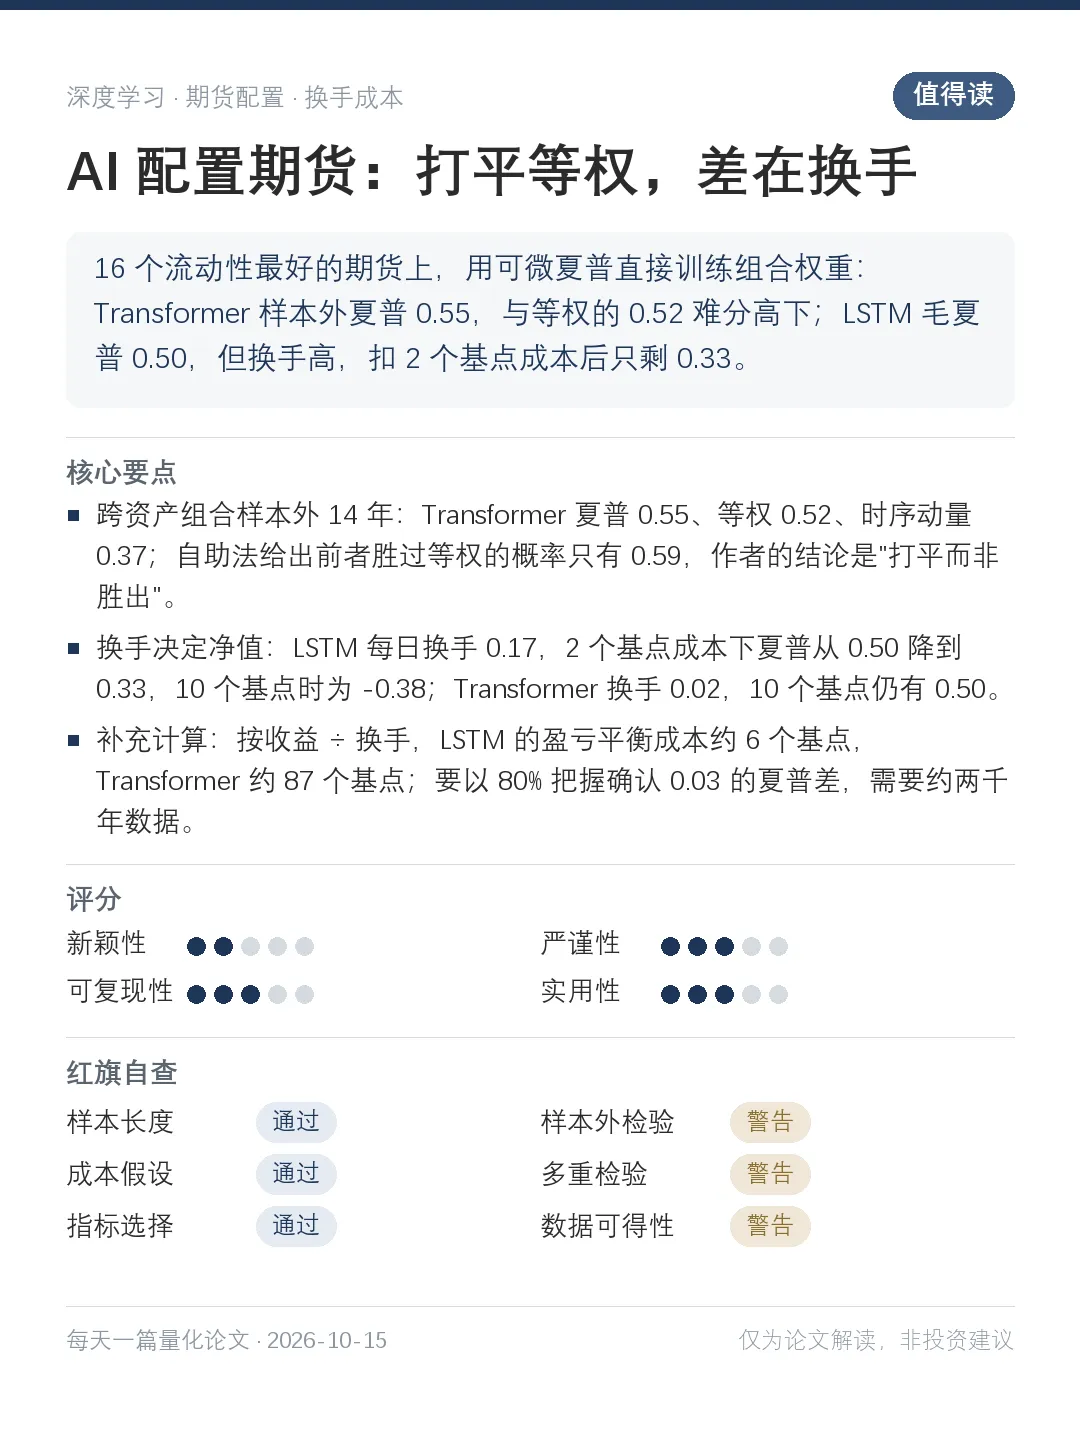
16 个流动性最好的期货上,用可微夏普直接训练组合权重:Transformer 样本外夏普 0.55,与等权的 0.52 难分高下;LSTM 毛夏普 0.50,但换手高,扣 2 个基点成本后只剩 0.33。
这一章的前两篇,一篇是量子核预测 A 股横截面,一篇是时间序列大模型预测波动率,都是"先预测、再使用"。本篇是这一章的最后一篇,换一种思路:不预测收益,直接学习仓位。
一、它想回答什么
跨资产配置的标准做法分两步:先预测各资产的收益和协方差,再做均值—方差优化。问题在于收益预测噪声很大,小的预测误差会被优化放大成不稳定的权重。
端到端的思路是把两步合成一步:用神经网络把市场状态直接映射成组合权重,训练目标就是组合本身的夏普比率。这在金融经济学里叫"参数化组合策略",在运筹学里叫"面向决策的学习",在强化学习里叫"策略函数近似"。
该文问的是一个很务实的问题:在全球宏观和管理期货实际会用的品种上,这类策略什么时候能胜过从业者真正在用的简单规则,而且胜出的幅度足以抵消它增加的复杂度? 作者明确说,目的不是提出新架构。
二、设计
品种:16 个芝加哥商品交易所流动性最好的期货,覆盖六大类——股指 3 个、利率 4 个、外汇 2 个、能源 2 个、金属 3 个、农产品 2 个。选最具流动性的品种,是为了排除流动性溢价这一收益来源,让检验更接近纯粹的择时。日频数据 2000 至 2024 年,连续合约按成交量和持仓量换月,所有计算只用过去的数据。
数据特征:同一大类内部,日收益的平均两两相关系数是 0.67;不同大类之间只有 0.05,几乎正交。每个大类滚动一年的夏普比率都在正负之间反复切换。
策略:一种用于资产配置的 Transformer(编码器和解码器各四层,带因果掩码),以及作为对照的 LSTM。网络输出每个资产的得分,经过"带符号的 softmax"变成多空权重,总绝对敞口为 1。训练目标是毛收益的负夏普比率;另测试了加入换手惩罚的版本。
状态变量:作者构造了趋势、均值回复、赫斯特指数、偏度、峰度、波动率、相关性等特征,但它们在样本外"几乎没有增益、迁移也不稳定",所以正式结果只用各品种的日收益序列作为输入。
滚动检验:前 40% 的样本用于初始训练,之后按约四年一段扩展窗口重新训练,按时间顺序 90/10 划分训练集和验证集,不打乱。跨资产组合的样本外期为 2011 至 2024 年。分别对六个大类和全部 16 个品种各跑一次,共七个"组合范围"。
对照规则:等权(纯多头)、风险平价(60 日波动率倒数加权,纯多头)、12 个月时间序列动量(多空)。所有策略每日调仓。
成本:按每单位换手 2 个基点计费,另做 0 到 10 个基点的敏感性分析。
统计推断:七个范围的夏普比率是否显著异于零,用 Bonferroni 校正(要求 |t| > 2.69);两个策略谁更好,用平稳自助法检验夏普差;再用 Newey–West 回归把收益分解为市场暴露和残差 α。
三、主要发现
样本外夏普(毛):
| 0.55 | |||||
| 0.87 | |||||
| 0.43 | |||||
| 0.25 | |||||
| 0.35 | |||||
| 0.30 | |||||
| 0.34 |
(* 表示经 Bonferroni 校正后显著异于零。)
第一,没有一种方法处处领先。 Transformer 在跨资产、金属、农产品领先,LSTM 在股指领先,等权在能源领先,时间序列动量在利率和外汇领先。学习型策略在简单规则最弱的地方增益最大,比如农产品的 0.34 是最好纯多头规则的两倍多;在单边上涨明显的股指和能源上,它们没有胜过等权。
第二,排名只是点估计。 校正后显著异于零的,只有股指上的四个策略(t 约为 3);跨资产 Transformer 的 t 约为 2,过了未校正的 5% 水平,过不了 Bonferroni。自助法给出的"Transformer 胜过对手"的概率:对风险平价 0.99,对时间序列动量 0.68,对等权只有 0.59。作者的结论写得很清楚:"The cross-asset transformer therefore matches, rather than significantly beats, 1/N."
第三,换手决定净表现。 Transformer 每日单边换手约 0.02,LSTM 在 0.07 到 0.17 之间。跨资产组合的净夏普随成本变化:
毛收益上两个网络几乎一样,扣费之后分道扬镳。给 LSTM 加换手惩罚能减少交易,但净表现的提升不足以改变排序;对本来换手就低的 Transformer,惩罚反而约束过度。
第四,股指上的"技能"主要是市场暴露。 用各范围的等权组合做基准回归:Transformer 在股指上的 α 只有 0.8%(不显著),β 为 0.63;LSTM 的 α 为 3.9%(显著),β 为 0.50。其余范围都没有显著的 α,直接的择时能力检验也都不显著。作者的解读是:Transformer 学到的,更接近一个"风险效率较高的方向性暴露",而不是市场中性的择时能力。
第五,增加复杂度没有帮助,除了多种子平均。 单个随机种子训练出的跨资产 Transformer,夏普比率波动很大,与零难以区分;三个种子平均之后才稳定到能与简单规则竞争。混合专家结构、更多特征、按大类单独调参、LSTM 与 Transformer 集成,都没有带来实质改进。
四、一项补充:打平需要多少年才能分出胜负
先做自洽检查。
- 显著性标记
:用 t ≈ 夏普 × √年数,样本外 14 年,Bonferroni 门槛 2.69 对应夏普约 0.72。表中带星号的恰好是夏普高于 0.72 的四个(0.78、0.79、0.87、0.80),跨资产 Transformer 0.55 × √14 = 2.06,与文中"t 约为 2"一致 - 扣费后的夏普
:净夏普 ≈ 毛夏普 − 成本 × 日换手 × 252 ÷ 波动率。LSTM(波动率 5%、换手 0.17)在 1、2、5、10 个基点下算得 0.41、0.33、0.07、−0.36,Transformer(波动率 8%、换手 0.02)算得 0.54、0.54、0.52、0.49,与表中基本一致 - 一处有待说明的出入
:按"α + β × 基准收益"复算股指上的收益,LSTM 应为 3.9% + 0.50 × 15% ≈ 11.4%,表中为 9%;Transformer 应为 0.8% + 0.63 × 15% ≈ 10.3%,表中为 12%。两张表的样本区间或收益定义可能不同,该文没有说明
盈亏平衡成本。 第一季用过的工具:盈亏平衡成本 = 年化收益 ÷ 年化换手。
LSTM:年化收益约 2.5%,年换手约 43 倍,盈亏平衡成本约 6 个基点——与表中 5 个基点时夏普只剩 0.06 吻合 Transformer:年化收益约 4.4%,年换手约 5 倍,盈亏平衡成本约 87 个基点 Transformer 相对等权(等权的目标权重不变,换手记为零):成本高于约 5 个基点,就会落到等权之下,与表中 5 个基点时两者同为 0.52 一致
两个网络的毛夏普相差 0.05,盈亏平衡成本却相差约 15 倍。对于毛收益接近的两个策略,换手才是真正的分水岭。
"打平"需要多少年才能分出胜负。 自助法给出 Transformer 胜过等权的概率是 0.59,在正态近似下相当于 z ≈ 0.23;夏普差 0.03,于是 14 年样本下夏普差的标准误约为 0.13。按两个夏普比率之差的标准误公式反推,两者的收益相关系数大约在 0.9 左右——Transformer 学到的,与等权相当接近。
由此可以算:要以 80% 的把握、在 5% 水平下确认 0.03 的夏普差,需要约 两千年 的数据。即使相关系数高达 0.9、夏普差的噪声已经被大幅抵消,这个差距仍然远在可检验的范围之外。这与上两期的结论一致:新模型与强基准之间的小差距,靠延长样本几乎不可能分辨。
0.59 与"排名第一"。 在跨资产范围里,Transformer 的夏普确实最高;但 0.59 的概率意味着,换一段同样长的历史,等权排第一的可能性并不小。作者把排名称为"点估计而非已确立的差异",这一自我定位是准确的。
五、值得进一步区分的观察
夏普目标在上涨市场里有一个"捷径"。 作者自己指出:在样本期整体上涨的市场里,模型只要学会一个稳定的、小于 1 的多头暴露,就能提升夏普目标,而这不需要任何择时能力。股指上 Transformer 的 β 为 0.63、α 不显著、夏普 0.80 与等权的 0.78 几乎相同——夏普比率不随杠杆变化,0.63 倍的等权组合,夏普就是等权的夏普。端到端优化最先学会的,往往是"持有那个在涨的资产"。
样本外期参与了设计选择。 工程特征之所以被舍弃,是因为在初步的滚动检验里"没有稳定的样本外增益";多种子平均、混合专家、集成等变体,也都是在样本外表现上比较后取舍的。舍弃的方向是更简单的模型,过拟合风险因此较低,但严格说来,报告的样本外期并不是完全没被看过的留出样本。训练参数主要在 LSTM 上调,再直接用于 Transformer,作者也承认这可能影响归因。
两个网络的毛收益相近,风险来源却不同。 LSTM 的股指收益有显著的 α,Transformer 的主要是 β;Transformer 在金属和能源上的 α 估计值更大。作者由此提出:风险、换手和归因,要在实际使用的那个模型上测量,不能从一个架构推到另一个。
等权的零换手是一个简化。 该文把等权这类常数权重规则的换手记为零,而实际维持固定权重需要随价格变化再平衡,所有策略也都需要换月。这对等权略有利,但幅度很小,不改变结论。
六、作者已声明的边界
把这项研究定位为"保守的检验":只有日频、只有流动性最好的品种,单个大类只有两到四个品种,模型可利用的截面很窄 结果对随机种子敏感,单个估计应视为提示性的而非定论 训练参数主要在 LSTM 上调,针对 Transformer 单独调参可能改变归因 只比较了两种架构 工程特征的充分利用留待后续 各范围的排名是点估计,不是已确立的差异;夏普差的自助法检验未做多重校正 后续方向:更高频率的数据、更多品种和大类、合约与大类的嵌入表示
作者在结论里提出的两条经验值得原样记下:学习型策略应当与从业者实际会用的规则比较,而不只是与等权比较;风险、换手和归因要在实际使用的模型上测量。
七、评价
值得读。
样本外检验标"警告":样本外期参与了特征和变体的取舍。多重检验标"警告":七个范围的"夏普异于零"做了校正,但尝试过的模型变体没有计入。数据可得性标"警告":商业数据,付费可得。
给"值得读",是因为它的结论措辞很克制,"打平而非胜出""主要是市场暴露"都由作者自己说出;再补上盈亏平衡成本和检验力的换算,可以更清楚地看到这些结论的分量。
八、可以带走的
第一,对照组选从业者真正会用的规则。 等权、风险平价、时间序列动量各有擅长的市场,只和其中一个比,结论会偏。
第二,先看换手,再看毛夏普。 毛夏普相差 0.05 的两个网络,盈亏平衡成本相差 15 倍。国内期货的单边成本(手续费加滑点)因品种而异,很多品种高于该文假设的 2 个基点,换手的影响只会更大。
第三,做一次 α/β 分解。 夏普比率不随杠杆变化,一个学会了"小仓位持有上涨资产"的模型,夏普可以和等权一模一样。
第四,多个随机种子平均。 这是该文唯一稳定有效的增强手段,成本最低。
回头看这一章。 三篇文章、三种新模型,结论惊人地一致:在严格的对照下,新模型与强基准之间要么没有差距,要么差距小到需要几十年、几千年的数据才能确认。岭回归、Log-HAR、等权,这些老基准都很强。真正拉开差距的,是评估方式:只换一个部件的对照、预算对等、实时可构建的股票池、逐资产的损失比、校准与信息的分解、换手与成本、α/β 分解,以及事先算好的检验力。
下一章换一个问题:信号要过的几道关。 第一篇把散户最常用的五类技术信号——趋势、振荡指标、K 线形态、成交量、日历效应——放进三道事先声明的关口:多重检验校正后的统计优势、扣费后的经济价值、杠杆下的生存。四类被判定为"否定",趋势和一个动量对照"无法判定",没有一类通过。更值得看的,是它怎样区分"被否定"和"证据不足"。
评分
红旗自查
一句话结论:值得读
参考文献
[1] Austin Pollok, Kevin Robik (2026). End-to-End Parametric Portfolio Policies for Cross-Asset Futures Timing: When Do AI Models Beat Simple Rules?. arXiv. https://arxiv.org/abs/2607.00475
仅为论文解读,不构成任何投资建议。