ARTICLE · 1184111
AI4Data:复杂逻辑多分支大文本SQL对LLM的考验
——从"能写SQL"到"会做数据工程"的七问七答
摘要:当一条SQL长达数千行、嵌套十余层、横跨三个以上数据源并携带数十个业务分支时,大语言模型"一把梭"式的端到端生成便会失效。本文围绕七个工程问题展开:小口径原则、分域拆解方法论、传统数据工程存续、方言精通、厂商定制小模型、生态责任分工与LLM运维DBA。核心结论:复杂SQL的生成不是"上下文更长"的问题,而是"分层解耦+领域知识+治理护栏"的系统工程问题。
目录
一、小口径原则:先把"一个指标"做对,再谈大SQL
二、step-by-step:六大理论域的"适配—拆解—融合"
三、传统数据工程不应抛弃:LLM的地基
四、方言精通矩阵:什么场景、什么体量、用什么
五、厂商该不该做"定制化、小参数"的数据库LLM?
六、模型、Agent、Tools:谁做最合适?
七、LLM做数据库运维(DBA)是好主意吗?
一、小口径原则:先把"一个指标"做对,再谈大SQL
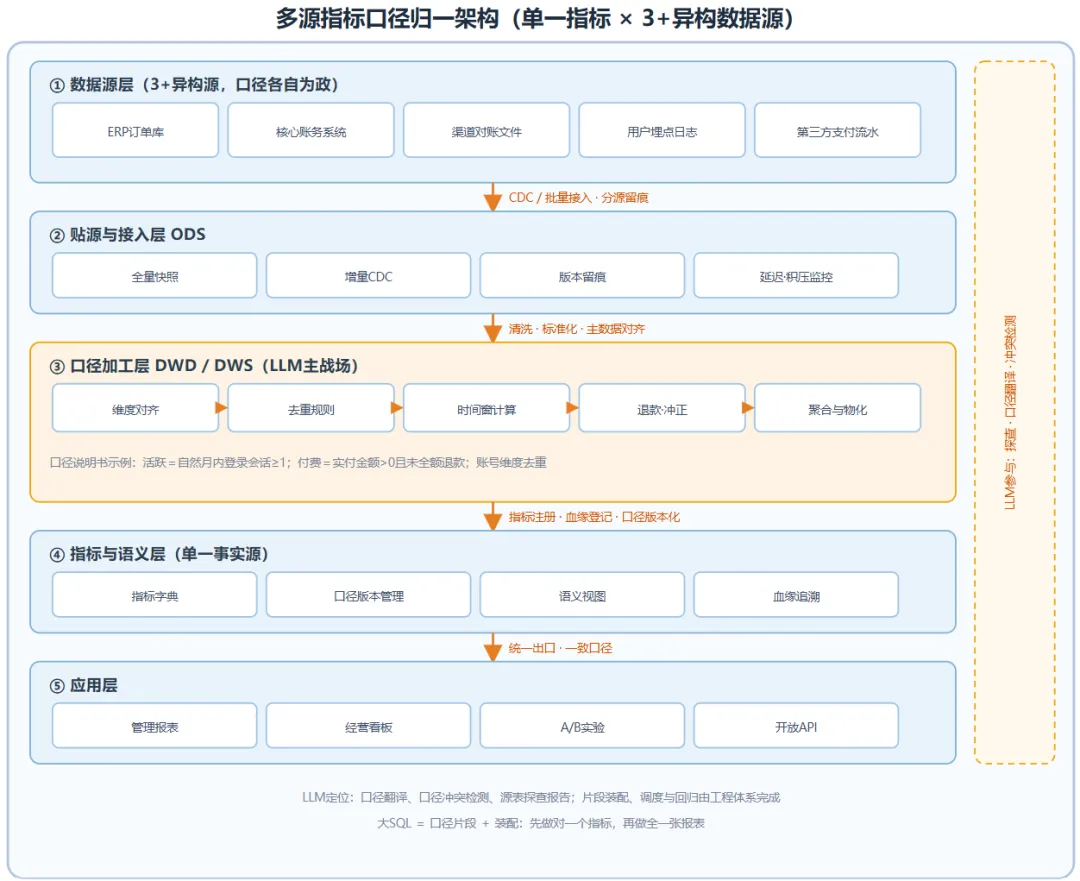
LLM擅长解决的是小口径问题——例如把一个指标的加工口径讲清楚、算准确,而不是一次性吞下整座数仓。最小任务单元应当是"一个指标的一条口径链路",而非"一个业务需求"。以"月度活跃付费用户数"为例:活跃如何定义(登录还是交易)?付费看实付还是应付、退款冲正扣不扣?时间窗是自然月还是滚动30天?去重维度是账号、设备还是实名?四问之后真正落库时,它至少来自三个及以上数据源——订单库、核心账务、渠道对账文件、埋点日志、第三方支付流水;join键怎么选、各源延迟不一致怎么办、重跑幂等如何保证、质量规则落在哪一层,都是"小口径"背后的真问题。
工程做法是口径归一:以指标字典为单一事实源,向下对齐主数据与维表,向上经语义层统一出口(图1)。大SQL应拆成"口径片段+装配"两层:LLM负责把自然语言口径翻译成可校验的SQL片段,并自动生成口径冲突检测报告;片段的装配、调度与回归交给工程体系。一个指标一条链路,先做对,再做全。
二、step-by-step:六大理论域的"适配—拆解—融合"
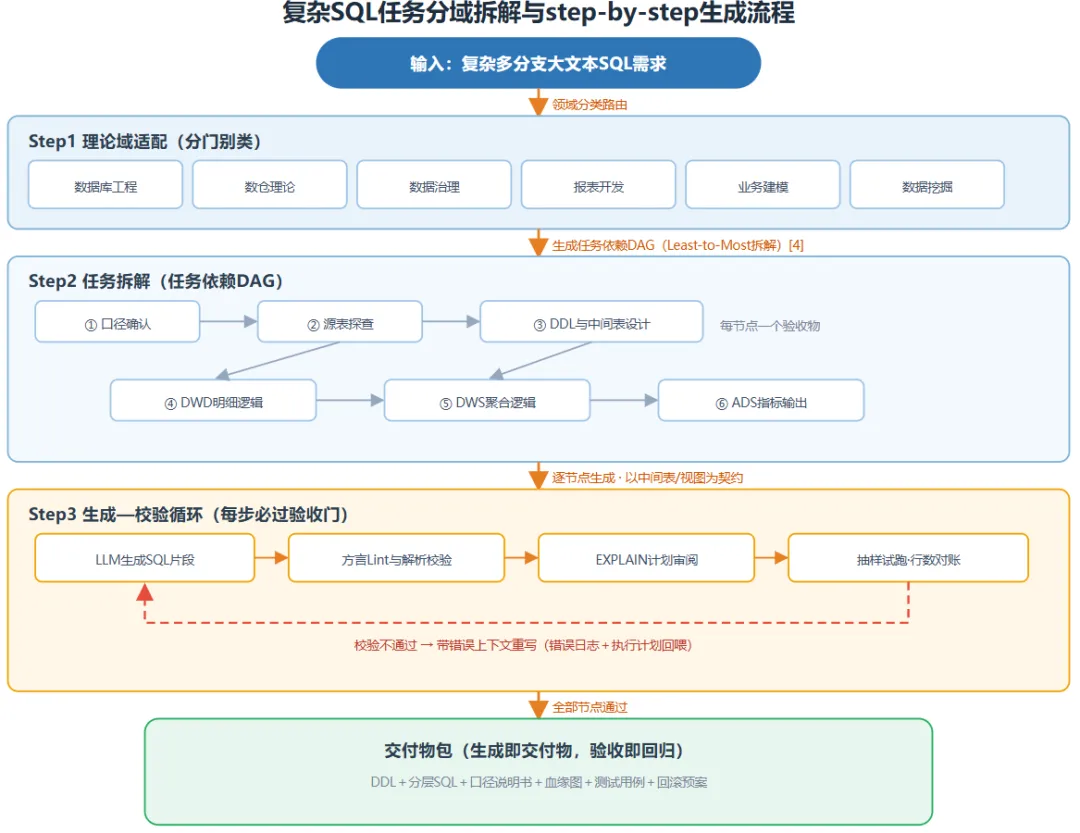
把复杂任务一次性丢给LLM端到端生成,等价于把整条流水线交给一个没有图纸的实习生。正确姿势是分门别类:先判定任务属于哪些学科域,再按域适配方法论,最后融合成step-by-step的执行计划。
2.1 六大理论域:各自的"宪法"
数据库工程关心执行计划与索引;数仓理论关心分层与建模——无论是Inmon的3NF企业仓库[6]还是Kimball的维度总线[5];数据治理关心元数据、质量与血缘[7][8];报表开发关心批次、一致性与财务复核;业务建模关心指标体系与领域边界;数据挖掘关心特征、采样与评估。每个域有自己的不变量,LLM必须先"入乡随俗",再动笔写SQL。
2.2 拆解—验收—回喂:step-by-step的闭环
方法上可依托思维链与"由易到难"的分步提示[3][4]:第一步产出任务依赖DAG,第二步逐节点生成,节点之间以中间表/临时视图为契约,第三步每一步都有验收物——DDL审阅、口径说明书、源表探查报告、分层SQL、集成测试用例、回滚预案(图2)。生成即交付物,验收即回归:校验不通过时,把报错与执行计划作为上下文回喂重写,而不是从头再来。Spider[1]与BIRD[2]两类基准的准确率落差也证明:纯端到端Text-to-SQL在真实脏库上会大幅失效,分步引入库结构探索与外部证据,才是涨分关键。
三、传统数据工程不应抛弃:LLM的地基
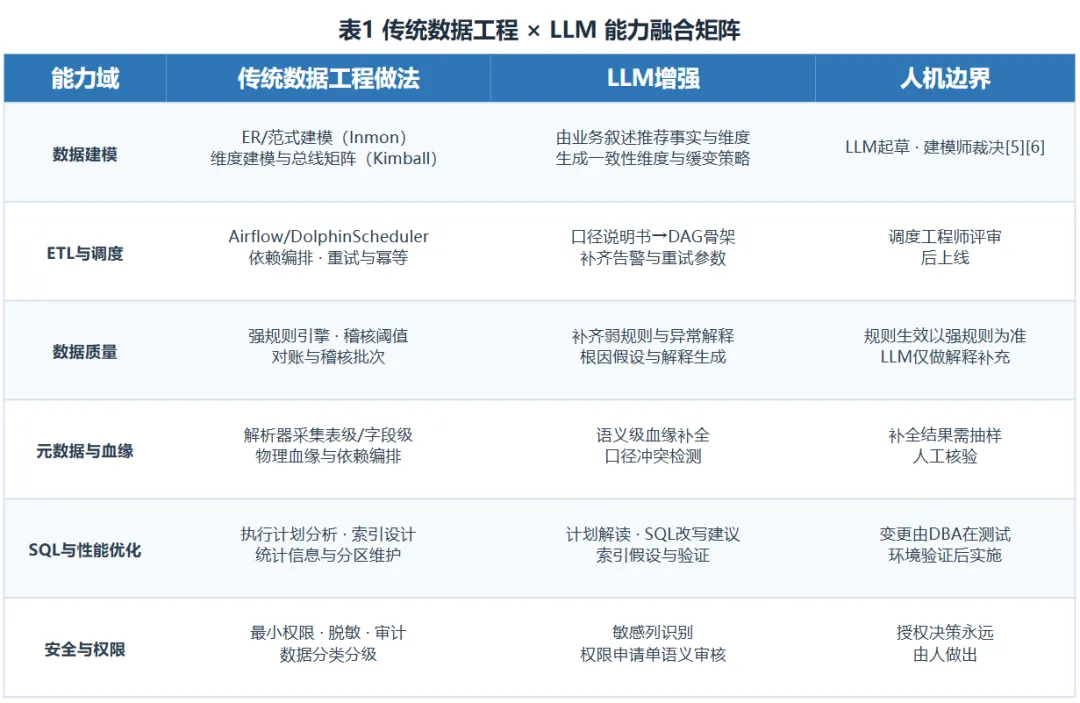
LLM是概率生成器,而数据工程是确定性纪律,二者不是替代关系。传统数据工程非但不能抛弃,反而是LLM发挥价值的地基:没有分层与建模,LLM生成的SQL只是漂浮的临时查询;没有治理框架,LLM就没有任何可供"投喂"的结构化语境。DAMA-DMBOK的十大知识域与DCMM成熟度模型[7][8],在LLM时代的正确打开方式是:把它们变成给模型的"语境包"与"护栏网"。融合矩阵与人机边界如表1所示:LLM起草,工程规范裁决;LLM解释,DBA拍板。
四、方言精通矩阵:什么场景、什么体量、用什么
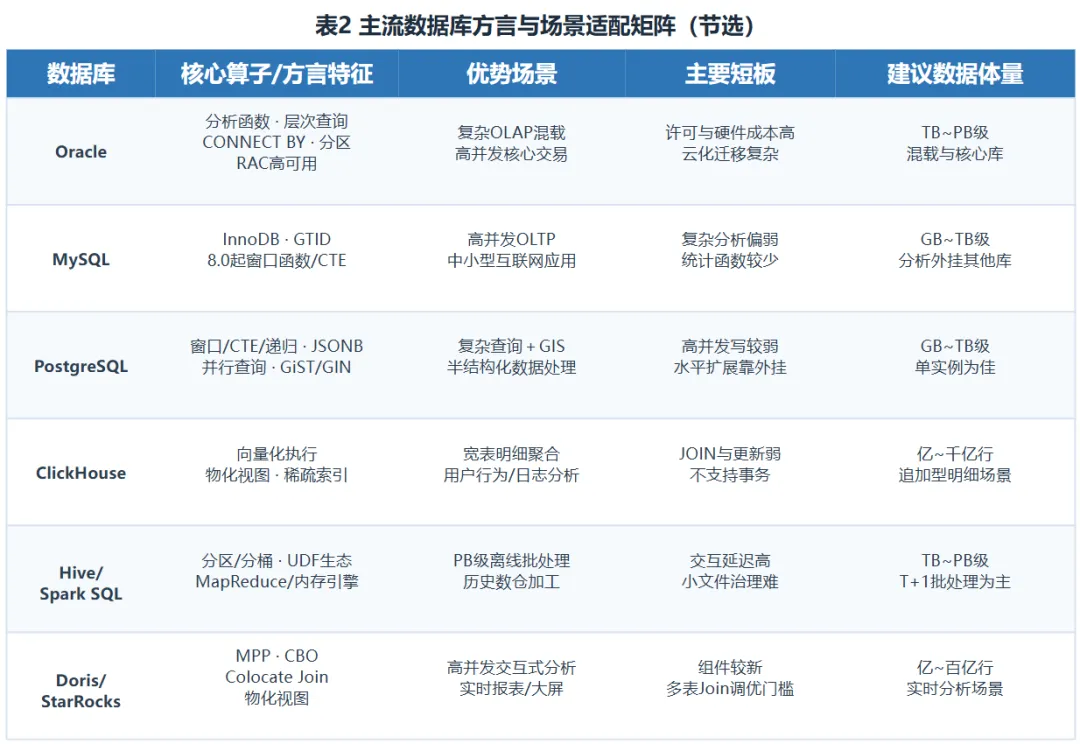
方言差异不是语法糖差异,而是执行模型、算子生态与数据体量适配的系统性差异。同为取TopN:Oracle可用分析函数与物化视图分层;MySQL 8.0之前没有窗口函数、要用变量模拟,8.0之后才能写ROW_NUMBER();ClickHouse干JOIN、更新是弱项,但向量化执行与预聚合物化视图让宽表明细聚合吞吐惊人;Hive/SparkSQL吃PB级离线批,却受困于小文件与启动延迟,做不了交互式查询;Doris/StarRocks的MPP与Colocate Join天然面向高并发交互式报表。节选矩阵见表2。
体量维度同样关键:百万行以下单机任意方言皆可;亿级以上要看分区、分桶、预聚合与MPP;千亿级日志场景基本只剩列存方案。LLM必须内化"四问"选型决策树:用什么、怎么用、什么时候用、多大体量用——这要求它掌握算子代价表,而不是背几条语法。落地方式是"方言知识库+算子代价表+迁移规则集"三件套,例如Oracle迁移场景的ROWNUM→LIMIT、DECODE→CASE、CONNECT BY→递归CTE映射。
五、厂商该不该做"定制化、小参数"的数据库LLM?
应该做,但要克制地做。小参数模型不是"更小的大模型",而应是"领域特化+工具外挂"的组合拳:把模型做小,把工具做厚。收益清晰:延迟低、成本低、可私有化、幻觉可控,且能与内核特性(系统视图、优化器行为、诊断SOP)深度对齐——这是通用模型短期做不到的。
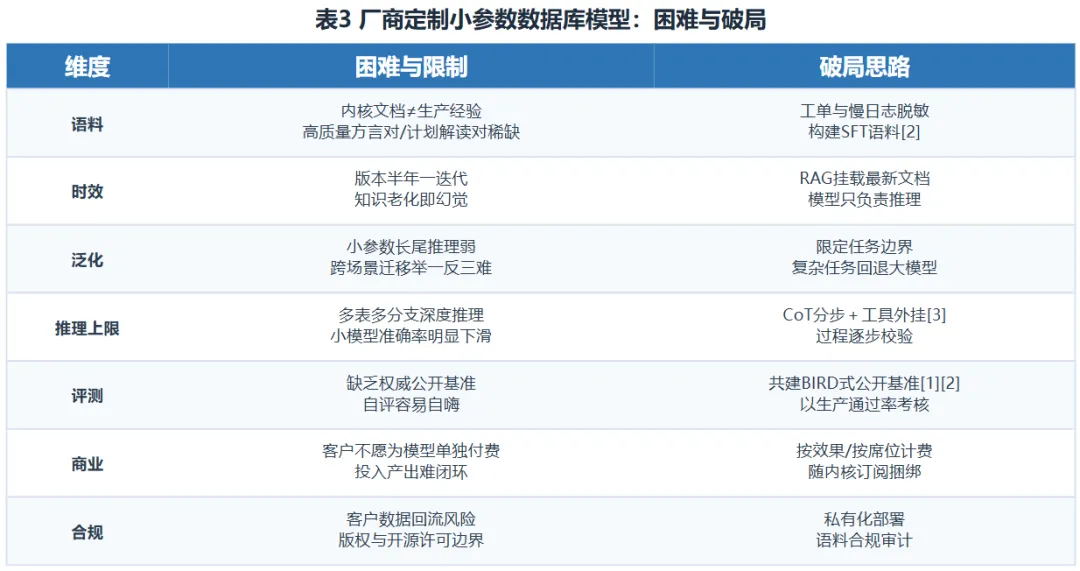
但困难同样结构化(表3):其一,语料——内核文档不等于生产经验,高质量"方言对/计划解读对"稀缺;其二,时效——版本半年一迭代,知识老化即幻觉;其三,泛化——小参数模型在长尾复杂多表推理上准确率下滑明显;其四,评测——缺乏权威公开基准,自评容易自嗨,应参考Spider/BIRD的共建思路[1][2];其五,商业——客户不愿为"会说SQL的模型"单独付费,更愿为效果付费;其六,合规——客户数据回流与许可边界。现实路径:通用基座+RAG挂载最新官方文档与生产样本+少量高质量SFT+工具调用;复杂任务仍回退大模型。
六、模型、Agent、Tools:谁做最合适?
判别准则:知识越"内核"越归厂商,知识越"私有"越归企业,知识越"公共"越归社区。厂商手握内核知识与系统视图,适合做方言小模型、官方MCP Server参考实现与诊断SOP知识库;企业内部数据团队独占私有口径、权限体系与调度拓扑,适合做Agent编排与私有知识注入;开源社区与学术界适合做公共基准与框架——Spider/BIRD[1][2]、DB-GPT[11]、D-Bot[9]已经趟出路线;MCP这类协议层[10]则应由生态共建:厂商定协议、社区做生态、企业做实例(表4)。
要警惕两个极端:一是厂商什么都自己做,结果私有场景做不深;二是企业什么都自己造,把Agent编排做成无人维护的内部轮子。分工的本质是:让最接近知识的人维护知识,让最接近场景的人编排场景。
七、LLM做数据库运维(DBA)是好主意吗?
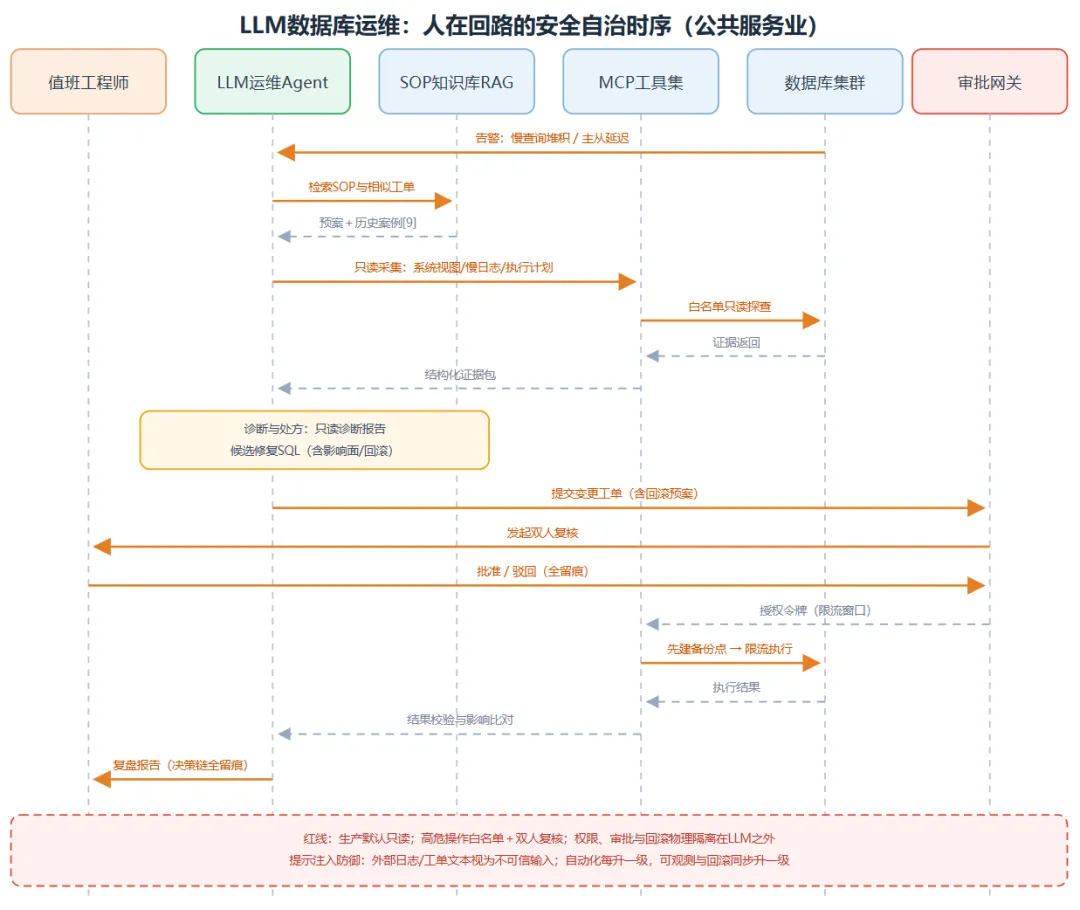
方向正确,但"自治程度"必须分行业分级。公共服务行业(金融、电信、能源)的LLM运维必须"人在回路",增值服务领域可以做到"人监督下自治"。D-Bot[9]与DB-GPT[11]已验证"感知—诊断—处方"链路的技术可行性,剩下的核心是安全与合规的工程化(图3)。
7.1 公共服务业:人在回路是底线
金融、电信、能源必须回答六个问题:合规底线(等保与行业监管对变更、审计的硬性要求);审计留痕(每一次诊断与执行的决策链可回放);双人复核(生产变更必须人工批准);默认只读(Agent对生产库默认只读探查,高危操作白名单+限流窗口+备份点);可解释性(LLM输出必须引用证据与SOP条款);提示注入防御(错误日志与工单文本可能携带恶意指令,应视为不可信输入[12])。一句话:LLM可以建议一切,但不能直接碰生产——权限、审批与回滚必须物理隔离在LLM之外。
7.2 增值服务:人监督下的自治
SaaS与互联网业务系统追求的是MTTR:可以允许灰度环境自动修复、A/B验证、自动扩容建议,但仍需金丝雀发布、环境隔离与速率限制。两者的共同红线是:自动化程度每提高一级,可观测性与回滚能力必须同步提高一级。
结语
复杂逻辑、多分支、大文本SQL对LLM的考验,本质是工程化能力的考验。以指标口径为最小任务单元,以六大理论域做分门别类拆解,以传统数据工程为地基,以方言决策树做选型,以生态分工建工具链,以人在回路守安全——做到这些,LLM才能从"会写SQL"进化为"会做数据工程"。
参考文献
Yu T, Zhang R, Yang K, et al. Spider: A Large-Scale Human-Labeled Dataset for Complex and Cross-Domain Semantic Parsing and Text-to-SQL Task[C]//EMNLP 2018. https://arxiv.org/abs/1809.08887 Li J, Yuan Y, Zhang G, et al. Can LLM Already Serve as A Database Interface? A BIg Bench for Large-Scale Database Grounded Text-to-SQLs (BIRD)[C]//NeurIPS 2023 Datasets and Benchmarks Track. https://arxiv.org/abs/2305.03111 Wei J, Wang X, Schuurmans D, et al. Chain-of-Thought Prompting Elicits Reasoning in Large Language Models[C]//NeurIPS 2022. https://arxiv.org/abs/2201.11903 Zhou D, Schärli N, Hou L, et al. Least-to-Most Prompting Enables Complex Reasoning in Large Language Models[C]//ICLR 2023. https://arxiv.org/abs/2205.10625 Kimball R, Ross M. The Data Warehouse Toolkit: The Definitive Guide to Dimensional Modeling[M]. 3rd ed. Indianapolis: Wiley, 2013. Inmon W H. Building the Data Warehouse[M]. 4th ed. Indianapolis: Wiley, 2005. DAMA International. DAMA-DMBOK: Data Management Body of Knowledge[M]. 2nd ed. Basking Ridge: Technics Publications, 2017. 全国信息技术标准化技术委员会. GB/T 36073-2018 数据管理能力成熟度评估模型(DCMM)[S]. 北京: 中国标准出版社, 2018. https://openstd.samr.gov.cn Zhou C, Liu P, Xu P, et al. D-Bot: A Database Troubleshooting System based on Large Language Models[J]. Proceedings of the VLDB Endowment, 2024. https://arxiv.org/abs/2312.01454 Anthropic. Model Context Protocol (MCP) Specification[EB/OL]. 2024. https://modelcontextprotocol.io eosphoros-ai. DB-GPT: AI Native Data App Development Framework with AWEL and Agentic Workflow[EB/OL]. 2023. https://github.com/eosphoros-ai/DB-GPT Yao S, Zhao J, Yu D, et al. ReAct: Synergizing Reasoning and Acting in Language Models[C]//ICLR 2023. https://arxiv.org/abs/2210.03629