ARTICLE · 1192658
OpenAI有反转?证明N-S方程千禧年问题的自然语言版本和Lean版本存在不一致
企业介绍:四维菁仿——在科学与生产实践之间架起桥梁
关联阅读:数学菲尔兹奖得主集体“吹哨”!张朝阳老师提醒:别只看AI答题,创新只能靠人们自己!
概述
《新科学家》在10月8日发表了一篇文章,标题是《OpenAI mistranslated mathematics into code for its Navier-Stokes proof》,意思是:OpenAI在证明N-S方程千禧年问题时,将自然语言翻译成lean语言的过程中存在错误。原文链接如下:
https://www.newscientist.com/article/2592824-openai-mistranslated-mathematics-into-code-for-its-navier-stokes-proof/
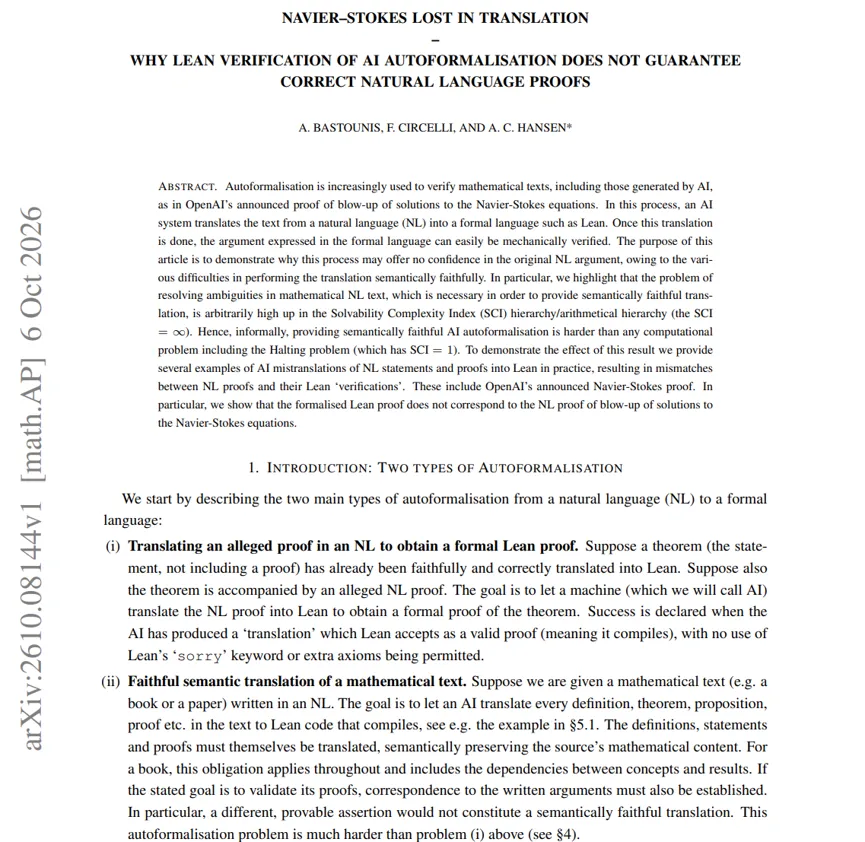
OpenAI在发布其纳维-斯托克斯方程证明时,提供了两个版本:一份是供人类阅读的自然语言(Natural Language, NL)版本,另一份是用于计算机验证的Lean代码版本(Lean代码的作用是让计算机能够机械地检查证明中每一步逻辑的有效性)。然而,剑桥大学数学家Anders Hansen、Fabian Circelli和Alexander Bastounis组成的研究团队发现,这两个版本的内容并不完全对应。相关研究的发表信息如下:
论文标题:Navier-Stokes lost in translation: Why Lean verification of AI autoformalisation does not guarantee correct natural language proofs 作者:Alexander Bastounis(伦敦国王学院)、Fabian Circelli(剑桥大学)、Anders C. Hansen(剑桥大学) arXiv编号:arXiv:2610.08144 提交日期:2026年10月6日
📋关键细节与具体问题
研究人员在论文《Navier-Stokes lost in translation》中,详细列举了Lean代码与自然语言证明不一致的具体实例。包括证明中的 Lemma 8.6 :
在自然语言证明中,某个值被要求低于 m + 4。 在 Lean 代码中,对应的值被要求低于 m + 5。
m + 5是一个更宽松(更弱)的条件。文章用解方程类比:x = 3 是精确解,而 x < 4 和 x < 5 虽然都成立,但 x < 5 允许更多可能性,因此数学上更弱。AI 为了让代码能编译通过,选择了这个更弱的版本。
⚠️问题根源与影响
这项研究并非旨在断定OpenAI的证明本身是错的。相反,它指出了AI自动形式化(Autoformalisation)过程中的一个根本性缺陷。
根源:翻译过程可能失真。AI系统在将自然语言翻译成Lean代码时,可能会遇到无法编译的段落。为了解决这个问题,AI会尝试寻找一个能通过编译的变通方案,即使这个方案已经偏离了原始证明的意图。研究指出,要语义上忠实地进行这种翻译,其计算复杂度极高,甚至超过了停机问题,这意味着AI目前无法可靠地完成这项任务。
影响:形式化验证的可靠性受到质疑。研究团队的核心观点是,Lean代码的“编译成功”不能作为自然语言证明正确的保证。论文作者之一Fabian Circelli指出,人们曾希望形式化验证能部分替代人工同行评审,但这项研究表明,这种AI自动形式化无法承担这一角色。剑桥大学的Anders Hansen也强调:AI生成的大量证明最终仍需人类来阅读,这给数学家带来了“巨大的额外负担”。
PS:四维菁仿在与一些数学研究者的交流中也获取到了类似的反馈:现在AI生成的数学论文太多了,看都看不过来,而且其中不乏粗制滥造的成果。其实广大网友在网上看到的往往是好的成果,那么其它大量的看不到的成果的质量如何呢?这里关键还是在“合理利用AI”上。
📌 OpenAI的回应
OpenAI方面已经确认了这些不一致的存在,但同时表示,这并不意味着两个版本的证明中有一个是无效的。
 值得深思的地方
(1)AI 能生成证明,但还是需要数学家来做最终裁决
人类可读的证明仍是数学共同体理解和接受的关键。 AI 可以产出被机器验证的代码,却未必能产出被数学家信任的论文。
(2)形式化验证的可信度被翻译环节侵蚀
Lean 本应消除歧义、提供机械保证,但 AI 自动形式化在“自然语言 → Lean”的翻译中,可能悄悄弱化条件、改变逻辑。于是出现一个悖论:机器验证通过 ≠ 数学证明正确,AI 引入了一个新的不透明层——翻译层。信任不再终结于 Lean,而必须回溯到自然语言。
(3)自然语言与形式语言的鸿沟,暴露了 AI 的理解局限
AI 在句法和形式操作上强大,但在语义理解和数学意图上仍然薄弱。AI获取信息的能力和计算能力是强大的,但AI是否能真正理解数学。
(4)产业节奏与学术规范的冲突
OpenAI 追求快速发布、抢占头条,而数学界要求同行评审、优先权承认、数据来源透明。报道中提到的“西班牙方案”争议、Buckmaster 的指控都显示:AI 公司的高调宣传与学术界的慢速验证、credit(学术上的功劳、贡献认定、优先权、署名权和荣誉)分配机制发生摩擦。
(5)合作与竞争并存
数学家也在用 LLM 推进研究,但担心被 AI 公司“抢跑”或训练数据“吸收”。AI 既是研究助手,也是潜在竞争者。这种关系不是简单取代,而是权力和 credit 的重新分配:谁提出问题、谁生成证明、谁验证、谁署名?
联系人:周先生
邮箱:siweijingfang_zf@126.com
微信号:xiaomengzf
微信二维码: