ARTICLE · 1208661
【统计分析软件SPSS】195、时间序列分析——应用时间因果模型(使用更新的数据进行预测)
本系列文章(基于SPSS 31版本)配套数据可通过百度网盘获取:
链接:https://pan.baidu.com/s/1AGizNngKrzAVapWtNcc-VA?pwd=mnsj提取码:mnsj
https://www.mizhushare.com/docs/
对于通过「时间因果建模」过程创建的模型,系统提供两种可用的应用程序。
时间因果模型预测:使用该过程,可以在不重新构建模型的情况下,对已更新数据的时间序列生成预测值。同时,还可以输出在「时间因果建模」过程中可用的各类结果。
时间因果模型情景分析:使用该过程,可以考察模型系统中某一特定时间序列取不同数值时,对与其存在因果关系的其他时间序列预测结果所产生的影响。
上述两个过程均需要模型系统文件,该文件可在「时间因果建模」过程中保存得到。
【统计分析软件SPSS】193、时间序列分析——创建时间因果模型(操作步骤)
本篇文章将介绍「时间因果模型预测」的相关内容。
时间因果模型预测:
时间因果模型预测,是指在已经建立好的时间因果模型系统基础上,当有更新或更近期的时间序列数据可用时,用户无需重新进行模型估计与结构识别,即可直接调用原有模型生成新的预测结果。在实际业务场景中,这一功能特别适用于需要定期更新预测的情形,例如宏观经济指标监测、销售与需求预测、能源负荷预测等。
通过这种方式,一方面可以避免重复建模带来的时间成本,提高分析效率;另一方面也能够保持模型结构与参数设定的一致性,使不同时间点的预测结果具有可比性。
在使用该过程时,需满足以下基本假设条件:
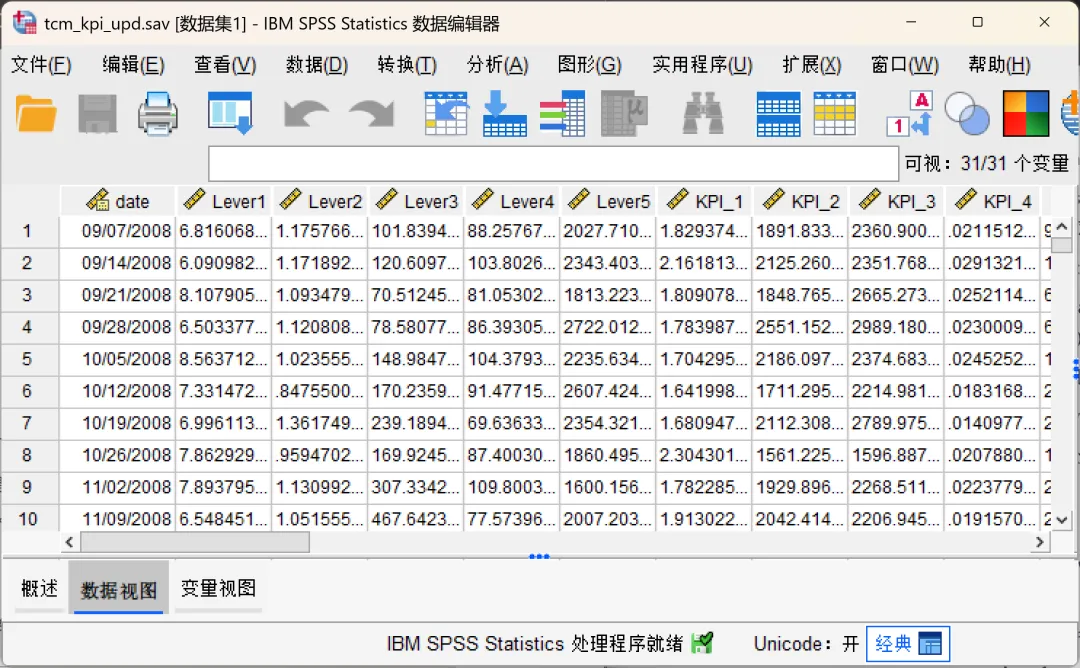
当前活动数据集的结构必须与建模时保持一致(包括基于列或多维数据的结构形式);若为多维数据,其维度字段及维度取值需与建模时一致;
模型将自动匹配并应用于活动数据集中与模型系统中同名的字段;
用于定义观测值的时间字段必须存在,且观测时间间隔与建模时相同;若使用了日期规范,活动数据集中也需采用相同的日期规范;
此外,时间间隔设置以及关于聚合方式、分布形式和缺失值处理的设置,均沿用建模阶段的配置。
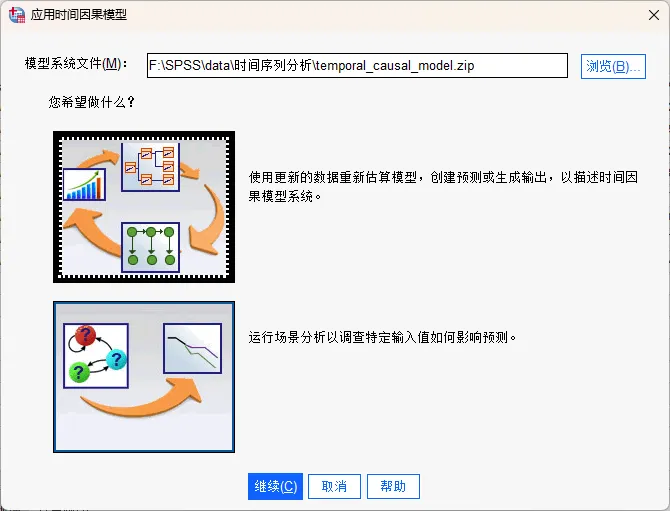
点击顶部菜单栏的【分析→时间序列预测→应用时间因果模型】,在打开的对话框中进行相应设置。
1)、对话框:
加载保存的时序因果模型系统文件;
选择「使用更新的数据重新估算模型,创建预测或生成输出,以描述时间因果模型系统」选项以使用更新的数据进行预测。
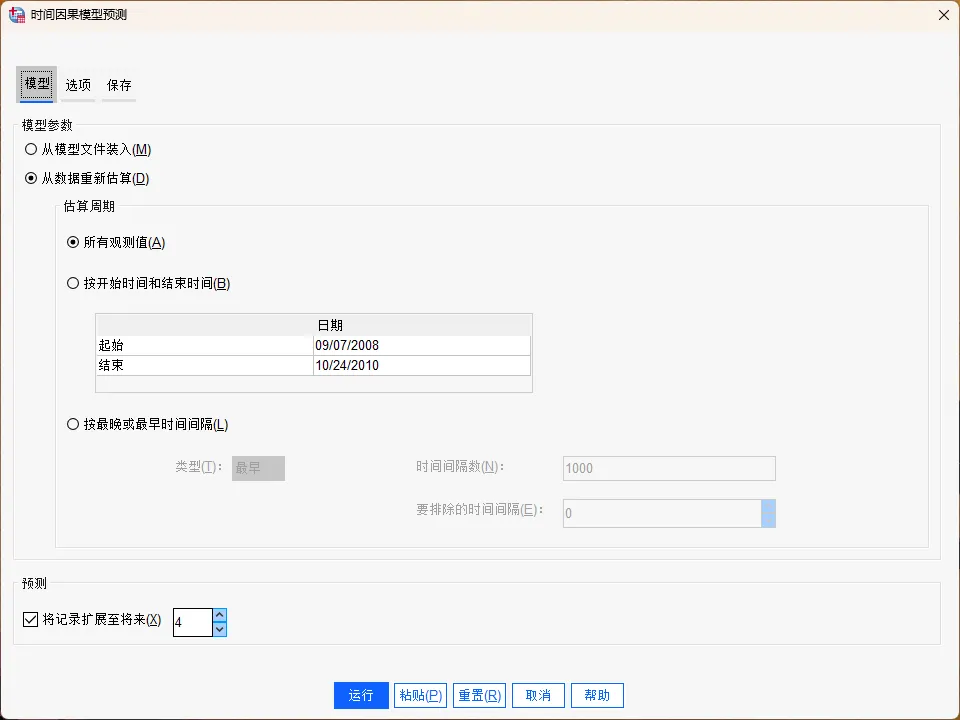
2)、模型选项卡:
指定模型参数以及预测周期。
从模型文件加载 | 使用模型系统文件中保存的模型参数,并结合活动数据集中的数据生成预测,而不重新估计模型参数。 输出中显示的拟合优度统计量以及用于选择最佳模型的相关统计量,均来自模型系统文件,因此这些统计量反映的是构建(或最后一次更新)模型时所使用的数据情况。 该选项适用于基于原始建模数据直接生成预测和输出结果的情形。 | |
从数据重新估计 | 基于活动数据集中的数据重新估计模型参数,但不会改变各目标模型中包含的输入变量结构。当获得超出原始估计期的新数据,并希望利用更新后的数据生成预测或其他输出时,选择该选项。 | |
全部观测值 | 将估计期设置为从所有序列中最早的观测时间开始,到最晚的观测时间结束。 | |
按开始和结束时间 | 手动指定估计期的开始时间和结束时间,可以只指定开始时间或只指定结束时间;若省略其中一项,则使用系统默认值。
| |
按最新或最早时间间隔 | 将估计期定义为从最早或最晚时间间隔起算的指定数量间隔范围,并可设置偏移量。此处的「时间间隔」指分析所采用的时间单位。例如,若观测值为月度数据而分析间隔为季度,选择「最新」且「间隔数」设为4,即表示最近4个季度。 此外,还可以选择排除指定数量的时间间隔隔。例如,设定为「最新24个间隔」且「排除数」为1,则估计期将包含从倒数第二个间隔往前推的24个间隔。 | |
用于指定在估计期结束之后继续向前预测的时间间隔数(以分析时间间隔为单位)。在进行预测时,系统会自动为非目标输入序列构建自回归模型,并利用这些模型在预测期内生成相应的输入序列值,从而获得目标变量在预测期内的预测结果。 |
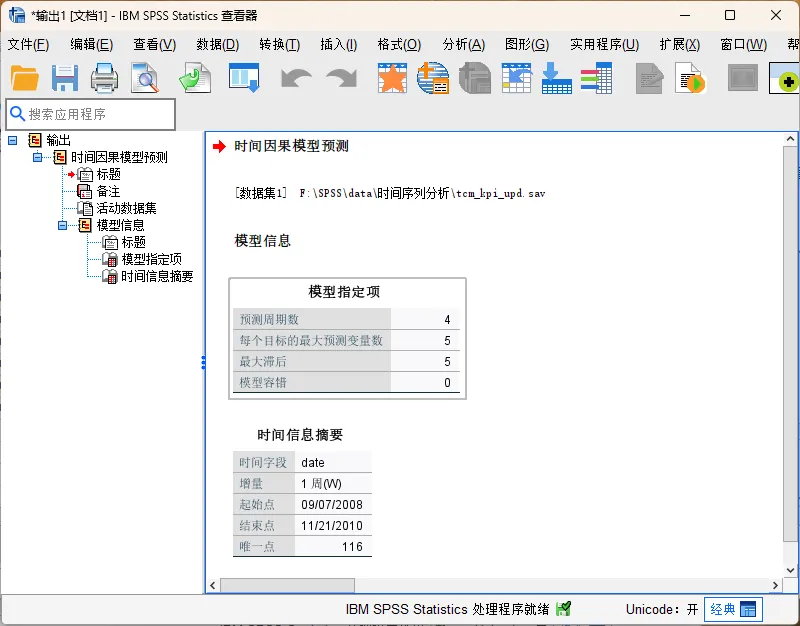
本次,勾选「从数据重新估算」选项,并选择「所有观测值」以确保估计期包含更新数据中的四周数据。
指定「将记录扩展至将来」的值为4,表示为估计期结束后的四周生成预测。
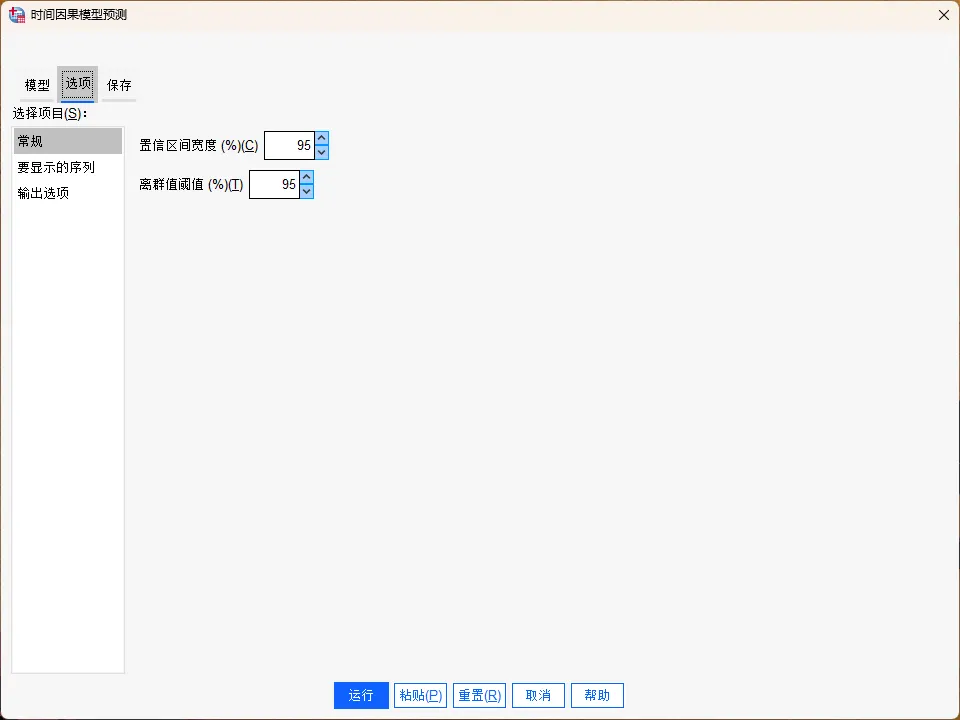
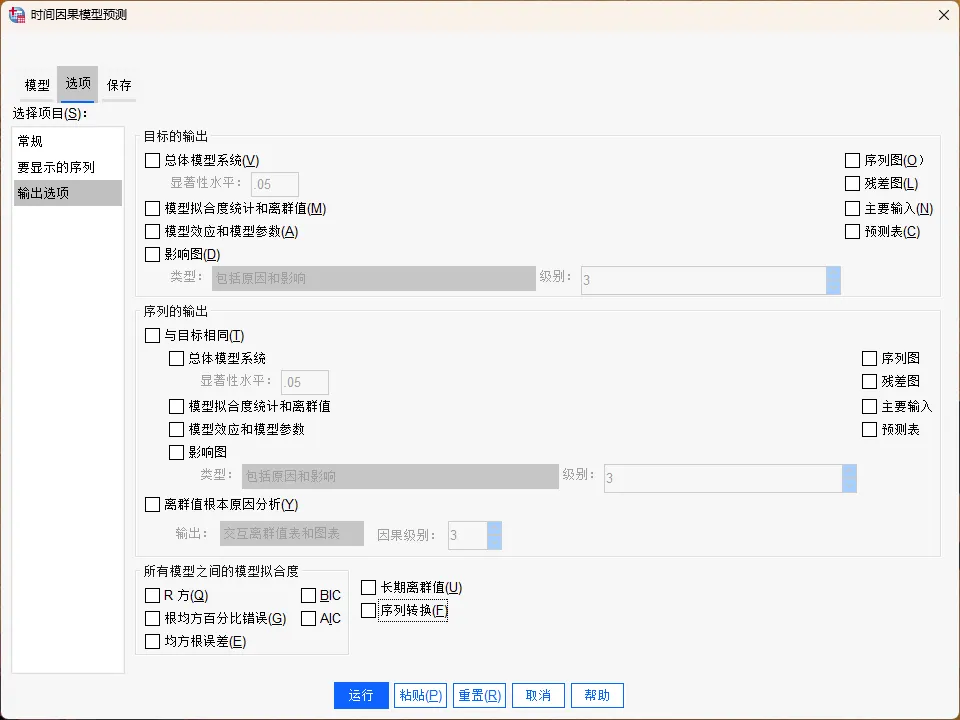
3)、选项选项卡:
指定输出的内容。
①、常规:
置信区间宽度 | 用于控制预测值和模型参数的置信区间,可设置任何小于100%的正值。默认值为95%。 |
离群值阈值 | 如果根据模型计算出某个观测值为离群值的概率超过了该阈值,则该观测值将被标记为离群值。可指定50-100范围内的值。 |
本次保持默认即可。
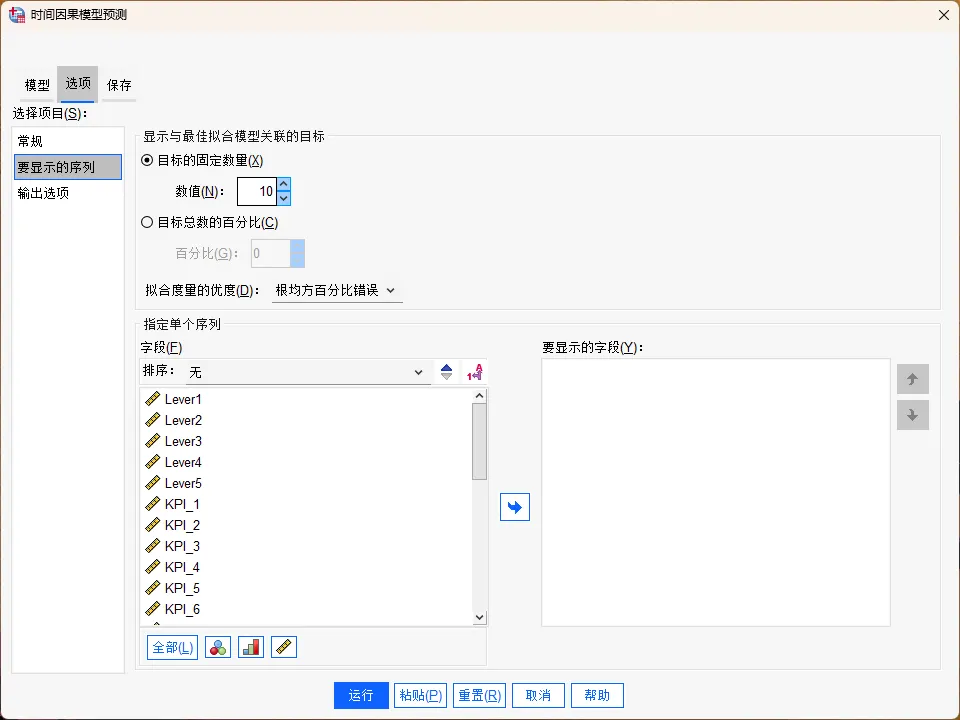
②、要显示的序列:
用于指定显示输出结果的序列(目标或输入)。指定序列的输出内容由「输出选项」设置决定。
显示与最佳拟合模型关联的目标 | 默认情况下,系统会显示与10个最佳拟合模型关联的目标的输出结果,这些模型是根据R方值确定的。 可以指定不同数量的最佳拟合模型,也可以指定最佳拟合模型的百分比,还可以选择拟合优度统计量指标。 |
指定单个序列 | 指定需要输出结果的单个序列。
|
本次保持默认即可。
③、输出选项:
用于指定输出内容。其中,「目标输出」组中的选项为「要显示的序列」设置中与最佳拟合模型关联的目标生成输出。「序列输出」组中的选项为「要显示的序列」设置中指定的单个序列生成输出。
各选项的含义与创建时间因果模型时一致,具体含义可查看以下文章:
【统计分析软件SPSS】193、时间序列分析——创建时间因果模型(操作步骤)
本次示例目标只是生成未来四周的预测值,因此取消选中「输出选项」中所有已选中的输出选项。
4)、保存选项卡:
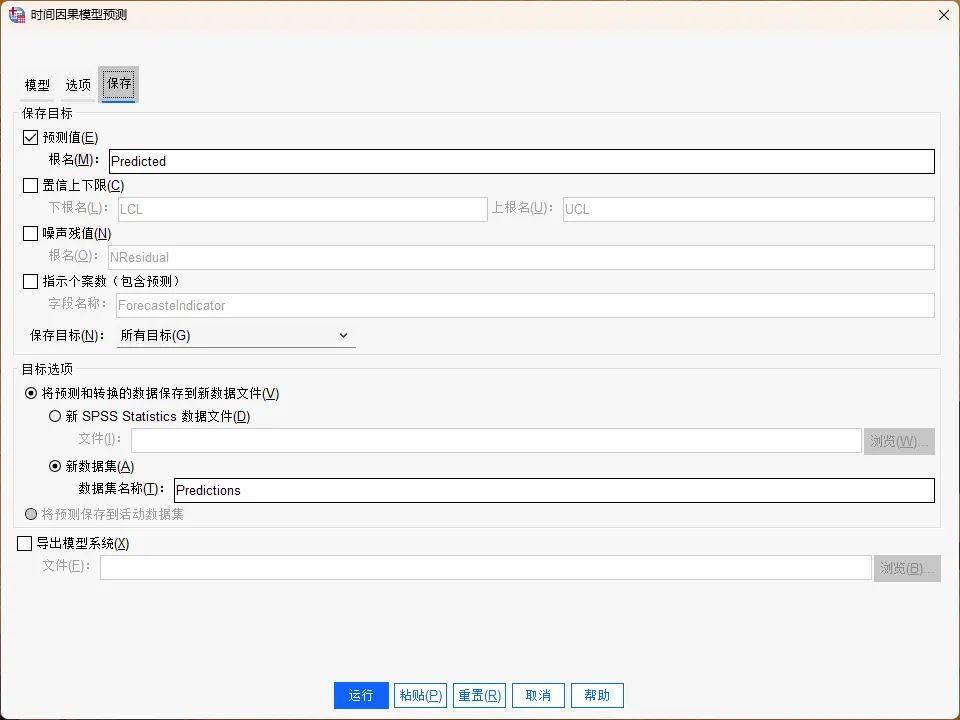
保存预测结果,并在重新估计模型参数时将更新后的模型系统导出到外部文件。
保存目标 | 设置要保存的输出项,每一个被选中的保存目标,系统都会生成一组对应的新变量,这些变量同时包含估计期间和预测期间的结果:
|
目标选项 | 可以将数据转换结果(如聚合处理、缺失值插补)以及在「保存目标」中指定生成的新变量,保存至数据文件或当前会话中的新数据集。保存后的日期/时间值将统一对齐到各时间间隔的起点(如,每月的第一天),并作为模型系统所使用的分析时间间隔。需要注意的是,只有当观测值由日期定义或记录顺序定义,且数据未进行聚合时,才允许将新生成的变量直接保存到活动数据集中。 |
导出模型系统 | 将模型系统保存到压缩文件存档(.zip文件)。该模型系统文件可由本过程重复使用,也可由「时间因果模型情景分析」过程用于运行情景分析。仅当选择「重新估计模型参数」时,该选项才可用。 |
本次勾选「预测值」,保留根名称的默认值;设置「保存目标」为「所有目标」。
选择将预测和转换的数据保存到新数据集中,并设置「Predictions」作为数据集名称。
设置完成,点击运行,系统执行时间因果模型预测。
输出结果一:模型信息表格
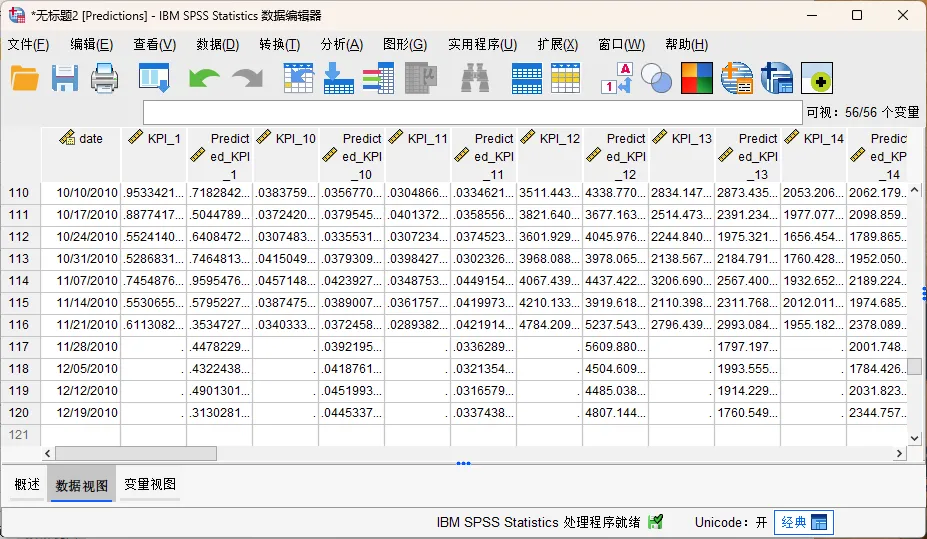
输出结果二:包含模型预测结果的新数据集
「Predictions」数据集是执行「时间因果模型预测」后生成的新数据集,该数据集在原有变量基础上,新增了与预测相关的新变量:
数据集中包含了25个新的预测变量,分别对应原始数据集中的25个目标变量(KPI_*)。变量名称由默认前缀(Predicted)加上关联目标的名称组成,用于表示相应目标变量在预测期内的预测值。
同时,该数据集还自动扩展了用于预测的额外个案。在本例中,模型生成了4个预测期的观测值,并为这些观测值自动创建了相应的日期字段,使得预测结果在时间轴上与原始数据保持连续。