ARTICLE · 1225777
有了 AI 质检员,整座工厂怎么重排
这一篇回答上一篇结尾留下的三个问题:有了这样一个质检员,整座工厂该怎么重新安排?每个角色负责什么?做 AI 的人,手上的活会怎么变?
先说结论:以前是一个大模型从头管到尾;现在可以把判断、分流、写作、把关拆开,交给不同的角色。人也不用每条都看,只需定好标准,再处理那一小部分拿不准的。
一、以前:一位工程师管全厂
以工厂接到的一张客户询单为例。在现在大多数 AI 系统里,询单进来以后的每一步都由同一个大模型完成:判断这是什么问题,决定去哪查资料,写答复,自己检查一遍,最后决定发出还是重写。
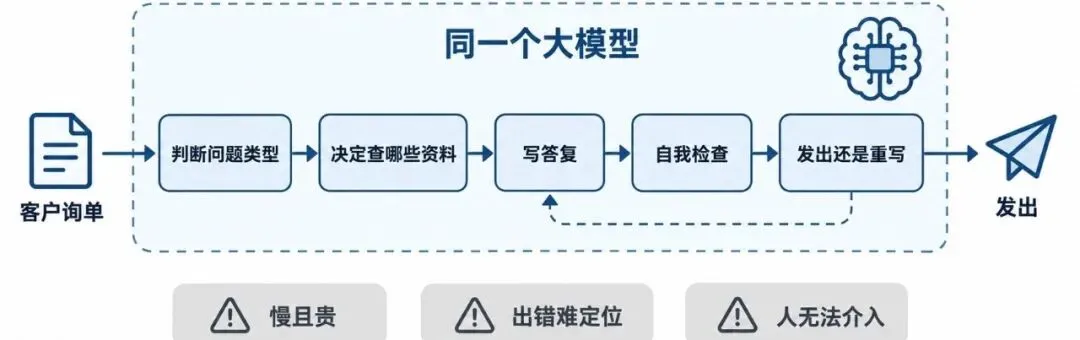
这就像一座工厂只有一位高级工程师,来料分拣、中间检查、写报告、出厂把关全是他。问题有三个:
又慢又贵。 五步里只有“写答复”真正需要写字,其余都是小判断。可大模型做小判断也得一个字一个字往外蹦,比专门做判断的 Jev 慢几十上百倍,也贵几十倍。
出错不好查。 判断和写作混在同一段输出里。答复错了,很难说清是一开始就归错了类,还是类归对了、话写错了。
人插不上手。 你想让人只看有风险的那几张单,系统却没留这个口子——大模型不会老实告诉你哪条它其实没把握。结果要么全靠人看,要么全不看。
二、Jev 的用法:三步
不管放在哪里,用 Jev 改造系统都是同样三步:
- 把决定变成题目。
把“看看这张询单怎么处理”这种含糊的指令,改写成有固定答案的题。比如:这张询单属于哪一类?选项是报价、交期、质量问题、退换货。题目和选项由人提前定好。 - 让 Jev 答题。
它给出答案,同时给出把握有多大。 - 按把握分三条路。
把握大的,系统直接照办;把握一般的,交给大模型再看;把握小的,交给真人。怎么分是写在程序里的规则,不由 Jev 决定。
在一条流水线上,Jev 常站三个工位:
三个工位上是同一个质检员,只是问的题不同。有一点容易想错:它们互相不认识。 出口的质检员不知道入口判过什么,每次都是第一次见。把它们串起来的是传送带,也就是程序;出口检查如果需要前面的信息,得由程序一并传给它。
所以别把 Jev 想成统管全局的主管。它做的事更小也更实在:在每个工位上,把眼前这件事看准。
三、新工厂:各司其职
质检员到岗后,工厂的角色就齐了:
同一张询单在新系统里这样走:
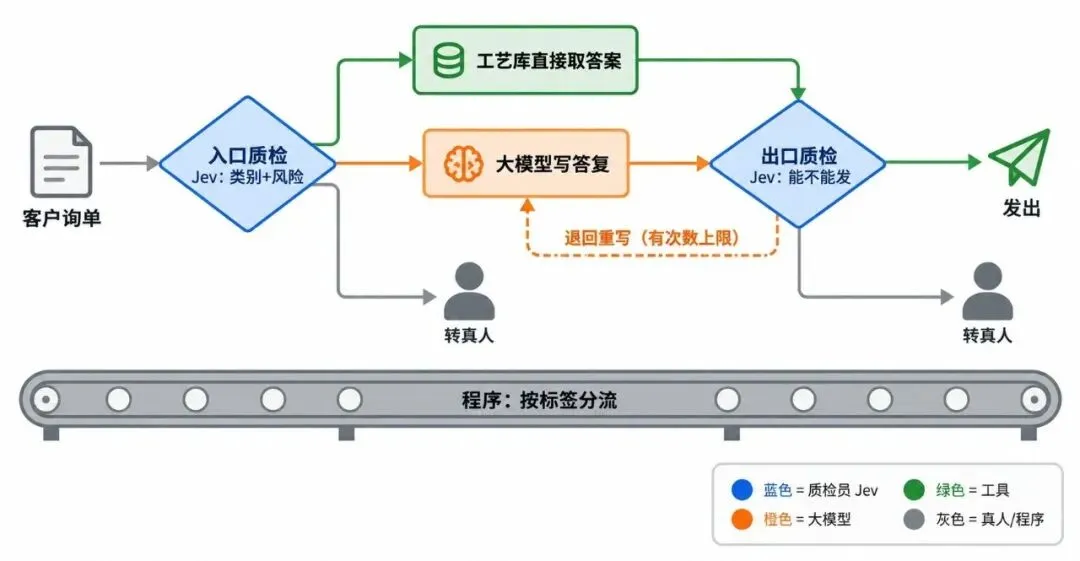
入口质检员先看一眼,贴上类别和风险标签。传送带按标签分流:简单问题直接从工艺库取现成答案,需要组织语言的交给大模型写,风险高的直接转真人。答复写好后,出口质检员再看一眼:有把握没问题的发出去,不合格的退回重写,拿不准的交给真人。
边界很清楚:质检员不设计产线,传送带不做判断只照章办事,高级工程师只在被叫到时出场。
四、走一遍:A 和 B 能合在一个批次生产吗
客户问: “这批订单能不能一半做产品 A、一半做产品 B,合在一个批次里生产?”
工厂规则: 同一批次只能生产同一型号,A 和 B 必须分开排产。
三个要点:
第一版的错被拦住了。 客户没看到“可以合批”这句话。没有出口检查,它就发出去了,后面就是排错产线、整批返工和合同纠纷。
质检员只判,不解释。 它能告诉你哪道题没过(“有没有乱承诺”),但说不出是哪句话出了问题、为什么。想知道原因,得另外让大模型解释。
返工有上限。 第二版还不过,传送带不会无限重来,超过规定次数就转真人。上限由人定,次数由程序数。
五、新旧对比:值不值得拆
最后一行是代价。系统从一块变成几块,并非什么场景都值得拆:
- 不划算的:
量小的系统,省下的钱可能抵不上维护的工夫;每个判断都要写明理由给审核人员看的场景,Jev 给不了理由,也不合适。 - 最划算的:
量大、重复、答案范围固定的判断。
六、人的活怎么变
我认为这是最重要的变化。以前是 AI 干、人抽查,抽多少、抽哪些基本靠感觉。现在可以分得很清楚。
人做四件事:
- 定标准:
什么算对、什么算错、什么绝对不能说。这是懂业务的人最清楚的事,AI 替代不了。 - 出题、定选项:
入口那道“属于哪一类”的选择题,选项表其实就是这门生意的分类方式。选项定得好不好,直接决定质检员判得准不准。这张表会成为最重要的资产之一,需要一直维护。 - 划分流线:
把握多大可以直接放行、多小必须转人工。上篇举过 95% 和 70% 的例子,但不能照抄——要拿真人判过的历史数据让 Jev 跑一遍,找到放行部分错得足够少的位置,再定下来。 - 处理拿不准的,复盘判错的:
系统挑出来的那部分交给人处理;处理完再回头看哪些题出得不好、哪条线划得不对,然后去改。
剩下的交给 AI 和程序: Jev 按标准把每一条又快又便宜地判一遍;大模型负责写作、处理拿不准的情况、在人需要时解释原因,也能帮人起草题目和选项表;程序把这些串起来,按规则分流。
一句话总结:人定标准,Jev 照标准判,大模型处理例外,程序把它们连起来。
人的工作量也换了形状:以前每条都可能要看,现在只看拿不准的那一段。前提是 Jev 给的把握数字靠得住。所以上线后还要定期抽查:它说有九成把握的那批,是不是真的九成对?对不上,就该重新划线。质检员也需要有人检查。
七、想动手改,从哪里开始
不必推倒重来,一个工位一个工位地换:
- 列出流程里所有做决定的地方。
很多决定藏在提示词里,比如“订单金额超过上限就转主管审批”,其实就是一道是非题。 - 挑出答案范围固定的。
能写成选择题、打分题、是非题的交给质检员;需要写字、讲道理的留给大模型。 - 先换一个。
挑量最大、最简单的判断点,比如入口分类。 - 新旧并跑一段时间。
同一批单子两边都判,对比差在哪。中文场景尤其要自己测,上篇说过,公开测试主要是英文。 - 根据判错的例子调题目、调选项、调线。
稳定了再换下一个。
这样做的好处是每一步都能退回去:某个工位换完效果不好,换回原来的做法即可,不影响其他工位。
八、往后看
Jev 只是第一个。我觉得有四个变化值得关注:
1. 模型开始分工。 过去默认一个大模型什么都做;以后一套系统里可能有好几种模型:找资料的、做判断的、想办法的、写东西的。选模型会从“哪个最强”变成“每个位置放哪个最合适”。
2. 以前舍不得做的检查,现在做得起了。 判断便宜几十倍、快几十上百倍后,很多只能抽查的事可以每条都查:每份 AI 答复发出前都过一遍规则,每张历史工单都打一个质量分。
3. AI 系统更好查、更好管。 每个判断都有单独的结果和把握数字,出了问题能定位到工位;人也终于有了明确的插手位置,不用在“全看”和“全不看”之间二选一。
4. 这条路不会只有 Jev 一家。 据报道,Jev 发布没几天就有人放出了开源的同类模型。其实这个工位一直有人站:传统的分类小模型,或者让大模型按固定格式答题。它们在准确度、速度与成本、把握数字是否可靠上各有长短,Jev 这类模型的新意,是把这几样同时做到了好用的程度。所以本文的重点是“判断”这个工位,而不是某个产品。
对做 AI 的人来说,时间会从写越来越长的提示词,转向出题、定选项、划线、看判错的例子。我的判断是:懂业务怎么分类、会看数据定标准的人,会变得更重要。
当然,这些都还早。Jev 发布不久,官方数据还缺乏大规模的第三方验证,中文效果要自己测。现在适合挑一个判断点小范围试,而不是把整个系统押上去。
写在最后
上一篇的结论是:判断和写作,也许不该由同一个模型来做。这一篇想说的是:一旦把判断单独拿出来,系统的搭法和人的位置都会跟着变。
质检员负责看准眼前这一件,传送带负责把东西送到对的地方,高级工程师只处理真正需要他的问题,人负责定标准、看例外。每个角色只做自己最擅长的事,整座工厂就顺了。
如果你手上有一个 AI 系统,可以先做一件小事:把它所有做决定的地方列出来,数一数有多少其实只是选择题和是非题。