ARTICLE · 1234855
大模型时代的文档解析地基:PP-DocLayout 从检测到阅读顺序的完整拆解
大模型时代,"喂数据"的瓶颈越来越前移到了文档解析上。一份 PDF 想变成能训练大模型的结构化语料,第一步往往不是 OCR,而是版面检测——先框出"哪里是标题、哪里是正文、哪里是公式和表格",后面的 OCR、公式识别、表格识别、KIE (Key Information Extraction,关键信息抽取) 才有意义。
PP-DocLayout 就是百度 PaddlePaddle 团队为这条流水线打造的版面检测模型。它先后迭代发布了多个版本,而最早的 V1、V2 基本就囊括了它的核心技术:V1 靠"知识蒸馏 + 半监督伪标签"把一个轻量检测器做到了 SOTA;V2 在检测之上又级联了一个"神经网络阅读顺序(Reading Order)"模块,让模型不仅回答"页面上有什么、在哪里",还回答"这些区域该按什么顺序读"。所以本文就以这两代为主线,先讲 V1,再讲 V2。
一、背景:现有版面检测痛点
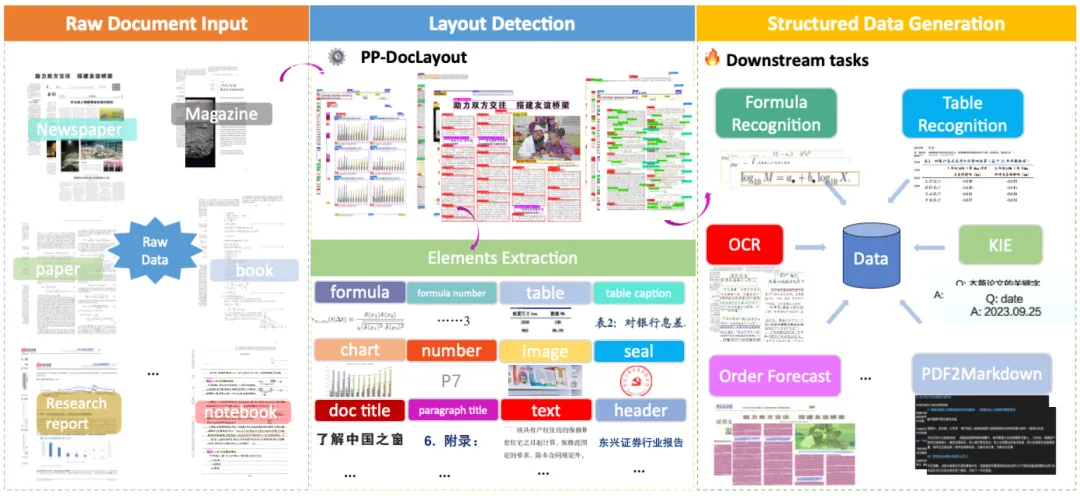
版面检测(Document Layout Analysis,DLA)是文档智能的前置步骤。整条链路是这样的:
原始文档(论文/杂志/报纸/研报/书籍/合同/手写…) → 版面检测(PP-DocLayout) → 元素抽取(formula / table / chart / image / title / text …) → 下游任务(公式识别 / 表格识别 / OCR / KIE / PDF2Markdown) → 结构化训练数据已有版面检测模型有三个突出痛点:
1. 跨文档类型泛化差。多数方法只在学术论文上训练,遇到杂志、报纸、研报、手写笔记就崩。 2. 细粒度类别缺失。缺少完整的类别定义——比如行内公式和行间公式不区分、脚注/页眉/页脚常被当成 "abandon" 忽略掉,逼得系统去堆辅助模型,复杂又低效。 3. 实时性不足。很多 SOTA 模型太慢,无法支撑大规模数据构建。
PP-DocLayout(V1)的定位就是一个统一的高精度 + 实时版面检测模型:23 个细粒度类别,覆盖中英文论文、杂志、报纸、研报、试卷、书籍、合同、手写笔记、表格等多种文档;并提供 L / M / S 三档,分别对应高精度、精度速度平衡、轻量高速三种需求。
二、V1 能检测什么,以及它的两项核心技术
2.1 V1 检测哪些类别
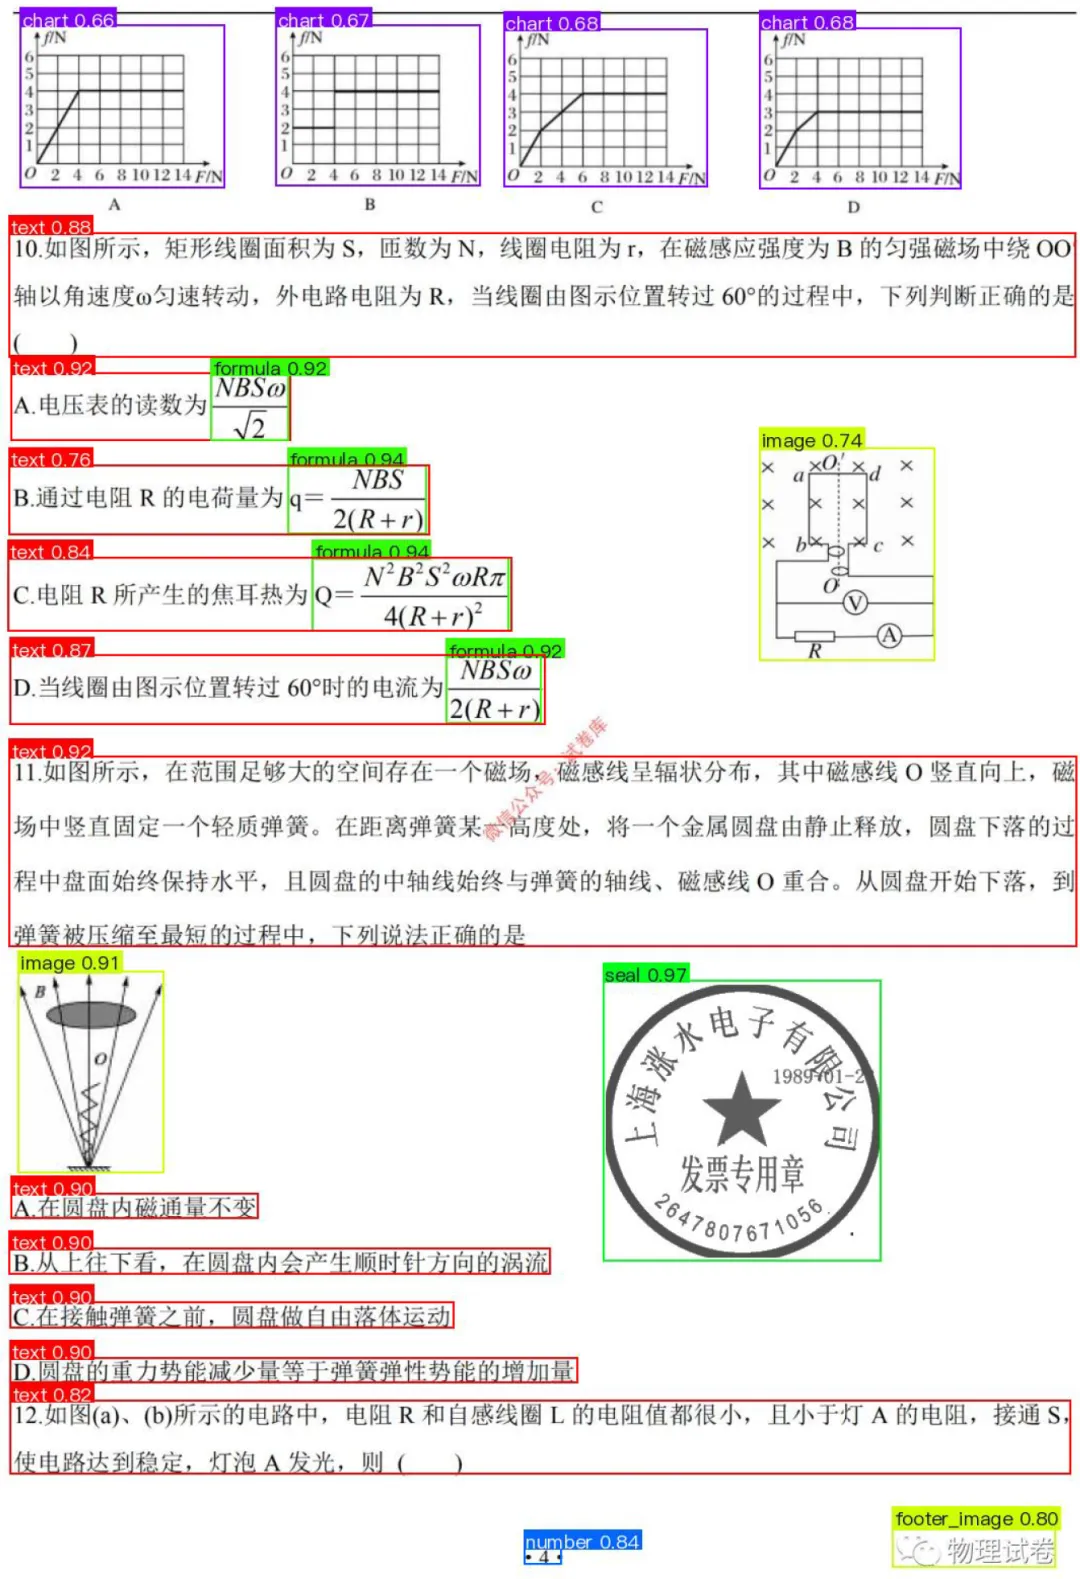
V1 定义了 23 个版面类别,比 DocLayout-YOLO 之类把标题/正文/图统统压成几个大类的方案细得多:
paragraph_title | footnote | ||||
image | header | ||||
text | algorithm | ||||
number | footer | ||||
abstract | seal | ||||
content | chart_title | ||||
figure_title | chart | ||||
formula | formula_number | ||||
table | header_image | ||||
table_title | footer_image | ||||
reference | aside_text | ||||
doc_title |
V1 有 L / M / S 三档,分别基于不同架构构建:
也就是说:只有 L 是 RT-DETR-L,M 和 S 都是 PicoDet 系列。 三者的训练方式也不同——L 靠知识蒸馏拿到一个强 backbone 再训检测器,M/S 则靠 L 生成的半监督伪标签来训。这正好对应 V1 的两项核心技术,下面分别展开。
2.2 核心技术一:Backbone 知识蒸馏
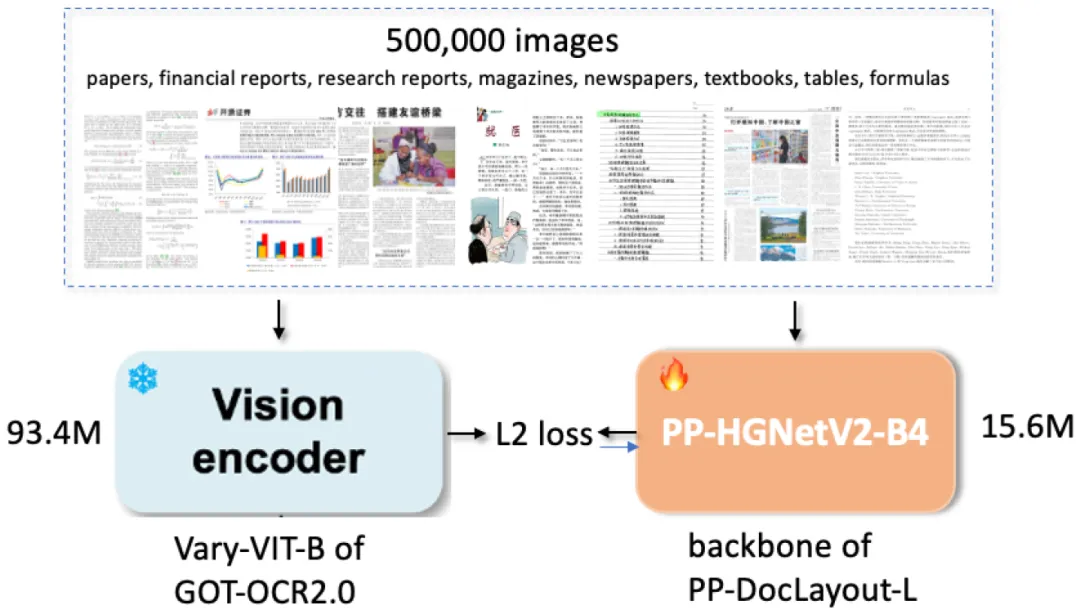
为什么需要蒸馏? L 的 backbone 是轻量的 PP-HGNetV2-B4(约 15.6M 参数)。这么小的 CNN 如果只靠 3 万张检测标注从头训,很难学到足够通用的文档视觉先验——字体、纹理、公式排布、表格线、版式结构这些东西,需要大规模文档才能见得广。直接训检测器,泛化能力会受限。
思路于是变成:找一个见过海量文档的大模型当"老师",把它的文档视觉知识低成本地灌进这个小 backbone,再拿去初始化检测器。
教师怎么选? 选的是 GOT-OCR2.0 的视觉编码器 Vary-VIT-B(约 93.4M 参数)。它经过大规模文档数据训练,具备很强的文档理解能力,正好是我们想迁移的那种"文档视觉表征"。蒸馏时把它冻结当教师,只训学生。
蒸馏框架如下:
文档图像 768×768 ├─> 冻结的 Vary-VIT-B(教师,93.4M)─────────> F_T [B,D] └─> PP-HGNetV2-B4(学生,可训练,15.6M)─────> F_S [B,P] │ Linear(P,D) 投影 φ │ MSE( F_T , φ(F_S) )因为教师维度 和学生维度 一般不相等,中间加一个可学习的线性投影 把学生对齐到教师维度。蒸馏损失就是标准的特征回归 / MSE:
教师特征 stop-gradient,梯度只更新学生 backbone 和投影层 。
注意:具体蒸哪个 stage/token,论文没细说。 论文只给了 和 这两个二维形状——没有空间维 ,也没有 token 数 ,说明特征已经被聚合成"每张图一个向量"。但从哪个 stage 取、怎么 pooling,论文没公开。最自然的实现是:学生末级 stage 特征 做 Global Average Pooling 得到 ,教师侧做 token pooling 或取特殊 token 得到 。
蒸馏值多少? 论文消融显示,backbone 蒸馏把 PP-DocLayout-L 从 89.3 提到 90.4 mAP(+1.1)。
2.3 核心技术二:半监督伪标签
L 训好之后,怎么把能力低成本地传给 M/S?V1 用的是离线伪标签。整个流程要先理清楚数据是怎么用的:
• 先用约 3 万张人工标注数据(外加约 500 张评估图)把 L 训练好——这批是有 bbox + class 的检测标注,来自百度图片搜索及 DocLayNet、PublayNet 等公开数据。 • 此外还有大量无标注文档图。用训练好的 L 给这些图打标,产出的伪标注拿去训练 M / S。
注意,这里的师生和上面蒸馏那套完全是两套:
串起来就是:
Vary-VIT-B ─蒸馏→ PP-HGNetV2-B4 ─初始化→ PP-DocLayout-L ─生成伪标签→ PP-DocLayout-M/S(迁移图像级视觉特征) (迁移检测框 + 类别)打标过程是怎样的? 简单说就是"L 预测 → 按类别用不同阈值过滤 → 留下合理的框"。
PP-DocLayout-L(无标注 image) → candidate box_i + class logits_i[23] → 由 logits 算出预测类 class_i 与概率 score_i → 若 score_i > τ[class_i](该类专属阈值):保存 box_i + class_i → 否则:丢弃每个框的分类类别 class_i 和 分数 score_i, 均由模型输出的 class logit得到,即:
保存下来的标注结构是:
{ "bbox": [xmin, ymin, width, height], "category_id": 7 }为什么要"不同类别不同阈值"? 统一用 0.5 会有问题:正文文本很容易拿高分,而印章、页脚图片这类长尾类置信度分布偏低,一刀切会让各类 precision/recall 严重失衡。V1 改成在有标注验证集上,对每一类单独扫描阈值、最大化该类 F1:
流程为:
对类别 c: 1. PP-DocLayout-L 在有标注验证集上推理 2. 扫描候选阈值 tau 3. 将预测框与 GT 按检测规则匹配 4. 计算 precision_c(tau) 和 recall_c(tau) 5. 计算 F1_c(tau) 6. 保存使 F1 最大的 tau_c*于是得到 23 个阈值 。最后把人工标注数据和伪标注数据合并,一起训 M/S。
半监督值多少? 论文消融里这一招对轻量模型收益明显:
| +1.4 | ||
| +4.7 |
三、V1 的训练与性能
3.1 三套数据与三阶段训练
检测数据来自百度图片搜索以及 DocLayNet、PublayNet 等公开数据,覆盖中英文论文、杂志、报纸、研究报告、试卷、书籍、合同、手写笔记和表格等文档。每个检测实例的训练标注需要 image_id + bbox + category_id。
对应地,V1 的训练是三阶段,而不是一步到位:
阶段 ① 蒸馏训练 PP-DocLayout-L 的 backbone Teacher: Vary-VIT-B(93.4M,冻结) Student: PP-HGNetV2-B4(15.6M) 数据: 约 500,000 张文档图(公式/金融文档/科技论文/学位论文/表格等五大领域) 输入: 768×768,50 epoch,AdamW(β1=0.9, β2=0.999)阶段 ② 有监督端到端训练 PP-DocLayout-L 用蒸馏后的 B4 初始化 backbone → 接 HybridEncoder + Decoder + 检测头 用人工标注的 bbox/class 做检测训练 100 epoch,8×V100,每卡 batch size 2(总 bs 16),lr 1e-4,约 26 小时阶段 ③ 半监督训练 PP-DocLayout-M / S 用训练好的 L 给无标注图打伪标签(每类自适应阈值过滤) 人工标注 + 伪标注合并,训练 PicoDet 系列的 M/S蒸馏预训练、检测训练、检测推理的输入分辨率各不相同,分别如下:
768×768 | ||
640×640 | ||
640×640 | ||
480×480 | ||
480–800 多尺度 | ||
576–704 多尺度 | ||
416–544 多尺度 |
3.2 性能表现
| 90.4 | ||||
L 用 30.94M 参数拿到 90.4 mAP、T4 上 74.6 FPS;S 只有 1.21M 参数,CPU 上都能跑到实时。
四、V2:在检测之上叠加阅读顺序
V2 没有单独论文,下面的解读基于 PaddleX / PaddleOCR / HuggingFace 的公开实现。它的演进关系是:
PP-DocLayout-L(论文 V1,23 类) └─> PP-DocLayout_plus-L(更丰富数据,20 类) └─> PP-DocLayoutV2 = RT-DETR-L 检测底座 + 25 类检测定义 + 级联 Reading Order 网络和 V1-L 摆在一起看,差异一目了然:
| 800×800 | ||
概括起来,V2 相对 V1 有三点改进:
1. 自适应阈值:V1 已有"不同类别不同阈值"的思想,V2 在检测过滤阶段继续沿用每类阈值,只是数值针对 25 类重新设定(正文/标题/公式约 0.4、seal 约 0.45、其余多为 0.5)。 2. 阅读顺序(Reading Order):这是 V2 的核心新能力——除了"有什么、在哪里",还回答"这些区域该按什么顺序读"。检测分支产生候选区域,排序分支再对这些区域做全局关系推理。 3. 检测类别扩展:从 23 类调整到 25 类,把一些语义拆得更细。
第 3 点的 25 类如下:
abstract | header_image | ||||
algorithm | image | ||||
aside_text | inline_formula | ||||
chart | number | ||||
content | paragraph_title | ||||
display_formula | reference | ||||
doc_title | reference_content | ||||
figure_title | seal | ||||
footer | table | ||||
footer_image | text | ||||
footnote | vertical_text | ||||
formula_number | vision_footnote | ||||
header |
相对 V1 的关键变化:formula 拆成 inline_formula + display_formula;新增 vertical_text(竖排文本)、reference_content(单条参考文献)、vision_footnote(图/表说明或脚注);把 figure_title / table_title / chart_title 统一到 figure_title。
自适应阈值和类别扩展都是"顺理成章"的小改进,V2 真正的重点是阅读顺序——下面单开一节详细拆解。
五、V2 的 Reader Order 到底怎么工作
这是 V2 的灵魂。核心一句话:它不是"从上到下、从左到右"的坐标排序,而是一个区域级的两两先后关系模型。
模型学的问题不是"区域 i 的绝对序号是几",而是:
对任意两个区域 i、j,i 是否应该在 j 之前阅读?
然后把所有 pairwise 关系合成为一个全序。整个 Reader Order 分支和检测器是级联的(不是端到端一张网):
输入 image [B,3,800,800] ├─ RT-DETR-L → raw boxes [B,300,4] + class logits [B,300,25] ├─ 每类置信度阈值过滤 → N 个有效区域(N ≤ 300) ├─ 区域 embedding [B,N+2,512] ├─ 6 层 Spatial-aware Transformer → [B,N+2,512] ├─ 去掉 START/END,GlobalPointer → order logits [B,N,N] └─ pairwise vote + argsort → 每个区域的 order_rank下面严格按数据流逐层展开。
5.1 从检测结果到有效区域
Reader Order 的输入来自检测器,检测器最后一层 decoder 给出 raw_bboxes [B,300,4](归一化 )和 logits [B,300,25]。对每个 query 取预测类、算概率、按该类阈值判定是否保留:
(每类阈值不同:正文/标题/公式约 0.4,seal 约 0.45,其余多为 0.5。)留下 个有效区域(),框从 转成 后乘 1000 裁剪:
这一步把连续的归一化坐标离散成整数索引——下一节的 bbox embedding 是用查表(Embedding 层)来编码位置的,查表需要整数桶(0..1023),所以先把坐标量化到 0..1000, 这个类似 LayoutLM 的离散版面坐标系,好处是让排序网络与原图实际像素尺寸彻底解耦。
5.2 区域 embedding:把每个框变成一个 512 维向量
排序网络的输入不是 OCR 文本,而是把每个有效检测框转成一个 512 维向量,再送进 6 层 Transformer。每个区域的 512 维 embedding 由四部分相加得到:
下面逐个说这四部分怎么来。
① —— token embedding。 区域序列拼成 [START], region_1, …, region_N, [END], [PAD]…,词表只有 4 个占位 token(不是 OCR 文本):
[START] | ||
[PAD] | ||
[END] | ||
[PRED] |
所有普通区域在这一项上都是同一个 [PRED] embedding。最大 query 数 300,典型序列最多 302 个有效位置(加 START/END),配置预留最大一维位置数 514。
② —— 一维序列位置 embedding。position_embedding(position_id),编码区域当前被送入网络时的序列位置(训练时这个顺序会被随机打乱,防止模型偷看输入下标)。
③ —— 二维绝对框 embedding。 对每个 框的四条边加宽高共 6 个量分别查表再拼接,最后线性投影到 512:
x_left: Embedding(1024,171) width: Embedding(1024,170)y_transform: translateY( Embedding(1024,171) height: Embedding(1024,170)x_right: Embedding(1024,171) 拼接维度 = 4×171 + 2×170 = 1024 → Linear(1024,512)y_bottom: Embedding(1024,171)(宽高由 、 得到并裁剪到 0..1023——这就是 5.1 把坐标量化到 1000 的用处。)
④ —— 类别 embedding。 检测类别先经过一张 class_order 映射表,把 25 个检测类归并成约 16 个排序语义类,再查 label_embedding → Linear(512,512):
paragraph_title | headerheader_image | ||||
chartimage/table | footerfooter_image | ||||
algorithminline_formula | seal | ||||
textreference/reference_content | formula_number | ||||
number | aside_text | ||||
abstract | vertical_text | ||||
content | display_formula | ||||
figure_titlevision_footnote | doc_title | ||||
footnote |
class_order 这个名字容易让人误以为是"类别优先级表",其实不是——这些 ID 只是类别 embedding 的索引,不是排序位置。paragraph_title→0 绝不表示段落标题一定排第 0 位;真正的顺序仍由后面的 Transformer + GlobalPointer 预测。归并是因为阅读顺序关心区域"在文档结构中的角色",image/table/chart 都作为整体视觉块参与顺序判断,没必要完全分开。
四部分相加后再过 LayerNorm 和 Dropout:
E_i → LayerNorm(512) → Dropout(0.1) → hidden_states [B,L,512]这就是喂给 6 层 Transformer 的 [B, N+2, 512]。
5.3 6 层 Spatial-aware Transformer
Transformer 之前,先补一件事:二维相对几何 bias。5.2 的绝对 bbox embedding 告诉每个 token"我在页面哪里";相对几何 bias 则直接告诉 attention"我和另一个区域是什么空间关系"。对区域 ,从各自的 算 4 个相对量:
是"相距几个源区域宽/高", 是宽高比;log 让极大距离/尺度比更平滑。每个标量做 16 维 sin/cos 频率编码(4 标量共 64 通道),最后 1×1 Conv 投影成每个 head 的 bias:
relative_geometry: [B,N,N,4]sin/cos 编码: [B,N,N,64] → permute [B,64,N,N]1×1 Conv: 64 → 8 heads → spatial_bias [B,8,N,N]这个 bias 只由框坐标算一次(1×1 Conv 参数可学习),然后在 6 层里复用。
Reader Order Encoder 有 6 个同构层:
输入 X_l [B,L,512] ├─ 8-head Self-Attention + spatial bias ├─ Linear(512,512) + Dropout → Residual + LayerNorm ├─ FFN: Linear(512,2048) → GELU → Linear(2048,512) └─ Dropout → Residual + LayerNorm → X_(l+1) [B,L,512]每个 head 维度 。第 个 head 的 attention logit 是三项相加:
学语义/类别/上下文关系, 注入框之间的相对几何, 屏蔽 PAD。注意力是双向的,不是自回归 causal——所有有效区域互相看到彼此。
为什么要 6 层?多层 self-attention 能逐步建立全局结构:浅层看相邻/上下左右关系,中层看列、标题-正文、图-caption 等局部组,深层看跨列、跨视觉块、整页一致顺序。这只是直觉——代码没强制"某层只干某件事",分工是训练中自组织出来的。
和 RoPE 的关系:RoPE 和 spatial bias 都是用来表达"相对位置"的,但表达的东西不同。RoPE 管的是序列/网格上的相对位置(相隔几个 token),做法是旋转 Q/K;spatial bias 管的是两个区域框的二维距离与尺寸比例——普通 RoPE 甚至不知道区域的宽高。二者正交、可以叠加使用(一个改 Q/K、一个加 bias);当前公开实现只用了 additive spatial bias,没有用 RoPE。
5.4 GlobalPointer 两两关系头
6 层输出去掉 START/END,只留最多 300 个区域 token [B,N,512],进 GlobalPointer:
Linear(512,128) → reshape [B,N,2,64] → unbind → Q [B,N,64], K [B,N,64]矩阵语义是 (i 在 j 之前的概率)。实现只保留严格上三角 ,对角线和下三角填成极小值:
j=0 j=1 j=2 j=3i=0 X p01 p02 p03i=1 X X p12 p13i=2 X X X p23i=3 X X X X这样每对区域只预测一次。若需要反方向概率,则用互补关系 。
5.5 从 N×N 关系恢复一个全序
先 sigmoid 得 。对每个区域 ,累加所有其他区域排在它前面的概率,得到"期望前驱数量" :
小 → 很少有区域该排它前面 → 靠前; 大 → 靠后。最后 ,再反写成每个区域的 rank。
A/B/C 具体算例(数值是教学示例,非真实输出):
上三角 sigmoid: P(A≺B)=0.9 P(A≺C)=0.8 P(B≺C)=0.7补全反方向: P(B≺A)=0.1 P(C≺A)=0.2 P(C≺B)=0.3前驱票数(越小越靠前): vote(A) = P(B≺A)+P(C≺A) = 0.1+0.2 = 0.3 vote(B) = P(A≺B)+P(C≺B) = 0.9+0.3 = 1.2 vote(C) = P(A≺C)+P(B≺C) = 0.8+0.7 = 1.5argsort([0.3, 1.2, 1.5]) → A → B → C这种聚合的优点是即使个别 pair 预测有噪声,靠全体投票也能得到稳定次序;缺点是不显式保证无环,遇到 这种冲突会用总票数强行打破。
5.6 后处理
底层 PaddleX 后处理会把每个区域整理成 8 个字段:
class_id, score, xmin, ymin, xmax, ymax, order_rank, order_vote它们分别来自:
• score:如 5.1 所述,由分类概率得到——对该 query 的分类 logit 取 。• order_vote:就是 5.5 的前驱票数 (该区域的"期望前驱数量")。• order_rank:对order_vote做 得到的名次,即最终阅读顺序。
高层后处理通常会:① 按 order_rank 排序检测结果;② 删掉内部排序辅助字段;③ 返回已排好顺序的 boxes 列表。所以用户往往只看到:
{ "boxes": [ {"label": "doc_title", "coordinate": [...]}, {"label": "text", "coordinate": [...]}, {"label": "image", "coordinate": [...]}]}列表下标本身就是阅读顺序。
5.7 顺序预测的两条路:启发式 vs 深度学习
文档阅读顺序的预测方法,大致分成两类。
一、启发式 / 规则法:如XY-Cut。 不训练排序网络,靠几何规则推顺序——递归地在 X、Y 方向做投影切分(找空白间隙把页面递归切成块,再按块的相对位置定序)。单栏文档很好用,但多栏、跨栏标题、环绕排版容易翻车。经典反例:
左栏 A1 右栏 B1左栏 A2 右栏 B2纯按 y 排:A1 → B1 → A2 → B2 ❌真实顺序:A1 → A2 → B1 → B2 ✓二、深度学习法。 用模型直接学"区域该怎么排"。PP-DocLayoutV2 属于关系预测型——GlobalPointer 预测区域两两先后关系,再投票成全序;类似思路的还有 LayoutReader,把阅读顺序当成 seq2seq 序列生成来学。
对比:
PP-DocLayoutV2 之所以稳过 XY-Cut,是因为它同时用了三类信息,再让 Transformer 让每个区域看到全页,从而判断"这是双栏""这个标题跨栏""这个 caption 跟在图后面":
但也要认清边界:PP-DocLayoutV2 的 Reader Order 输出的是线性顺序,不是树形文档结构。它不直接表达 caption 归属哪张图、标题层级、表格脚注的父子关系、跨页段落连续性、引用与参考文献条目的链接——这些是"树结构"类方法想解决的问题。在 Paddle 生态里,通常仍交给上层的 PP-StructureV3 / PaddleOCR-VL 结合 OCR、规则或视觉语言模型处理。
六、总结
PP-DocLayout 两代的技术脉络,可以浓缩成"V1 的两个核心技术 + V2 的一个新能力":
1. V1 核心技术之一 —— Backbone 知识蒸馏:教师 Vary-VIT-B → 学生 HGNetV2-B4,图像级特征 MSE,把大模型的文档视觉表征灌进轻量 backbone。 2. V1 核心技术之二 —— 半监督伪标签:训练好的 L 给无标注图打伪标签,配合每类自适应阈值过滤,低成本把能力传给 M/S。 3. V2 的 Reader Order:预测区域两两先后关系,再用前驱票数投票 + argsort 得到全序;靠绝对位置 + 相对几何 bias + 语义角色 + 全页 attention,稳过 XY-Cut 这类启发式规则法。
把这几招串起来看:PP-DocLayout 用"轻量检测器 + 大模型知识蒸馏 + 自适应半监督 + 神经阅读顺序"这套组合拳,在精度、速度、结构化能力三者之间找到了一个漂亮的平衡点——最终服务的,是大模型时代最稀缺的东西:大规模、高质量、带结构的文档训练数据。
参考资料
1. PP-DocLayout: A Unified Document Layout Detection Model,arXiv:2503.17213:https://arxiv.org/abs/2503.17213 2. PaddleOCR 版面区域检测文档:https://github.com/PaddlePaddle/PaddleOCR/blob/main/docs/version3.x/module_usage/layout_detection.md 3. PaddleX PP-DocLayout-L 配置:https://github.com/PaddlePaddle/PaddleX/blob/develop/paddlex/configs/modules/layout_detection/PP-DocLayout-L.yaml 4. PaddleX PP-DocLayoutV2 推理实现:https://github.com/PaddlePaddle/PaddleX/blob/develop/paddlex/inference/models/object_detection/modeling/pp_doclayout_v2.py 5. Hugging Face Transformers PP-DocLayoutV2 实现:https://github.com/huggingface/transformers/tree/main/src/transformers/models/pp_doclayout_v2 6. GOT-OCR2.0:https://arxiv.org/abs/2409.01704 7. PaddleOCR PPHGNetV2_B4源码:https://github.com/PaddlePaddle/PaddleOCR/blob/main/ppocr/modeling/backbones/rec_pphgnetv2.py8. Vinyals et al., Pointer Networks:https://arxiv.org/abs/1506.03134 9. Su et al., GlobalPointer:https://kexue.fm/archives/8373 10. LayoutReader: Pre-training of Text and Layout for Reading Order Detection,arXiv:2108.11591:https://arxiv.org/abs/2108.11591