ARTICLE · 1242919
品牌AI可见度工具测出"三个数":GEO服务商的信任危机,已经开始了
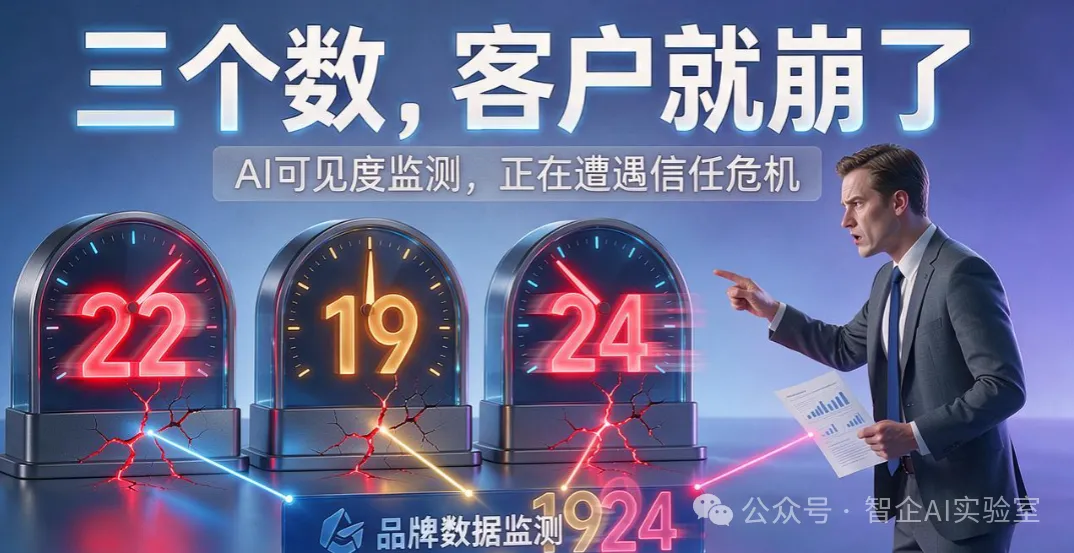
最近行业里有个事在圈子里传得很快。同一家品牌、同一批40个问题、同一段30天时间,有人拿Profound、Otterly、Peec三家主流AI可见度监测工具同时跑了一遍——报出来的命中数分别是22、19、24。
三个数,谁都没算错。但把这三个数摆在一起给客户看,客户只会得出一个结论:你们这行的数,到底准不准?
这不是个小问题。过去半年,几乎所有GEO服务商都在给客户卖"AI可见度监测"——有的打包在代运营服务里,有的做成了独立SaaS,有的用它作为签单前的"诊断"工具。监测数据已经成为我们这行说服客户、证明效果、续约谈判的核心依据。
但现在,这个依据自己出现了信任裂缝。
很多同行的第一反应是:嗨,工具嘛,算法不同有点偏差很正常,多测几次就好。
我不太同意。
这不是"算法差异"能搪塞过去的问题。这是整个行业交付可信度的问题。如果客户发现你给他看的数字换个工具就能差出一大截,他第一反应不是"工具不统一",而是"你是不是挑了个好看的数给我"。这个怀疑一旦种下去,你后面所有交付都会被打折扣。
今天咱们不评说哪家工具好哪家差。就聊三件事:为什么会出现三个数、这件事对GEO服务商到底意味着什么、你现在应该怎么应对。
一、重点不在"工具不准",在"监测和优化绑在一起,本身就是个问题"
先把"三个数"这件事拆开看,其实差异来自四个地方,每一个都是我们这行必须直面的。
第一,口径没对齐。 Profound算"被点名"(回答文本里出现品牌名)、Otterly算"被链接"(引用URL含客户域名)、Peec算"被提到"(含同义词、子品牌、对比提及)。三个工具把三件不同的事叫成了同一个词"AI可见度"。这不是算法问题,是行业术语不统一——而这个锅,不能让工具商背,是我们整个GEO行业到今天都没拿出一套公认的测量口径。
第二,抽样量普遍不够。 多数工具每个prompt只跑10-30次。按实测经验,temperature=0的情况下同一个prompt也要跑到60-100次答案才开始收敛。30次采样的波动有多大?34%和28%之间的差距,可能根本不是趋势变化,就是噪声。而我们拿这个波动去跟客户汇报"本月提升了6个百分点"——说实话,心里不虚吗?
第三,prompt库是黑箱。 工具厂商自己建的提示词库里,塞了多少品牌词、多少品类词、多少场景词?如果品牌词占比高,测出的"可见度"天然就高,但那不是AI推荐你,是AI复读你。客户一旦亲手在AI上问几个非品牌词,发现AI根本没推荐他,你那份报告就崩了。
第四,也是最要命的——既做监测又卖优化的利益冲突。 国内不少GEO服务商的商业模式是:先用监测工具给客户"诊断"出一个很难看的数字,然后卖GEO优化服务,优化完再用自家工具测一个好看的数字给客户看。自己出题自己考自己,这种数据客户早晚会质疑。9月以来行业里已经出现客户主动要求用第三方独立监测工具验收的案例,这个趋势只会加速。
二、客户比你想象的更聪明:他们已经开始"手测"了
有一个信号所有GEO服务商都该注意到——越来越多的品牌方市场部,开始自己亲自去豆包、DeepSeek、元宝、通义上敲问题了。
以前客户是"你给我看什么我信什么"。现在不一样了。
CSDN上最近一篇工具对比文阅读量很高,讲六款AI可见度监测工具(Geolix、Ahrefs、Semrush、Similarweb、HubSpot、Profound)各自覆盖多少引擎、能不能导出数据、每天采样多少次。评论区里大量是甲方市场部的人在问"哪个能接自己的报表""哪个能看到原始回答"。
国内的独立第三方监测产品也在起势——搜极星明确打"只监测不优化、只诊断不开药"的定位,BUGOOAI布谷主打"分条件测概率"(按预算/地区/场景拆分可见度)。这些产品的共同特点是:不做代运营,只做独立第三方数据。
这背后是一个很清晰的趋势:客户正在从"看服务商给的报告"转向"自己去AI上问、自己用第三方工具测"。
当客户开始手测,他会发现几件事:
● 你给他看的"提及率55%",他自己问只有30%,因为你问的是品牌词、他问的是品类词;
● 你给他看的"首推率",换个AI平台(比如从豆包换到DeepSeek)直接掉到零;
● 你说"这个月优化效果显著",但那只是某一天的快照,过两天AI更新了算法又回去了。
到那个时候,客户不会找工具商算账,他会找你。
三、你现在必须动的四件事
这个趋势不可逆。等客户集体反应过来再调整,就被动了。这周你就该动四件事。
第一件:把你的监测口径,写得明明白白。 别再给客户一个笼统的"AI可见度XX%"。把指标拆成至少三层:
● 提及率——回答文本里出现客户品牌名的比例(分母:带品牌样本);
● 首位率/前三推荐率——在推荐名单里的位置(分母:带推荐列表的样本);
● 非品牌词推荐率——问品类词/场景词时AI主动推荐客户的比例(这个才是真金白银)。
三层指标分开报,不要合成一个黑箱总分。客户问起来你能讲清楚每一层是什么意思,信任度立刻上来。
第二件:采样量和采样方法写进交付说明。 你每个问题跑多少次?覆盖哪几个AI模型?提问时间是怎么分布的?temperature怎么设的?这些参数不要藏着。写清楚"本报告基于豆包/DeepSeek/元宝/通义/文心五个平台,每个问题每日采样100次,共X个问句,合计X次提问"——数字越具体,客户越信。含糊一句"基于AI监测数据",等于没说。
第三件:监测和优化,要么分离、要么说清楚。 如果你既做监测又做代运营,必须在合同里跟客户讲清楚:监测数据由哪套系统出、原始回答是否可查、客户能不能自己登录后台看。更进一步的做法是:主动引入第三方独立监测作为验收依据。你说你做了优化,用第三方工具复测给客户看——这比你自己测自己有说服力一百倍。短期内这是增加成本,长期这是你的护城河。
第四件:把"原文+信源URL"作为标准交付物。 不要只给客户一个数字。每一份监测报告里都要附上:① 原始问题清单;② AI回答的原文截图/文本存档;③ AI引用的信源URL列表;④ 采样时间、模型版本。客户能点进去看、能自己复现,这份报告才有价值。给不出原文的数字,以后客户不会认。
四、长期看:这是行业升级的机会,不是危机
看到这里你可能觉得:这不是给自己找事吗?客户不就是想要个好看的数字交差吗?
短看是这样,长看不是。
一个行业从"谁胆子大谁赚钱"进化到"谁的数据经得起核验谁赚钱",这个过程里一定会洗掉一批人——那些靠截图交差的、靠话术忽悠的、靠"自己出题自己考"做交付的,会被客户一个一个识破。
但对认真做事的服务商来说,这是好事。
因为当客户不再为"模糊数字"买单,他就会开始为"可核验的过程"买单。你能把口径讲清楚、能把采样方法亮出来、敢用第三方工具验收、能提供原始回答存档——你就比同行多了一层信任壁垒。而信任,在GEO这个还没完全标准化的行业里,是最贵的东西。
顺便说一句,中国商务广告协会9月14日公布的五项GEO团体标准(T/CAACCHINA 001–005—2026)里,《计价评估与测量》那一份已经在把监测维度、采样规则、效果指标往标准化方向推。10月16日上海那场宣贯会之后,会有越来越多的客户拿着团标问你:"你们的监测方法符合这个标准吗?"
与其等客户问,不如你先做到。
五、写在最后
三家工具测出三个数这件事,看上去是工具的尴尬,实际上是整个GEO服务行业的一道坎。
它对两类服务商是坏消息:
● 靠"一张截图交差"做交付的,因为客户已经开始手测;
● 靠"自家监测+自家优化"做闭环的,因为第三方独立监测会把这个闭环拆开。
它对两类服务商是好消息:
● 愿意把监测口径、采样方法、原始数据全部亮给客户看的,因为透明本身就是竞争力;
● 主动接受第三方监测做验收的,因为这会把你从"卖报告的"升级为"对结果负责的"。
AI可见度数字准不准这件事,最终答案不在工具商手里,在我们服务商自己手里。
你敢不敢让客户自己复现你给的数?敢不敢让第三方来验收你的效果?敢不敢把"你可能看不到立竿见影的效果"这句话说在前面?
敢的人,会留在牌桌上。不敢的人,会被越来越聪明的客户一个一个淘汰。
这不是行业寒冬。这是行业长大。
———
扫码加我微信
GEO 落地交流 · 合作咨询