ARTICLE · 1259246
我拆了三个安装包:Qoder、Trae、WorkBuddy 是怎么接管你 Chrome 的
昨天翻 Chrome 的一个系统目录,看到一条挺有意思的线索。
~/Library/Application Support/Google/Chrome/NativeMessagingHosts
里面躺着几个 JSON 小文件,文件名一个比一个眼熟:com.qoder.app.connector、com.solo.browser_bridge、com.workbuddy.extension。三份清单指向三个程序,指向同一个用途——把本地 Chrome 交出去,给一个 AI 当手用。
Qoder CN、Trae CN、WorkBuddy,这三款我都在用。它们都在做同一件事,但走的是三条不一样的路。这篇把三条路拆开讲讲,尽量说人话。
它们没有另开一个浏览器。它们是接管了你现在这个。
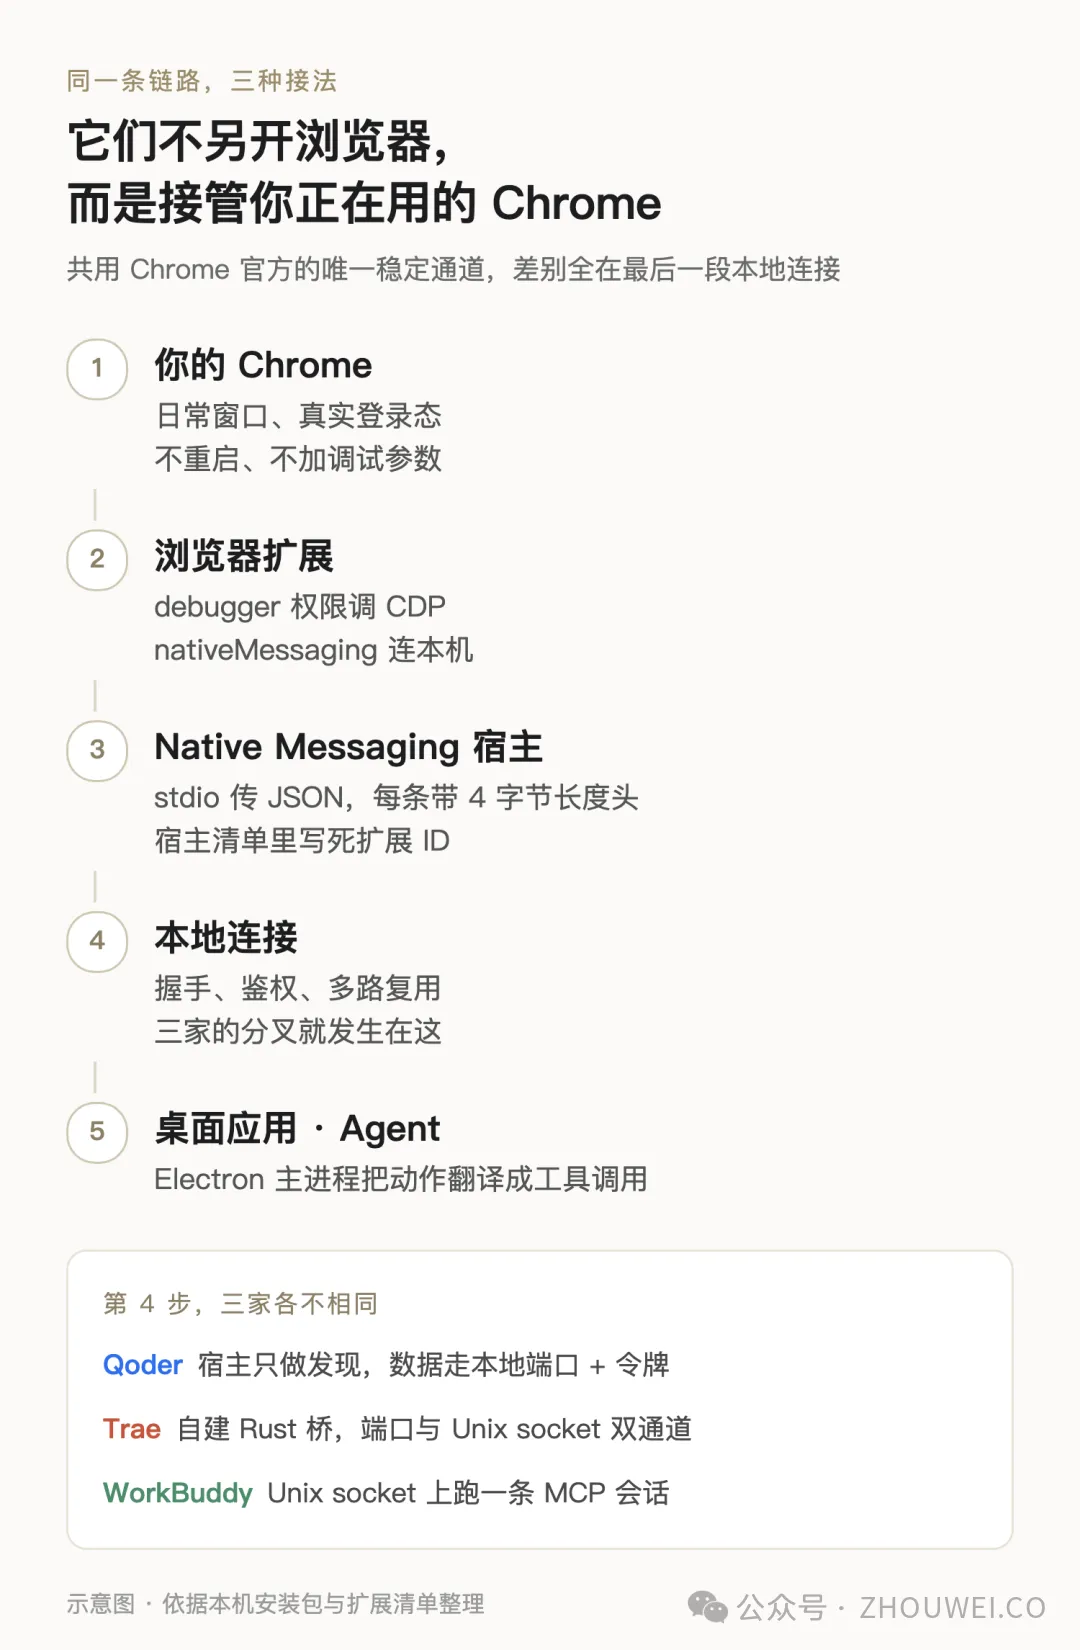
通用链路:扩展 → 宿主 → 本地 IPC → 应用
01
为什么都不自己开一个浏览器
最直觉的做法,是 Playwright 那一套:起一个干净的 Chromium,加 --remote-debugging-port,agent 通过 CDP 连上去。干净、可控、好复现。
但这条路在「帮用户干活」的场景里有个要命的问题:新开的浏览器里没有你的登录态。没有 cookie,没有已登录的后台,没有你昨天关不掉的十几个标签页。
还有两个隐性成本。一是要重启浏览器,调试端口不是热插拔的。二是窗口上会挂一条「受自动化测试软件控制」的横幅,看着像被劫持了。
扩展这条路把这些都绕开了:不用重启、不动启动参数、只在你授权的那几个标签页上生效,还能顺手用上浏览器自己的标签组能力。代价是你得装一个扩展,并且给它 debugger 权限——权限不小,后面单独说。
02
三家的共同底座:就三件东西
拆完三家的安装包,共同点很明确:chrome.debugger、nativeMessaging、宿主清单。
chrome.debugger 是 Chrome 把 DevTools 用的那套 CDP 协议,以扩展 API 的形式放出来。扩展 attach 到某个标签页,然后一条条发命令:Page.captureScreenshot 截图,Input.dispatchMouseEvent 点鼠标,Runtime.evaluate 跑一段页面脚本。
它有两个硬限制,值得记住。一是同一个标签页同时只能挂一个调试器,被别的工具占了就挂不上——所以三家代码里都有「这个标签被占了,跳过」的处理。二是 attach 的时候浏览器会给提示,不是偷偷摸摸的。
nativeMessaging 则是扩展唯一能跟本机原生程序说话的官方通道。走标准输入输出传 JSON,每条消息前面带 4 个字节的长度头,单条有大小上限。宿主清单里把 allowed_origins 写死成扩展 ID,别的扩展连不上。
我电脑上那三份清单,allowed_origins 里各只有一到三个 chrome-extension:// 开头的 ID。谁能连、连谁,是白名单写死的,不是运行时协商的。
到这里三家还是一样的。分叉发生在下一段:宿主跟桌面应用之间,怎么把消息送进去。
03
真正的分叉:最后一段本地通道
Qoder 的做法最绕,但也最省。它把「发现」和「数据」拆成两件事。
它注册的宿主其实是个 shell 脚本,脚本干的事是把 Qoder 的主程序以 Node 模式拉起来,跑一个几十 KB 的 .cjs。这个脚本只做一件事:去 ~/.qoder/browser-connector/clients 目录里读记录,把 端口号、进程号、一枚 relayToken 回给扩展。
扩展拿到端口之后,自己去连 Qoder 开的那个本地端口,带着 token 做鉴权。截图、点击这些真正的大流量,全程不经过 native messaging。
这个设计挺聪明。native messaging 单条消息有上限、往返也慢,扛不住连续截图和高频事件;挪到本地端口之后就是普通网络请求,想推流就推流。而宿主只负责「告诉你我在哪」,应用重启、端口变了,记录 30 秒过期自然刷新,不需要用户重连。
Trae 反过来,让桥进程自己把整条连接终结掉。宿主是一个 1.5MB 的 Rust 二进制,Chrome 直接把它拉起来。它同时开两扇门:127.0.0.1:19234 和一个 Unix socket,JSON-RPC 帧,连上先鉴权,5 秒内不完成握手就断开。再往上一层还有会话、租约、作用域这些概念。
它还给「预览」单独留了一条通道:独立的 ticket、独立的帧通道,跟 agent 干活的那条路分开。这样 IDE 里给你看的画面,不会和 agent 的调试请求互相排队。扩展里还有个 offscreen 文档专门保活——Manifest V3 的后台脚本会被浏览器回收,不保活连接就断。
WorkBuddy 的选择最彻底:它干脆把浏览器包装成一个 MCP 服务器。宿主文件的描述写得很直白——Browser MCP extension relay,浏览器 MCP 扩展中继。它在本地挂一条名字像 browser-mcp-* 的 Unix socket,上面跑的是标准 MCP 会话。
所以应用那边根本不用知道「浏览器」是个特殊东西。它看到的就是一个装了 32 个工具的 MCP 服务器:列出浏览器、开标签页、跳转、截图、点坐标。跟接一个数据库、一个文档工具,走的是同一层协议。
04
给模型的那只手,长得不一样
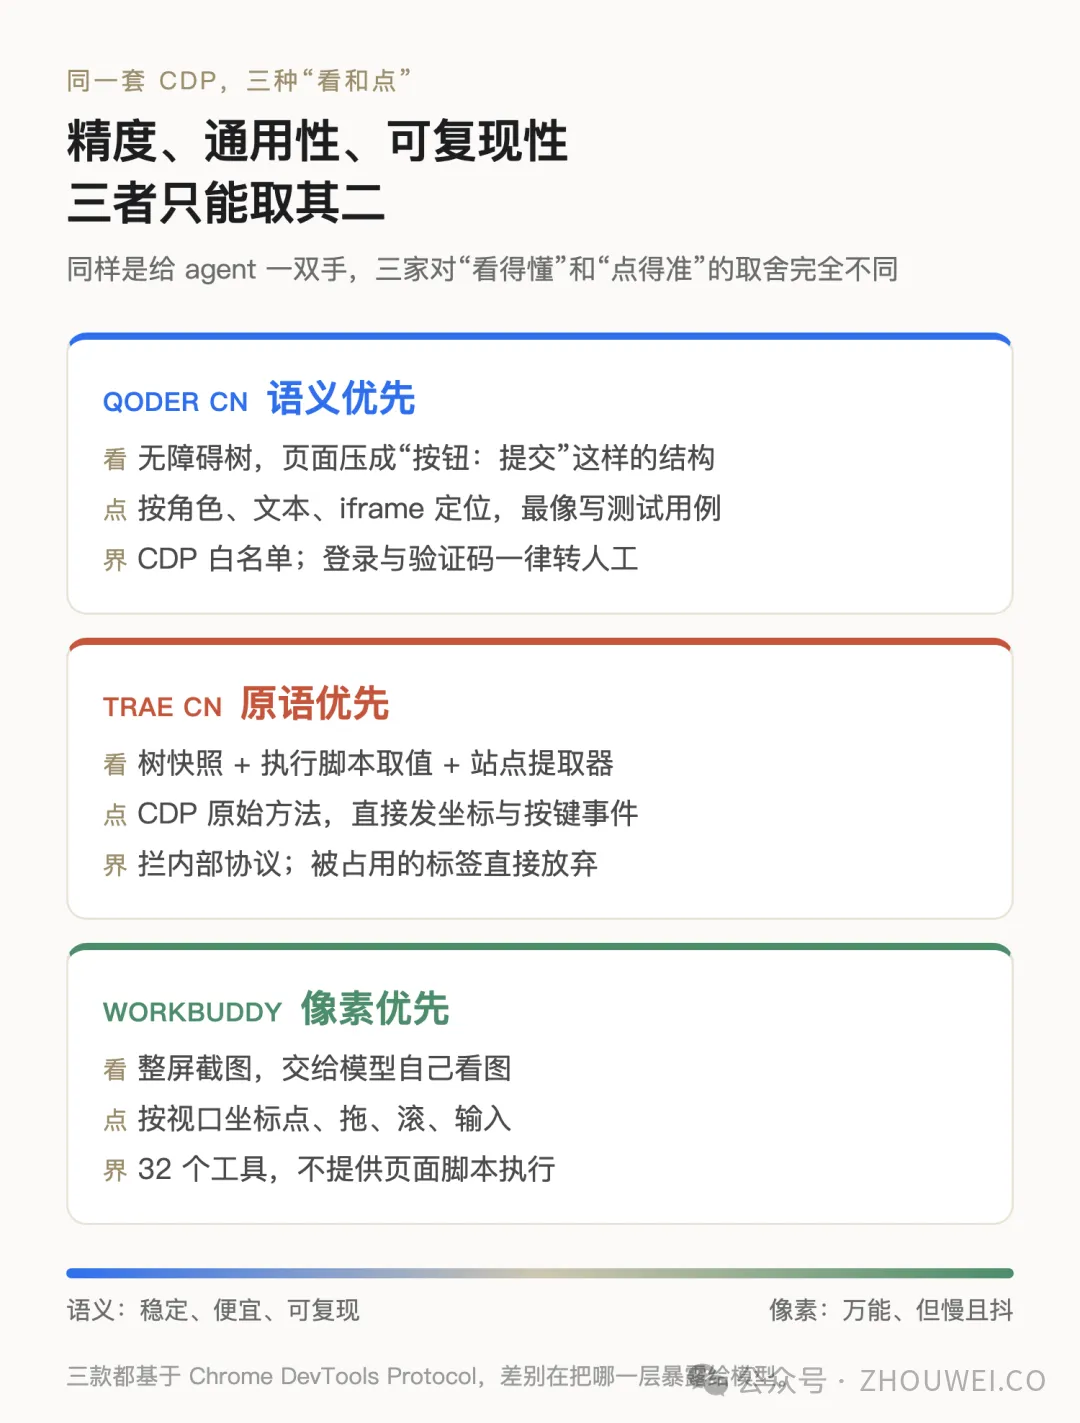
通道打通之后,还要回答一个问题:agent 怎么「看见」页面,怎么「按下」按钮。三家的答案完全不同。
Qoder 走语义层。它先把页面压成一张无障碍树——每个可交互元素有角色、有名字、有索引,模型读的是「按钮:提交」而不是一堆坐标。操作上,它给模型的是 Playwright 风格的接口:按角色找、按文本找、按 iframe 找,等文件选择框弹出再处理。
如果只是套了个壳,没必要在扩展里塞一百多处 Playwright 相关代码,还专门实现文件选择框拦截这种命令。它是在 CDP 之上重新实现了一套 Playwright 后端,把「选择器」这种确定性很强的东西留了下来。
Trae 走原语层。它不做抽象,直接把 CDP 的方法摊给模型:无障碍树快照、坐标点击、按键、执行脚本、截当前视口。另外单独配了一组站点提取器,GitHub、掘金、Twitter、公众号、小红书、知乎各有一套解析逻辑——这类站点结构稳定,用规则抓比让模型看图便宜得多。
WorkBuddy 走像素层。核心就两步:截一张图,告诉模型「这是你眼前的画面」;模型回一组坐标,它就在那个坐标按下鼠标。另有一套按 DOM 节点点的备选方案,但主路径是看图点图。而且它刻意不给页面脚本执行能力,32 个工具里没有 evaluate。
同样是点一个按钮:一个在说「点名叫提交的按钮」,一个在说「在 (412, 688) 按下鼠标」。
三种抽象:语义优先 / 原语优先 / 像素优先
这三种没有高下,只有取舍。语义层便宜、稳定、可复现,但前提是页面有像样的可访问性结构;原语层最灵活,代价是对模型能力要求高;像素层最通用,什么页面都能试,可每一步都要截图,又慢又不稳。
05
权限收了多紧,才是真功夫
debugger 权限意味着:能读页面内容、能模拟输入、能改 DOM。这个权限给的是一整个标签页的控制权,所以三家的护栏值得单独看。
Qoder 收得最细。标签页绑定在单轮对话上,用完释放;认领你已有的标签页,给的是一次性、短时效的 ID,标题或链接一变就作废;CDP 命令走白名单,Cookie、Storage、跨标签这些直接拒绝;填表接口拒收敏感字段;会改页面的命令要先弹确认;遇到登录和验证码,一律停下来把控制权交还给你。
Trae 收在通道上。鉴权有超时、请求有租约、chrome:// 这类内部协议直接拦掉;被别的调试器占住的标签记进黑名单,不反复重试;自己开的标签在会话结束时清掉。
WorkBuddy 的护栏长在工具面本身。不提供脚本执行,就等于没了「在页面里跑任意代码」这个口子;能做的只有开标签、跳转、截图、点、输入,动作粒度天然更粗。MCP 层还有自己的审批记录。
装一个带 debugger 权限的扩展,等于把「读所有打开页面」的能力交出去。用完之后把连接关掉,不用的插件卸载掉,这不是多余的小心。
06
一张表,和三句选型建议
如果你已经在浏览器里登录好,只想让它接着往下干——后台看数据、填一长串表单、走完某个流程,选 Qoder。它最准,也最愿意在该停的地方停下来。
如果你在写代码,边写边要看页面,或者要抓一堆公开资料——选 Trae。预览通道和站点提取器都是为这个场景准备的,它跟 IDE 贴得最近。
如果你要干的是一堆没 API、没结构、每天变的杂活——选 WorkBuddy。看图点图最笨,但也最不挑页面,而且它天生就是一个 MCP 工具,能跟别的能力混着用。
07
一点判断
这条技术路线其实已经收敛了。扩展拿页面、宿主通本地、本地 IPC 承载数据,三家不约而同,说明在「必须用你真实浏览器」这个前提下,没有更好的解。
接下来比的不是「能不能控浏览器」——这个已经没门槛了。比的是两件事:给模型多大权限,和把哪一层暴露给模型。
前者决定你敢不敢让它碰你的网银和邮箱,后者决定它干活是稳还是玄。三条路分别给出了三种答案,也都还在改。等哪天有人把这两件事同时做对了,浏览器里的 agent 才算真的能用。