ARTICLE · 1259597
AI为什么有时等半天才开口?
一
不知道你有没有注意过,AI回答问题的时候,有时候慢得很奇怪。
问完问题,屏幕上半天没有动静。好不容易开始出现文字,后面却一口气冒出来,速度很快。
而有时候正好相反。问题刚发出去,AI几乎马上就开口了。但后面的文字一个一个往外蹦,写了半天还没写完。
同样是AI回答慢,为什么会出现这两种不同的情况?
我们可以先看两个例子。
第一个,假设我把腾讯一份几十页的年报交给AI,要求它:
“用三句话总结这一年的主要经营变化。”
输入的材料很长,但最终只需要三句话。
第二个,我只给AI一句要求:
“写一篇三千字的文章,介绍新能源汽车产业。”
输入只有几十个字,输出却可能有几千字。
这两种任务,究竟哪个更费时间?
乍一看,后者需要写三千字,似乎应该更慢。但前者虽然只需要回答三句话,AI却需要先处理几十页材料。
而且,它们在GPU中的计算方式还不一样。
要弄明白这个问题,我们得先认识两个新概念:
Prefill和Decode。
它们是大语言模型推理过程中两个非常重要的阶段。
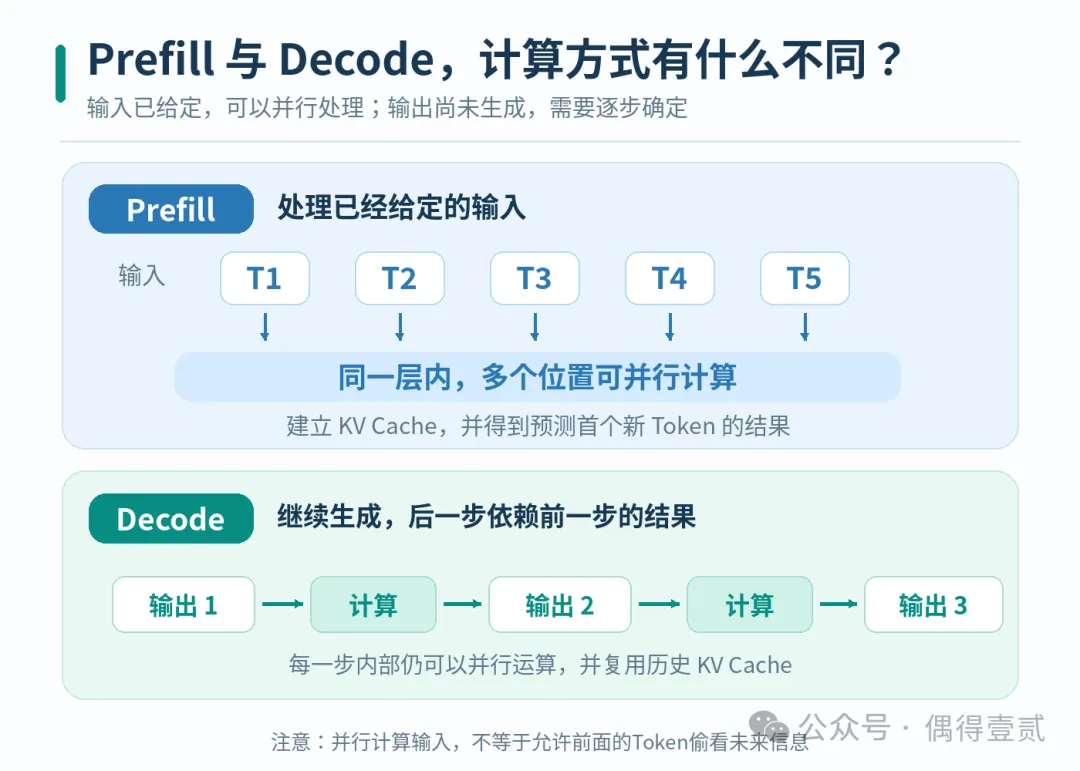
简单来说,Prefill负责处理已经给出的输入,Decode负责接着生成新的内容。
这两个过程,都需要GPU进行计算。但由于面对的任务不同,它们对计算资源的要求也不一样。
二
先说Prefill。通常翻译成“预填充”。
可以把它简单的理解成:模型处理已经给出的输入,为接下来生成回答做好计算准备。
还是前面那个年报的例子。
我们把几十页年报交给AI。文字首先会被切分成Token,再转换成数字表示,送进模型。
上一篇已经讲过,模型中的Attention需要利用Q、K、V,让不同位置的信息发生联系。
在处理这几十页年报时,模型就需要经过一层层神经网络,对这些Token进行计算,同时形成后续生成可能用到的KV Cache。
问题来了。
假设这份年报有几万个Token,模型是不是也得像生成回答一样,先处理第一个Token,等它完成后,才能处理第二个?
并不是。
因为这几万个输入Token,已经全部给定了。
这和模型接下来准备写什么,是两回事。
我们之前讲过,自回归生成有一个重要特点:后面的Token要依赖前面已经生成的内容。
但处理一段已经存在的输入时,并不需要等待未来的Token生成出来。
整个输入序列已经摆在这里。
因此,模型可以在神经网络的同一层里,组织大量Token位置同时进行计算。比如许多位置的Q、K、V,可以通过大规模矩阵运算并行算出来。
当然,前面讲过的因果掩码仍然有效。一个位置不能利用它后面不允许访问的信息。但这不妨碍GPU同时计算许多位置各自允许使用的信息。这正是GPU擅长的工作,GPU的优势在于能够同时处理大量适合并行的数值运算。
在Prefill阶段,模型面对大量已知输入,可以组织出规模比较大的矩阵计算,让GPU充分发挥计算能力。
这也解释了一个容易产生的误解:既然Prefill可以并行,那是不是意味着,输入十万个Token也能一瞬间处理完?
并行计算只是让许多工作同时展开,并不代表这些工作不需要消耗时间。
一份年报有几十页,另一份有几百页。对于同一个模型,在其他条件相近、没有额外缓存可以复用的情况下,后者需要处理的输入更多,也意味着更多计算工作。
所以,我们要求AI只总结三句话,并不能据此判断这次任务一定很轻松。
因为在生成那三句话以前,它可能已经做了大量计算。
不过,假如模型之前已经处理过同一份年报,而系统恰好保留了能够复用的缓存,那么这次就可能不必重新计算全部相同内容。这就是我们刚学过的技术:KV Cache。
这也是为什么,同样长的材料,在不同的请求中,等待时间不相同。
到了这里,Prefill的工作就容易理解了。
输入已经确定,模型可以并行处理大量Token,计算出生成所需的中间状态,并在输入末尾产生用于预测第一个新Token的结果。
接下来,才轮到另一个阶段。
三
现在,模型已经处理完用户给出的输入,开始正式生成回答。
这一步叫作Decode,解码。
Decode这个词在不同技术领域有不同含义。放在这里,我们先把它理解成:根据已有内容,接续生成新的Token。
它与Prefill最重要的区别,是后面的输出还不存在。
比如,我们要求AI写一封英文邮件,告诉客户货物周五发出。
模型已经写到了:
“The shipment is expected to...”
那么接下来究竟是“ship”,还是其他表达?
模型需要计算以后才能决定。
等它生成下一个Token,再把这个Token加入已有内容,继续计算后面的Token。
于是,生成过程就变成了:
算出一个Token,再根据已经生成的内容,继续算下一个。这叫作自回归生成。
这时你可能会问:
上一节说Prefill可以并行计算,为什么Decode不能把整篇邮件也同时算出来?
原因就在于,输入和输出的确定性不同。
Prefill处理的是已经给出的整段材料。
Decode处理的则是还没有生成的内容。
如果模型连这句话的前半部分具体写什么都尚未决定,后半部分的文字就可能存在许多不同的选择。
因此,在通常的自回归生成方式中,生成步骤之间存在先后依赖。
这里要特别强调,逐个生成Token,不等于GPU每一步内部只能串行运算。
模型每生成一个Token,仍然要进行大量矩阵计算,这些计算内部依然可以并行进行。
只是它不能简单地一次确定所有尚未生成的Token。
所以,当我们要求AI写一篇几千字的文章时,即使输入只有一句话,生成过程也可能持续很久。
另外,Prefill和Decode不仅在计算的组织方式上不同,还可能受到不同硬件瓶颈的限制。
Prefill面对大量已知Token,可以展开较大的并行计算,更容易充分利用GPU的计算能力。
但在单个请求的Decode阶段,每一步通常只新增少量Token,却仍然需要调用模型参数,读取前面保存的KV Cache,完成新一轮计算。
打个比方。
假设一间工厂里有一百台机器。
Prefill像是一下子送来一大批材料,让许多机器同时开工。
Decode则有点像每次只送来一小批新材料,机器完成这一步以后,还得等下一步要做什么确定下来,才能继续。
如果机器要用到的大量数据,还需要不断从仓库搬过来,那么等待数据的时间就可能变得很重要。
这恰好又回到了我们熟悉的三个概念:
算力、显存容量和显存带宽。
算力决定计算单元能够多快完成运算。
显存容量决定能存放多少参数和中间数据。
显存带宽决定单位时间内能够把多少数据送到需要的地方。
在许多单请求或较低并发的推理场景中,Decode每一步都需要读取大量参数和缓存,但计算单元不一定得到充分利用。这时,显存带宽就容易成为限制生成速度的重要因素。
所以,这里可以呼应我们系列的第一篇文章的主题:GPU计算能力翻倍,并不意味着AI生成Token的速度就会翻倍。
当然,这不是说Prefill永远只受计算能力限制,Decode永远只受带宽限制。具体瓶颈还会随着模型规模、输入长度、同时处理的请求数量和运行方式发生变化。
但我们至少已经能够理解:
同样是大语言模型推理,处理大量输入和持续生成输出,确实是两种特点不同的计算负载。
这也是为什么,NVIDIA在介绍大模型推理优化时,会把Prefill与Decode分开讨论。
四
我们回到最开始的问题:为什么有时候AI等半天才开口,有时候却是开口以后慢慢往外蹦字?
从工程角度看,评价AI服务的响应速度,至少需要区分两个指标。
第一个叫作TTFT,Time to First Token,首Token延迟。
它衡量的是,从请求发出或者被服务系统接收,到第一个输出Token出现,中间经过了多长时间。具体起点和终点取决于测量方式。
如果我们问完问题,等了很久才开始看到回答,那么TTFT可能就比较长。
第二个叫作TPOT,Time per Output Token,平均每个输出Token耗时。
它主要衡量首个输出Token之后,生成其余Token平均需要多少时间。
你也可以反过来理解成每秒能够生成多少Token。
两个指标的区别很直观:
TTFT看多久开始回答;TPOT看开始以后,回答生成得有多快。
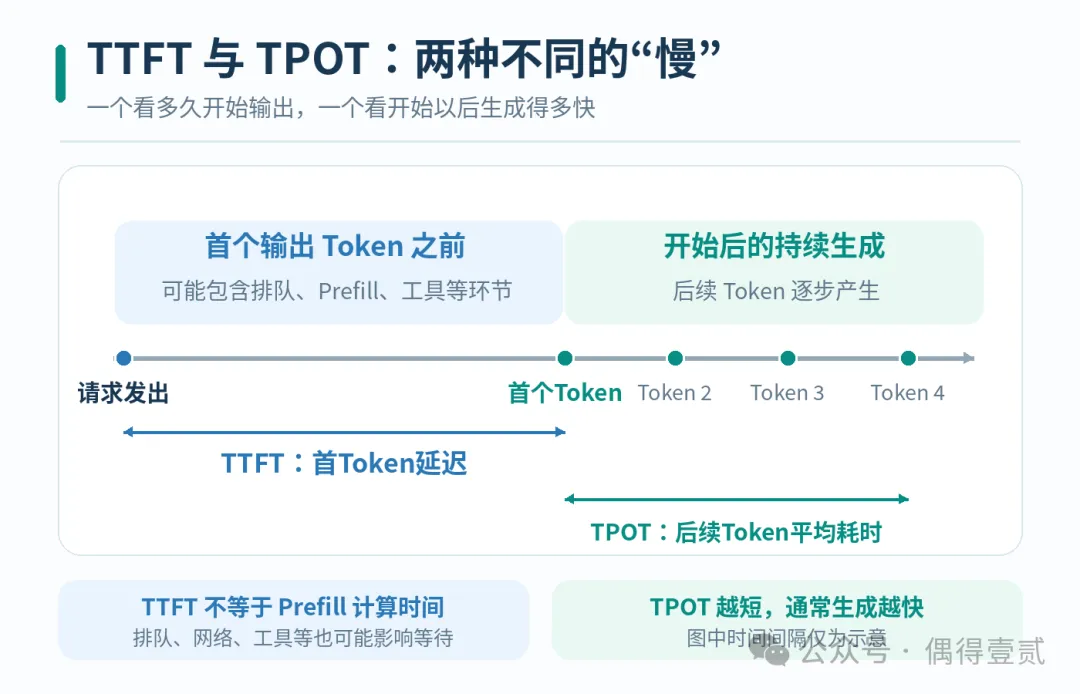
对于不同的任务,这两个指标的重要性并不一样。
比如,我们让AI从几百页材料中提取几个关键事实。
用户可能需要等上一段时间,才能看到最终答案。但如果结果只有短短几句话,后续生成本身并不需要持续太久。
反过来,如果只是要求AI写一篇长文章,输入可能很短,首个Token很快就出现了,但整个回答还需要经过大量后续生成步骤。
这里又有一个特别需要注意的问题。
TTFT并不等于Prefill的计算时间。
因为用户问完问题到收到第一个Token,中间可能还发生了其他事情。
例如,AI服务商的服务器正在处理其他请求,新任务需要先排队。
又或者,网络传输和任务调度本身需要时间。
如果这次任务需要先查资料、调用外部工具,正式回答也可能因此推迟。
还有一种情况,是一些推理模型在输出最终答案之前,先生成额外的内部推理内容。模型其实已经开始生成Token了,但屏幕上未必立即显示这些内容。
因此,我们不能看到AI迟迟没有开口,就直接断定它一定是在Prefill阶段,也不能因为它等了很久,就认为它一定思考得更加深入。
同时,屏幕上的文字显示速度,也不完全等于模型内部的Token生成速度。
一个Token不一定对应一个完整汉字或单词。聊天产品还可能采用不同的传输和显示方式。
于是,用户真正感受到的等待时间,与模型内部实际执行的计算阶段,既有联系,又不能完全画等号。