ARTICLE · 1274072
AI提取PDF表格,为什么会悄悄少行
一份58行的PDF表格,最后只拿到5行,程序却没有报异常。这是OpenRouter在10月29日教程里展示的案例:输出被截断后,启用JSON修复,得到了一份能解析、却不完整的结果。文件能打开,数据也可能已经少了。
先看模型实际读到了什么
把PDF交给OpenRouter,后面可能是两条路:支持原生文件输入的模型直接读PDF;不支持的模型,先由解析器处理,再读解析结果。模型能看图片,不代表这个接入端点就能直接收PDF。
官方用扫描采购单测试时,免费文本解析器cloudflare-ai没有找到文字,最后返回空的rows数组。HTTP状态是200,结束原因也是stop。这说明请求正常结束,却不能说明表格已被读到。
遇到这种扫描件,应改用原生文件输入,或带OCR的解析路径。当前文档说明,不指定引擎时优先使用模型原生能力,否则默认走mistral-ocr。后者另计解析费,需有OpenRouter账号、API密钥及可用额度。
JSON修好了,缺掉的行仍然缺着
另一处损失发生在输出端。表格很长,模型还没写完就触到max_tokens上限;普通JSON解析可能立刻报错,也可能被后续修复掩盖。官方把58行运单的输出限额调到600,启用Response Healing后,得到了只有5行、但能解析的结果。
修复括号和引号,不能补回模型没有写出的行。因此,看到finish_reason为length,就应停止使用这份结果,增加输出预算或拆分文件重新提取。即使结束原因是stop,仍须对照原表行数;前面的空表案例也是正常结束。
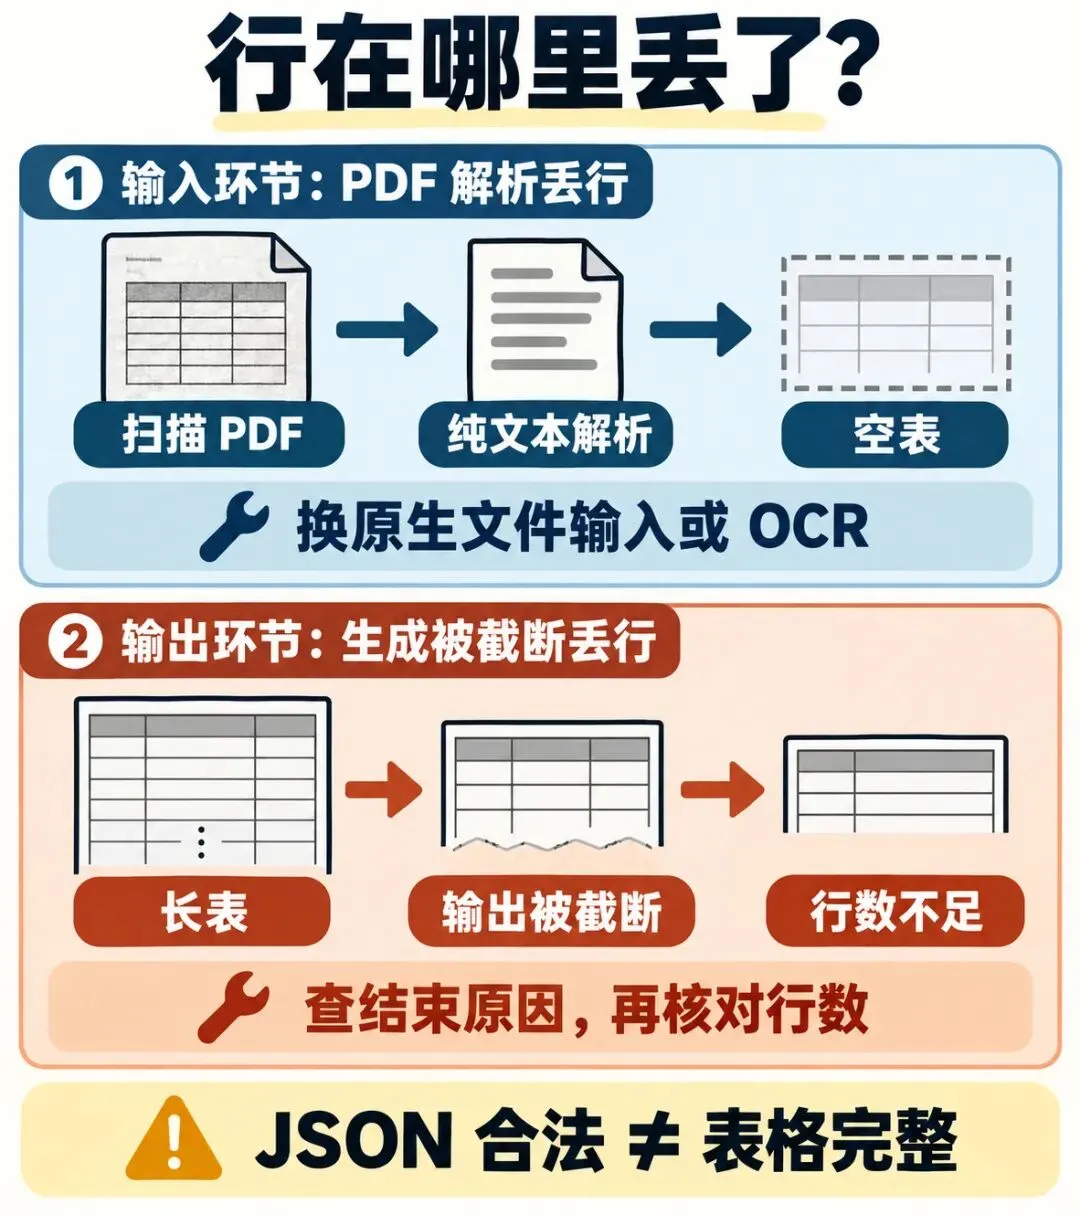
依据OpenRouter官方教程整理的机制示意,非本号运行截图。
结构化输出仍然有用。用JSON Schema约定每行的字段、类型与含义,可以要求数量为整数、金额去掉千分位,把括号形式的负数按约定转换。但它约束的是结果结构,不能单独证明行数齐全、数字正确。是否支持严格输出,还要核对具体服务端点。
先选一张能对得上账的表
测试时先拿一份已脱敏、自己知道总行数的文件,包含跨页位置、一个负数或合并单元格。记录实际模型、解析引擎、结束原因与输出行数,再回原表核对这些位置及合计。这是从官方案例整理出的试用方法,并非本号运行结果。
拆页时保留表头和单位,合并时检查重复表头及跨页重复行。行数相同也可能错列,合计相同也可能相互抵消,仍要抽查具体单元格。
如果只是结构简单的文字版PDF,官方对照中的pdfplumber已能找到表格;遇到扫描件、跨页或复杂表头,再评估OCR与模型路线。官方测试只覆盖五份自建PDF,不能替代你自己的文件。先确认“读到了什么、写完了没有”,再谈批量自动化。
#PDF表格 #OpenRouter #结构化输出 #文档处理 #AI开发
来源:OpenRouter官方教程、PDF输入与结构化输出文档
架构师手记