ARTICLE · 1291743
AI 助手该何时闭嘴:28,058 个决策点给出的答案
一套主动式助手最难的地方,不是它会说什么,是它什么时候闭嘴——而这篇论文用 28,058 个决策点告诉我们:真正决定提示好不好用的,不是模型多大,是它记不记得你。
想象这个场景。
你正在跟人聊天,突然卡住了:“我上周去看的那个……那个表演……”
你想不起名字。对方问:“哪个?”
这时候,你戴的智能眼镜在视野角落里打出三个字:舞蹈表演。
你想起来了,话接下去。
这个场景来自一篇 10 月 29 日的 arXiv 论文(arXiv:2610.40611,A. J. A. Jubayer Talukder 与 Mohammad Ariful Haque)。它研究的不是“AI 会不会写提示”,而是一件更琐碎、也更难的事:
一个随时可能插话的助手,该在什么时候插话。
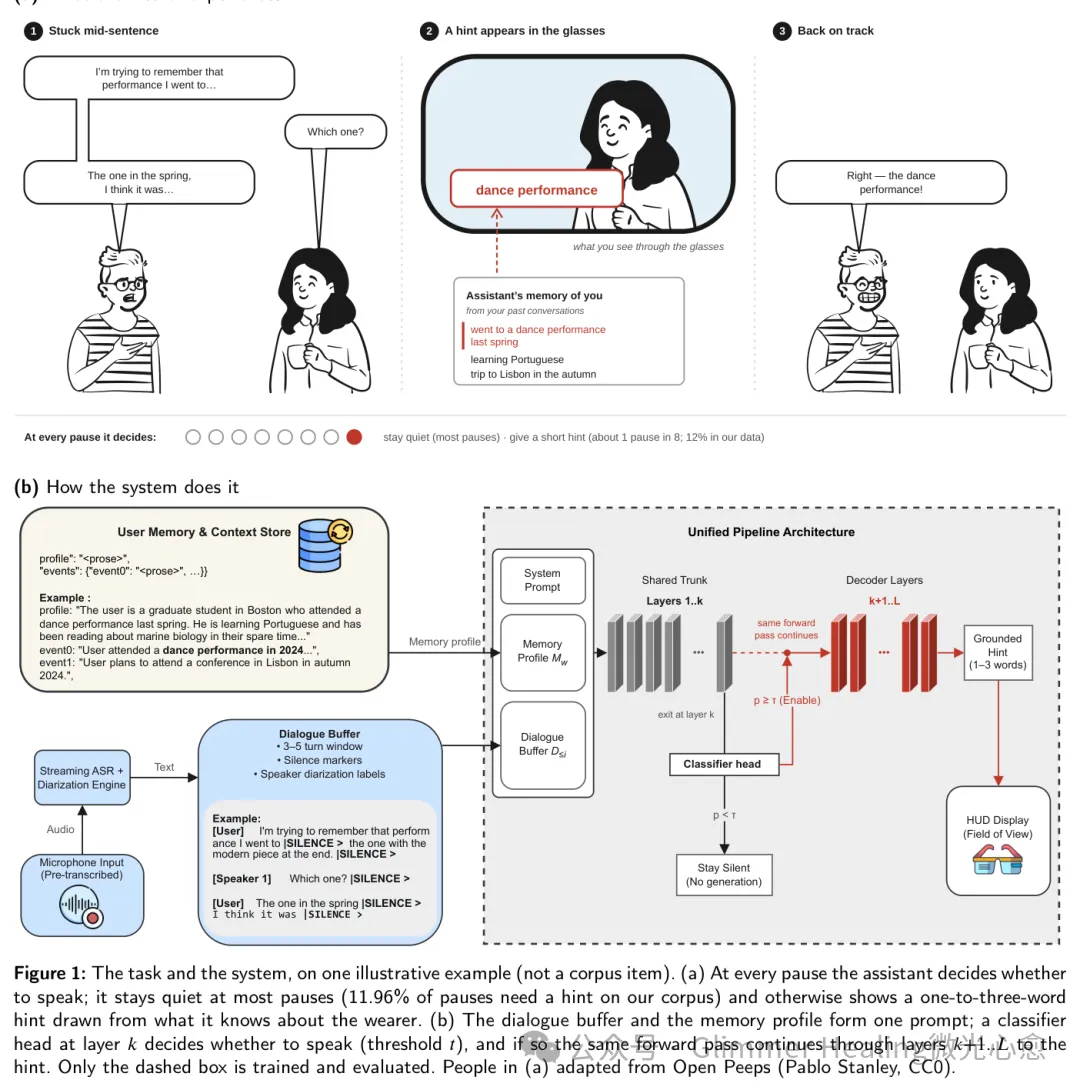
论文把这类系统叫主动式助手。它一直在听(但你不一定在跟它说话),在对话的每一个停顿处做两个判断:
· 要不要开口(论文叫“门控”)
· 开口说什么(提示只有 1–3 个 token)
第一个判断的难度,数字说得很清楚:语料里只有约 12% 的停顿真的需要提示——大约八分之一次。
也就是说,绝大多数时候,正确行为是沉默。
这也决定了评价方式:说错话(误报)会打断一段本来不需要它的对话;不说话(漏报)只是让你保持原状。两个代价不对称,所以“误报预算”在论文里被明确当作一个部署决策,而不是技术默认值。
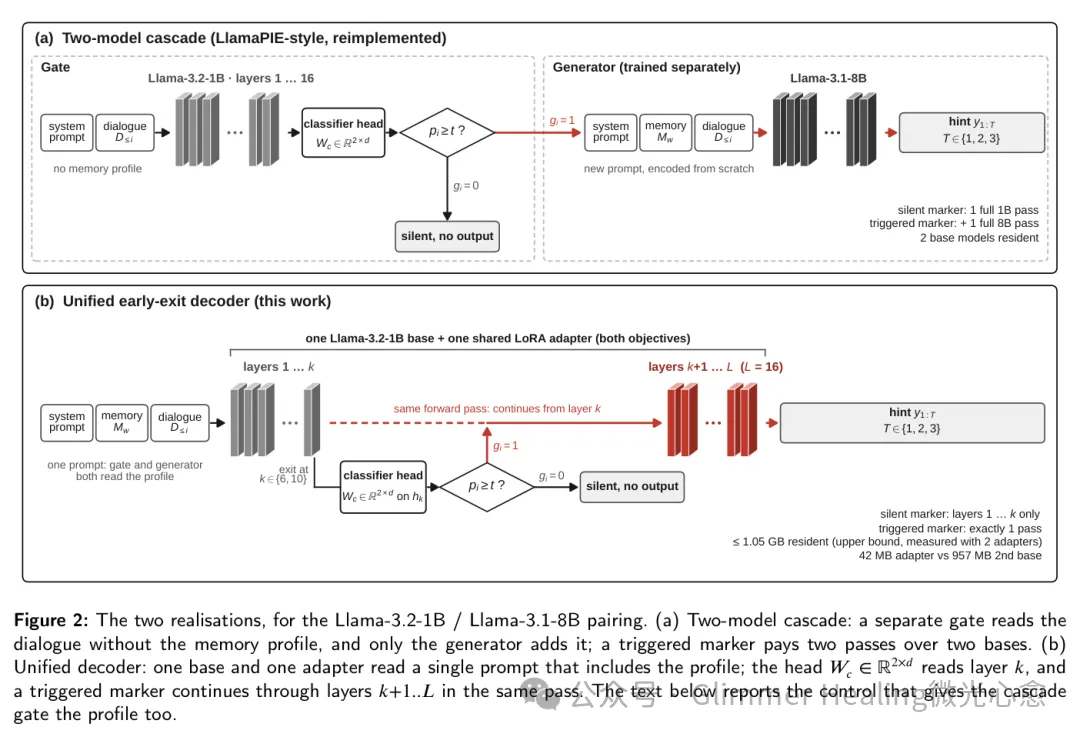
过去的做法叫两阶段级联:一个小模型当门控,读对话,决定要不要说;通过了再调一个更大的生成模型,读“对话 + 记忆”,写出提示。
这个结构有三处浪费:
1. 算力:沉默要跑一次门控,开口要跑两次前向
2. 信息:门控只看对话,看不到记忆画像——它其实是在信息不足的情况下判断该不该说
3. 成本:两个基座都要常驻
论文给的对照很直观:一个 42 MB 的 adapter,对上一个 957 MB 的第二个基座模型。
这篇论文的做法叫统一早退解码器:
· 基座是 Llama-3.2-1B,加一个共享的 LoRA adapter,同时服务门控和生成
· 输入是一个包含记忆画像的提示(门控不再“盲着”判断)
· 在第 k 层(k = 6 或 10,总层数 16)取隐状态,算一个分数 p
· p ≥ 阈值:继续跑到第 16 层,生成提示
· p < 阈值:当场停住,不出声
代价很清楚:沉默只跑 k/L 的层,开口恰好一次完整前向。
省的不只是算力,还有内存和延迟。
论文在部署工作点上测到:门控把生成器调用次数削减了 7.62 倍。
但折成实际耗时,就缩水了:
· 对 8B 生成器:省 4.39×
· 对 1B 生成器:只省 1.38×
为什么?论文自己给了原因,很诚实:在他们的测量装置上,门控本身就占用了“被门控的 1B 流水线”82% 的运行时间(考虑前缀缓存后约 53%)。
这条经验可以直接搬走:门控省算力的收益,取决于生成器有多大。生成器越小,专门为门控养一个模型就越不划算。
这是我觉得整篇最值得带走的一点。
同一批 3,356 个触发点,只改一个变量——推理时有没有记忆画像:
· 去掉画像:精确匹配掉 24.73 个点
· BERTScore 从 0.57 掉到 0.35,ROUGE-1 从 0.48 掉到 0.13
而且论文用三组对照把原因钉死了:
· 换成别人的画像:效果和“没有画像”无法区分(p = 0.343)——所以不是“多了点文字”,是内容对得上
· 长度不是原因:把增益拆成“长度成分”与“内容成分”,长度份额是 −1.33%
· 训练时不用画像的模型,推理也不用,表现接近——所以不是训练/推理匹配的功劳
相比之下,“换个更大的生成器”呢?同族里 8B 和 1B 在精确匹配上打平(p = 0.79)。
一个 1B 的模型,因为多了一份“你是谁、你上周去过哪儿”,就顶得上一个 8B。
这一条最反潮流。
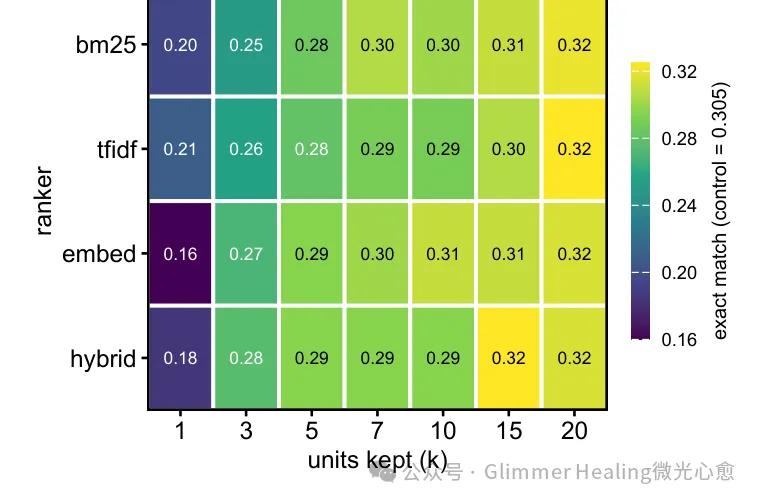
现在大家都在做检索、做上下文压缩。但论文测了 45 种检索配置(4 种排序器 × 7 种保留深度),Holm 校正之后,没有一种优于“整份画像全给”;k = 10 与 k = 5 甚至显著更差。
理由很朴素:完整画像本来就放得进上下文预算,所以在这里做检索,只会移除信息。
当然它有前提:画像放得进才行。但这条结论值得记住——“压缩”不是免费的,当预算够的时候,整份给可能更好。
这一节我读了两遍。
论文用人工评测验证自动指标。1,144 条评分、32 段对话、五点“采纳度”量表。然后它把不同自动信号跟人的打分做相关:
· 原生 LLM 评判器:0.55 / 0.67
· ROUGE-1:0.51 / 0.62
· BERTScore:0.47 / 0.61
· 精确匹配(EM,他们的主指标):0.31 / 0.43
主指标恰恰是与人类判断最不相关的那个。
论文的处理很克制:他们不把 EM 当“质量”,而当作一个严格下界(它只承认“一字不差”),并明确推荐把原生 LLM 评判器用于这个任务的自动评测。
这篇论文还有几处自我披露,在工程论文里并不常见:人工研究三次偏离了预注册方案;“这条提示本该被扣留吗”那一问收到 843 个回答,几乎全是“否”,于是他们直接写“不支撑任何结论”。
读者因此知道:能信的边界在哪里。
第 10 节是这篇论文最不像论文、但最有用的部分:
① 换门控就必须重校阈值。
六个候选模型里,达到“2% 误报预算”的阈值相差三倍以上;最坏情况(Gemma-3-270M 跑到别的工作点上)损失 28.0 个 F1 点。
② 排序最好的门控,校准反而最差。
如果系统要根据用户反馈自动调阈值,你消费的是“概率”而不是“排名”——那就得按校准质量选型,或者先做事后校准再重测。
③ 误报预算是一个部署决策。
部署工作点上系统发了 3,682 条提示,其中 23.5% 落在本该沉默的位置。收紧预算,是用精确匹配换精确率:更少的错误打断,代价是更少的正确打断。
④ 常驻权重是真实成本。
两模型方案要占 GB 级内存;合并版上界 1.05 GB。
⑤ CPU 延迟也是真实成本。
论文实测了各运行时、各权重格式,量级在一秒到数秒之间——“省算力”不等于“省时间”。
1. 单一任务、单一语料。 主数字来自“智能眼镜递提示”那份对话语料,补充材料另有一个自然录制的会议语料。
2. 它测的是“说什么”,不是“何时说”的全面能力。 人工评测里每个系统的提示都放在相同的金标注触发点上——比较的是各系统说了什么,而不是何时开口。
3. 触发标签本身是模型生成的。 主语料的触发标注由一个语言模型读合成对话产生,这正是补充材料要在行为标注语料上复核的原因。
4. “整份画像更好”有前提:画像得放得进预算。
5. “合并更好”也有前提:收益依赖生成器足够小。如果生成器是 8B,两阶段反而更划算(4.39× 里大头来自生成侧)。
我读这篇时一直在想教学。
一个老师天天在做同样两个决定:什么时候该给学生一句提示,提示要多细。
这篇论文给我三个可以直接搬走的判断:
第一,“要不要帮”和“帮什么”最好在同一个脑子里想。
你如果先由一个粗糙的判断决定“这学生需要帮”,再换一套材料去帮,信息会在交接处丢掉——论文里门控“看不见记忆画像”就是这个毛病。
第二,学情档案比“更聪明的老师”更影响提示质量。
去掉画像掉 24.73 个点,换个更大的模型提升有限。这对教学设计是个提醒:与其追求更花哨的讲解,不如把学生上周做过什么、卡在哪里记清楚。
第三,“帮错了”和“没帮”的代价不对称,所以“帮的频率”应该是一个主动决策。
论文里 23.5% 的提示落在本该沉默的位置——在课堂里,这就是那些“学生本来自己能想出来、却被你一句话拿走”的时刻。
还有一条关于评价:“一字不差”和“对人有用”的相关只有 0.31–0.43。 我们平时批作业、评课,用的往往是最容易算的那个指标;而它跟“真的有用”的关系,可能比我们想的弱。
这篇论文的结论其实很克制:一个 1B 解码器可以同时把门控与生成做好,在自动指标上追平甚至超过两模型流水线,还显著省时省内存;但它也老实承认——人工评分上仍低于 8B 流水线,非劣性检验没有达到计划边际。
所以它最有价值的部分,也许不是那个架构,而是那几条能搬走的经验:换模型要重校阈值、误报预算要主动选、记忆比规模重要、自动指标要挑对。
让 AI 学会“什么时候别说话”,比让它“说得更漂亮”更难;而在它决定开口之后,决定这句话有没有用的,往往不是它有多大,而是它记不记得你。
延伸阅读
· 论文原文与中文全译稿(正文 11 页 + 补充材料 S1–S8)
· 精读解读|论文图解(7 张插图逐张导读)
· AI 播客(13 分钟)|讲解课件|讲解视频(13 分钟,动效版)
论文:When to Assist and What to Suggest: Joint Gating and Memory-Grounded Hint Generation in One Compact Decoder |
A. J. A. Jubayer Talukder, Mohammad Ariful Haque | arXiv:2610.40611 | 2026-10-29
论文全文(复制到浏览器打开):https://arxiv.org/abs/2610.40611
📖 关于本公众号
公众号名称:Glimmer Healing微光心愈
分享方向:AI 论文精读 · 智慧心育 · GitHub
优秀项目 · 心愈周报
长按识别二维码 · 关注“Glimmer Healing微光心愈”