ARTICLE · 1295367
文档处理是地基,但决定房子塌不塌的是意图、召回与验证
我上期公众号讲意图理解,有评论区最感谢的是前面文档处理的文章,大家觉得“先把文档搞好再说”。这个想法对了一半。文档处理确实是第一步,数据脏了后面全白搭。但近期好多提问涌向文档处理,反而让我觉得有必要把话说完整:数据是充要条件,但不是全部。一份清洗得再干净的文档库,如果系统没听懂用户到底在问什么、召回时漏掉了关键的多跳证据、生成完没人检查有没有胡编,最后给用户的答案照样可能是错的。
本期我把意图理解之后、最终输出之前的三个关键环节拆开讲透:提示词意图的精确对齐、向量与多跳召回的配合、以及回答生成后的循环验证。这三个环节任何一个出问题,前面文档处理花的功夫都白费。
一、意图理解:不是“听懂人话”那么简单
很多人以为意图理解就是让大模型“理解用户问题”。这个说法太糙了。真正要解决的是约束保持问题。
用户问“去年Q3华东区销售额超过500万且回款率低于60%的客户有哪些”,这句话里包含了时间约束(去年Q3)、地域约束(华东区)、数值阈值(销售额>500万)、条件约束(回款率<60%)、输出类型(客户名单)。如果系统在理解阶段把这些条件拆散了、丢了一个、或者把“且”理解成了“或”,后面的检索再精准也是白搭。
有研究把这个问题叫约束绑定查询:多个条件绑定在同一个用户查询上,必须一起保留才能让回答有效。如果某些条件被忽略、折叠、或者当成独立关键词处理,系统可能检索出“看起来相关”但根本不满足用户真实意图的内容。
怎么解决? 关键在于把意图理解从“黑盒”变成“白盒”。不要让大模型直接吞掉用户问题就开始检索,而是先输出一个结构化的意图对象:主题是什么、操作性条件有哪些、非操作性修饰词有哪些、哪些条件当前无法支持、缺少哪些前提。这个结构化表示可以在检索之前被检查、被审计、被修正。换句话说,意图理解的可解释性不在事后解释“为什么这么答”,而在事前让人看到“系统认为用户在问什么”。这一步做扎实了,幻觉的源头就少了一个。
二、召回:向量只是起点,多跳才是分水岭
向量召回是当前 RAG 系统的标配。把用户问题 embedding 一下,去向量库里找余弦相似度最高的几个块,简单直接。但简单问题够用,复杂问题不够。
问题出在“多跳”上。用户问“A 产品的退货政策在 B 地区的特殊条款与总则的差异是什么”,答案可能分散在三份文档里:总则在一份政策文件里,B 地区特殊条款在一份区域补充说明里,而两者的差异需要对比推理才能得出。向量召回只做一次相似度匹配,很可能只捞到总则或者只捞到特殊条款,漏掉的那一半恰恰是答案的关键。
更成熟的召回架构要做两件事:
第一,多路召回并行。向量检索负责语义匹配,全文检索负责关键词精确命中,图检索负责沿着实体关系走多跳。三路结果各有所长,融合层再做加权或重排序。向量擅长“意思相近”,全文擅长“词对得上”,图擅长“顺着关系链找到间接证据”。缺了哪一路,盲区就留在那里。
第二,多跳邻域扩展。在检索到初始结果后,不是直接塞给模型,而是沿着查询之间的语义关联继续往外走几跳,收集邻域内的相关查询和对应文档块,再统一排序筛选。这相当于在说:“这个块跟问题相关,那跟这个块语义相邻的其他块有没有可能也相关?”对于需要跨文档综合的问题,这一步往往决定了答案能不能“凑齐”。
还有一个容易被忽略的点:召回后的去冗余。检索出十个块,可能五个说的是同一件事。全塞给模型不仅浪费上下文窗口,还会让模型被重复信息带偏。贪心对数行列式选择之类的方法可以在保留多样性的前提下挑出信息量最大的子集。少而精,比多而杂安全。
三、循环验证:生成完就交卷,是幻觉最大的帮凶
这是最容易被跳过的一步。很多系统的流程是:检索→拼 prompt→生成→返回。干净利落,也干净利落地把幻觉放了出去。
验证要做在生成之后、返回之前。具体来说,有两个层次:
层次一:句子级事实校验。把生成的回答拆成句子,逐句检查每个断言是否有检索到的证据支撑。有研究用自然语言推理分类器做这件事:每个句子被标记为“有支撑”“无支撑”“被矛盾”,据此计算幻觉分数。临床问答领域的实践更激进:生成器先基于筛选过的证据起草答案,验证器再逐句检查,发现有未支撑的断言就打回去让生成器修改,形成检索—验证—生成的循环,最多迭代三轮。效果是,一个 7B 参数的模型配合验证循环,在开放式推理指标上能追平甚至超过 32B 的模型,多跳逆向步骤识别错误降低了 26%。小模型加验证,好过大模型不加验证。
层次二:信息缺口驱动的再检索。有时候问题不在生成胡编,而在召回阶段漏了东西,模型只能靠参数知识硬补。验证环节要能识别出“当前检索到的证据不足以回答某个子问题”,然后主动生成聚焦的反馈查询去补检索。这比让模型“根据已有信息尽力回答”要诚实得多,也安全得多。
我上期提过的“回答结果的再循环验证”,这确实是当前 RAG 从“能用”走向“可信”的分水岭。没有验证环节的 RAG,本质上是一个带参考书的幻觉生成器。参考书翻得再对,抄错了一样是错。
最后再来说说文档处理
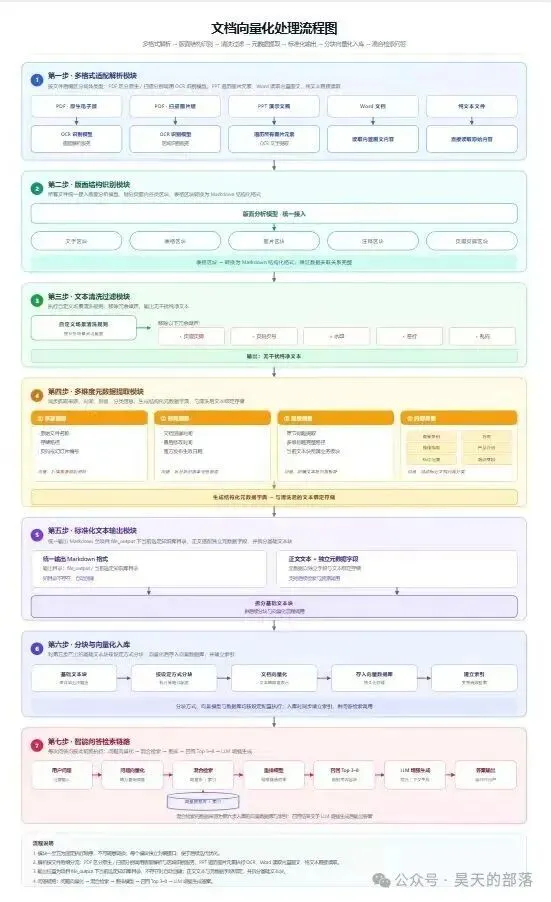
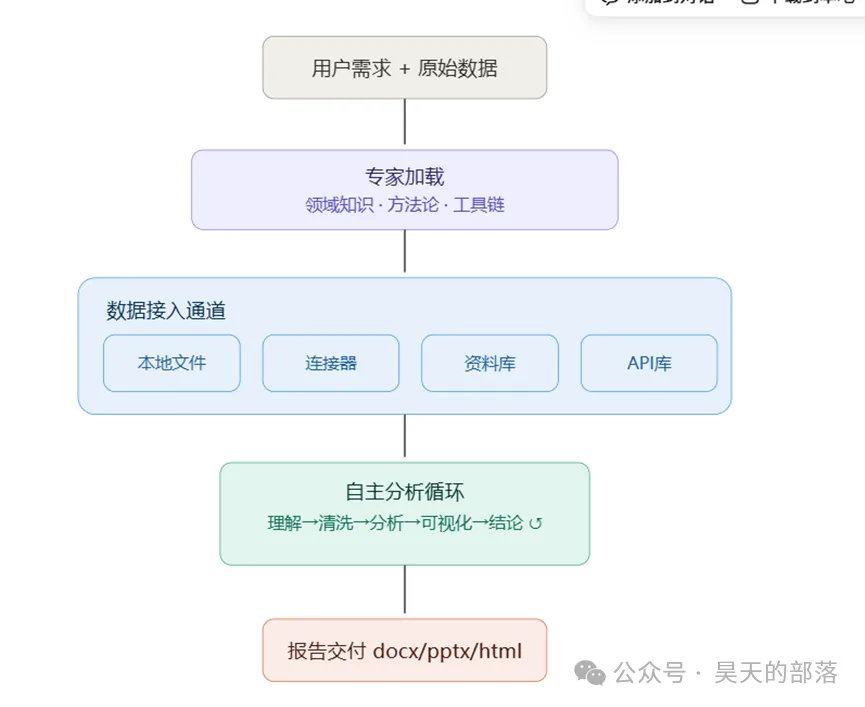
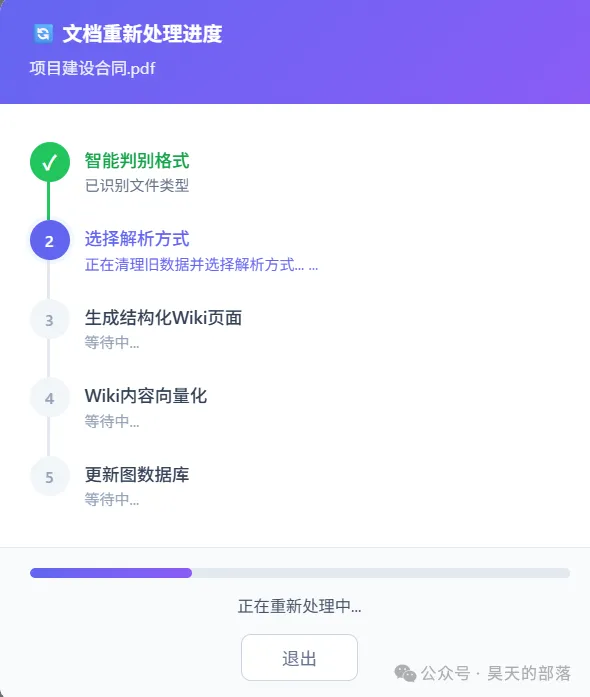
我把我的数据处理流程和系统截图,放在这供大家参考。大家对文档处理的热情是对的,因为数据质量对 RAG 性能的拖累是全局性的。有研究在表格和文本数据里注入真实错误后测试 GPT 和 Gemini,发现特定类型的错误会让回答正确率显著下降。OCR 质量、分块策略、元数据完整性,每一个环节的疏漏都会在检索和生成阶段被放大。
但正因为地基重要,才不能只盯着地基。一栋房子的交付质量,取决于地基、结构、水电、验收每一个环节。意图理解是结构设计,召回是多路管线的铺设,验证是最后的验收。文档处理决定系统有没有资格上场,后三者决定它上场之后是赢是输。
下期 我准备可以把意图理解的结构化输出示例、多路召回的融合逻辑、验证环节的打回重试流程各配一张图。大家拿着流程图对照自己的系统跑一遍,可能比读十篇综述都管用。